

Na kojim principima se gradi idealno skladište podataka?
Fokus na poslovnoj vrednosti i analizi u odsustvu boilerplate koda. Upravljanje DWH kao kodnom bazom: verzionisanje, revija, automatsko testiranje i CI. Modularnost, proširivost, otvoreni izvor i zajednica. Prijateljska korisnička dokumentacija i vizualizacija zavisnosti (Data Lineage).
O svemu ovome detaljnije i o ulozi DBT-a u ekosistemu Big Data & Analytics — dobrodošli ispod.
Svima pozdrav
Na vezi je Artemij Kozyr. Već više od 5 godina radim sa skladištima podataka, bavim se izgradnjom ETL/ELT-a, kao i analizom podataka i vizualizacijom. Trenutno radim u , predajem na OTUS-u na kursu , i danas želim da podelim sa vama članak koji sam napisao uoči početka novog upisa na kurs.
Kratak pregled
DBT okvir je sve o slovu T u akronimu ELT (Extract — Transform — Load).
Sa pojavom tako produktivnih i skalabilnih analitičkih baza podataka kao što su BigQuery, Redshift, Snowflake, izbrisana je svaka svrha izvođenja transformacija van skladišta podataka.
DBT ne izvozi podatke iz izvora, ali pruža ogromne mogućnosti za rad sa podacima koji su već učitani u skladište (u Internal ili External Storage).
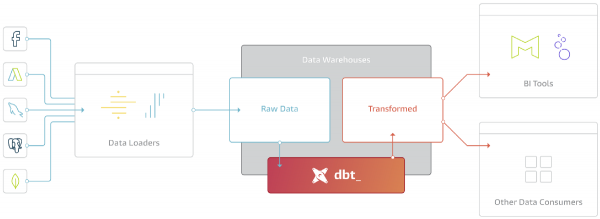
Osnovna svrha DBT-a je uzeti kod, kompajlirati ga u SQL, izvršiti komande u pravom redosledu u skladištu.
Struktura DBT projekta
Projekt se sastoji od samo 2 tipa direktorija i datoteka:
- Model (.sql) — jedinica transformacije izražena SELECT upitom
- Datoteka konfiguracije (.yml) — parametri, podešavanja, testovi, dokumentacija
Na osnovnom nivou rad se gradi na sledeći način:
- Korisnik priprema kod modela u bilo kojem pogodnom IDE-u
- Pomoću CLI-a pokreće se izvršenje modela, DBT kompajlira kod modela u SQL
- Kompajlirani SQL kod se izvršava u skladištu prema zadatom redosledu (graf)
Ovako može izgledati pokretanje iz CLI-a:
Sve je SELECT
To je killer feature DBT okvira. Drugim rečima, DBT apstrahuje sav kod vezan za materijalizaciju vaših upita u skladištu (varijacije iz komandi CREATE, INSERT, UPDATE, DELETE ALTER, GRANT, …).
Svaki model podrazumeva pisanje jednog SELECT upita koji definiše rezultantni skup podataka.
Logika transformacija može biti višerazinska i konsolidovati podatke iz više drugih modela. Primer modela koji će izgraditi vitrin obaveza (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Šta zanimljivo možemo ovde videti?
Prvo: Koriste se CTE (Common Table Expressions) — za organizaciju i razumevanje koda koji sadrži mnogo transformacija i poslovne logike
Drugo: Kod modela — to je mešavina SQL-a i (templatni jezik).
U primeru se koristi petlja for za formiranje suma po svakom metodu plaćanja navedenom u izrazu set. Takođe se koristi funkcija ref — mogućnost referisanja unutar koda na druge modele:
- Tokom kompajliranja ref biće transformisan u ciljni pokazivač na tabelu ili prikaz u skladištu
- ref omogućava izgradnju grafika zavisnosti modela
Ono što dodaje u DBT gotovo neograničene mogućnosti. Najčešće korišćene od njih su:
- If / else izjave — grane uslovnog izvršavanja
- For petlje — petlje
- Varijable — varijable
- Makro — kreiranje makrosa
Materializacija: Tabela, Prikaz, Inkrementalna
Strategija materializacije — pristup prema kojem će rezultantni skup podataka modela biti sačuvan u skladištu.
U osnovnom razmatranju to je:
- Tabela — fizička tabela u skladištu
- Prikaz — prikaz, virtuelna tabela u skladištu
Tu su i složenije strategije materializacije:
- Inkrementalno — inkrementalno učitavanje (velikih tabela činjenica); nove stavke se dodaju, izmenjene — ažuriraju, obrisane — uklanjaju
- Ephemeral — model se ne materializuje direktno, već učestvuje kao CTE u drugim modelima
- Bilo koje druge strategije koje možete dodati sami
Pored strategija materializacije, otvaraju se mogućnosti za optimizaciju za konkretna skladišta, na primer:
- Snowflake: Transient tabele, Merge ponašanje, Klasterizacija tabela, Kopiranje prava, Sigurni prikazi
- Redshift: Distkey, Sortkey (interleaved, compound), Kasno vezivanje prikaza
- BigQuery: Podela i klasterizacija tabela, Merge ponašanje, KMS enkripcija, Oznake i Tagovi
- Spark: Format datoteka (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
Trenutno su podržani sljedeći pohrane:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (djelomično)
- Spark (djelomično)
- Microsoft SQL Server (community adapter)
Poboljšajmo naš model:
- Napravimo njegov sadržaj inkrementalnim (Incremental)
- Dodajmo ključeve segmentacije i sortiranja za Redshift
-- Konfiguracija modela:
-- Inkrementalno punjenje, jedinstveni ključ za ažuriranje zapisa (unique_key)
-- Ključ segmentacije (dist), ključ sortiranja (sort)
{{
  config(
           materialized='incremental',
           unique_key='order_id',
           dist="customer_id",
           sort="order_date"
       )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Ova filtracija će se primijeniti samo za inkrementalno pokretanje
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Graf ovisnosti modela
Isto tako, drvo ovisnosti. Također DAG (Usmjereni Aklitički Graf — Directed Acyclic Graph).
DBT gradi graf na temelju konfiguracije svih modela projekta, a točnije referenci ref() unutar modela na druge modele. Postojanje grafa omogućuje sljedeće:
- Pokretanje modela u ispravnom redoslijedu
- Paralelizacija formiranja vizualizacija
- Pokretanje proizvoljnog podgrafa
Primjer vizualizacije grafa:
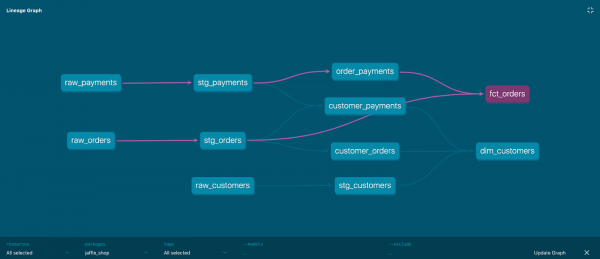
Svaki čvor grafa je model, a rubovi grafa određuju se izrazom ref.
Kvaliteta podataka i Dokumentacija
Osim formiranja samih modela, DBT omogućuje testiranje niza pretpostavki (assertions) o rezultantnom skupu podataka, kao što su:
- Not Null
- Unique
- Reference Integrity — referentna cjelovitost (na primjer, customer_id u tablici orders odgovara id-u u tablici customers)
- Podudaranje s popisom dopuštenih vrijednosti
Moguće je dodavanje vlastitih testova (custom data tests), kao što su, na primjer, % odstupanja prihoda u usporedbi s pokazateljima od dan, tjedan, mjesec ranije. Svaka pretpostavka izražena u obliku SQL upita može postati test.
Tako se mogu otkrivati neželjene varijacije i greške u podacima u vizualizacijama pohrana.
Što se tiče dokumentacije, DBT nudi mehanizme za dodavanje, verzioniranje i distribuciju metapodataka i komentara na razini modela pa čak i atributa.
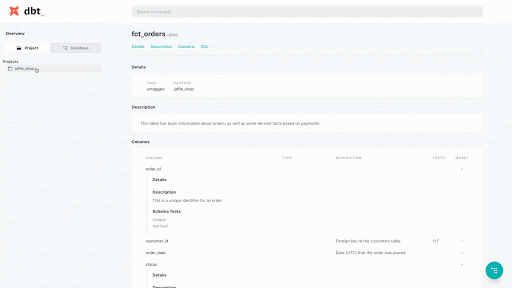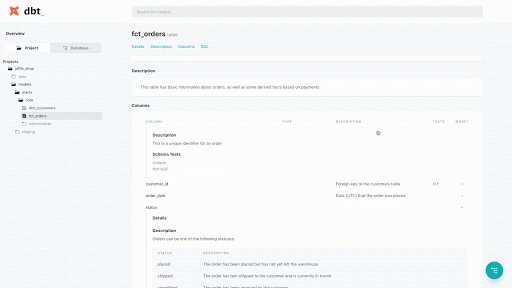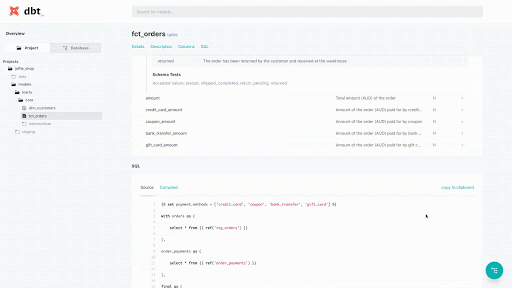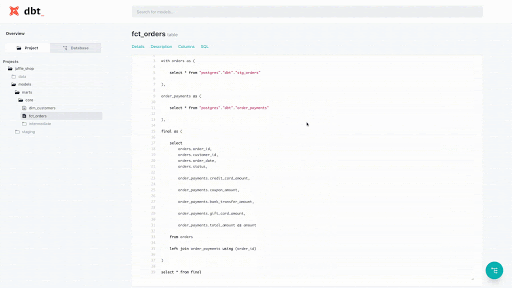
Evo kako izgleda dodavanje testova i dokumentacije na razini konfiguracijske datoteke:
 - name: fct_orders
   description: Ova tablica ima osnovne informacije o narudžbama, kao i neke izvedene podatke na temelju uplata
   columns:
     - name: order_id
       tests:
         - unique # provjera jedinstvenosti vrijednosti
         - not_null # provjera nije null
       description: Ovo je jedinstveni identifikator za narudžbu
     - name: customer_id
       description: Strani ključ za tablicu kupaca
       tests:
         - not_null
         - relationships: # provjera referentne cjelovitosti
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Datum (UTC) kada je narudžba postavljena
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # provjera prihvatljivih vrijednosti
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
A ovo je kako ta dokumentacija izgleda na generiranoj web stranici:
Mikroa i Moduli
Svrha DBT-a nije toliko u tome da postane skup SQL skripti, već pružiti korisnicima moćne alate za izgradnju vlastitih transformacija i distribuciju tih modula.
Mikroa su skupovi konstrukcija i izraza koji se mogu pozvati kao funkcije unutar modela. Mikroi omogućavaju ponovnu upotrebu SQL-a između modela i projekata prema inženjerskom principu DRY (Ne ponavljaj se).
Primjer mikre:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
I njegova upotreba:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- poziv mikre
from my_table
DBT dolazi s upraviteljem paketa (packages) koji omogućava korisnicima objavljivanje i ponovnu upotrebu pojedinačnih modula i mikri.
To znači mogućnost preuzimanja i korištenja takvih biblioteka kao što su:
- : rad s datumom/vremenom, zamjenskim ključevima, testovima sheme, pivot/unpivot i drugima
- Gotovi predlošci vitrina za takve usluge kao što su i
- Biblioteke za određene skladišne podatke, na primjer
- — Modul za evidenciju rada DBT-a
S punim popisom paketa možete se upoznati na .
Još više mogućnosti
Ovdje ću opisati nekoliko drugih zanimljivih karakteristika i implementacija koje ja i tim koristimo za izgradnju Skladišta Podataka u .
Razdvajanje izvršnih okruženja DEV — TEST — PROD
Čak i unutar jednog DWH klastera (u okviru različitih shema). Na primjer, pomoću sljedećeg izraza:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Ovaj kod doslovno govori: za okruženja dev, test, ci uzmi podatke samo za posljednja 3 dana i ništa više. To znači da će izvođenje u tim okruženjima biti puno brže i zahtijevati manje resursa. Kada se pokrene u okruženju prod uvjet filtriranja će biti ignoriran.
Materializacija s alternativnim kodiranjem kolona
Redshift je kolonska DBMS koja omogućuje određivanje algoritama kompresije podataka za svaku pojedinačnu kolonu. Odabir optimalnih algoritama može smanjiti zauzet volumen na disku za 20-50%.
Makro izvršit će naredbu ANALYZE COMPRESSION, stvorit će novu tablicu s preporučenim algoritmima kodiranja kolona, označenim ključevima segmentacije (dist_key) i sortiranja (sort_key), prenijet će u nju podatke i, ako je potrebno, obrisati staru kopiju.
Potpis makroa:
{{ compress_table(schema, table,
                  drop_backup=False,
                  comprows=none|Integer,
                  sort_style=none|compound|interleaved,
                  sort_keys=none|List,
                  dist_style=none|all|even,
                  dist_key=none|String) }}
Zapisivanje pokretanja modela
Na svaku izvršavanje modela mogu se pričvrstiti hookovi (hooks) koji će se izvršavati prije pokretanja ili odmah nakon završetka izrade modela:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
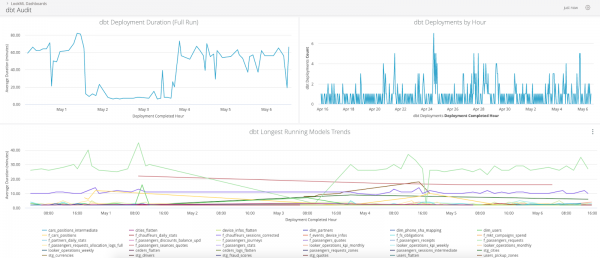
Modul zapisa omogućit će zabilježavanje svih potrebnih metapodataka u zasebnoj tablici, prema kojoj se kasnije može provoditi revizija i analiza problematičnih mjesta (bottlenecks).
Evo kako izgleda nadzorna ploča na podacima zapisa u Lookeru:
Automatizacija održavanja Skladišta
Ako koristite neka proširenja funkcionalnosti korištenog Skladišta, kao što su UDF (User Defined Functions), verzioniranje tih funkcija, upravljanje pristupima i automatizirano uvođenje novih verzija može se vrlo lako provesti u DBT.
Koristimo UDF na Pythonu za izračunavanje hash vrijednosti, domena e-mail adresa, dekodiranje bitmaski.
Primjer makronaredbe koja stvara UDF u bilo kojem okruženju izvršenja (dev, test, prod):
{% macro create_udf() -%}

 {% set sql %}
 CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
 RETURNS varchar
 LANGUAGE plpythonu
 STABLE
 AS $$
 import hashlib
 return hashlib.sha256(mes).hexdigest()
 $$
 ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
U Wheelyju koristimo Amazon Redshift, koji je temeljen na PostgreSQL-u. Za Redshift je važno redovito prikupljati statistiku o tablicama i oslobađati prostor na disku — naredbe ANALYZE i VACUUM, respektivno.
Zbog toga se svake noći izvršavaju naredbe iz makronaredbe redshift_maintenance:
{% macro redshift_maintenance() %}

 {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

 {% for row in vacuumable_tables %}
 {% set message_prefix=loop.index ~ " od " ~ loop.length %}

 {%- set relation_to_vacuum = adapter.get_relation(
 database=row['table_database'],
 schema=row['table_schema'],
 identifier=row['table_name']
 ) -%}
 {% do run_query("commit") %}

 {% if relation_to_vacuum %}
 {% set start=modules.datetime.datetime.now() %}
 {{ dbt_utils.log_info(message_prefix ~ " Usisavanje " ~ relation_to_vacuum) }}
 {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
 {{ dbt_utils.log_info(message_prefix ~ " Analiziranje " ~ relation_to_vacuum) }}
 {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
 {% set end=modules.datetime.datetime.now() %}
 {% set total_seconds = (end - start).total_seconds() | round(2)  %}
 {{ dbt_utils.log_info(message_prefix ~ " Završeno " ~ relation_to_vacuum ~ " u " ~ total_seconds ~ "s") }}
 {% else %}
 {{ dbt_utils.log_info(message_prefix ~ ' Preskočeno odnosa "' ~ row.values() | join ('"."') ~ '" jer ne postoji') }}
 {% endif %}

 {% endfor %}

{% endmacro %}
DBT Cloud
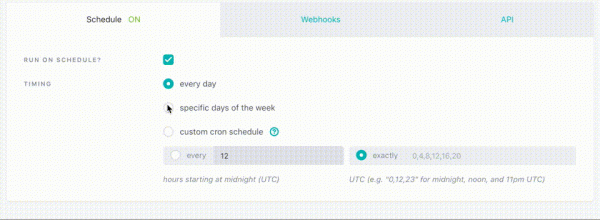
Postoji mogućnost korištenja DBT kao servisa (Upravljana usluga). Uključeno je:
- Web IDE za razvoj projekata i modela
- Konfiguracija poslova i raspored izvršenja
- Jednostavan i praktičan pristup logovima
- Web stranica s dokumentacijom vašeg projekta
- Povezivanje CI (Kontinuirana integracija)
Zaključak
Pripremiti i koristiti DWH postaje jednako prijatno i korisno kao piti smoothie. DBT se sastoji od Jinja, korisničkih proširenja (modula), kompajlera, izvršitelja (executor) i menadžera paketa. Okupljanjem ovih elemenata dobijate potpuno radno okruženje za vašu skladištenje podataka. Malo je verovatno da danas postoji bolji način za upravljanje transformacijama unutar DWH-a.
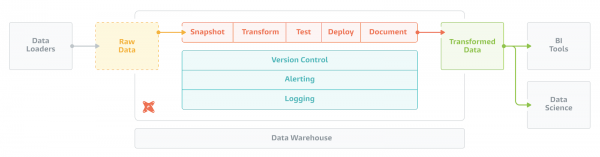
Uverenja koja su sledili DBT developeri formulišu se ovako:
- Kod, a ne GUI, je najbolja apstrakcija za izražavanje složene analitičke logike
- Rad sa podacima treba da prilagodi najbolje prakse razvoja softvera (Software Engineering)
- Najvažnija infrastruktura za rad sa podacima treba da se kontroliše od strane zajednice korisnika kao softver sa otvorenim izvorom
- Ne samo alati za analitiku, već i kod će sve više postajati deo Open Source zajednice
Ova osnovna uverenja su stvorila proizvod koji se danas koristi u više od 850 kompanija, i ona čine osnovu mnogih zanimljivih proširenja koja će biti razvijena u budućnosti.
Za one koje je to zainteresovalo, postoji video snimak otvorenog časa koji sam održao pre nekoliko meseci u okviru otvorenog časa u OTUS-u — .
Pored DBT-a i Skladišta podataka, u okviru kursa Data Engineer na platformi OTUS, moje kolege i ja vodimo nastavu o nizu drugih aktuelnih i modernih tema:
- Arhitektonske koncepcije aplikacija Velikih Podataka
- Praksa sa Spark-om i Spark Streaming-om
- Istraživanje načina i alata za učitavanje izvora podataka
- Izgradnja analitičkih izloga u DWH-u
- NoSQL koncepti: HBase, Cassandra, ElasticSearch
- Principi organizacije monitoringa i orkestracije
- Finalni Projekat: okupljanje svih veština pod mentorskih vođstvom
Linkovi:
- — Zvanična dokumentacija
- — Pregledni članak jednog od autora DBT-a
- — YouTube, Snimak otvorenog časa OTUS-a
- — Najbliži otvoreni čas 15. maja 2020.
- — OTUS
- — Pogled na budućnost rada sa podacima i analitikom
- — Evolucija analitike i uticaj Open Source-a
- — Principi izgradnje CI korišćenjem DBT-a
- — Praksa, korak po korak uputstva za samostalan rad
- — Github, kod edukacijskog projekta
Izvor: habr.com
