

Pozdrav, Habr! U Dodo Pizza Engineering jako volimo podatke (a tko ih danas ne voli?). Ovo je priča o tome kako prikupiti sve podatke svijeta Dodo Pizze i omogućiti svakom zaposleniku tvrtke lak pristup tom skupu podataka. Zadatak pod zvjezdicom: sačuvati živce tima za obradu podataka.
Kao pravi Pluškin, skupljamo razne informacije o radu naših pizzerija:
- pamtimo sve narudžbe korisnika;
- znamo koliko je vremena prošlo od izrade prve pizze u Syktyvkaru;
- vidimo koliko vremena pizza hladi na toploj polici u Voronežu upravo sada;
- čuvamo podatke o otpisu namirnica;
- i mnogo toga drugog.
Za rad s podacima u Dodo Pizzi trenutno je odgovorno nekoliko timova, a jedan od njih je tim za obradu podataka. Sada je pred nama zadaća: omogućiti svakom zaposleniku tvrtke lak pristup tom skupu podataka.
Kada smo počeli razmišljati o tome kako to učiniti i započeli raspravu, pronašli smo vrlo zanimljiv pristup upravljanju podacima – (u linku ćete pronaći ogroman sjajan članak). Njegove ideje su se vrlo dobro uklopile u naše predstave o tome kako želimo izgraditi naš sustav. U nastavku članka bit će naše preispitivanje pristupa i kako vidimo njegovu implementaciju u Dodo Pizza Engineering.
Što podrazumijevamo pod 'podacima'
Za početak, definirajmo što podrazumijevamo pod podacima u Dodo Pizza Engineering:
- Događaji koje šalju servisi (imamo zajedničku sabirnicu izgrađenu pomoću RabbitMQ);
- Zapisi unutar baze podataka (za nas su to MySQL i CosmosDB);
- Clickstream s mobilne aplikacije i web stranice.
Kako bi Dodo Pizza mogla koristiti ove podatke i oslanjati se na njih, važno je da se ispune sljedeći uvjeti:
- Oni moraju biti cjeloviti. Moramo biti sigurni da ne mijenjamo podatke tijekom obrade, pohrane i prikaza. Ako posao ne može vjerovati našim podacima, nećemo imati nikakve koristi od njih.
- Moru imati vremensku oznaku i ne smiju se brisati. To znači da želimo imati mogućnost da se bilo kada vratimo i pogledamo podatke iz tog vremenskog razdoblja. Na primjer, saznati koliko je pizza prodano 8. srpnja 2018. godine.
- Moru biti pouzdani. U procesu prikupljanja i pohrane podataka moramo paziti ne samo na cjelovitost, nego i na pouzdanost. Ne smijemo gubiti podatke, vremenske dijelove, jer zajedno s njima gubimo povjerenje naših klijenata (i vanjskih i unutarnjih).
- Moraju biti sa stabilnom shemom – pišemo upite za te podatke. Zbilja bismo voljeli da se promjenom koda aplikacije, refaktorizacijom, ne promijene toliko da naši upiti prestanu raditi. Onaj tko piše upite nikad ne sazna da ste napravili refaktorizaciju dok se sve ne pokvari. Ne bismo voljeli doznati to od klijenata.
Uzimajući u obzir sve ove zahtjeve, došli smo do zaključka da su podaci u Dodo proizvod. Isti kao javno API usluge. Prema tome, podacima treba upravljati istom ekipom koja upravlja uslugom. Također, promjene sheme podataka uvijek moraju biti unazad kompatibilne.
Tradicionalni pristup – Data Lake
Za rješavanje zadataka pouzdane pohrane i obrade velikih podataka postoji tradicionalni pristup, prihvaćen u mnogim firmama koje rade s takvim skupom informacija – Data Lake. U okviru ovog pristupa, inženjeri za podatke prikupljaju informacije sa svih komponenti sustava i pohranjuju ih u jedno veliko skladište (to može biti, primjerice, Hadoop, Azure Kusto, Apache Cassandra ili čak MySQL replikacija, ako se podaci mogu smjestiti u nju).
Nakon toga, ti isti inženjeri pišu upite za to skladište. Implementacija ovog pristupa u Dodo Pizza Engineering podrazumijeva da će tim Data Engineeringa upravljati shemom podataka u analitičkom skladištu.
U tom scenariju, tim postaje vrlo tužni mačići i evo zašto:
- Mora pratiti promjene u SVIM uslugama unutar tvrtke. A njih je mnogo i promjena je jako puno (u prosjeku spajamo ~100 pull zahtjeva tjedno, pri čemu mnoge usluge uopće ne rade pull zahtjeve).
- Prilikom promjene sheme podataka, proizvodni vlasnik i tim koji mijenja shemu podataka moraju čekati da Data Engineering napiše kod potreban za podršku promjenama. U međuvremenu, imamo situaciju u kojoj jedna ekipa čeka drugu – što je vrlo rijetko. I ne želimo da to postane 'normalan' dio procesa razvoja.
- Mora biti uronjena u CJELI tvrtke. Mreža pizzerija izgleda kao jednostavan posao, ali to je samo privid. Veoma je teško okupiti u jednom timu dovoljno kompetencija za izgradnju adekvatnog modela podataka za cijelu tvrtku.
- Ona je jedinstvena točka neuspjeha. Svaki put kada je potrebno promijeniti podatke koje servis vraća ili napisati upit, sve te zadatke prebacuje se timu za inženjering podataka. Na kraju, tim ima preopterećen backlog.
Ispada da se tim nalazi na raskrižju ogromnog broja potreba i vjerojatno ih neće moći zadovoljiti. Uz to, bit će u stalnoj jurnjavi i stresu. Ne želimo to. Stoga moramo razmišljati o tome kako riješiti te probleme i pritom dobiti mogućnost analize podataka.
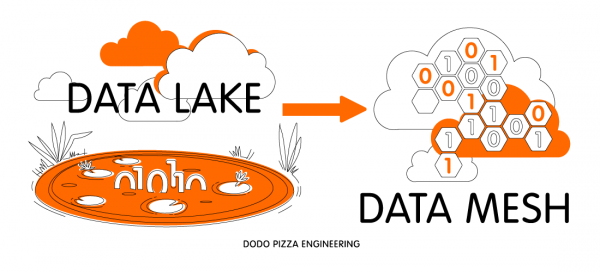
Prelazak s Data Lake-a na Data Mesh
Na sreću, ovo pitanje postavljali su si ne samo mi. U stvarnosti, sličan problem već je riješen u industriji (aleluja!). Samo u drugom području: implementaciji aplikacija. Da, govorim o DevOps pristupu, gdje tim određuje kako treba implementirati proizvod koji stvaraju.
Sličan pristup rješavanju problema Data Lake-a predložila je Zhamak Dehghani, konzultantica u ThoughtWorks-u. Promatrajući kako slične zadatke rješavaju Netflix i Spotify, napisala je sjajan članak (link na njega bio je na početku članka). Glavne ideje koje smo iz njega izveli su:
- Podijeliti veliki Data Lake na domene podataka, koje su vrlo slične domenama vođenim domenama (domain-driven design). Svaka domena je mali bounded context.
- Feature Team-ovi koji su odgovorni za DDD domene također su odgovorni za odgovarajuće domene podataka. Oni čuvaju shemu, unose u nju promjene, učitavaju podatke u nju. Uz to, sami sve znaju: kako promijeniti učitavanje podataka i ništa ne slomiti kada se aplikacija mijenja. Znanja ne odlaze nikamo. Da bi otvorili podatke, ne trebaju nikuda ići. Sam tim vodi potpuni ciklus razvoja od promjene operativnih podataka do pružanja analitičkih podataka trećim stranama. Jedan tim posjeduje sve povezano s domenom (kao poslovnom domenom, tako i domenom podataka).
- Data Engineer – uloga unutar Feature Team-a. Ne mora biti posebna osoba, ali je obavezno da tim posjeduje tu kompetenciju.
A u to vrijeme tim za inženjering podataka...
Ako zamislimo da se sve ovo ostvaruje s prstohvatom, ostaje nam samo da odgovorimo na dva pitanja:
Čime će se sada baviti tim Data Engineeringa? U Dodo Pizza Engineering već postoji tim za platformu/SRE. Njihov zadatak je omogućiti programerima alate za jednostavno postavljanje servisa. Tim Data Engineeringa će igrati istu ulogu, ali za podatke.
Pretvaranje operativnih podataka u analitičke je složen proces. Učiniti analitičke podatke dostupnima cijeloj tvrtki još je složenije. Tim Data Engineeringa će se baviti rješavanjem tih problema.
Namjeravamo pružiti Feature Teamu prikladan skup alata i praksi, zahvaljujući kojima će moći objavljivati podatke iz svojih servisa za ostatak tvrtke. Također, mi ćemo biti odgovorni za zajedničke infrastrukturne dijelove data pipelinea (redovi, pouzdano skladište, klasteri za izvođenje transformacija nad podacima).
Kako će vještine Data Engineera postati prisutne unutar Feature Teama? S Feature Teamom je složenije. Naravno, mogli bismo pokušati zaposliti po jednog Data Engineera u svaki od naših timova. No, to je jako teško. Teško je pronaći osobu s dobrim pozadinom u obradi podataka i uvjeriti je da radi unutar proizvodnih timova.
Velika prednost Doda je to što volimo interno obrazovanje. Tako da je naš plan trenutno ovakav: tim Data Engineeringa počinje objavljivati podatke nekih servisa, pati, muči se, ali nastavlja jesti kaktus. Čim shvatimo da imamo spreman proces za objavljivanje, počinjemo pričati o tome u Feature Teamu.
Imamo nekoliko načina kako to učiniti:
- , na kojem ćemo objasniti kako izgleda proces koji smo stvorili, koji alati postoje i kako ih najučinkovitije koristiti.
- Izlaganje na DevForumu pomoći će nam prikupiti povratne informacije od produktnih programera. Nakon toga, moći ćemo se pridružiti proizvodnim timovima i pomoći im u rješavanju zadatka objavljivanja podataka, organizirati obuke za timove.
Potrošnja podataka
Sada sam puno govorio o objavljivanju podataka. No, postoji i potrošnja. Što je s tim pitanjem?
Imamo sjajan BI tim koji piše vrlo složene izvještaje za upravljačku kompaniju. Unutar Dodo IS-a postoji mnogo izvještaja za naše partnere koji im pomažu u upravljanju pizzerijama. U našem novom modelu, razmišljamo o njima kao o potrošačima podataka, koji imaju svoje domene podataka. Potrošači će biti odgovorni za svoje vlastite domene. Ponekad se domena potrošača može opisati jednim upitom u analitičkom skladištu – i to je dobro. No, shvaćamo da to neće uvijek funkcionirati. Zato želimo da platforma koju ćemo stvoriti za produkcijske timove bude također upotrebljiva za potrošače podataka (jer u slučaju izvještaja unutar Dodo IS-a – to će biti isti timovi).
Ovako vidimo rad s podacima u Dodo Pizza Engineering. Rado ćemo pročitati vaše misli o tome u komentarima.
Izvor: habr.com
