

SQL, što može biti jednostavnije? Svaki od nas može napisati jednostavni upit — jednostavno unesemo select, navodimo potrebne kolone, a zatim from, naziv tablice, malo uvjeta u where i to je to — korisni podaci su nam u džepu, uz to (skoro) neovisno o tome koja je DBMS u pozadini (a možda i ). Kao rezultat, rad s gotovo bilo kojim izvorom podataka (relacijskim i onim manje relacijskim) može se promatrati kao obični kod (sa svim posljedicama — verzioniranje, pregled koda, statička analiza, automatizirani testovi i sve to). To se ne odnosi samo na same podatke, sheme i migracije, nego na cjelokupno funkcioniranje skladišta. U ovom članku razgovarat ćemo o svakodnevnim zadacima i problemima rada s raznim bazama podataka s naglaskom na "bazu podataka kao kod".
I započinjemo odmah s . Prvi sukobi tipa "SQL vs ORM" primijećeni su još u .
Objektno-relacijsko mapiranje
Pristaše ORM-a tradicionalno cijene brzinu i jednostavnost razvoja, neovisnost o DBMS-u i čistoću koda. Za mnoge od nas kod rada s bazom podataka (a često i sama baza podataka)
obično izgleda otprilike ovako…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Model je obogaćen pametnim anotacijama, a negdje u pozadini hrabri ORM generira i izvršava tone nekog SQL koda. Usput, programeri se svim snagama trude odvojiti se od svoje baze podataka kilometrima apstrakcija, što ukazuje na određeni .
S druge strane barikada, pristaše čistog "handmade"-SQL-a ističu mogućnost izvući maksimalnu korist iz svoje DBMS-a bez dodatnih slojeva i apstrakcija. Kao rezultat toga, pojavljuju se "data-centric" projekti, gdje se bazom bave posebno obučeni ljudi (oni su "bazisti", oni su "bazăvici", oni su "bazădnjecı" itd.), dok programerima ostaje samo da "povuku" gotove poglede i pohranjene procedure, ne upuštajući se u detalje.
A što ako uzmemo najbolje iz oba svijeta? Kako je to učinjeno u prekrasnom alatu s optimističnim imenom . Dati ću nekoliko redaka iz opće koncepcije u mom slobodnom prijevodu, a detaljnije se s njom možete upoznati .
Clojure je sjajan jezik za kreiranje DSL-ova, ali SQL je već sam po sebi sjajan DSL i ne trebamo još jedan. S-izrazi su prekrasni, ali ovdje ne dodaju ništa novo. Na kraju imamo zagrade samo radi zagrada. Ne slažete se? Onda pričekajte trenutak kada apstrakcija iznad baze podataka počne curiti i započet ćete borbu s funkcijom. (raw-sql)
Što učiniti? Ostavimo SQL običnim SQL-om — jedan datoteka za jedan upit:
-- ime: korisnici-po-državama
select *
  from users
 where country_code = :country_code
… a zatim pročitajte ovu datoteku, pretvarajući je u običnu Clojure funkciju:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Funkcija s imenom `users-po-državama` je stvorena.
;;; Iskoristimo je:
(users-po-državama {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Držeći se principa "SQL odvojeno, Clojure odvojeno", dobivate:
- Nema sintaktičkih iznenađenja. Vaša baza podataka (kao i bilo koja druga) ne odgovara SQL standardu 100% — ali za Yesql to nije važno. Nikada nećete trošiti vrijeme na lov za funkcijama čija je sintaksa ekvivalentna SQL-u. Nikada se nećete morati vraćati na funkciju (raw-sql "some (‘funky’ :: SYNTAX)")).
- Najbolja podrška za urednike. Vaš urednik već ima odličnu podršku za SQL. Čuvajući SQL kao SQL, jednostavno ga možete koristiti.
- Kompatibilnost s timom. Vaši DBA mogu čitati i pisati SQL koji koristite u svom Clojure projektu.
- Jednostavnija podešavanja performansi. Trebate izraditi plan za problematični upit? Nema problema kada je vaš upit običan SQL.
- Ponovno korištenje upita. Prevucite te iste SQL-datoteke u druge projekte, jer to je samo stari dobri SQL — jednostavno ga dijelite.
Po mom mišljenju, ideja je vrlo cool i istovremeno jednostavna, zbog čega je projekt dobio mnogo na raznim jezicima. A mi ćemo dalje pokušati primijeniti sličnu filozofiju odvajanja SQL koda od svega ostalog daleko izvan ORM-a.
IDE & DB-upravitelji
Počnimo s jednostavnim svakodnevnim zadatkom. Često nam je potrebno tražiti razne objekte u bazi podataka, na primjer, pronaći tablicu u shemi i istražiti njezinu strukturu (koje se kolone, ključevi, indeksi, ograničenja i drugo koriste). I od svake grafičke IDE ili malog DB-managera, prvo očekujemo upravo te sposobnosti. Da bi sve išlo brzo i da ne moramo čekati pola sata da se prikaže prozor s potrebnim informacijama (osobito pri sporoj vezi s udaljenom bazom podataka), i da pri tome dobijemo svježe i aktualne informacije, a ne zastarjeli cache. Što su baza i broj baza složeniji i veći, to je ovakav zadatak teži za ostvariti.
Ali obično odlažem miš u stranu i jednostavno pišem kod. Recimo, potrebno je saznati koje se tablice (i s kojim svojstvima) nalaze u shemi "HR". U većini SGBD-a željeni rezultat se može postići jednostavnim upitom iz information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
Od baze do baze sadržaj takvih referentnih tablica varira ovisno o sposobnostima svake SGBD. Na primjer, za MySQL iz te referentne tablice možemo dobiti specifične za tu SGBD parametre tablice:
select table_name
     , storage_engine -- Korišteni "motor" ("MyISAM", "InnoDB" itd.)
     , row_format     -- Format retka ("Fixed", "Dynamic" itd.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle ne podržava information_schema, ali ima , i ne javljaju se veliki problemi:
select table_name
     , pct_free       -- Minimalni slobodni prostor u podatkovnom bloku (%)
     , pct_used       -- Minimalno korišteno mjesto u podatkovnom bloku (%)
     , last_analyzed  -- Datum posljednjeg prikupljanja statistike
     , ...
  from all_tables
 where owner = 'HR'
Ni ClickHouse nije iznimka:
select name
     , engine -- Korišteni "motor" ("MergeTree", "Dictionary" itd.)
     , ...
  from system.tables
 where database = 'HR'
Nešto slično može se učiniti i u Cassandri (gdje postoji columnfamilies umjesto tablica i keyspace-ovi umjesto shema):
select columnfamily_name
     , compaction_strategy_class  -- Strategija kompresije
     , gc_grace_seconds           -- Vrijeme života smeća
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Za većinu drugih baza podataka također se mogu osmisliti slični upiti (čak i u Mongo postoji , koja sadrži informacije o svim kolekcijama u sustavu).
Naravno, na ovaj način možete dobiti informacije ne samo o tablicama, već i o bilo kojem objektu. Povremeno, dobri ljudi dijele takav kod za različite baze podataka, poput serije članaka na Habru "Funkcije za dokumentiranje baza podataka PostgreSQL" (, , ). Naravno, imati sve te upite u glavi i stalno ih unositi nije "baš sjajno" zadovoljstvo, pa u omiljenom IDE-u/uređivaču imam unaprijed pripremljen set snipeta za često korištene upite, i ostaje samo upisati imena objekata u predložak.
Na kraju, ovaj način navigacije i pretraživanja objekata daleko je fleksibilniji, štedi puno vremena i omogućuje dobivanje točno onih informacija u obliku u kojem su trenutno potrebne (kao što je opisano u postu ).
Operacije s objekti
Nakon što smo pronašli i proučili potrebne objekte, pravo je vrijeme da s njima učinimo nešto korisno. Naravno, također ne skidajući prste s tipkovnice.
Nije tajna da će jednostavno brisanje tablice izgledati gotovo identično u svim bazama podataka:
drop table hr.personsA stvaranje tablice je već zanimljivije. Gotovo svaki DBMS (uključujući mnoge NoSQL) na ovaj ili onaj način podržava "create table", a veliki dio toga će se malo razlikovati (ime, popis stupaca, tipovi podataka), no ostali detalji mogu se drastično razlikovati i ovise o unutarnjoj strukturi i mogućnostima određenog DBMS-a. Moj omiljeni primjer — u dokumentaciji Oracle samo "gole" BNF-ove za sintaksu "create table" . Drugi DBMS-ovi imaju skromnije mogućnosti, ali svaki od njih također ima mnoštvo zanimljivih i jedinstvenih značajki za stvaranje tablica (, , , ). Teško da bi neki grafički "čarobnjak" iz još jednog IDE-a (osobito univerzalnog) mogao potpuno obuhvatiti sve te sposobnosti, a ako i može, to će biti prizor koji nije za slabe živce. U isto vrijeme, pravilno i na vrijeme napisani operator create table omogućit će vam da bez problema iskoristite sve njih, učinite pohranu i pristup vašim podacima pouzdanim, optimalnim i maksimalno udobnim.
Također, u mnogim DBMS-ima postoje specifični tipovi objekata koji nedostaju u drugim DBMS-ima. Osim toga, možemo obavljati operacije ne samo nad objektima baze podataka, već i nad samim DBMS-om, poput "ubijanja" procesa, oslobađanja određenog dijela memorije, uključivanja praćenja, prelaska u način "samo za čitanje" i puno više.
A sada malo da crtamo
Jedan od najčešćih zadataka je izraditi dijagram s objektima baze podataka, vidjeti objekte i veze između njih na lijepoj slici. Ovo može gotovo svaka grafička IDE, posebne "command line" alate, specijalizirane grafičke alate i modele. Oni će vam nešto nacrtati "kako znaju", a malo utjecati na ovaj proces možete samo uz pomoć nekoliko parametara u konfiguracijskoj datoteci ili opcija u sučelju.
Međutim, ovaj problem može se riješiti mnogo jednostavnije, fleksibilnije i elegantnije, naravno, uz pomoć koda. Za izradnju dijagrama bilo koje složenosti imamo nekoliko specijaliziranih jezika označavanja (DOT, GraphML itd.), a uz njih cijeli niz aplikacija (GraphViz, PlantUML, Mermaid) koje znaju čitati takve upute i vizualizirati ih u raznim formatima. Informacije o objektima i vezama između njih već znamo kako dobiti.
Evo malog primjera kako bi to moglo izgledati, koristeći PlantUML i (lijevo SQL upit koji generira potrebnu uputu za PlantUML, a desno rezultat):
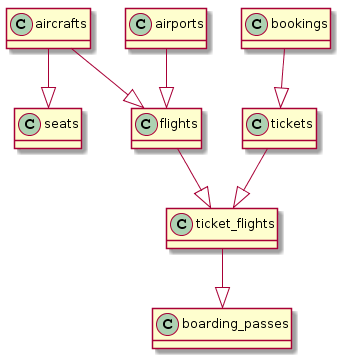
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
A ako malo više potrudite, na osnovu možete dobiti nešto što jako podsjeća na pravu ER dijagram:
SQL upit malo kompliciraniji
-- Naslov
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tablice
select format('Table(%s, "%s n informacije o %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Odnosi između tablica
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s može imati mnogo %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Podnožje
select '@enduml' 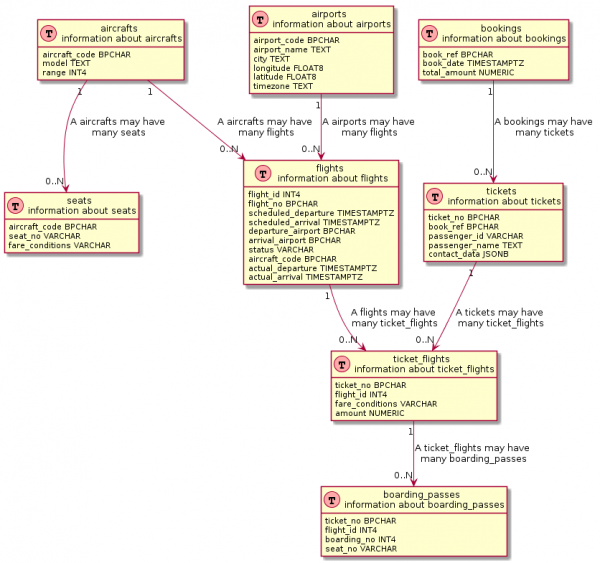
Ako pažljivo pogledate, mnogi alati za vizualizaciju također koriste slične upite. Međutim, ti su upiti obično duboko , da ne spominjem bilo kakvu njihovu modifikaciju.
Metrički i monitoring
Prelazimo na tradicionalno složenu temu — praćenje performansi baze podataka. Sjetit ću se jedne male istinite priče koju mi je ispričao "jedan moj prijatelj". U jednom projektu živio je moćni DBA, i malo tko od programera ga je osobno poznavao, a i uopće ga je tko ikada vidio (unatoč tome što je, prema glasinama, radio negdje u susjednoj zgradi). U trenutku "X", kada je produkcijski sustav velikog maloprodavača ponovno počinjao "loše raditi", on je šutke slao snimke zaslona grafikona iz Oracle Enterprise Managera, na kojima je pažljivo označavao kritična mjesta crvenim markerom za "jasnoću" (što, blago rečeno, slabo pomaže). I tako se na temelju te "fotografije" moralo liječiti. Pri tom nitko nije imao pristup dragocjenom (u oba smisla te riječi) Enterprise Manageru, jer je sustav složen i skup, a tko zna, možda bi "programeri nešto zgriješili i sve pokvarili". Stoga su programeri "empirijski" nalazili mjesto i uzrok usporavanja te ispuštali zakrpu. Ako prijeteće pismo od DBA nije stizalo ponovo u bliskoj budućnosti, svi su s olakšanjem uzdahnuli i vraćali se svojim trenutnim zadacima (do novog Pisma).
No proces praćenja može izgledati vedrije i prijateljskije, a najvažnije — dostupno i transparentno za sve. Barem njegova osnovna dijela, kao dodatak osnovnim sustavima praćenja (koji su svakako korisni i u mnogim slučajevima nezamjenjivi). Svaka SGBD slobodno i potpuno besplatno spremna je podijeliti informacije o svom trenutnom stanju i performansama. U istoj onoj "krvavoj" Oracle DB praktički se sve informacije o performansama mogu dobiti iz sustavnih prikaza, počevši od procesa i sesija do stanja predmemorije (na primjer, , odjeljak "Praćenje"). U PostgreSQL-u također postoji cijeli niz sustavnih prikaza za , posebice oni neizostavni u svakodnevnom životu svakog DBA, kao što su , , . U MySQL-u za to je predviđena čak i posebna shema . A u MongoDB ugrađeni agregira podatke o performansama u sustavnu kolekciju .
Dakle, opremljeni nekim sakupljačem metrika (Telegraf, Metricbeat, Collectd) koji može izvoditi prilagođene SQL upite, pohranom tih metrika (InfluxDB, Elasticsearch, Timescaledb) i vizualizatorom (Grafana, Kibana), možemo dobiti prilično lagani i fleksibilni sustav nadzora koji će biti čvrsto integriran s ostalim općim sistemskim metrikama (dobivenim, na primjer, od aplikacijskog servera, od OS-a itd.). Kao što je to slučaj u pgwatch2, gdje se koristi kombinacija InfluxDB + Grafana i set upita prema sistemskim pogledima, kojima također možemo .
U konačnici
I to je samo približan popis onoga što se može učiniti s našom BAZOM podataka pomoću običnog SQL koda. Siguran sam da se može pronaći još mnoštvo primjena, pišite u komentarima. A o tome kako (i što je najvažnije, zašto) to sve automatizirati i uključiti u svoj CI/CD pipeline ćemo razgovarati sljedeći put.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish