

Kako backend developer zna da će SQL upit dobro raditi na "produkciji"? U velikim ili brzo rastućim kompanijama pristup "produkciji" nije dostupan svima. Čak i s pristupom, nije moguće svakog upita bezbolno testirati, a kreiranje kopije baze podataka često traje satima. Da bismo riješili te probleme, stvorili smo umjetnog DBA - Joe. Već je uspješno implementiran u nekoliko kompanija i pomaže brojnim developerima.
Video:
Pozdrav svima! Moje ime je Anatolij Stansler. Radim u kompaniji . Bavimo se time da ubrzavamo proces razvoja, eliminirajući kašnjenja povezana s radom Postgres-a za developere, DBA i QA.
Imamo fantastične klijente i danas će dio izlaganja biti posvećen slučajevima s kojima smo se susreli u radu s njima. Ispričat ću kako smo im pomogli u rješavanju prilično ozbiljnih problema.
Kada radimo na razvoju i provodimo složene migracije, postavljamo si pitanje: "Hoće li ova migracija uspjeti?". Koristimo revizije, oslanjamo se na znanje iskusnijih kolega, DBA stručnjaka. Oni mogu reći – hoće li uspjeti ili ne.
Ali, možda bi bilo bolje da možemo sami testirati to na punim kopijama. Danas ćemo govoriti o trenutnim pristupima testiranju i kako to bolje raditi te s kojim alatima. Također ćemo razgovarati o plusovima i minusima takvih pristupa te što možemo ovdje poboljšati.
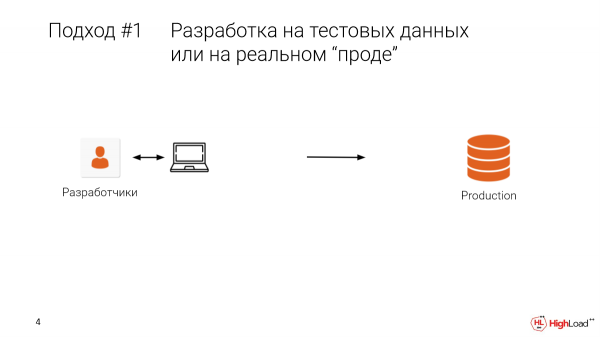
Tko je ikada pravio indekse ili unosio neke promjene direktno na produkciji? Prilično mnogo. A kod koga je to dovelo do gubitka podataka ili zastoja? Ako ste to doživjeli, poznajete tu bol. Hvala Bogu, imamo sigurnosne kopije.
Prvi pristup je testiranje na produkciji. Ili kada developer sjedi s lokalnog računala, ima testne podatke, postoji neka ograničena uzorak. I postavljamo to na produkciju, i dobivamo takvu situaciju.
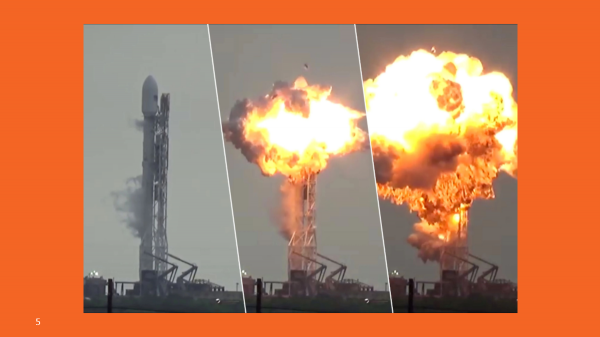
To boli, to je skupo. Vjerojatno je bolje da se to ne radi.
Kako to bolje uraditi?
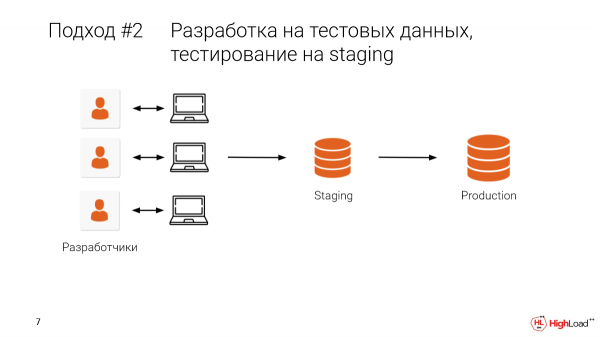
Hajde da uzmemo staging i dodijelimo joj dio produkcije. Ili u najboljem slučaju, uzmimo pravi produkciju, sve podatke. Nakon što smo lokalno razvili, dodatno ćemo provjeravati i na stagingu.
To će nam omogućiti da eliminiramo neke greške, tj. da ih ne dopustimo na produkciji.
Koji su problemi?
- Problem je u tome što ovaj staging dijelimo s kolegama. I vrlo često se dogodi da napraviš neku promjenu, bum – nema podataka, rad je uzaludan. Staging je bio višeterabajtni. I potrebno je dugo čekati da se ponovno podigne. I odlučujemo to doraditi sutra. Sve, razvoj nam je stao.
- I, naravno, imamo puno kolega koji rade, puno timova. I treba ručno usuglašavati. A to nije praktično.
I treba reći da imamo samo jedan pokušaj, jedan hitac, ako želimo unijeti neke promjene u bazu podataka, dotaknuti podatke, promijeniti strukturu. I ako nešto krene po zlu, ako je bila greška u migraciji, brza povratka više nema.
To je bolje od prethodnog pristupa, ali još uvijek postoji velika vjerojatnost da će neka greška otići na produkciju.
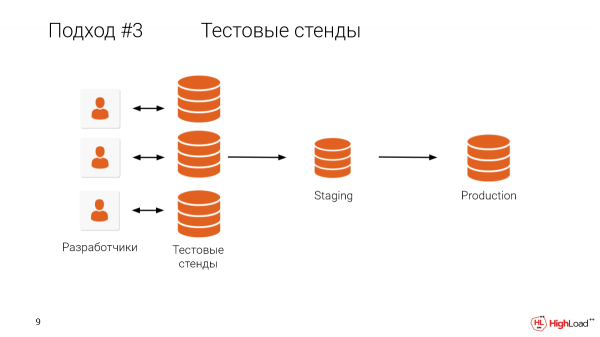
Što nas sprječava da svakom programeru damo testni stalak, punu kopiju? Mislim da je jasno što nas sprječava.
Tko ima bazu podataka veću od terabajta? Više od polovice dvorane.
I jasno je da održavati mašine za svakog programera, kada postoji tako velika produkcija, jako je skupo, a osim toga i dugo.
Imamo klijente koji su shvatili da je jako važno sve promjene testirati na punim kopijama, ali imaju baze manje od terabajta, a resursa da za svakog programera drže testni stalak nema. Stoga moraju preuzimati dumpove lokalno na svoje strojeve i testirati na taj način. To traje puno vremena.
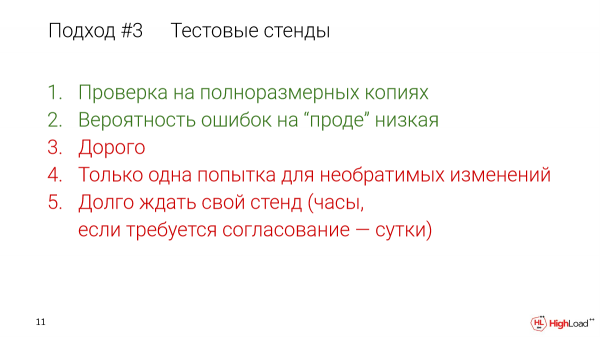
Čak i ako to radite unutar infrastrukture, preuzeti jedan terabajt podataka po satu – to je već jako dobro. Ali oni koriste logičke dumpove, preuzimaju lokalno iz clouda. Za njih je brzina oko 200 gigabajta po satu. I treba još vremena da se iz logičkog dumpa obrade indeksi itd.
Ali koriste taj pristup jer omogućuje održavanje prodajnog sustava pouzdanim.
Što možemo učiniti ovdje? Hajde da učinimo da testni stalci budu jeftini i da svakom programeru damo svoj vlastiti testni stalak.
I to je moguće.
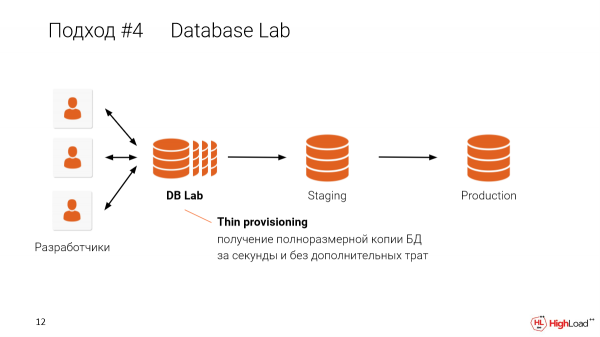
U ovom pristupu, kada pravimo tanke klonove za svakog programera, možemo to podijeliti na jednoj mašini. Na primjer, ako imate bazu podataka od četiri terabajta i želite je dati deset programera, ne trebate imati deset puta po četiri terabajta. Dovoljna vam je jedna mašina za stvaranje tankih izoliranih kopija za svakog programera, koristeći samo jednu mašinu. Kako to funkcionira, objasnit ću malo kasnije.
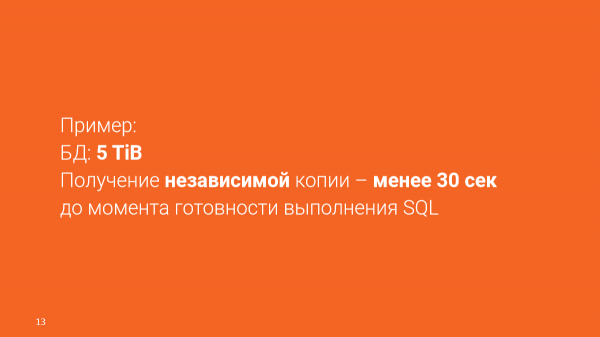
Stvarni primjer:
Baza podataka – 4,5 terabajta.
Možemo dobiti neovisne kopije u 30 sekundi.
Nema potrebe čekati testno okruženje ili ovisiti o tome kakvih je veličina. Možete ga dobiti za nekoliko sekundi. To će biti potpuno izolirana okruženja, ali koja dijele podatke međusobno.
To je sjajno. Ovdje govorimo o magiji i paralelnom svemiru.
U našem slučaju to funkcionira pomoću sustava OpenZFS.
OpenZFS je copy-on-write datotečni sustav koji iz kutije podržava snapshote i klonove. Pouzdan je i skalabilan. Vrlo je lako njime upravljati. Može se postaviti doslovno s dvije naredbe.
Postoje druge opcije:
LVM,
Sustavi pohrane podataka (npr. Pure Storage).
Database Lab o kojem govorim je modularan. Može se implementirati korištenjem takvih opcija. No, trenutno smo se fokusirali na OpenZFS jer su konkretno s LVM bilo problema.
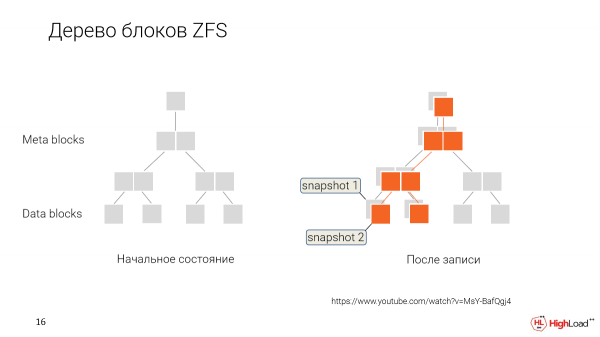
Kako to funkcionira? Umjesto da prepisujemo podatke svaki put kada ih mijenjamo, zadržavamo ih samo označavajući da su ti novi podaci povezani s novim trenutkom vremena, s novim snapshotom.
I kada želimo vratiti ili kada želimo napraviti novi klon s nekom starijom verzijom, jednostavno kažemo: "U redu, dajte nam te blokove podataka koji su tako označeni."
I taj korisnik će raditi s tim skupom podataka. Postupno će ih mijenjati, izrađivati svoje snapshote.
I imat ćemo grananje. Svaki programer u našem slučaju će imati mogućnost imati svoj vlastiti klon koji uređuje, a zajednički podaci će se dijeliti među svima.
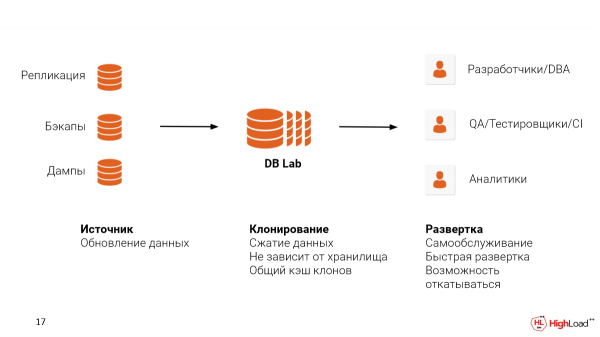
Da biste postavili takav sustav kod sebe, potrebno je riješiti dva problema:
Prvi je izvor podataka s kojeg ćete ih uzimati. Možete postaviti replikaciju s produkcijom. Možete koristiti već postojeće sigurnosne kopije koje ste postavili, nadam se. WAL-E, WAL-G ili Barman. Čak i ako koristite neko Cloud rješenje, poput RDS-a ili Cloud SQL-a, možete koristiti logičke isječke. No, ipak vam savjetujemo da koristite sigurnosne kopije, jer ćete ovakvim pristupom zadržati i fizičku strukturu datoteka, što će omogućiti bliže praćenje metrika koje biste vidjeli na produkciji, kako biste otkrili probleme koji postoje.
Drugo je mjesto gdje želite hostati Database Lab. To može biti Cloud, može biti On-premise. Važno je napomenuti da ZFS podržava kompresiju podataka. I to radi prilično dobro.
Zamislite da će svaki od tih klonova, ovisno o operacijama koje provodimo s bazom, povećati neki dev prostor. Za taj dev također će biti potrebno mjesta. No, budući da smo uzeli bazu od 4,5 terabajta, ZFS će je komprimirati na 3,5 terabajta. Ovisno o postavkama, to se može varirati. I još uvijek ćemo imati mjesta za dev.
Takav sustav se može koristiti za različite slučajeve.
Ovo su programeri, DBA za testiranje upita, za optimizaciju.
Može se koristiti u QA testiranju za provjeru konkretne migracije prije nego što to postavimo u prod. Također možemo podići posebna okruženja za QA s pravim podacima, gdje mogu testirati nove funkcionalnosti. I to će trajati sekunde umjesto da čekate sate, a možda i dane u nekim drugim slučajevima gdje se ne koriste tanke kopije.
I još jedan poseban slučaj. Ako u kompaniji nije postavljen analitički sustav, možemo odvojiti tanki klon proizvodne baze i dodati ga za duže upite ili specijalne indekse koji se mogu koristiti u analitici.
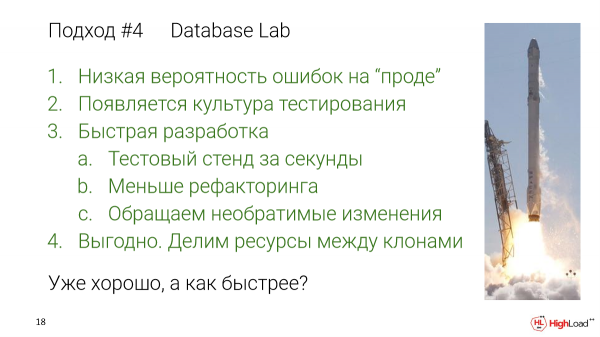
S ovakvim pristupom:
Niska vjerojatnost grešaka na ‘produkciji’, jer smo sve promjene testirali na punim podacima.
Pojavljuje nam se kultura testiranja, jer više nije potrebno satima čekati svoj vlastiti stan.
I nema prepreka, nema čekanja između testiranja. Stvarno možete ići i provjeriti. I tako će biti bolje, jer ćemo ubrzati razvoj.
Bit će manje refaktoriranja. Manje grešaka će dospjeti u prod. Manje će ih biti potrebno refaktorirati kasnije.
Možemo obavljati nepovratne promjene. To nije prisutno u standardnim pristupima.
- To je isplativo jer dijelimo resurse testnih okruženja.
Već je dobro, što još možemo ubrzati?
Zahvaljujući takvom sustavu, možemo znatno smanjiti prag ulaska u takvo testiranje.
Trenutno imamo začarani krug gdje programer, kako bi dobio pristup stvarnim, punim podacima, mora postati stručnjak. Mogu mu povjeriti takav pristup.
Ali kako rasti, ako toga nema? A što ako ti je dostupan samo vrlo mali skup testnih podataka? Tada ne možeš steći stvarno iskustvo.
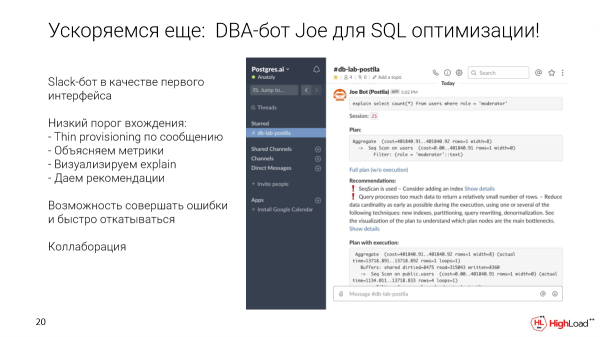
Kako izaći iz tog kruga? Kao prvi sučelje, prikladno za programere svih razina, odabrali smo Slack-bota. No, to može biti bilo koje drugo sučelje.
Što omogućuje? Možeš uzeti konkretan upit i poslati ga u poseban kanal za bazu podataka. Automatski ćemo u sekundi rasporediti tanušni klon. Izvršit ćemo taj upit. Prikupit ćemo metrike i preporuke. Prikazat ćemo vizualizaciju. A dalje će taj klon ostati kako bi se taj upit mogao optimizirati, dodati indeksi itd.
I također, Slack nam pruža mogućnosti za suradnju iz kutije. Budući da je to samo kanal, možeš odmah tamo u threadu za taj upit započeti raspravu o tom upitu, pingajući svoje kolege, DBA-e koji su unutar tvrtke.
No, naravno, postoje i problemi. Budući da je to stvarni svijet, i koristimo poslužitelj na kojem odmah hostamo mnogo klonova, moramo smanjiti količinu memorije i procesorske snage koja je dostupna klonovima.
Ali kako bi ti testovi bili vjerodostojni, potrebno je nekako riješiti taj problem.
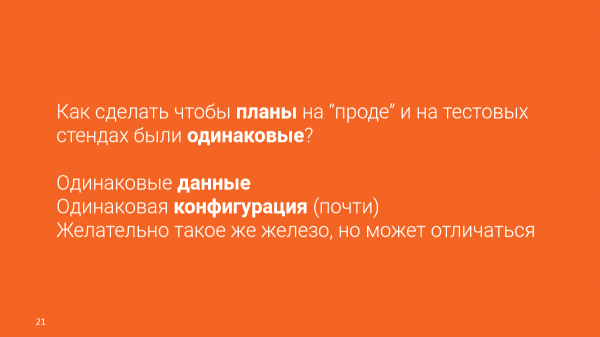
Jasno je da je važan moment imati jednake podatke. No, to već imamo. I želimo postići jednake konfiguracije. I možemo dati praktički jednake konfiguracije.
Bilo bi super imati istu opremu kao na produkciji, ali ona se može razlikovati.
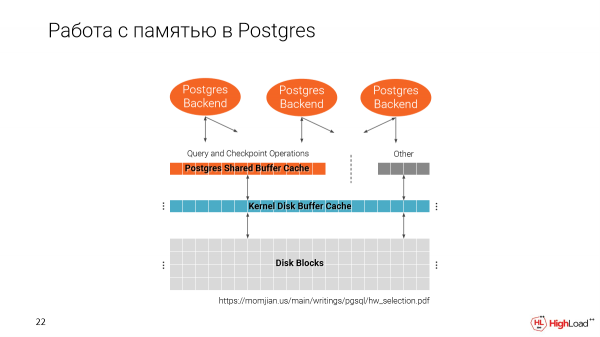
Podsjetimo se kako Postgres radi s memorijom. Imamo dvije predmemorije. Jedna je od datotečnog sustava, a druga je vlastita Postgres, tj. Shared Buffer Cache.
Važno je napomenuti da se Shared Buffer Cache alocira pri pokretanju Postgresa ovisno o veličini koju postavite u konfiguraciji.
A drugi keš koristi sav dostupan prostor.
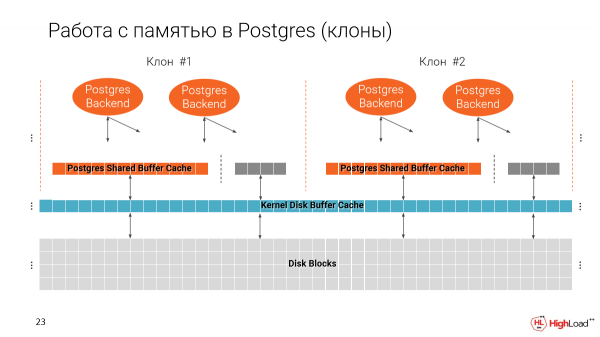
Kada pravimo više klonova na jednom stroju, postupno ispunjavamo memoriju. I idealno, Shared Buffer Cache trebao bi biti 25% od ukupne memorije dostupne na stroju.
Tako da, ako ne promijenimo ovaj parametar, možemo pokrenuti samo 4 instance na jednom stroju, odnosno samo 4 takva jednostavna klona. To je, naravno, loše jer želimo imati mnogo više.
S druge strane, Buffer Cache koristi se za izvršavanje upita, za indekse, tj. plan ovisi o veličini naših keševa. Ako samo smanjimo ovaj parametar, planovi se mogu značajno promijeniti.
Na primjer, ako imamo veliki keš na prodaji, Postgres će preferirati korištenje indeksa. A ako ne, tada će doći do SeqScan-a. I kakav bi imalo smisao ako se naši planovi ne bi podudarali?
Ali dolazimo do rješenja da plan u Postgresu zapravo ne ovisi o konkretnoj veličini zadanog u Shared Buffer-u, nego o effective_cache_size.
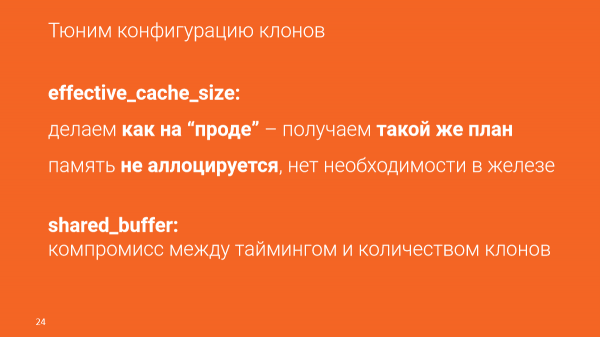
Effective_cache_size je predviđeni volumen keša koji nam je dostupan, tj. zbroj Buffer Cache-a i keša datotečnog sustava. To je zadano u konfiguraciji. I ta memorija se ne alocira.
Zahvaljujući ovom parametru možemo na neki način obmanuti Postgres, reći mu da nam je zapravo dostupno mnogo podataka, čak i ako tih podataka nemamo. Tako će se planovi potpuno podudarati s produkcijom.
I to može utjecati na vrijeme izvršavanja. Optimiziramo upite prema vremenu, ali važno je da vrijeme ovisi o mnogim faktorima:
Ovisi o opterećenju koje trenutno postoji na prodaji.
Ovisi o karakteristikama samog stroja.
To je neizravni parametar, ali zapravo možemo optimizirati prema količini podataka koje ovaj upit pročita kako bi dobio rezultat.
A ako želite da tajming bude bliži onome što ćemo vidjeti u prodaji, moramo uzeti maksimalno sličan hardver i, možda, čak i više kako bismo svi klonovi stali. No, to je kompromis, tj. dobit ćete iste planove, vidjet ćete koliko podataka obradi određeni upit i moći ćete donijeti zaključak – je li taj upit dobar (ili migracija) ili loš, i treba ga dodatno optimizirati.
Pogledajmo kako konkretno ide optimizacija s Joe-om.
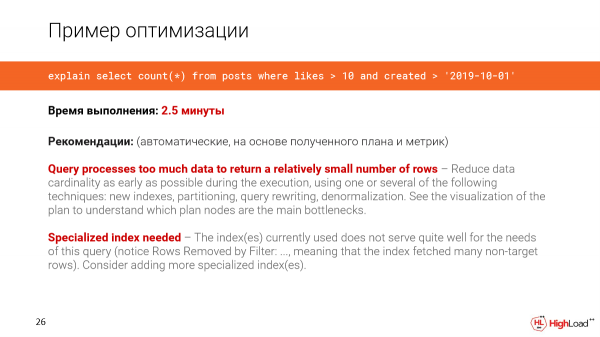
Uzmimo upit iz stvarnog sustava. U ovom slučaju, baza podataka ima 1 terabajt. I želimo izračunati broj svježih postova koji su imali više od 10 lajkova.
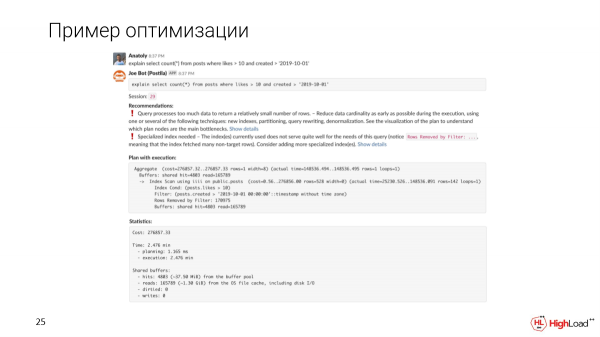
Pišemo poruku u kanal, klon se otvorio za nas. I vidjet ćemo da će se takav upit obraditi za 2,5 minute. To je prvo što ćemo primijetiti.
Joe će pokazati automatske preporuke temeljene na planu i metrike.
Vidjet ćemo da upit obrađuje previše podataka kako bi dobio relativno mali broj redaka. I potreban je neki specijalizirani indeks, budući da smo primijetili da je u upitu previše filtriranih redaka.
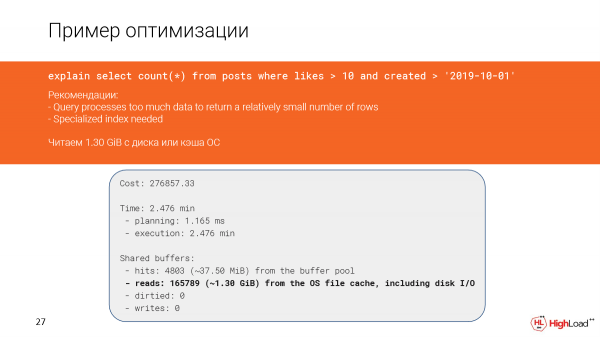
Pogledajmo detaljnije što se dogodilo. Doista, vidimo da smo pročitali skoro jedan i pol gigabajt podataka iz datotečnog predmemoriranja ili čak s diska. I to nije dobro, budući da smo dobili samo 142 retka.
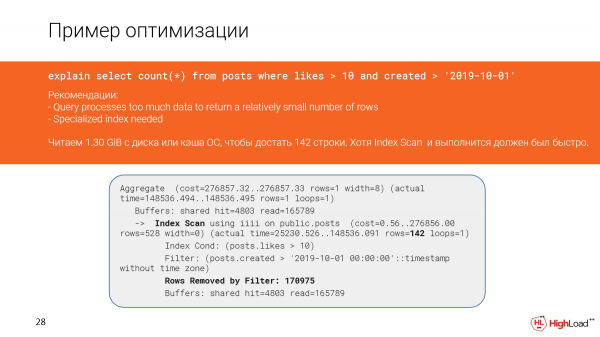
I, čini se, imamo ovdje index scan i trebao se brzo obraditi, no, budući da smo filtrirali previše redaka (morali smo ih izračunati), upit se sporo obradio.
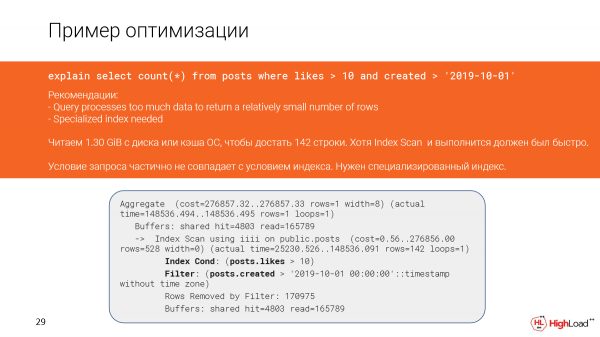
I to se dogodilo u planu zbog djelomične neusklađenosti uvjeta u upitu i uvjeta u indeksu.
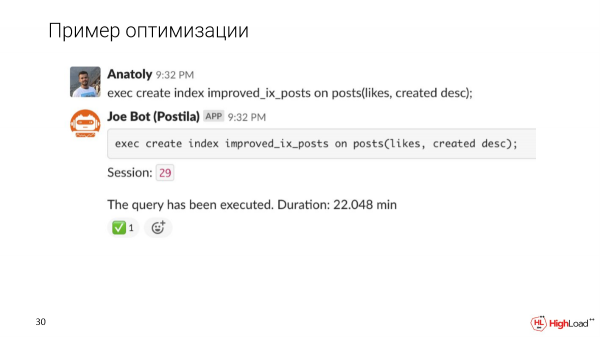
Pokušajmo napraviti indeks preciznijim i vidimo kako će se izvršenje upita promijeniti nakon toga.
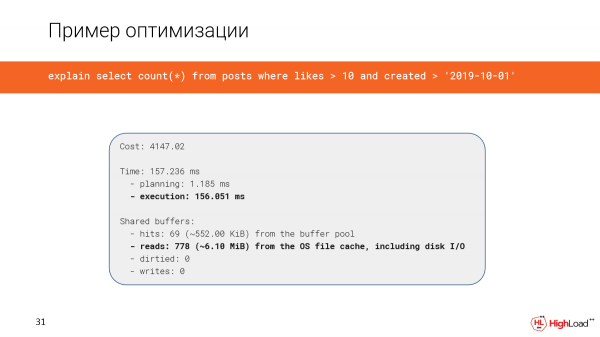
Kreiranje indeksa je potrajalo, ali sada provjeravamo upit i vidimo da je vrijeme umjesto 2,5 minute sada samo 156 milisekundi, što je dovoljno dobro. I čitamo samo 6 megabajta podataka.
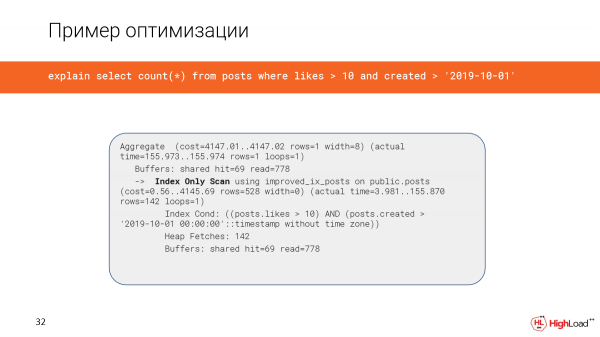
I sada koristimo index only scan.
Druga važna priča je da želimo plan predstaviti na neki više razumljiv način. Mi smo implementirali vizualizaciju pomoću Flame Graphs.
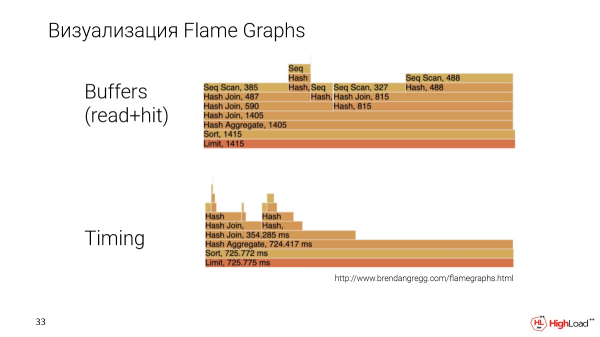
To je drugi upit, bogatiji. I Flame Graphs gradimo prema dva parametra: to su količina podataka koje je određena nod u planu pročitala i tajming, tj. vrijeme izvršenja noda.
Ovdje možemo usporediti konkretno čvorove međusobno. Bit će jasno koji od njih zauzima više ili manje prostora, što obično može biti teško učiniti s drugim načinima vizualizacije.
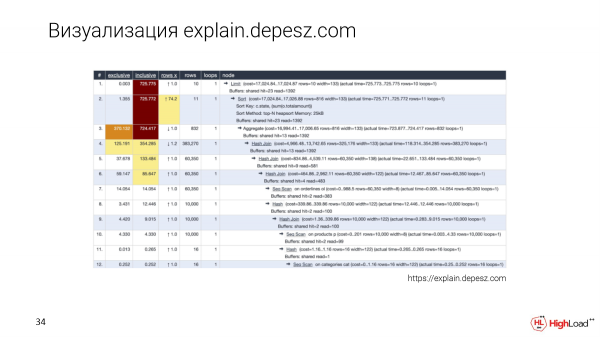
Naravno, svi znaju za explain.depesz.com. Dobra značajka ove vizualizacije je to što zadržavamo tekstualni plan i također ističemo neke osnovne parametre u tablici, kako bismo ih mogli sortirati.
I programeri koji se još nisu duboko zaronili u ovu temu također koriste explain.depesz.com, jer im je tako lakše shvatiti koje su metrike važne, a koje nisu.
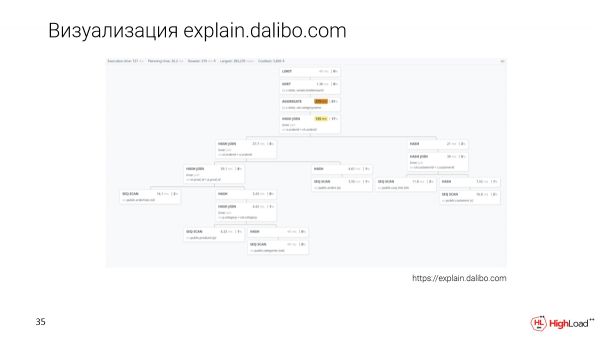
Postoji novi pristup vizualizaciji – explain.dalibo.com. Oni rade hijerarhijsku vizualizaciju, ali ovdje je jako teško usporediti čvorove međusobno. Ovdje se može dobro razumjeti struktura, međutim, ako bude veliki upit, potrebno je skrolati naprijed-natrag, ali i to je opcija.
Suradnja
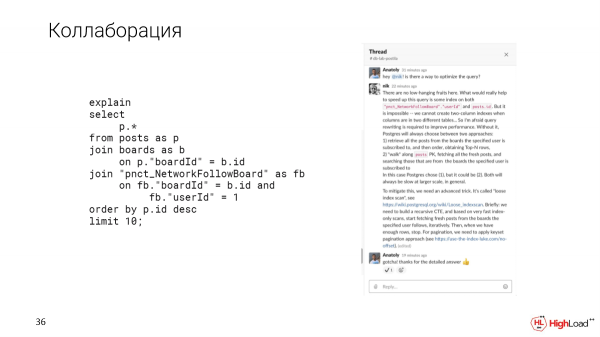
I, kao što sam već rekao, Slack nam pruža mogućnost suradnje. Na primjer, ako naiđemo na složen upit koji nije jasno kako optimizirati, možemo u thread-u u Slacku razjasniti to pitanje s kolegama.
Čini nam se važnim testirati na punim podacima. Za to smo napravili alat Update Database Lab, koji je dostupan kao open source. Također možete koristiti bota Joe. Možete ga uzeti odmah i implementirati kod sebe. Svi vodiči su tamo dostupni.
Važno je i napomenuti da samo rješenje nije revolucionarno, jer postoji Delphix, ali to je enterprise rješenje. Potpuno je zatvoreno i izuzetno skupo. Mi se specijaliziramo za Postgres. Svi naši proizvodi su open source. Pridružite nam se!
Time završavam. Hvala!
Pitanja
Pozdrav! Hvala na izlaganju! Jako zanimljivo, posebno za mene, jer sam otprilike istu takvu situaciju rješavao prije nekog vremena. Stoga imam cijeli niz pitanja. Nadam se da ću barem neka postaviti.
Zanima me kako proračunavate prostor za ovo okruženje? Tehnologija podrazumijeva da, pod određenim okolnostima, vaši klonovi mogu narasti do maksimalne veličine. Pojednostavljeno, ako imate deset terabajtnu bazu i 10 klonova, lako možete modelirati situaciju u kojoj bi svaki klon imao 10 jedinstvenih podataka. Kako proračunavate taj prostor, tj. onu razliku o kojoj ste govorili, u kojoj će živjeti ti klonovi?
Dobro pitanje. Ovdje je važno pratiti konkretne klonove. Ako se kod nekog klona dogodi prevelika promjena i on počne rasti, možemo prvo upozoriti korisnika na to ili odmah zaustaviti taj klon kako bismo izbjegli situaciju neuspjeha.
Da, imam dodatno pitanje. Odnosno, kako osiguravate životni ciklus ovih modula? To nam je problem i cijela posebna priča. Kako se to odvija?
Svaki klon ima neki TTL. U principu, imamo fiksni TTL.
Koji, ako nije tajna?
1 sat, odnosno neaktivno – 1 sat. Ako se ne koristi, mi ga brišemo. No, ovdje nema nikakvog iznenađenja, s obzirom da možemo klon podići za nekoliko sekundi. A ako ga opet zatrebamo, tu je.
Zanimaju me i tehnologije koje ste izabrali, jer mi, na primjer, paralelno koristimo nekoliko načina iz raznih razloga. Zašto baš ZFS? Zašto niste koristili LVM? Spomenuli ste da ste imali problema s LVM-om. Koji su to problemi? Po mom mišljenju, najoptimalnija opcija je ona sa SAN-om, s aspekta performansi.
Koji je glavni problem sa ZFS-om? To je to što ga moraš pokretati na jednom hostu, odnosno svi instance će živjeti unutar jednog operacijskog sustava. Dok kod SAN-a možeš povezivati različitu opremu. Usko mjesto su samo oni blokovi koji su na SAN-u. I zanimljivo je pitanje izbora tehnologija. Zašto ne LVM?
O LVM-u ćemo konkretno moći razgovarati na meetupu. Što se tiče SAN-a – to je jednostavno skupo. Sustav ZFS možemo implementirati bilo gdje. Možete ga postaviti na svom računalu. Možete jednostavno preuzeti repozitorij i postaviti ga. ZFS se instalira praktički svugdje, kada govorimo o Linuxu. Odnosno, dobijamo vrlo fleksibilno rješenje. I sam ZFS iz kutije nudi puno. Možeš tamo učitati koliko god podataka želiš, povezati veliki broj diskova, postoje snimci. I, kao što sam već rekao, lako je administratorirati. Odnosno, čini se vrlo ugodnim za korištenje. Provjeren je, postoji već dugi niz godina. Ima vrlo veliku zajednicu koja raste. ZFS je vrlo pouzdano rješenje.
Nikolaj Samokhvalov: Mogu li još komentirati? Zovem se Nikolaj, radim zajedno s Anatolijem. Slažem se da je SAN odličan. I neki naši klijenti imaju Pure Storage itd.
Anatolij je ispravno primijetio da nastojimo na modularnosti. U budućnosti bi se mogao realizirati jedan sučelje - napravi snimku, napravi klon, uništi klon. Sve je to jednostavno. A SAN je odličan, ako ga imate.
Ali ZFS je dostupan svima. Dosta je DelPhixa, imaju 300 klijenata. Od njih u Fortune 100 - 50 klijenata, tj. ciljaju NASA-u itd. Vrijeme je da ova tehnologija bude dostupna svima. Zato imamo open source Core. Imamo dio sučelja koje nije open source. To je platforma koju ćemo pokazati. No, želimo da to bude dostupno svima. Želimo napraviti revoluciju kako bi svi testeri prestali nagađati na prijenosnicima. Moramo pisati SELECT i odmah vidjeti ako je spor. Dosta je čekanja da nam o tome kaže DBA. To je glavni cilj. I mislim da ćemo svi doći do toga. I ovu stvar radimo kako bi je imali svi. Zato ZFS, jer će biti dostupan svugdje. Hvala zajednici za rješavanje problema i za to što ima open source licencu itd.
Pozdrav! Hvala na izlaganju! Zovem se Maksim. Riješavali smo slične probleme. U sebi smo ih riješili. Kako ste podijelili resurse između tih klonova? Svaki klon može u svakom trenutku raditi svoje: jedan testira jedno, drugi drugo, nekom se gradi indeks, nekome teži job radi. I ako se CPU još može podijeliti, kako dijelite IO?
I drugo pitanje o neusklađenosti okruženja. Recimo, ovdje imam ZFS i sve je u redu, a klijent na produkciji nema ZFS, nego ext4, na primjer. Što u tom slučaju?
Pitanja su vrlo dobra. Spomenuo sam malo ovaj problem s dijeljenjem resursa. Rješenje je sljedeće. Zamislite da testirate na stagingu. Može se dogoditi da netko daje jednu opterećenje, dok netko drugi daje drugo. I na kraju vidite nejasne metrike. Čak i isti problem se može pojaviti na produkciji. Kada želite provjeriti neki upit i vidite da ima problem – sporo se izvršava, zapravo problem nije bio u upitu, nego u tome što postoji neko paralelno opterećenje.
I zato je važno fokusirati se na to kakav će biti plan, kroz koje korake ćemo ići u planu i koliko podataka ćemo prikupiti za to. To što ćemo imati diskove, recimo, opterećene nečim, konkretno će utjecati na vremenske okvire. Ali možemo procijeniti broj podataka koliko je taj upit opterećen. Nije toliko važno što će se istovremeno izvoditi još neka operacija.
Imam dva pitanja. Ovo je stvarno odlična stvar. Da li je bilo slučajeva kada su podaci na produkciji kritično važni, primjerice brojevi kreditnih kartica? Ima li već nešto spremno ili je to odvojen zadatak? I drugo pitanje – postoji li nešto slično za MySQL?
Što se tiče podataka. Mi ćemo vršiti obfuscaciju, dok to ne učinimo. Ali ako postavljate isključivo Joe-a, ako ne dajete pristup developerima, tada nema pristupa podacima. Zašto? Jer Joe ne prikazuje podatke. On prikazuje samo metrike, planove i tako dalje. To je namjerno učinjeno jer – to je jedan od zahtjeva našeg klijenta. Željeli su imati mogućnost optimizacije, ali ne dati svima pristup.
Što se tiče MySQL-a. Ovaj sustav se može koristiti za bilo što što pohranjuje stanje na disku. I pošto se bavimo Postgresom, trenutno u prvom redu radimo potpunu automatizaciju za Postgres. Želimo automatizirati dobivanje podataka iz backupa. Pravilno konfiguriramo Postgres. Znamo kako osigurati da se planovi poklapaju i tako dalje.
Ali pošto je sustav proširiv, moći će se koristiti i za MySQL. I postoje takvi primjeri. Slična stvar postoji u Yandexu, ali je ne objavljuju nigdje. Koriste je unutar Yandex.Metrike. I tamo je zapravo priča o MySQL-u. Ali tehnologije su iste, ZFS.
Hvala na prezentaciji! Imam i ja nekoliko pitanja. Spomenuli ste da se kloniranje može koristiti za analitiku, na primjer, za izradu dodatnih indeksa. Možete li malo detaljnije objasniti kako to funkcioniše?
I odmah ću postaviti drugo pitanje u vezi uniformnosti postavki, uniformnosti planova. Plan zavisi između ostalog od statistike koju prikuplja Postgres. Kako rješavate ovaj problem?
Nema analize konkretnih slučajeva, jer to još nismo koristili, ali takva mogućnost postoji. Ako govorimo o indeksima, zamislite da se pokreće upit po tablici sa stotinama milijuna zapisa i po stupcu koji obično nije indeksiran u produkciji. A mi želimo izračunati određene podatke. Ako taj upit pokrenemo u produkciji, postoji mogućnost da će doći do zastoja jer će upit trajati minutu.
U redu, napravimo tanak klon kojeg nije strah zaustaviti na nekoliko minuta. Kako bi nam bilo lakše analizirati podatke, dodajmo indekse na one stupce koji nas zanimaju.
Hoće li se indeks svaki put stvarati?
Može se napraviti tako da dodirnemo podatke, napravimo snimke, a zatim ćemo se obnavljati s te snimke i pokretati nove upite. To znači da možemo pokretati nove klonove s već postavljenim indeksima.
Što se tiče pitanja vezanog za statistiku, ako se obnavljamo iz sigurnosne kopije, ako radimo replikaciju, tada će naša statistika biti identična. Jer ćemo prenijeti cijelu fizičku strukturu podataka, tj. podatke u svom cjelovitom obliku sa svim metrima statistike.
Ovdje je drugi problem. Ako koristite cloud rješenje, tada su dostupne samo logičke izrade, jer Google, Amazon ne daju fizičke kopije. Tada će nastati takav problem.
Hvala na izlaganju. Postavila su se dva dobra pitanja o MySQL-u i o razdvajanju resursa. No, u suštini, sve se svodi na to da je ovo tema koja nije specifična za pojedine DBMS-ove, već se odnosi na ukupni datotečni sustav. Tako da se pitanja razdvajanja resursa također trebaju rješavati odatle, a ne na kraju da je to Postgres, nego u datotečnom sustavu, u serveru, u instanci.
Moje pitanje je malo drugačije. Ono je više orijentirano na višeslojnost baze podataka, gdje postoje nekoliko slojeva. Na primjer, postavili smo ažuriranje deset terabajtnog imidža, imamo replikaciju. Konkretno koristimo to rješenje za baze podataka. Idemo s replikacijom, dolazi do ažuriranja podataka. U isto vrijeme, 100 zaposlenika paralelno radi, stalno pokrećući te različite snimke. Što učiniti? Kako osigurati da ne dođe do sukoba, da su pokrenuli jedno, a zatim se datotečni sustav promijenio, i da su te snimke svi pogrešne?
Oni neće putovati jer tako ZFS radi. Možemo zadržati odvojeno u jednom tijeku promjene datotečnog sustava, koje dolaze zahvaljujući replikaciji. I čuvati klonove na starijim verzijama podataka koje programeri koriste. I to nam radi, s tim je sve u redu.
Ispada da će se ažuriranje događati kao dodatni sloj, a sve nove snimke će se bazirati na tom sloju, zar ne?
Iz prethodnih slojeva koji su bili iz prethodnih replikacija.
Prethodni slojevi će otpasti, ali će se referencirati na stari sloj, a nove slike će se uzimati s posljednjeg sloja koji je izveden tijekom ažuriranja?
Uglavnom, da.
Dakle, kao posljedica, imat ćemo mnogo slojeva. I s vremenom će ih trebati smanjiti?
Da, točno. Postoji određeni prozor. Čuvamo tjedne snimke. To ovisi o tome kakav resurs imate. Ako imate mogućnost čuvanja mnogo podataka, možete čuvati snimke dulje vremena. One se same neće obrisati. Nema korupcije podataka. Ako snimke postanu zastarjele, kako mislimo, tj. ovisno o politici u tvrtki, možemo ih jednostavno obrisati i osloboditi prostor.
Dobar dan, hvala na izlaganju! Što se tiče pitanja Joea. Rekli ste da naručitelj nije želio dati pristup svim osobama podacima. Strogo govoreći, ako netko ima rezultat Explain Analyze, može pregledavati podatke.
Svejedno. Na primjer, možemo napisati: „SELECT FROM WHERE email = nekome“. Tj. nećemo vidjeti same podatke, ali možemo pogledati neke posredne oznake. To treba razumjeti. Ali, s druge strane, sve ovo je vidljivo. Imamo reviziju dnevnika, imamo kontrolu drugih kolega koji također vide čime se programeri bave. I ako netko pokuša to napraviti, služba sigurnosti će doći do njih i riješiti taj problem.
Dobar dan! Hvala na izlaganju! Imam kratko pitanje. Ako se Slack ne koristi u tvrtki, postoji li ikakva povezanost s njim ili je moguće za programere postaviti instance kako bi se povezali s testnim aplikacijama u bazi?
Trenutno postoji povezanost sa Slackom, tj. nema druge aplikacije za razmjenu poruka, ali želimo omogućiti i podršku za druge aplikacije. Što možete učiniti? Možete pokrenuti DB Lab bez Joe-a, koristiti REST API ili našu platformu za izradu klonova i povezivanje s PSQL-om. No to može biti moguće samo ako ste spremni dati svojim programerima pristup podacima, jer tu već neće biti nikakvog sučelja.
Ova posrednička usluga nije mi potrebna, već mi je potrebna ta mogućnost.
U tom slučaju – da, to se može učiniti.
Izvor: habr.com
