

Pozdrav svima! Moje ime je Oleg Sidorenko, radim u tvrtki DomClick kao voditelj infrastrukturnog tima. Već više od tri godine koristimo "Kubik" u produkciji, i tokom tog vremenskog razdoblja doživjeli smo mnoge zanimljive trenutke. Danas ću vam ispričati kako uz pravi pristup možete iz "vanilnog" Kubernetesa izvući još veću učinak za svoj klaster. Spremni, pozor, krenimo!
Svi dobro znate da je Kubernetes skalabilni sustav s otvorenim kodom za orkestraciju kontejnera; ili, ili 5 binarnih datoteka koje čine čaroliju upravljajući životnim ciklusom vaših mikroservisa u poslužiteljskoj okolini. Osim toga, to je prilično fleksibilan alat koji se može sastaviti poput Lego kockica za maksimalnu prilagodbu različitim zadacima.
I kao da je sve u redu: bacajte servere u klaster, poput drva u peć, i ne brinite. No, ako ste za ekologiju, zapitat ćete se: "Kako mogu održavati vatru u peći, a istovremeno štititi šumu?" Drugim riječima, kako pronaći načine za poboljšanje infrastrukture i smanjenje troškova.
1. Pratite resurse timova i aplikacija
Jedna od najbanalnijih, ali najdjelotvornijih metoda je uvođenje requests/limits. Podijelite aplikacije po namespace-ima, a namespace-e po timovima razvoja. Zadajte aplikaciji vrijednosti potrošnje procesorskog vremena, memorije i efemernog prostora za pohranu prije nego što je implementirate.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Iskustvom smo došli do zaključka: ne bi trebalo napuhavati zahtjeve od limita više od dva puta. Volumen klastera se izračunava na temelju zahtjeva, i ako zadate aplikacijama razliku u resursima, na primjer, 5-10 puta, zamislite što će se dogoditi s vašom nodom kada se napuni podovima i iznenada dobije opterećenje. Ništa dobro. U najmanju ruku, throttling, a u najboljem slučaju, oprostit ćete se od radnika i dobiti cikličko opterećenje na ostalim nodama nakon što podovi počnu preseljenje.
Osim toga, putem limitranges na početku možete zadaći za kontejner vrijednosti resursa — minimalne, maksimalne i prema zadanim postavkama:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Ne zaboravite ograničiti resurse prostora imena kako jedna ekipa ne bi mogla uzeti sve resurse klastera:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Kao što se može vidjeti iz opisa resourcequotas, ako ekipa ops želi postaviti podove koji će trošiti još 10 cpu, planer neće dopustiti to i prikazat će pogrešku:
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10Za rješavanje takvog problema moguće je napisati alat, na primjer, kao , koji može skladištiti i komitirati stanje resursa ekipa.
2. Odaberite optimalnu pohranu datoteka
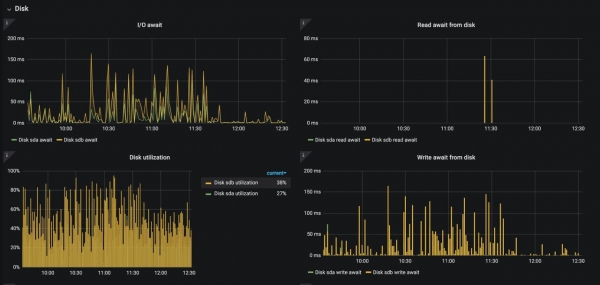
Ovdje bih želio dotaknuti temu trajnih volumena i diskovnog sustava radnih čvorova Kubernetes-a. Nadam se da nitko ne koristi "KUB" na HDD-u u produkciji, ali ponekad čak i obični SSD postaje nedovoljan. Našli smo se pred problemom da su dnevnički zapisi uništavali disk zbog operacija ulaz/izlaz, a opcija rješenja nije mnogo:
Upotrijebite visoko performantne SSD-e ili pređite na NVMe (ako sami rukujete svojim hardverom).
Smanjite razinu dnevničkog zapisa.
Učinite "pametan" balans podova koji opterećuju disk (
podAntiAffinity).
Screens above shows what happens to the nginx-ingress-controller with the disk when access_logs logging is enabled (~12k logs/sec.). This state can surely lead to degradation of all applications on that node.
Što se tiče PV, nažalost, nisam isprobao sve Trajne Volumen. Odaberite najbolju opciju koja vam najbolje odgovara. Historijski, mala grupa naših usluga zahtijeva RWX volumene, a za tu svrhu se oduvijek koristi NFS skladište. Jeftino i… dovoljno. Naravno, imali smo svojih problema — ali smo naučili kako ga optimizirati, tako da više ne brinemo. A ako je moguće, pređite na objektno skladište S3.
3. Prikupite optimizirane slike
Najbolje je koristiti slike optimizirane za kontejnere, kako bi Kubernetes mogao brže pristupiti njima i učinkovitije ih izvoditi.
Optimiziranost znači da slike:
sadrže samo jednu aplikaciju ili obavljaju samo jednu funkciju;
imaju mali volumen, jer velike slike lošije prolaze kroz mrežu;
imaju točke za provjeru ispravnosti i spremnosti, pomoću kojih Kubernetes može poduzeti mjere u slučaju zastoja;
koriste operacijske sustave prijateljske prema kontejnerima (poput Alpine ili CoreOS), koji su otporniji na greške u konfiguraciji;
koriste višestepene gradnje, tako da možete implementirati samo kompilirane aplikacije, a ne pripadajuće izvorne kodove.
Postoji mnogo alata i usluga koje omogućuju provjeru i optimizaciju slika u trenutku. Važno je uvijek održavati ih ažuriranima i sigurnima. Na kraju dobijate:
Smanjenje mrežnog opterećenja na cijelom klasteru.
Smanjenje vremena pokretanja kontejnera.
Manji volumen vaše Docker registracije.
4. Koristite DNS keš
Što se tiče visokih opterećenja, bez optimiziranja DNS sustava klastera živjeti je prilično teško. Davno su developeri Kubernetes-a podržali svoje rješenje kube-dns. Uvedeno je i kod nas, ali taj softver nije bio posebno optimiziran i nije pružao potrebne performanse, iako se činilo da je zadatak jednostavan. Zatim se pojavio coredns, na koji smo prešli i nismo imali problema, a kasnije je postao zadan DNS servis u K8s. U nekom trenutku dostigli smo 40 tisuća rps prema DNS sustavu, i ovo rješenje također je postalo nedovoljno. No, sretnim slučajem, izašao je Nodelocaldns, također poznat kao node local cache, također .
Zašto to koristimo? U Linux jezgri postoji greška koja, prilikom višestrukih poziva putem conntrack NAT za UDP, dovodi do stanja utrke pri zapisivanju u conntrack tablice, a dio prometa putem NAT-a se gubi (svaki posjet putem usluge je NAT). Nodelocaldns rješava ovaj problem eliminiranjem NAT-a i nadogradnjom veze na TCP prema uzvodnim DNS-ovima, kao i lokalnim keširanjem DNS upita prema uzvodnim (uključujući kratki 5-sekundni negativni keš).
5. Automatski skalirajte podove horizontalno i vertikalno
Možete li s povjerenjem reći da su svi vaši mikroservisi spremni za dvostruko ili trostruko povećanje opterećenja? Kako ispravno dodijeliti resurse svojim aplikacijama? Držanje nekoliko podova aktivnim iznad radnog opterećenja može se pokazati suvišnim, a držanje na rubu znači da riskirate izprazniti zbog iznenadnog porasta prometa na uslugu. Zlatna sredina pomaže postići čarobna usluga kao što su i .
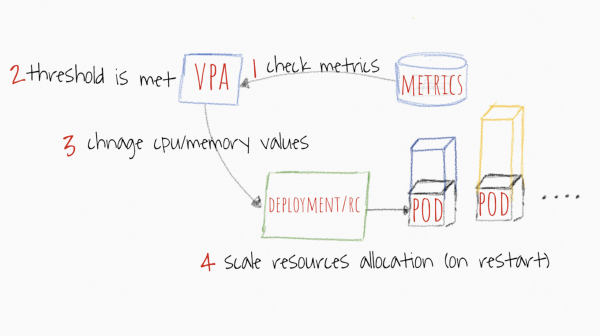
VPA omogućuje automatsko povećavanje requests/limits vaših kontejnera u podu ovisno o stvarnoj potrošnji. Kako može biti koristan? Ako imate podove koje iz nekog razloga ne možete horizontalno skalirati (što nije potpuno pouzdano), možete pokušati prepustiti promjenu njegovih resursa VPA-u. Njegova funkcija leži u sustavu preporuka temeljenom na povijesnim i trenutnim podacima iz metric-servera, tako da, ako ne želite automatski mijenjati requests/limits, jednostavno možete pratiti preporučene resurse za vaše kontejnere i optimizirati postavke radi uštede CPU-a i memorije u klasteru.
 Slika preuzeta s https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Planer u Kubernetesu uvijek se temelji na requests. Koju god vrijednost tamo stavili, planer će tražiti odgovarajući čvor na osnovu nje. Vrijednosti limits su potrebne kubeletu kako bi razumio kada treba ograničiti ili ubiti pod. I budući da je jedini važan parametar — vrijednost requests, VPA će raditi s njom. Svaki put kada postavljate vertikalno skaliranje aplikacije, definirate kakve bi trebale biti requests. A što će onda biti s limits? Ova će se vrijednost također proporcionalno skalirati.
Na primjer, evo uobičajenih postavki poda:
resursi:
   zahtjevi:
     memorija: 250Mi
     cpu: 200m
   ograničenja:
     memorija: 500Mi
     cpu: 350m
Mehanizam preporuka utvrđuje da vašoj aplikaciji za normalan rad treba 300m CPU i 500Mi. Dobit ćete takve postavke:
resursi:
   zahtjevi:
     memorija: 500Mi
     cpu: 300m
   ograničenja:
     memorija: 1000Mi
     cpu: 525m
Kao što je ranije spomenuto, ovo je proporcionalno skaliranje na temelju omjera zahtjeva/ograničenja u manifestu:
CPU: 200m → 300m: omjer 1:1.75;
Memorija: 250Mi → 500Mi: omjer 1:2.
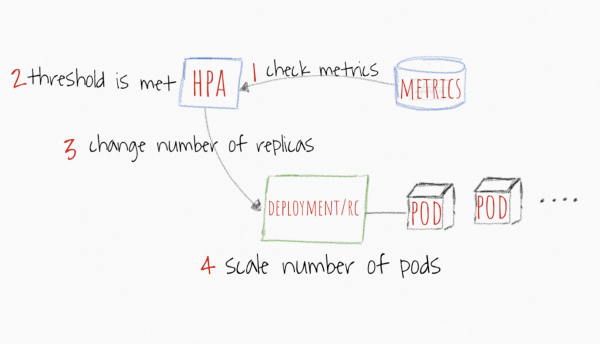
Što se tiče HPA, ovdje je mehanizam rada jasniji. Postavljaju se pragovni vrijednosti metrika, primjerice, procesora i memorije, i ako je prosječna vrijednost svih replika iznad praga, aplikacija se skalira za +1 pod sve dok vrijednost ne padne ispod praga, ili dok se ne postigne maksimalan broj replika.
 Slika preuzeta s https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Osim uobičajenih metrika, poput procesora i memorije, možete postaviti pragove na svojim prilagođenim metrikama iz Prometheusa i raditi s njima ako smatrate da je to najtočnije određivanje kada treba skalirati vašu aplikaciju. Nakon što se aplikacija stabilizira ispod zadane granice metrike, HPA će početi skalirati pode za dolje do minimalnog broja replika ili dok opterećenje ne odgovara zadanom pragu.
6. Ne zaboravite na Node Affinity i Pod Affinity
Ne rade svi čvorovi na istom hardveru, a ne trebaju svim podovima izvršavati aplikacije koje zahtijevaju intenzivne proračune. Kubernetes omogućava postavljanje specijalizacije čvorova i podova putem Node Affinity i Pod Affinity.
Ako imate čvorove pogodne za operacije s intenzivnim proračunima, za maksimalnu učinkovitost je najbolje vezati aplikacije za odgovarajuće čvorove. Za to koristite nodeSelector s oznakom čvora.
Pretpostavimo, imate dva čvora: jedan s CPUType=HIGHFREQ i velikim brojem brzih jezgri, drugi s MemoryType=HIGHMEMORY velikim brojem memorije i boljim performansama. Najjednostavnije je dodijeliti raspoređivanje poda čvoru HIGHFREQ, dodajući u odjeljak spec takav selektor:
…
nodeSelector:
	CPUType: HIGHFREQ
Skuplji i specifičniji način da to postignete je upotreba nodeAffinity u polju affinity odjeljka spec. Ima dva opcije:
requiredDuringSchedulingIgnoredDuringExecution: stroga konfiguracija (planer će raspoređivati pode samo na određenim čvorovima (i nigdje drugo));preferredDuringSchedulingIgnoredDuringExecution: mekana konfiguracija (planer će pokušati rasporediti na određenim čvorovima, a ako to ne uspije, pokušat će rasporediti na sljedećem dostupnom čvoru).
Možete odrediti određenu sintaksu za upravljanje oznakama čvorova, kao što su U, Nije u, Postoji, Ne postoji, Veće ili Manje. Međutim, imajte na umu da složene metode u dugim popisima oznaka usporavaju donošenje odluka u kritičnim situacijama. Drugim riječima, ne komplicirajte.
Kao što je već spomenuto, Kubernetes omogućava određivanje vezivanja trenutnih podova. To znači da možete osigurati da određeni podovi rade zajedno s drugim podovima u istoj zoni dostupnosti (relevantno za oblak) ili čvorovima.
U podAffinity polja affinity odjeljka spec dostupna su ista polja kao u slučaju nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution i preferredDuringSchedulingIgnoredDuringExecution. Jedina razlika je u tome što matchExpressions veže podove na čvoru na kojem već radi pod s tom oznakom.
Osim toga, Kubernetes nudi polje podAntiAffinity, koje, s druge strane, ne veže pod na čvor s određenim podovima.
Što se tiče izraza nodeAffinity može se dati isti savjet: nastojte održati jednostavnost i logičnost pravila, nemojte pokušavati preopteretiti specifikaciju podova složenim skupom pravila. Lako je stvoriti pravilo koje neće odgovarati uvjetima klastera, stvarajući dodatno opterećenje na planer i smanjujući ukupnu učinkovitost.
7. Taints & Tolerans
Postoji još jedan način upravljanja planerom. Ako imate veliki klaster s stotinama čvorova i tisućama mikroslužbi, vrlo je teško ne dopustiti određenim podovima da budu raspoređeni na određenim čvorovima.
U tome pomaže mehanizam taints — zabrana pravila. Na primjer, u određenim scenarijima možete zabraniti određenim čvorovima da na sebi pokreću podove. Da biste primijenili taint na određeni čvor, trebate koristiti opciju taint u kubectl. Odredite ključ i vrijednost, a zatim taint poput NoSchedule ili NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleTakođer valja napomenuti da mehanizam taint podržava tri osnovna efekta: NoSchedule, NoExecute i PreferNoSchedule.
NoScheduleznači da dok u specifikaciji poda ne bude odgovarajući unostolerations, ne može biti raspoređen na čvoru (u ovom primjerunode10).PreferNoSchedule— pojednostavljena verzijaNoSchedule. U ovom slučaju planer će pokušati ne raspoređivati podove koji nemaju odgovarajući unostolerationsna čvor, ali to nije stroga ograničenja. Ako u klasteru ne bude resursa, podovi će početi raspoređivati na tom čvoru.NoExecute— ova pojava pokreće trenutačnu evakuaciju podova koji nemaju odgovarajući zapistolerations.
Zanimljivo je da se ovo ponašanje može poništiti pomoću mehanizma tolerancija. To je korisno kada postoji "zabranjeni" čvor i kada želite postaviti samo infrastrukturne usluge na njemu. Kako to učiniti? Dopustiti samo one podove za koje postoje odgovarajuće tolerancije.
Evo kako će izgledati specifikacija poda:
spec:
   tolerations:
     - key: "node-role.kubernetes.io\/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
To ne znači da će sljedeći redeploy poda nužno završiti na ovom čvoru, to nije mehanizam Node Affinity i nodeSelector. No kombiniranjem nekoliko značajki, možete postići vrlo fleksibilno podešavanje planera.
8. Postavite prioritet deploymenta podova
To što ste postavili vezu podova na čvorove ne znači da će svi podovi biti obrađeni s istim prioritetom. Na primjer, možda ćete htjeti deployati neke podove prije drugih.
Kubernetes nudi različite načine za podešavanje prioriteta podova (Pod Priority and Preemption). Podešavanje se sastoji od nekoliko dijelova: objekta PriorityClass i opisa polja priorityClassName u specifikaciji poda. Pogledajmo primjer:
apiVersion: scheduling.k8s.io\/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Ova klasa prioriteta bi trebala koristiti samo za vrlo važne podove"
Stvaramo PriorityClass, postavljamo mu ime, opis i vrijednost. Što je veći value, to je veći prioritet. Vrijednost može biti bilo koji 32-bitni cijeli broj, manji ili jednak 1 000 000 000. Više vrijednosti su rezervirane za kritično važne sistemske podove koji se obično ne mogu izbaciti. Izbacivanje će se odvijati samo ako visoko prioritetnom podu nije dostupno mjesto za deployment, tada će neki podovi s određenog čvora biti evakuirani. Ako vam je ovaj mehanizam previše rigorozan, možete dodati opciju preemptionPolicy: Never, i tada neće biti izbacivanja, pod će biti prvi u redu i čekati kada planer pronađe slobodne resurse za njega.
Zatim stvaramo pod u kojem navodimo ime priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Možete stvoriti neograničen broj prioritetskih klasa, iako se preporučuje da se ne pretjeruje (na primjer, ograničite se na nisku, srednju i visoku prioritet).
Na taj način ćete, ako bude potrebno, moći povećati učinkovitost postavljanja kritičnih usluga kao što su nginx-ingress-controller, coredns itd.
9. Optimizirajte ETCD klaster
ETCD se može nazvati mozgom cijelog klastera. Veoma je važno održavati ovu bazu podataka na visokom nivou, jer od nje zavisi brzina operacija u 'Kubu'. Standardno, a u isto vrijeme odlično rješenje bilo bi držati ETCD klaster na majstor nodovima kako bi se osigurala minimalna kašnjenja do kube-apiservera. Ako to nije moguće, postavite ETCD što bliže, uz dobru propusnost između sudionika. Također obratite pažnju na to koliko noda iz ETCD može ispasti bez štete za klaster.
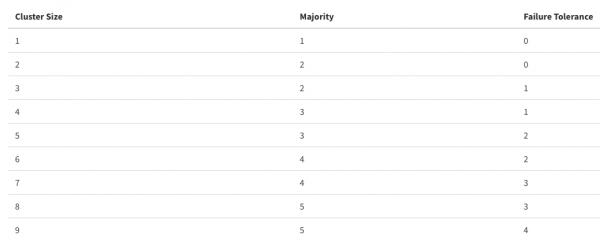
Imajte na umu da prekomjerno povećanje broja sudionika u klasteru može povećati otpornost na greške na račun performansi, sve treba biti u razumu.
Kada je riječ o konfiguraciji usluge, preporuka je malo:
Imajte dobru opremu, uzimajući u obzir veličinu klastera (možete pročitati ).
Podesite nekoliko parametara ako ste rasporedili klaster između nekoliko DC-ova ili ako vaša mreža i diskovi ostavljaju mnogo željenog (možete pročitati ).
Zaključak
U ovom članku opisana su pravila koja naša ekipa nastoji slijediti. Ovo nije korak-po-korak opis radnji, već mogućnosti koje mogu pomoći u optimizaciji operativnih troškova klastera. Jasno je da je svaki klaster jedinstven, a rješenja za konfiguraciju mogu se značajno razlikovati, pa bi bilo zanimljivo dobiti povratne informacije od vas: kako pratite svoj Kubernetes klaster, čime poboljšavate njegov rad. Podijelite svoje iskustvo u komentarima, bit će zanimljivo čuti ga.
Izvor: habr.com
