

Nastavljajući temu unosa velikih količina podataka, pokrenutu , u ovom ćemo razmotriti načine na koje se može smanjiti "fizička" veličina pohranjenih u PostgreSQL-u i njihov utjecaj na performanse poslužitelja.
Govorit ćemo o TOAST postavkama i poravnanju podataka. "U prosjeku" ovi načini će omogućiti uštedu ne previše resursa, ali — bez modifikacije koda aplikacije.
Međutim, naše iskustvo pokazalo se vrlo produktivnim u tom smislu, jer skladište gotovo svakog monitora po svojoj prirodi jest većinom append-only s obzirom na zapisane podatke. A ako vas zanima kako učiti bazu da piše na disk umjesto 200MB/s dvostruko manje — molim, pod cut.
Mali tajni trikovi velikih podataka
Po profilu rada , redovito primamo iz logova tekstualne pakete.
A budući da , čije baze podataka pratimo, predstavlja višekomponentni proizvod s kompleksnim strukturama podataka, zahtijevaju se za postizanje maksimalne učinkovitosti prilično takvi . Tako da i obujam svake pojedinačne instance upita ili rezultantnog plana izvršenja u dolaznom logu ispadne "u prosjeku" dovoljno velik.
Pogledajmo strukturu jedne od tablica, u koju upisujemo "sirove" podatke — odnosno baš originalni tekst iz zapisa loga:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- ključ sekcije
    date
, data -- najvažnije
    text
, PRIMARY KEY(pack, recno)
);
Tipična takva tablica (već sekcionirana, naravno, dakle ovo je — predložak sekcije), gdje je najvažnije — tekst. Ponekad dovoljno obiman.
Podsjetimo se da "fizička" veličina jednog zapisa u PG ne može zauzeti više od jedne stranice podataka, no "logička" veličina — sasvim je druga stvar. Da bi se zabilježio obiman vrijednost u polju (varchar/text/bytea) koristi se :
PostgreSQL koristi fiksnu veličinu stranice (obično 8 KB) i ne dozvoljava tupplama zauzimanje više stranica. Stoga nije moguće izravno pohraniti vrlo velike vrijednosti polja. Kako bismo premostili ovu prepreku, velike vrijednosti polja se komprimiraju i/ili podijele na nekoliko fizičkih redaka. Ovo se događa neprimjetno za korisnika i samo neznatno utječe na veći dio server koda. Ova metoda poznata je kao TOAST …
Zapravo, za svaku tablicu s "potencijalno velikim" poljima automatski svake "velike" zapisa u segmente od 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
To jest, ako moramo zabilježiti redak s "velikom" vrijednošću data, tada će se stvarni zapis dogoditi ne samo u glavnoj tablici i njenom PK, već i u TOAST-u i njenom PK.
Smanjenje TOAST utjecaja
Ali većina zapisa kod nas zapravo nije toliko velika, u 8KB bi se trebala uklapati — kako na tome uštedjeti?..
Ovdje nam pomaže atribut u stupcu tablice:
- EXTENDED dozvoljava i kompresiju i odvojeno pohranjivanje. Ovo je standardna opcija za većinu vrsta podataka kompatibilnih s TOAST-om. Prvo se pokušava izvršiti kompresija, zatim — pohrana izvan tablice, ako redak i dalje ostaje prevelik.
- MAIN dozvoljava kompresiju, ali ne i odvojeno pohranjuvanje. (Zapravo, odvojeno pohranjivanje, ipak, bit će izvršeno za takve stupce, ali samo kao krajnja mjera, kada nema drugog načina da se smanji redak tako da stane na stranicu.)
Zapravo, to je upravo ono što nam treba za tekst — maksimalno komprimirati, a ako se baš ne može smjestiti — premjestiti u TOAST. Ovo se može učiniti odmah "u letu", jednom naredbom:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Kako ocijeniti učinak
Budući da se svakodnevni tijek podataka mijenja, ne možemo uspoređivati apsolutne brojke, ali u relativnim, što manji postotak zapisujemo u TOAST — to je bolje. Ali ovdje postoji opasnost — što je veći "fizički" volumen svakog pojedinačnog zapisa, to "širi" postaje indeks, jer se mora pokriti veći broj stranica podataka.
Sekcija prije promjena:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Sekcija poslije promjena:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Zapravo, mi u TOAST-u pišemo 2 puta rjeđe, što je olakšalo ne samo disk, već i CPU:
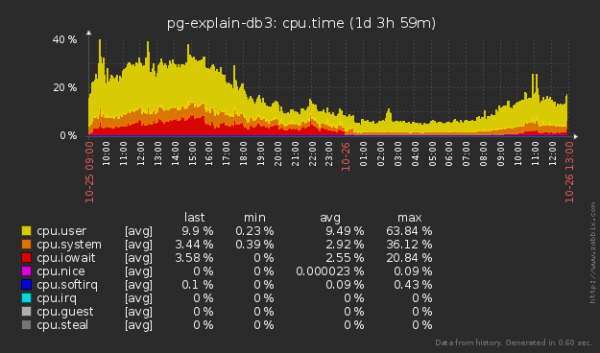
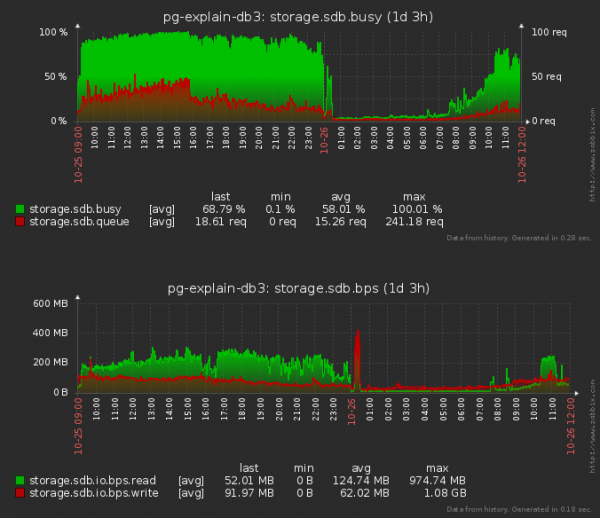
Napominjem da sada i 'čitamo' disk manje, ne samo 'pišemo' — jer prilikom umetanja zapisa u neku tablicu moramo 'pročitati' i dio stabla svakog od indeksa kako bismo odredili njegovu buduću poziciju u njima.
Onima koji žive dobro s PostgreSQL 11
Nakon nadogradnje na PG11 odlučili smo nastaviti s 'tuningom' TOAST-a i obratili pažnju da je od ove verzije dostupan za konfiguraciju parametar :
Kod obrade TOAST-a aktivira se samo kada je vrijednost retka koja se treba pohraniti u tablici veća od TOAST_TUPLE_THRESHOLD bajtova (obično je to 2 kB). TOAST kod će komprimirati i/ili prenositi vrijednosti polja izvan tablice sve dok vrijednost retka ne postane manja od TOAST_TUPLE_TARGET bajtova (varijabilna veličina, također obično 2 kB) ili dok ne bude moguće smanjiti obujam.
Odlučili smo da su naši podaci obično ili 'vrlo kratki' ili odmah 'vrlo dugi', pa smo odlučili ograničiti se na minimalnu moguću vrijednost:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Pogledajmo kako su nova podešavanja utjecala na opterećenje diska nakon ponovnog podešavanja:
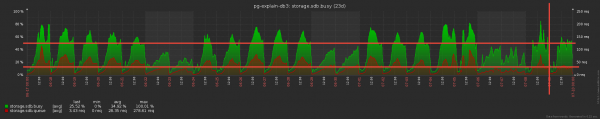
Nije loše! Prosječna čekanja na disk smanjena je otprilike 1,5 puta, a 'zauzetost' diska — za 20%! Ali možda je to nekako utjecalo na CPU?
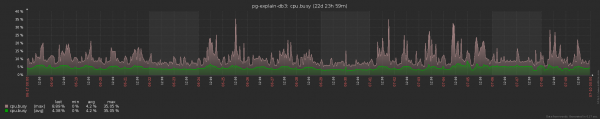
U svakom slučaju, sigurno nije postalo gore. Iako, teško je suditi, kada čak i takvi volumeni ne mogu podići prosječno opterećenje CPU iznad 5%.
Od promjene mjesta sastojaka zbroj… se mijenja!
Kako je poznato, jedan novčić štedi rubalj, a pri našim volumenu pohrane od 10TB/mjesec čak i mala optimizacija može donijeti dobru korist. Stoga smo obratili pažnju na fizičku strukturu svojih podataka — konkretno kako su 'uređeni' polja unutar zapisa svake od tablica.
Zato što zbog to izravno :
Mnoge arhitekture predviđaju poravnanje podataka po granicama strojnih riječi. Na primjer, na 32-bitnom sistemu x86, cijeli brojevi (tip integer, zauzima 4 bajta) bit će poravnati po granici 4-bajtnih riječi, kao i brojevi s pomičnom točkom duple preciznosti (tip double precision, 8 bajtova). Na 64-bitnom sustavu, double vrijednosti će biti poravnate po granici 8-bajtnih riječi. To je još jedan razlog nespojivosti.
Zbog poravnanja, veličina tabličnog reda ovisi o redoslijedu postavljanja polja. Obično taj efekt nije jako primjetan, ali u nekim slučajevima može dovesti do značajnog povećanja veličine. Na primjer, ako se polja tipa char(1) i integer miješaju, obično će između njih propadati 3 bajta bez potrebe.
Započnimo sa sintetičkim modelima:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bajtova

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bajtova
Odakle su došla dva suvišna bajta u prvom slučaju? Sve je jednostavno — 2-bajtni smallint se poravnava na 4-bajtnoj granici ispred sljedećeg polja, dok kada je posljednje — nema potrebu za poravnanjem.
U teoriji — sve je dobro i može se preuređivati polja kako god želite. Provjerimo na stvarnim podacima uz primjer jedne od tablica, čija dnevna sekcija zauzima oko 10-15GB.
Izvorna struktura:
CREATE TABLE public.plan_20190220
(
-- Naslijeđeno iz tablice plan:  pack uuid NOT NULL,
-- Naslijeđeno iz tablice plan:  recno smallint NOT NULL,
-- Naslijeđeno iz tablice plan:  host uuid,
-- Naslijeđeno iz tablice plan:  ts timestamp with time zone,
-- Naslijeđeno iz tablice plan:  exectime numeric(32,3),
-- Naslijeđeno iz tablice plan:  duration numeric(32,3),
-- Naslijeđeno iz tablice plan:  bufint bigint,
-- Naslijeđeno iz tablice plan:  bufmem bigint,
-- Naslijeđeno iz tablice plan:  bufdsk bigint,
-- Naslijeđeno iz tablice plan:  apn uuid,
-- Naslijeđeno iz tablice plan:  ptr uuid,
-- Naslijeđeno iz tablice plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Sekcija nakon promjene redoslijeda kolona — točno iste polja, samo u drugačijem redoslijedu:
CREATE TABLE public.plan_20190221
(
-- Naslijeđeno iz tablice plan:  dt date NOT NULL,
-- Naslijeđeno iz tablice plan:  ts timestamp with time zone,
-- Naslijeđeno iz tablice plan:  pack uuid NOT NULL,
-- Naslijeđeno iz tablice plan:  recno smallint NOT NULL,
-- Naslijeđeno iz tablice plan:  host uuid,
-- Naslijeđeno iz tablice plan:  apn uuid,
-- Naslijeđeno iz tablice plan:  ptr uuid,
-- Naslijeđeno iz tablice plan:  bufint bigint,
-- Naslijeđeno iz tablice plan:  bufmem bigint,
-- Naslijeđeno iz tablice plan:  bufdsk bigint,
-- Naslijeđeno iz tablice plan:  exectime numeric(32,3),
-- Naslijeđeno iz tablice plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Ukupna veličina sekcije određuje se brojem "događaja" i ovisi isključivo o vanjskim procesima, stoga ćemo podijeliti veličinu heap (pg_relation_size) o broju zapisa u njemu — što ćemo dobiti prosječnu veličinu stvarno pohranjenog zapisa:
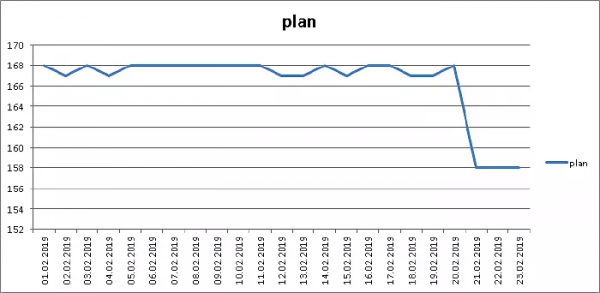
Minus 6% volumena, odličan!
Ali, naravno, nije sve tako ružičasto — jer u indeksima ne možemo promijeniti redoslijed polja, a stoga je 'ukupno' (pg_total_relation_size)…
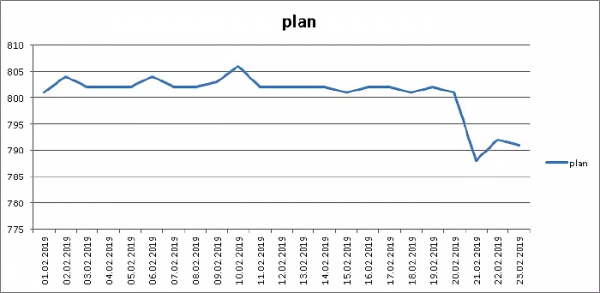
… ipak i ovdje uštedjeli 1.5%, ne promijenivši niti jedan redak koda. Tačno!
Napominjem da prethodna varijanta rasporeda polja — nije nužno najsvjetlija. Jer neke grupe polja ne želimo 'razdvajati' čak ni iz estetskih razloga — na primjer, par (pack, recno), koji je PK za ovu tablicu.
U cjelini, definiranje 'minimalnog' rasporeda polja — to je prilično jednostavan 'povratni' zadatak. Stoga možete dobiti rezultate koji su čak bolji od naših na svojim podacima — probajte!
Izvor: habr.com
