

Pozdrav svima. Razvijamo proizvod za analizu offline prometa. U projektu postoji zadatak vezan uz statističku analizu putanja kretanja posjetitelja po područjima.
U okviru ovog zadatka korisnici mogu postavljati sustavu upite sljedećeg tipa:
- koliko posjetitelja je prošlo iz područja "A" u područje "B";
- koliko posjetitelja je prošlo iz područja "A" u područje "B" preko područja "C", a zatim kroz područje "D";
- koliko je vremena bilo potrebno da posjetitelj određenog tipa prođe iz područja "A" u područje "B."
i još niz sličnih analitičkih upita.
Kretanje posjetitelja po područjima predstavlja usmjereni graf. Pročitao sam na internetu da se graf baze podataka koriste i za analitičke izvještaje. Počeo sam se pitati kako će se graf baze podataka nositi s takvim upitima (TL;DR; loše).
Odabrao sam za korištenje bazu podataka , kao istaknutog predstavnika grafova open-source baza podataka, koja se oslanja na stog zrelih tehnologija koje (po mom mišljenju) bi trebale osigurati dobre operativne karakteristike:
- back-end skladišta BerkeleyDB, Apache Cassandra, Scylla;
- složeni indeksi mogu se pohranjivati u Lucene, Elasticsearch, Solr.
Autori JanusGraph-a navode da odgovara i za OLTP i za OLAP.
Radio sam s BerkeleyDB, Apache Cassandra, Scylla i ES, osim toga, ti se proizvodi često koriste u našim sustavima, tako da sam optimističan što se tiče testiranja ove graf baze podataka. Činio mi se čudnim izbor BerkeleyDB umjesto RocksDB, ali to je vjerojatno povezano s zahtjevima za transakcijama. U svakom slučaju, za skalabilnu, produktnu upotrebu preporučuje se korištenje back-enda na Cassandri ili Scylli.
Neo4j nisam razmatrao, jer je za klasteriranje potrebna komercijalna verzija, tj. proizvod nije otvoren.
Graf baze podataka kažu: "Ako nešto izgleda kao graf — obradite to kao graf!" — ljepota!
Prvo sam nacrtao graf koji je doslovce napravljen prema pravilima graf baza podataka:
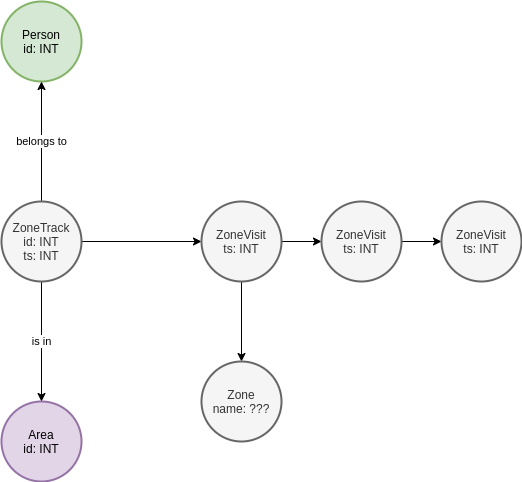
Postoji entitet Zone, koji je odgovoran za područje. Ako ZoneStep pripada ovoj Zone, onda se na nju poziva. Na entitetu Area, ZoneTrack, Osoba ne obraćajte pažnju, pripadaju domeni i u okviru testa se ne razmatraju. U konačnici, upit za pretraživanje lanca ovakve graf strukture izgledao bi ovako:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
Što na hrvatskom otprilike znači: pronađi Zone s ID=0, uzmi sve vrhove od kojih ide brid (ZoneStep), kretanje bez povratka unatrag dok ne pronađeš takve ZoneStep, od kojih ide brid u Zone s ID=19, prebroji broj takvih lanaca.
Ne tvrdim da poznajem sve nijanse pretraživanja na grafovima, ali ovaj upit je generiran na temelju ove knjige ().
Učitao sam 50 tisuća tragova duljine od 3 do 20 točaka u grafsku bazu JanusGraph, koja koristi backend BerkeleyDB, stvorio indekse prema .
Skripta za učitavanje na Pythonu:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
Koristila se VM s 4 jezgrom i 16 GB RAM-a na SSD-u. JanusGraph je pokrenut s ovom komandom:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestU ovom slučaju podaci i indeksi koji se koriste za pretraživanje po točnom podudaranju pohranjuju se u BerkeleyDB. Izvršivši prethodni upit, dobio sam vrijeme od nekoliko desetaka sekundi.
Pokrenuvši 4 navedene skripte paralelno, uspio sam pretvoriti DBMS u bundeve s veselim tokom Java stack traceova (a svi volimo čitati Java stack traceove) u Docker logovima.
Razmišljajući, odlučio sam pojednostaviti grafičku shemu na sljedeći način:
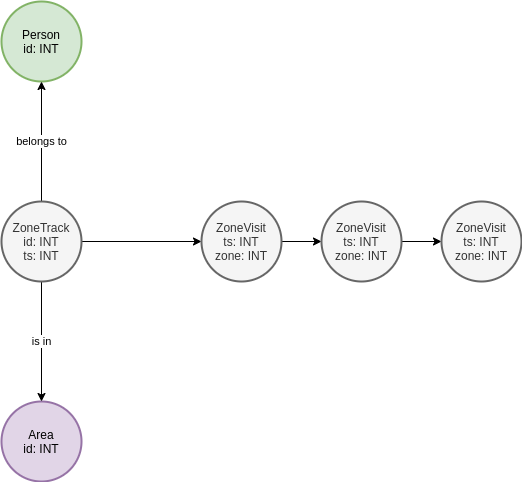
Odlučivši da će pretraživanje po atributima entitete biti brže od pretraživanja po rubovima. Na kraju, moj upit se pretvorio u sljedeće:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()Što na hrvatskom otprilike znači: pronađi ZoneStep s ID=0, kretanje bez povratka unatrag dok ne pronađeš ZoneStep s ID=19, prebroji broj takvih lanaca.
Skriptu učitavanja, navedenu iznad, također sam pojednostavio, kako ne bih stvorio suvišne veze, ograničivši se na atribute.
Upit se još uvijek izvršavao nekoliko sekundi, što je bilo potpuno neprihvatljivo za naš zadatak, jer za potrebe AdHoc upita raznolike naravi to jednostavno nije bilo prikladno.
Pokušao sam postaviti JanusGraph koristeći Scylla, kao najbržu implementaciju Cassandre, ali to također nije donijelo značajne promjene u performansama.
Stoga, iako "izgleda kao graf", nisam uspio natjerati grafičku DBMS da to obradi brzo. Smatram da ne znam nešto i da se JanusGraph može natjerati da izvršava ovu pretragu u dijelovima sekunde, no meni to nije uspjelo.
Budući da je zadatak svakako trebao biti riješen, počeo sam razmišljati o JOIN-ovima i Pivot tablicama, što nije ulijevalo optimizam s obzirom na eleganciju, ali bi moglo biti sasvim radno rješenje u praksi.
U našem projektu već se koristi Apache ClickHouse, pa sam odlučio provjeriti svoje istraživanje na ovoj analitičkoj DBMS.
Postavio sam ClickHouse prema jednostavnom receptu:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Stvorio sam u njemu Bazu podataka i tablicu koja izgleda ovako:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Ispunio sam je podacima sljedećim skriptom:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Budući da se umetanja odvijaju u skupinama, ispunjenje je bilo mnogo brže nego za JanusGraph.
Konstruirao sam dva upita pomoću JOIN-a. Za prijelaz iz točke A u točku B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
Za prijelaz kroz 3 točke:
SELECT s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
FROM
  (SELECT s1.person AS person,
          s1.zone AS s1z,
          s1.when AS s1w,
          s2.zone AS s2z,
          s2.when AS s2w
   FROM
     (SELECT *
      FROM steps
      WHERE (area = 0)
        AND (zone = 0)) AS s1 ANY INNER JOIN
     (SELECT *
      FROM steps AS s2
      WHERE (area = 0)
        AND (zone = 3)) AS s2 USING person
   WHERE s1.when <= s2.when) p ANY INNER JOIN
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 19)) AS s3 USING person
WHERE p.s2w <= s3.when
Upiti zaista izgledaju prilično zastrašujuće, za stvarnu upotrebu potrebno je napraviti programski okvir-generator. Međutim, oni rade i rade brzo. I prvi i drugi upit se izvršavaju za manje od 0.1 sekunde. Evo primjera vremena izvršavanja upita za count(*) prolazak kroz 3 tačke:
SELECT count(*)
FROM
(
    SELECT
        s1.person AS person,
        s1.zone AS s1z,
        s1.when AS s1w,
        s2.zone AS s2z,
        s2.when AS s2w
    FROM
    (
        SELECT *
        FROM steps
        WHERE (area = 0) AND (zone = 0)
    ) AS s1
    ANY INNER JOIN
    (
        SELECT *
        FROM steps AS s2
        WHERE (area = 0) AND (zone = 3)
    ) AS s2 USING (person)
    WHERE s1.when <= s2.when
) AS p
ANY INNER JOIN
(
    SELECT *
    FROM steps
    WHERE (area = 0) AND (zone = 19)
) AS s3 USING (person)
WHERE p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 redak u postavci. Elapsed: 0.068 sec. Procesirano 250.03 tisuća redaka, 8.00 MB (3.69 milijuna redaka/s., 117.98 MB/s.)Napomena o IOPS. Tijekom unosa podataka, JanusGraph je generirao prilično visoku količinu IOPS (1000-1300 za četiri toka unosa podataka), a IOWAIT je bio prilično visok. U isto vrijeme, ClickHouse je generirao minimalno opterećenje na diskovnom sustavu.
Zaključak
Odlučili smo koristiti ClickHouse za obradu upita ovog tipa. Uvijek možemo dodatno optimizirati upite koristeći materijalizirane poglede i paralelizaciju, provodeći prethodnu obradu toka događaja pomoću Apache Flink-a prije učitavanja u ClickHouse.
Performanse su toliko dobre da vjerojatno nećemo ni morati razmišljati o pivotiranju tablica programskim sredstvima. Ranije smo morali raditi pivotiranje podataka koji su se izvlačili iz Vertica putem izvoza u Apache Parquet.
Nažalost, još jedan pokušaj korištenja grafičke baze podataka nije bio uspješan. Nije mi se činilo da je JanusGraph prijateljsko okruženje koje omogućava brzi uvid u proizvod. Pri tome se konfiguracija servera primjenjuje na tradicionalni Java način, što će ljude koji nisu upoznati s Javom natjerati da plaču krvave suze:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary je ovdje da zamijeni Gryo i Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo i Graphson, najnovije verzije
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Stariji serializacijski formati za unazadnu kompatibilnost:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Slučajno sam uspio "postaviti" BerkeleyDB verziju JanusGraph.
Dokumentacija je prilično nedovoljna u pogledu indeksa, jer je za upravljanje indeksima potrebno izvesti prilično neobične radnje u Groovyju. Na primjer, kreiranje indeksa mora se provesti pisanjem koda u Gremlin konzoli (koja, usput rečeno, ne radi odmah). Iz službene dokumentacije JanusGraph:
graph.tx().rollback() \/\/Nikada ne kreirajte nove indekse dok je transakcija aktivna
mgmt = graph.openManagement()\nname = mgmt.getPropertyKey('name')\nage = mgmt.getPropertyKey('age')\nmgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()\nmgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()\nmgmt.commit()\n\n\//Čekajte da indeks postane dostupan\nManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()\nManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()\n\//Ponovno indeksiranje postojećih podataka\nmgmt = graph.openManagement()\nmgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()\nmgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()\nmgmt.commit()
Epilog
U određenom smislu, eksperiment iznad je usporedba toplog i mekanog. Ako se malo bolje razmisli, grafička DBMS izvodi druge operacije da bi došla do istih rezultata. Međutim, tijekom testiranja izvodio sam i eksperiment s upitom slijedeće vrste:
g.V().hasLabel('ZoneStep').has('id',0)\n .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()koji odražava stepen dostupnosti. Međutim, čak i s takvim podacima, grafička DBMS pokazivala je rezultate koji su trajali više od nekoliko sekundi… To je, naravno, povezano s tim da su postojali putovi poput 0 -> X -> Y ... -> 1, koje je grafički motor također provjeravao.
Čak i za upit vrste:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()nisam uspio dobiti produktivan odgovor s vremenom obrade ispod jedne sekunde.
Moral priče je da lijepa ideja i paradigmatsko modeliranje ne dovode do željenog rezultata, koji se s značajno višom učinkovitošću pokazuje na primjeru ClickHousea. Prikazani slučaj korištenja u ovom članku je očiti antipattern za grafičke DBMS, iako izgleda prikladno za modeliranje u njihovoj paradigmi.
Izvor: habr.com
