

Na temelju mojih nastupa na Highload++ i DataFest Minsk 2019.
Za mnoge danas je e-pošta nezamjenjiv dio života na mreži. Pomoću nje obavljamo poslovnu komunikaciju, pohranjujemo razne važne informacije vezane uz financije, rezervacije hotela, narudžbe i još mnogo toga. Sredinom 2018. godine formulirali smo produktnu strategiju razvoja e-pošte. Kakva bi današnja e-pošta trebala biti?
E-pošta mora biti pametna, što znači pomoći korisnicima da se snalaze u sve većem volumenu informacija: filtrirati, strukturirati i pružiti ih na najprikladniji način. Ona mora biti korisna, omogućujući rješavanje raznih zadataka direktno u kutiji s e-poštom, na primjer, plaćanje kazni (funkcija koju, na svoju žalost, često koristim). I pritom, naravno, e-pošta mora osigurati informatičku zaštitu, filtrirati spam i štititi od provale, to jest, biti sigurnom.
Ove smjernice definiraju niz ključnih zadataka, od kojih se mnogi mogu učinkovito riješiti pomoću strojnog učenja. Evo primjera već aktivnih funkcionalnosti razvijenih u okviru strategije — po jednom za svaku smjernicu.
- Pametni odgovor. U e-pošti postoji funkcionalnost pametnog odgovora. Neuronska mreža analizira tekst e-poruke, razumije njezin smisao i cilj, i kao rezultat nudi tri najprikladnija odgovora: pozitivni, negativni i neutralni. To značajno štedi vrijeme prilikom odgovaranja na e-poruke, a često omogućava i neobične i zabavne odgovore.
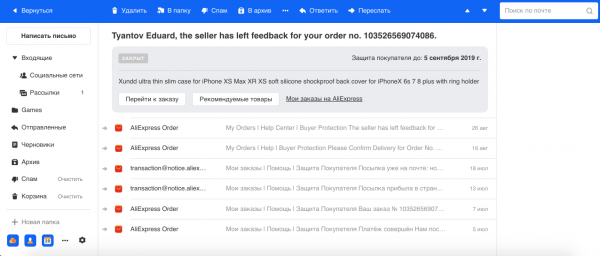
- Grupiranje e-poruka, koje se odnose na narudžbe u internetskim trgovinama. Često obavljamo kupovine na internetu, i obično trgovine mogu slati nekoliko poruka za svaku narudžbu. Na primjer, od AliExpressa, najveće platforme, dolazi puno poruka za jednu narudžbu, a procijenili smo da u terminalnom slučaju njihov broj može dostići do 29. Zato pomoću modela prepoznavanja imenskih entiteta izdvajamo broj narudžbe i druge informacije iz teksta i grupiramo sve poruke u jedan nit. Također prikazujemo osnovne informacije o narudžbi u posebnoj traci, što olakšava rad s ovim tipom poruka.

- AntiphishingPhishing je posebno opasan oblik prevarantskih e-poruka kojima zlonamjernici pokušavaju doći u posjed financijskih informacija (uključujući podatke o korisničkim bankovnim karticama) i prijavnih podataka. Takve e-poruke imitiraju prave, one koje šalje servis, čak i vizualno. Stoga uz pomoć računalnog vida prepoznajemo logotipe i stil formatiranja e-poruka velikih kompanija (npr. Mail.ru, Sber, Alfa) i uzimamo to u obzir zajedno s tekstom i drugim karakteristikama u našim klasifikatorima spama i phishinga.
Strojno učenje
Malo o strojnom učenju u pošti općenito. Pošta je visoko opterećen sustav: na našim serverima prolazi u prosjeku 1,5 milijardi e-poruka dnevno za 30 milijuna korisnika DAU. Sve potrebne funkcije i značajke opslužuje oko 30 sustava strojnog učenja.
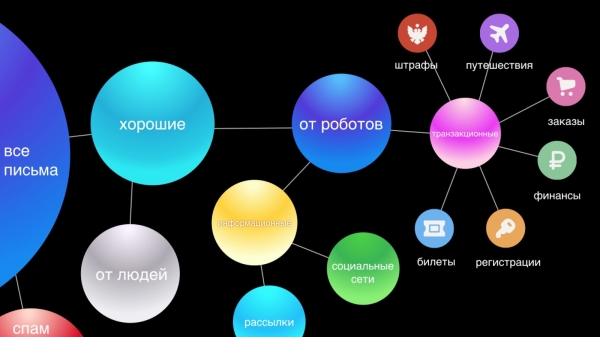
Svaka e-poruka prolazi kroz cijeli proces klasifikacije. Prvo odbacujemo spam i zadržavamo dobre e-poruke. Korisnici često ne primjećuju rad anti-spama jer 95—99 % spama ne završi ni u odgovarajućoj mapi. Prepoznavanje spama je vrlo važan dio našeg sustava i najzahtjevniji, jer u području anti-spama neprekidno dolazi do prilagodbe između sustava zaštite i napada, što predstavlja kontinuirani inženjerski izazov za naš tim.
Nakon toga razdvajamo e-poruke poslane od ljudi i robota. E-poruke od ljudi su najvažnije, stoga im pružamo funkcije poput pametnog odgovora. E-poruke od robota dijele se na dva dijela: transakcijske — to su važne e-poruke od servisa, na primjer, potvrde o kupnji ili rezervaciji hotela, financije, i informacijske — to su poslovni oglasi, popusti.
Smatramo da su transakcijske e-poruke po važnosti jednake osobnoj prepisci. One bi trebale biti pri ruci, jer često je potrebno brzo pronaći informacije o narudžbi ili rezervaciji avio karte, a mi trošimo vrijeme tražeći te e-poruke. Stoga za praktičnost automatski dijelimo na šest osnovnih kategorija: putovanja, narudžbe, financije, karte, registracije i, naposljetku, kazne.
Informativna pisma su najveća i, vjerojatno, manje važna grupa koja ne zahtijeva trenutnu reakciju, jer se ništa bitno ne mijenja u životu korisnika ako ne pročita takvo pismo. U našem novom sučelju, sakupljamo ih u dvije teme: društvene mreže i newslettere, čime vizualno čistimo inbox i ostavljamo na vidiku samo važne poruke.
Eksploatacija
Veliki broj sustava donosi mnoge poteškoće u eksploataciji. Naime, modeli s vremenom propadaju, kao i svaki softver: kvarovi, otkazivanje strojeva, nakupljanje pogrešnog koda. Također, podaci se neprestano mijenjaju: dodaju se novi, transformira se obrazac ponašanja korisnika itd., tako da će model bez odgovarajuće podrške s vremenom raditi sve lošije.
Ne smijemo zaboraviti ni to da što dublje strojno učenje prodire u život korisnika, to veći utjecaj imaju na ekosustav, te su samim tim i financijski gubici ili dobitci koje igrači tržišta mogu ostvariti veći. Stoga su igrači sve češće prilagođeni radu ML algoritama (klasični primjeri — reklama, pretraživanje i već spomenuti anti-spam).
Također, zadaci strojnog učenja imaju posebnost: svaka, čak i neznatna, promjena u sustavu može stvoriti puno posla s modelom: rad s podacima, ponovno učenje, implementacija, što može potrajati tjednima ili mjesecima. Stoga, što brže se mijenja okruženje u kojem operiraju vaši modeli, to više napora zahtijeva njihovo održavanje. Tim može stvoriti mnoštvo sustava i radovati se tome, a zatim trošiti gotovo sve resurse na njihovo održavanje, bez mogućnosti da naprave nešto novo. S takvom smo se situacijom jednom prilikom susreli u timu anti-spama. I donijeli smo očigledan zaključak da održavanje treba automatizirati.
Automatizacija
Što se može automatizirati? U stvari, gotovo sve. Istaknuo sam četiri područja koja definiraju infrastrukturu strojnog učenja:
- prikupljanje podataka;
- dodatno učenje;
- implemantacija;
- testiranje & monitoring.
Ako je okruženje nestabilno i stalno se mijenja, tada je cijela infrastruktura oko modela puno važnija od samog modela. To može biti stari i dobri linearni klasifikator, ali ako se pravilno unesu značajke i osigura dobra povratna informacija od korisnika, on će raditi mnogo bolje od hipermoderne State-Of-The-Art modela sa svim dodatcima.
Povratna informacija
Ovaj ciklus uključuje prikupljanje podataka, usavršavanje i implementaciju — zapravo, cijeli ciklus ažuriranja modela. Zašto je to važno? Pogledajte grafikon registracija u pošti:
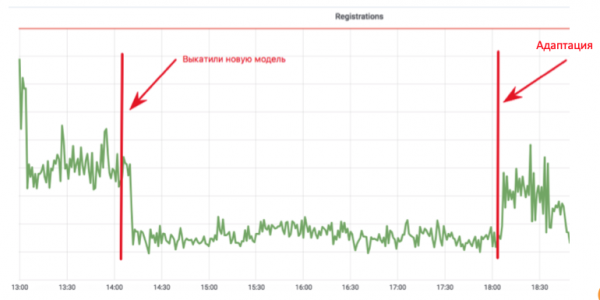
Razvijatelj strojnog učenja je implementirao model protiv botova koji sprječava botove u registraciji e-pošte. Grafikon pada na razinu gdje ostaju samo stvarni korisnici. Sve je fantastično! No, nakon četiri sata, botovi prilagođavaju svoje skripte i sve se vraća u normalu. U ovoj implementaciji, razvojnici su potrošili mjesec dana dodajući značajke i usavršavajući model, ali spameru je trebalo samo četiri sata da se prilagodi.
Kako ne bi bilo tako bolno i da ne bi kasnije sve morali raditi iznova, potrebno je od samoga početka razmisliti o tome kako će izgledati ciklus povratne informacije i što ćemo učiniti ako se okruženje promijeni. Počnimo s prikupljanjem podataka — to je gorivo za naše algoritme.
Prikupljanje podataka
Jasno je da moderni neuronski mrežama, što više podataka, to bolje, a njih u biti generiraju korisnici proizvoda. Korisnici nam mogu pomoći u označavanju podataka, ali ne smijemo zloupotrebljavati to, jer će se korisnicima u nekom trenutku zasititi usavršavanja naših modela i preći će na drugi proizvod.
Jedna od najčešćih grešaka (ovdje se referiram na Andrew Ng) je prevelika orijentacija na metrike na testnoj bazi podataka, a ne na povratnu informaciju korisnika, što je zapravo glavno mjerilo kvalitete rada, jer stvaramo proizvod za korisnika. Ako korisniku nije jasno ili mu se ne sviđa kako model radi, tada je sve uzaludno.
Stoga korisnik uvijek treba imati mogućnost glasovati, trebamo mu dati alat za povratne informacije. Ako mislimo da je u poštanski sandučić stiglo pismo vezano uz financije, potrebno ga je označiti kao 'financije' i osmisliti gumb koji korisnik može pritisnuti i reći da to nije financije.
Kvaliteta povratne informacije
Razgovarajmo o kvaliteti povratnih informacija korisnika. Prvo, vi i korisnici možete uložit različita značenja u jedan pojam. Na primjer, vi i menadžeri proizvoda smatrate da su „financije“ poruke iz banke, dok korisnik smatra da i pismo od bake o mirovini spada u financije. Drugo, postoje korisnici koji bez razmišljanja vole pritiskati gumbe bez ikakve logike. Treće, korisnik može duboko griješiti u svojim zaključcima. Jasni primjer iz naše prakse je implementacija klasifikatora , veoma zabavne vrste neželjene pošte, gdje korisniku nude da preuzme nekoliko milijuna dolara od iznenada pronađenog daljnjeg rođaka u Africi. Nakon implementacije ovog klasifikatora provjerili smo klikove „Nije neželjeno“ na te poruke i ispalo je da je 80% od njih sočna nigerijska neželjena pošta, što ukazuje na to da korisnici mogu biti izuzetno naivni.
I ne zaboravimo da ne samo ljudi mogu pritiskati gumbe, već i razni botovi koji se pretvaraju da su preglednici. Tako da sirova povratna informacija nije pogodna za obuku. Što se može učiniti s ovom informacijom?
Primjenjujemo dva pristupa:
- Povratne informacije iz povezane ML. Na primjer, imamo online sustav protiv botova koji, kao što sam već spomenuo, donosi brze odluke na temelju ograničenog broja karakteristika. I postoji drugi, sporiji sustav koji radi postfaktum. Ima više podataka o korisniku, njegovom ponašanju itd. Kao rezultat toga, donosi se najpromišljenija odluka, stoga ima višu točnost i potpunost. Razliku u radu ovih sustava možemo usmjeriti u prvi kao podatke za obuku. Na taj način, jednostavniji sustav će uvijek nastojati približiti se performansama složenijeg.
- Klasifikacija klikova. Možete jednostavno klasificirati svaki korisnikov klik, procijeniti njegovu valjanost i mogućnost korištenja. To radimo u anti-spamu e-pošte, koristeći korisničke značajke, njegovu povijest, značajke pošiljatelja, sam tekst i rezultat rada klasifikatora. Na kraju dobivamo automatski sustav koji validira korisničke povratne informacije. Kako se njega treba manje često dotjerivati, njegov rad može postati osnovni za sve druge sustave. Glavni prioritet u ovom modelu je preciznost, jer je obučavanje modela na netočnim podacima opasno.
Dok čistimo podatke i dotjerujemo naše ML sustave, ne smijemo zaboraviti na korisnike, jer za nas tisuće, milijuni grešaka na grafikonu su statistika, a za korisnika svaka greška je tragedija. Osim što korisnicima trebaju načini kako preživjeti vašu grešku u proizvodu, oni nakon povratne informacije očekuju isključenje sličnih situacija u budućnosti. Stoga, uvijek treba davati korisnicima ne samo mogućnost glasanja, već i ispravljanje ponašanja ML sustava, stvarajući, na primjer, personalizirane heuristike za svaki klik povratne informacije; u slučaju e-pošte to može biti mogućnost filtriranja sličnih poruka po pošiljatelju i naslovu za tog korisnika.
Također je potrebno, na temelju nekih izvještaja ili podnesaka u podršci, poluautomatski ili ručno dotjerati model kako drugi korisnici ne bi trpjeli zbog sličnih problema.
Heuristike za obučavanje
S tim heuristikama i naslijeđenim rješenjima postoje dva problema. Prvi je u tome što je stalno rastući broj naslijeđenih rješenja teško održavati, da ne govorimo o njihovoj kvaliteti i radu na duže staze. Drugi problem je taj što greška možda nije učestala, i nekoliko klikova za obučavanje modela može biti nedovoljno. Činilo bi se da se ova dva nespojiva efekta mogu značajno ublažiti primjenom sljedećeg pristupa.
- Stvaramo privremeno naslijeđeno rješenje.
- Usmjeravamo podatke s njega u model, koji se redovito obučava, uključujući i na dobivenim podacima. Ovdje je, naravno, važno da heuristika ima visoku preciznost kako bi se ne smanjivala kvaliteta podataka u trening setu.
- Zatim postavljamo nadzor na aktiviranje 'štake', i ako nakon nekog vremena štaka više ne aktivira i potpuno se pokriva modelom, možemo je slobodno ukloniti. Sada se ovaj problem teško može ponoviti.
Stoga je vojska štaka vrlo korisna. Najvažnije je da im služba bude hitna, a ne stalna.
Daljnje učenje
Daljnje učenje je proces dodavanja novih podataka, koji su prikupljeni kao rezultat povratnih informacija od korisnika ili drugih sustava, i obučavanje postojećeg modela na tim podacima. S daljnjim učenjem mogu se javiti brojne poteškoće:
- Model možda jednostavno ne podržava daljnje učenje, već se mora učiti ispočetka.
- Nigdje u knjizi prirode nije napisano da će daljnje učenje nužno poboljšati kvalitetu rada na produkciji. Često se događa upravo suprotno, što znači da može doći do pogoršanja.
- Promjene mogu biti nepredvidive. To je dovoljno delikatna situacija koju smo sami uočili. Čak i ako novi model u A/B testu pokazuje slične rezultate u odnosu na trenutni, to uopće ne znači da će raditi identično. Njihov rad može se razlikovati za jedan posto, što može donijeti nove greške ili vratiti već ispravljene stare. S trenutnim greškama već znamo živjeti, a kada se javi veliki broj novih grešaka, korisnik također može ne razumjeti što se događa, jer očekuje predvidivo ponašanje.
Zbog toga je najvažnije u daljnjem učenju garantirati poboljšanje modela, ili barem ne pogoršati ga.
Prvo što pada na pamet kada govorimo o daljnjem učenju je pristup Aktivnog učenja. Što to znači? Na primjer, klasifikator određuje da li je poruka u vezi s financijama, i oko granice njegove odluke dodajemo uzorak označenih primjera. To dobro funkcionira, na primjer, u reklami, gdje ima puno povratnih informacija i moguće je obučavati model u stvarnom vremenu. A ako je povratnih informacija malo, dobivamo jako pristran uzorak u odnosu na produkcijsku distribuciju podataka, na temelju kojeg se ne može procijeniti ponašanje modela tijekom korištenja.
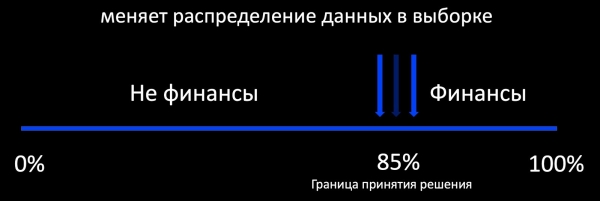
Naš cilj je zapravo održati stare uzorke, već poznate modele i usvojiti nove. Ovdje je važna kontinuitet. Model koji smo često s velikim trudom razvili, već radi, stoga se možemo osloniti na njegovu učinkovitost.
U mailovima se koriste različiti modeli: stabla, linearni i neuronske mreže. Za svaki model radimo svoj algoritam za daljnje učenje. U procesu daljnjeg učenja dobivamo ne samo nove podatke, već i često nove karakteristike koje ćemo uzeti u obzir u svim donjim algoritmima.
Linearni modeli
Pretpostavimo da imamo logističku regresiju. Sastavljamo gubitak modela iz sljedećih komponenti:
- LogLoss na novim podacima;
- regulariziramo težine novih karakteristika (stare ne diramo);
- učimo i na starim podacima kako bismo sačuvali stare uzorke;
- i, možda najvažnije: dodajemo Harmonic Regularization, koja jamči da se težine neće značajno mijenjati u odnosu na stari model.
Budući da svaki sastojak gubitka ima koeficijente, možemo odabrati optimalne vrijednosti za naš zadatak tijekom križnog validiranja ili prema produktnim zahtjevima.
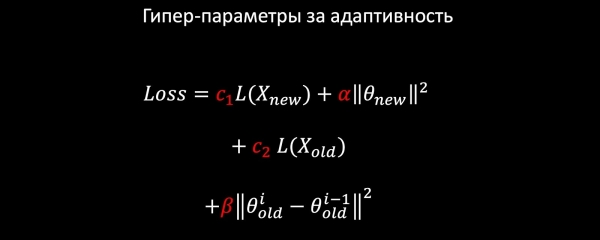
Stabla
Pređimo na stabla odluka. Razvili smo sljedeći algoritam za daljnje učenje stabala:
- Na produkciji radi šuma od 100—300 stabala, koja je obučena na starom skupu podataka.
- Na kraju uklanjamo M = 5 komada i dodajemo 2M = 10 novih, obučene na cijelom skupu podataka, ali s visokim težinama na novim podacima, što prirodno jamči inkrementalnu promjenu modela.
Očigledno je da se s vremenom broj stabala znatno povećava i da treba povremeno skratiti, da bismo stigli u vremenske okvire. Za to koristimo svima poznatu Knowledge Distillation (KD). Ukratko o principu njegovog rada.
- Imamo trenutni "složeni" model. Pokrećemo ga na trening skupu podataka i dobivamo raspodjelu vjerojatnosti klasa na izlazu.
- Nakon toga učimo učenik model (model s manjim brojem stabala u ovom slučaju) da ponavlja rezultate rada modela, koristeći raspodjelu klasa kao ciljnu varijablu.
- Važno je napomenuti da ne koristimo markup skupa podataka, stoga možemo koristiti proizvoljne podatke. Naravno, koristimo uzorak podataka iz stvarne produkcije kao obučeni set za učenik model. Na taj način, trenirajući set omogućava nam osiguravanje tačnosti modela, dok uzorak toka garantira sličnu izvedbu na produkcijskom rasporedu, kompenzirajući pomak obučene skupine.
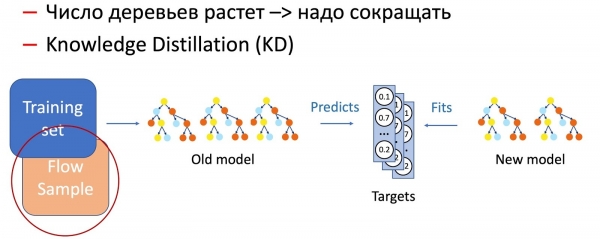
Kombinacija ove dvije metode (dodavanje stabala i povremeno smanjenje njihovog broja putem Knowledge Distillation) osigurava uvođenje novih uzoraka i potpunu kontinuitet.
Pomoću KD također razlikujemo operacije s karakteristikama modela, na primjer, uklanjanje karakteristika i rad s nedostacima. U našem slučaju imamo nekoliko važnih statističkih karakteristika (prema pošiljateljima, tekstualnim hash-ima, URL-ovima itd.) koje se čuvaju u bazi podataka i imaju tendenciju da zatajivaju. Takvom razvoju događaja model, naravno, nije pripremljen, jer u trenirajućem setu ne postoje situacije zatajivanja. U takvim slučajevima kombiniramo KD tehnike i augmentaciju: za obučeni set dijela podataka uklanjamo ili nultaamo potrebne karakteristike, dok originalne oznake (izlazi trenutnog modela) uzimamo iz prvotnog, model učenik uči ponavljati tu raspodjelu.
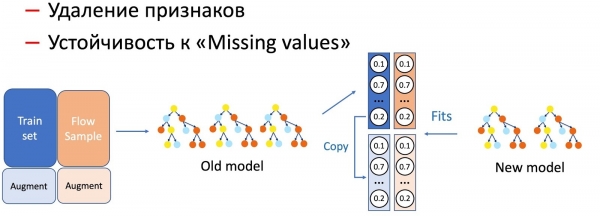
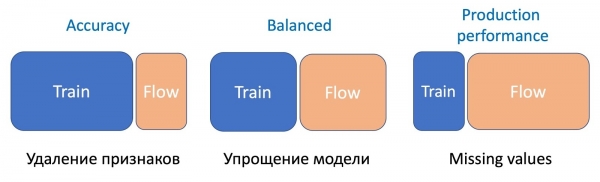
Primijetili smo da što ozbiljnija manipulacija modelima se događa, potrebniji je veći postotak uzorka toka.
Za uklanjanje karakteristika, najjednostavnije operacije, potrebna je samo mala količina toka, jer se mijenja samo nekoliko karakteristika, a trenutni model je učio na istom setu — razlika je minimalna. Za pojednostavljenje modela (smanjenje broja stabala nekoliko puta) već je potrebno 50 na 50. A za nedostatke važnih statističkih karakteristika koje značajno utiču na performanse modela, potrebno je još više toka da se uskladi rad novog modela otpornog na nedostatke na svim vrstama pisama.
FastText
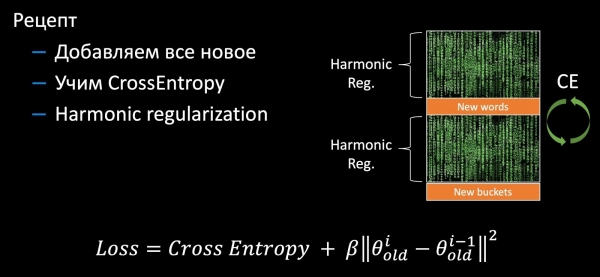
Pređimo na FastText. Podsjećam da je prikaz (Embedding) riječi zbroj embeddinga same riječi i svih njezinih slova N-grama, obično trigrami. Kako trigrami mogu biti prilično brojni, koristi se Bucket Hashing, odnosno pretvorba cijelog prostora u određeni fiksni hash map. U konačnici, matrica težina dobiva dimenzije unutarnjeg sloja prema broju riječi + bucketima.
Tijekom fino podešavanja pojavljuju se nove značajke: riječi i trigrami. U standardnom fino podešavanju od Facebooka ne događa se ništa značajno. Fino podešavaju se samo stare težine s unakrsnom entropijom na novim podacima. Stoga, nove značajke se ne koriste, a ovaj pristup, naravno, ima sve navedene nedostatke povezane s nepredvidivošću modela u produkciji. Zato smo malo doradili FastText. Dodajemo sve nove težine (riječi i trigrami), fino podešavamo cijelu matricu s unakrsnom entropijom i dodajemo harmonijsku regularizaciju po analogiji s linearnim modelom, koja garantira neznatnu promjenu starih težina.
CNN
Sa konvolucijskim mrežama je malo složenije. Ako se u CNN-u fine podešavaju posljednji slojevi, tada se naravno može primijeniti harmonijska regularizacija i garantirati kontinuitet. No, u slučaju da je potrebna fina prilagodba cijele mreže, tada takvu regularizaciju više nije moguće primijeniti na sve slojeve. Međutim, postoji opcija s učenjem komplementarnih embeddinga putem Triplet Loss ().
Triplet Loss
Na primjeru zadatka protiv ribolovnih prevara opisaćemo u općim crtama Triplet Loss. Uzimamo naš logotip, kao i pozitivne i negativne primjere logotipa drugih tvrtki. Minimizira se udaljenost između prvih i maksimizira se udaljenost između drugih, pri čemu to radimo s malim odstupanjem kako bismo osigurali veću kompaktnost klasa.
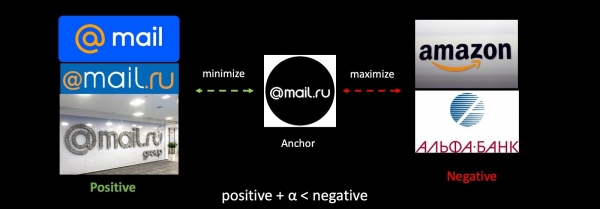
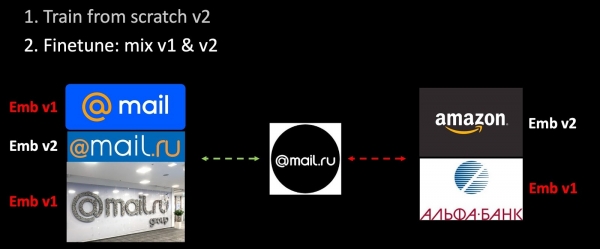
Ako fino podešavamo mrežu, potpuno se mijenja metrički prostor, a on postaje apsolutno nespojiv s prethodnim. To je ozbiljan problem u zadacima koji koriste vektore. Da bismo zaobišli ovaj problem, tijekom učenja ćemo ubacivati stare embeddinge.
Dodali smo nove podatke u trening set i iz temelja obučavamo drugu verziju modela. U drugoj fazi dorađujemo našu mrežu (Finetuning): prvo se obučava posljednji sloj, a zatim se cijela mreža otključava. Tijekom sastavljanja tripleta samo dio embedovanja izračunavamo pomoću obučavanog modela, dok ostale izračunavamo pomoću starog. Na taj način, tijekom dopunjavanja osiguravamo usklađenost metričkih prostora v1 i v2. To je svojevrsna verzija harmonične regularizacije.
Cijela arhitektura
Ako razmatramo cijeli sustav na primjeru antispama, modeli nisu izolirani, već su uloženi jedan u drugi. Uzimamo slike, tekst i druge znakove, a pomoću CNN-a i Fast Text-a dobivamo embedovanja. Zatim se na embedovanja primjenjuju klasifikatori koji daju rezultate za različite klase (tipovi poruka, spam, prisutnost logotipa). Rezultati i značajke zatim ulaze u šumu drveća za donošenje konačne odluke. Određeni klasifikatori u ovoj shemi omogućuju bolje tumačenje rezultata rada sustava i preciznije dopunjavanje komponenata u slučaju problema, nego kada bi se svi podaci u sirovom obliku davali u drveće odluka.
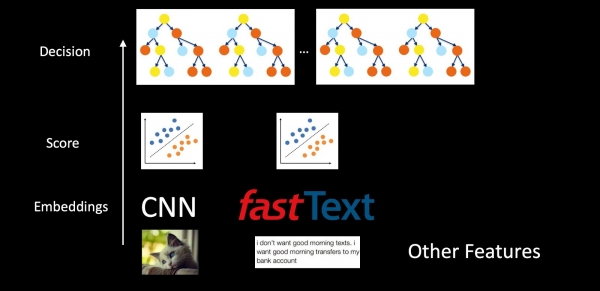
Na kraju jamčimo nasljednost na svakoj razini. Na donjoj razini u CNN-u i Fast Text-u koristimo harmoničnu regularizaciju, za klasifikatore u sredini — također harmoničnu regularizaciju i kalibraciju rezultata za usklađenost distribucije vjerojatnosti. A boosting drveća se obučava inkrementalno ili pomoću Knowledge Distillation.
Općenito, podrška za takav složeni sustav strojne obrade obično predstavlja poteškoću, jer svaki komponent na donjoj razini vodi do ažuriranja cijelog sustava iznad. Međutim, s obzirom na to da se u našem setupu svaka komponenta malo mijenja i da je usklađena s prethodnom, cijeli sustav se može ažurirati u dijelovima bez potrebe za ponovnim učenjem cijele strukture, što omogućuje održavanje bez ozbiljnog preopterećenja.
Deploy
Razgovarali smo o prikupljanju podataka i doradi različitih tipova modela, stoga prelazimo na njihovu implementaciju u produkcijsko okruženje.
A/B testiranje
Kao što sam ranije spomenuo, u procesu prikupljanja podataka obično dobijamo pristrasnu uzorak koja ne omogućava procjenu performansi modela u produkciji. Stoga je prilikom implementacije modela nužno usporediti ga s prethodnom verzijom kako bismo razumjeli kako se stvari zapravo odvijaju, odnosno provoditi A/B testove. Stvarno, proces implementacije i analiza rezultata prilično su rutinski i odlično se mogu automatizirati. Uklanjamo naše modele postupno na 5%, 30%, 50% i 100% korisnika, prikupljajući sve dostupne metrike o odgovorima modela i povratnim informacijama korisnika. U slučaju ozbiljnih odstupanja, automatski vraćamo model, a za ostale slučajeve, nakon što prikupimo dovoljno klikova korisnika, donosimo odluku o povećanju postotka. Na kraju, novu verziju modela dovodimo do 50% korisnika potpuno automatski, dok odobrenje za implementaciju na cijeloj publici daje osoba, iako se i ovaj korak može automatizirati.
Međutim, proces A/B testiranja pruža prostor za optimizaciju. Naime, svaki A/B test traje dovoljno dugo (u našem slučaju traje od 6 do 24 sata, ovisno o količini povratnih informacija), što ga čini prilično skupim i s ograničenim resursima. Osim toga, potrebno je imati dovoljno visok postotak prometa za test kako bismo ubrzali ukupno vrijeme A/B testiranja (prikupljanje statistički značajnog uzorka za procjenu metrika na malom postotku može trajati jako dugo), što čini broj A/B slotova izuzetno ograničenim. Očigledno je da trebamo uključiti u test samo najperspektivnije modele, kojih u procesu dodatnog učenja dobijemo prilično puno.
Za rješavanje ovog zadatka obučili smo poseban klasifikator koji predviđa uspješnost A/B testa. Kao karakteristike uzimamo statistiku odluka, Preciznost, Povrat i druge metrike na obučavajućem skupu, na odvojenom i na uzorku s prometa. Također uspoređujemo model s trenutnim u produkciji, s heuristikama i uzimamo u obzir složenost (Complexity) modela. Korištenjem svih ovih karakteristika, klasifikator obučen na povijesti testova ocjenjuje kandidate modela, u našem slučaju to su šume drveća, i donosi odluku koji od njih pustiti u A/B test.
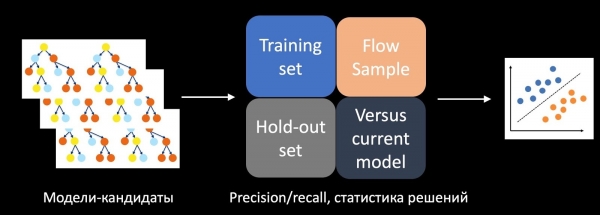
U trenutku implementacije, ovaj pristup je omogućio višestruko povećanje broja uspješnih A/B testova.
Testiranje & praćenje
Testiranje i praćenje, čudno kako zvučalo, ne štete našem zdravlju; naprotiv, poboljšavaju ga i oslobađaju nas od viška stresa. Testiranje može spriječiti kvar, dok praćenje omogućava pravovremeno otkrivanje, smanjujući utjecaj na korisnike.
Ovdje je važno razumjeti da će vaša sistem prije ili kasnije uvijek grešiti — to je povezano s razvojnim ciklusom svakog softvera. Na početku razvoja, sistem obično ima mnogo bugova dok se sve ne stabilizira i ne završi glavni dio inovacija. No s vremenom, entropija uzima danak i greške se ponovo pojavljuju — zbog degradacije komponenti i promjene podataka, o čemu sam govorio na početku.
Želim napomenuti da se svaki sistem strojnog učenja treba razmatrati s obzirom na njegovu dobit tijekom cijelog životnog ciklusa. Ispod je prikazan primjer rada sistema za otkrivanje rijetkog tipa spama (na grafu linija je oko nule). Jednom prilikom, zbog netočno umreženog svojstva, sistem je poludeo. Nažalost, nije bilo monitoring-a za anomalno aktiviranje, te je sistem počeo pohranjivati e-poštu u mapu 'spam' u velikim količinama na granici donošenja odluke. Iako su posljedice ispravljene, sistem je već toliko puta pogriješio da se ne može isplatiti ni nakon pet godina. A to je potpuni neuspjeh s gledišta životnog ciklusa modela.
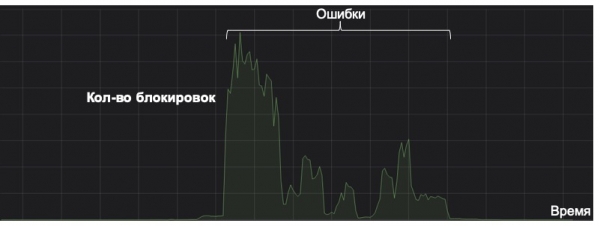
Stoga, tako jednostavna stvar kao što je praćenje može postati ključna u životu modela. Osim standardnih i očitih metrika, uzimamo u obzir distribuciju odgovora i ocjena modela, kao i distribuciju vrijednosti ključnih svojstava. Pomoću KL divergencije možemo usporediti trenutnu distribuciju s povijesnom ili vrijednosti na A/B testu s ostatkom toka, što omogućava pravovremeno uočavanje anomalija u modelu i vraćanje promjena.
U većini slučajeva pokrećemo naše prve verzije sustava koristeći jednostavne heuristike ili modele koje kasnije koristimo za praćenje. Na primjer, pratimo NER model u usporedbi s regularnim izrazima za određene internetske trgovine, i ako pokrivenost klasifikatora opadne u odnosu na njih, istražujemo uzroke. Još jedna korisna primjena heuristika!
Zaključci
Ponovno ćemo proći kroz ključne misli članka.
- Fibdek. Uvijek razmišljamo o korisniku: kako će živjeti s našim greškama, kako može prijaviti iste. Ne zaboravimo da korisnici nisu izvor čistog povratnog informacija za obuku modela, i taj povratak treba proći kroz pomoćne ML sustave. Ako ne postoji mogućnost prikupljanja signala od korisnika, tražimo alternativne izvore povratnih informacija, na primjer, povezane sustave.
- Daljnje učenje. Ovdje je ključna nasljednost, stoga se oslanjamo na trenutni proizvodni model. Nove modele učimo tako da se ne razlikuju značajno od prethodnog kroz harmoničnu regularizaciju i slične trikove.
- Deploy. Automatsko implementiranje prema metrikama znatno skraćuje vrijeme potrebno za uvođenje modela. Praćenje statistike i raspodjele donošenja odluka, kao i broja pogrešaka korisnika, obavezno je za vaš miran san i produktivne vikende.
Nadam se da će pročitano pomoći bržem poboljšanju vaših ML sustava, ubrzavanju njihove izlazne strategije na tržištu i učiniti ih pouzdanijima, smanjujući stres na poslu.
Izvor: habr.com
