

Tijekom ljeta tradicionalno opada i kupovna aktivnost i intenzitet promjena infrastrukture web projekata, govori nam Kapetan Očiglednost. Jednostavno zato što čak i IT stručnjaci, dogodi se, idu na godišnji odmor. I CTO također. Teže je onima koji ostaju na svom mjestu, no sada nije o tome: možda je iz tog razloga ljeto najbolje doba za polako razmišljanje o postojećem sustavu rezerviranja i izradu plana za njegovo poboljšanje. A u tome će vam pomoći iskustvo Egora Andrejeva iz , o kojem je govorio na konferenciji .
Prilikom izgradnje rezervnih mjesta, prilikom rezerviranja postoje nekoliko zamki u koje se može upasti. A u njih se nikako ne smije upasti. I u svemu ovome, kao i u mnogo čemu drugome, uništava nas perfekcionizam i… lijenost. Pokušavamo učiniti sve savršeno, a savršeno ne trebamo činiti! Trebamo napraviti samo određene stvari, ali ih trebamo napraviti ispravno, završiti ih, kako bi normalno radile.
Failover nije neka zabavna stvar ‘za svaki slučaj’; to je stvar koja treba učiniti samo jedno — smanjiti vrijeme mirovanja, kako bi se servis, tvrtka, manje gubila novac. I u svim metodama rezerviranja predlažem razmišljati u sljedećem kontekstu: gdje su novci?
Prva zamka: kada gradimo velike pouzdane sustave i bavimo se rezerviranjem — smanjujemo broj kvarova. To je strašna zabluda. Kada se bavimo rezerviranjem, vjerojatno povećavamo broj kvarova. I ako sve napravimo ispravno, tada ćemo ukupno smanjiti vrijeme mirovanja. Kvarova će biti više, ali će se događati uz manje troškove. Što je zapravo rezerviranje? — to je kompliciranje sustava. Svako kompliciranje je loše: imamo više sitnica, više zupčanika, riječju, više elemenata — i, stoga, veća je šansa za kvar. I oni će se zaista slomiti. I stvarat će kvarove češće. Jednostavan primjer: recimo da imamo neku web stranicu, s PHP-om, MySQL-om. I hitno je potrebno napraviti rezervaciju.
Što se tiče (c) Uzimamo drugu platformu, gradimo identičan sustav... Složenost postaje dvostruko veća — imamo dvije entitete. A na to nanosimo određenu logiku prijenosa podataka s jedne platforme na drugu — dakle, replikacija podataka, kopiranje statike i tako dalje. Tako, replikacijska logika — obično je vrlo složena, i stoga ukupna složenost sustava može biti ne 2, već 3, 5, 10 puta veća.
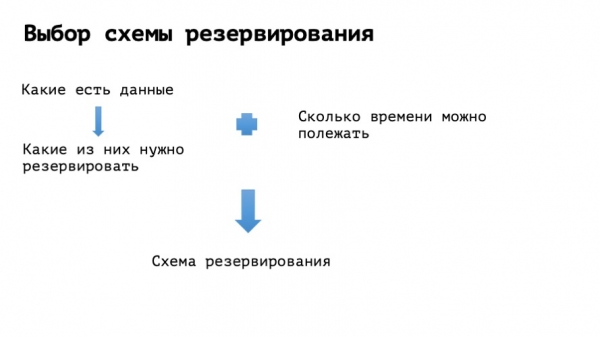
Druga zamka: kada gradimo stvarno velike složene sustave, maštamo o tome što želimo postići na kraju. Voilà: želimo imati superpouzan sustav koji radi bez ikakvog zastoja, prebacuje se za pola sekunde (a još bolje, odmah), i počinjemo ostvarivati snove u stvarnost. No ovdje također postoji nijansa: što je kraće željeno vrijeme prebacivanja, to je složenija logika sustava. Što ćemo teže napraviti tu logiku, to će se sustav češće rušiti. I možemo se naći u vrlo neugodnoj situaciji: svim snagama pokušavamo smanjiti vrijeme zastoja, a zapravo sve kompliciramo, i kada nešto ne ide po planu, vrijeme zastoja će na kraju biti duže. Često se uhvatiš u misli: bolje da nismo imali rezervu. Bolje da je jedno radilo s jasnim vremenom zastoja.
Kako se s tim boriti? Moramo prestati lagati sami sebi, prestati se udvarati, da ćemo graditi svemirski brod, i realno razumjeti koliko dugo projekt može trajati. Prema tom maksimalnom vremenu, birat ćemo kojim ćemo metodama zapravo povećati pouzdanost našeg sustava.
Savršeno vrijeme za «priče iz ž»… iz života, naravno.
Primjer broj jedan
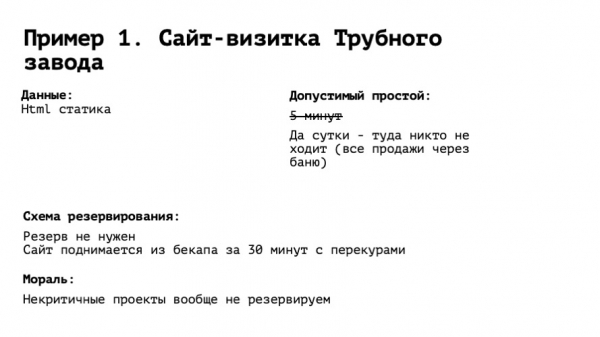
Zamislite informacijsku stranicu tvornice cjevovoda broj 1 u gradu N. Na njoj su ispisana velika slova — TVORNICA CJEVOVODA BROJ 1. Malo niže nalazi se slogan: „Naše cijevi su najokruglije cijevi u N“. I na dnu je broj telefona glavnog direktora i njegovo ime. Shvaćamo da treba rezervirati — to je veoma važna stvar! Počinjemo istraživati od čega se sastoji. Html statika — dakle, nekoliko slika, gdje glavni direktor, zapravo, sjedi za stolom u sauni sa svojim partnerom i razgovaraju o nekoj novoj transakciji. Počinjemo razmišljati o vremenu neaktivnosti. Pada nam na pamet: treba ležati pet minuta, ne više. A tu je pitanje: koliko je od naše web stranice bilo prodaja uopće? Koliko, koliko? Što znači „nula“? A to i znači: zato što je svih četiri transakcije prošle godine glavni direktor napravio za istim stolom, s istim ljudima s kojima idu u saunu sjede za stolom. I shvaćamo da čak i ako stranica leži jedan dan — neće biti ništa strašno.
Na temelju uvodnih informacija, imamo jedan dan za pokretanje ove priče. Počinjemo razmišljati o rezervacijskoj shemi. I biramo najidealniju shemu za rezervaciju za ovaj primjer: ne koristimo rezervaciju. Ova cijela stvar se podiže bilo kojim administratorom za pola sata s pauzama. Postaviti web server, staviti datoteke — to je to. Funkcionirat će. Ništa ne treba pratiti, ništa ne treba posebno pažnju. Dakle, zaključak iz prvog primjera je prilično očigledan: usluge koje ne treba rezervirati — ne treba rezervirati.
Primjer broj dva
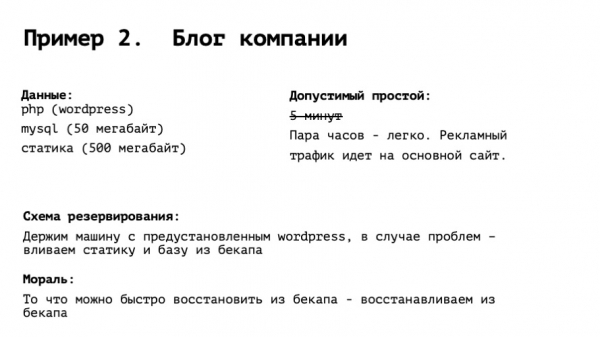
Tvrtkin blog: posebno obučeni pišu tamo novosti, evo sudjelovali smo na nekom sajmu, a evo i novi proizvod smo lansirali i tako dalje. Recimo, to je standardni PHP s WordPressom, mala baza podataka i malo statičkog sadržaja. Naravno, opet mi pada na pamet da ni u kojem slučaju ne možemo ležati – „ne više od pet minuta!“, to sve. Ali hajde da razmislimo malo dalje. Što taj blog zapravo radi? Tamo dolaze posjetioci iz Yandex-a, iz Google-a prema nekim upitima, kroz organski promet. Super. A kako su prodaje uopće s tim povezane? Osvještenje: nije baš. Oglasi idu na glavnu stranicu, koja je na drugom serveru. Počinjemo razmišljati o shemi rezervacije bloga. Pošteno, trebalo bi ga podići za nekoliko sati, i bilo bi dobro na to se pripremiti. Razumno bi bilo nabaviti server u drugom data centru, postaviti okruženje, dakle web server, PHP, WordPress, MySQL, i ostaviti to u pripremi. U trenutku kada shvatimo da je sve srušeno, trebamo napraviti dvije stvari – pokrenuti MySQL dump od 50 megabajta, to će proći za minutu, i preuzeti određeni broj slika iz backup-a. To također nije previše. Tako, za pola sata, sve to bude podignuto. Nema replikacija, ili Bože sačuvaj, automatskog failovera. Zaključak: ono što možemo brzo povratiti iz backup-a – nije potrebno rezervirati.
Primjer broj tri, malo složeniji
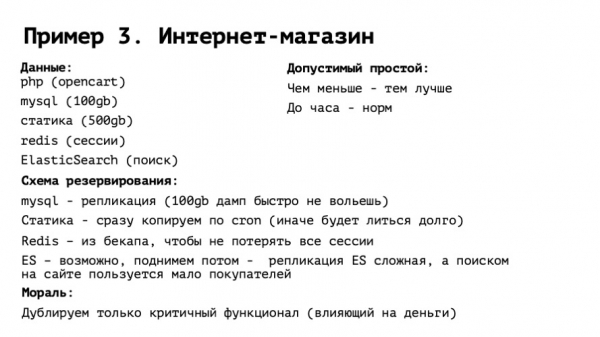
Internetska trgovina. PhP s malo dorade, mysql sa solidnom bazom. Dosta statičkog sadržaja (jer u internetskoj trgovini ima lijepih HD slika i sve to), Redis za sesije i Elasticsearch za pretraživanje. Počinjemo razmišljati o vremenu zastoja. I tu, naravno, nije tajna da dan bez boli ne može proći za internetsku trgovinu. Što duže leži, to više novca gubimo. Moramo ubrzati. A koliko? Smatram da ako budemo ležali sat, nitko neće poludjeti. Da, nešto ćemo izgubiti, ali ako se počnemo truditi – samo će biti gore. Određujemo shemu zastoja, koja je prihvatljiva u satu.
Kako to sve mogu rezervirati? Automobil je potreban u svakom slučaju: sat vremena je prilično malo. Mysql: ovdje već potrebna replikacija, živa replikacija, jer za sat vremena 100 GB u dump vjerojatno neće stati. Statika, slike: opet, za sat vremena 500 GB možda neće moći stati. Stoga, bolje je odmah kopirati slike. Redis: ovdje je zanimljivije. U Redis-u se nalaze sesije — jednostavno uzeti i uništiti ga ne možemo. Jer to neće biti dobro: svi korisnici će se izlogirati, a košarice će biti prazne i slično. Ljudi će biti prisiljeni ponovno unositi svoje korisničko ime i lozinku, a mnogi će se možda poslije povući i ne završiti kupnju. Opet, konverzija će pasti. S druge strane, Redis je sasvim aktualan, s posljednjim prijavljenim korisnicima, vjerojatno također nije potreban. I dobar kompromis je uzeti Redis i obnoviti ga iz backup-a, jučerašnjeg, ili, ako ga imate svakih sat vremena, — starog satnog. Na sreću, obnova iz backup-a je kopiranje jedne datoteke. A najzanimljivija priča je Elasticsearch. Tko je ikada podizao replikaciju MySQL-a? Tko je ikada podizao replikaciju Elasticsearch-a? I tko je imao da nakon toga normalno radi? Na što mislim: vidimo u našem sustavu neku entitet. Izgleda korisno — ali je složeno.
Kompleksan u smislu da naši inženjeri nemaju iskustva s njom. Ili imaju negativno iskustvo. Ili shvaćamo da je ovo još uvijek prilično nova tehnologija s nijansama ili nedostacima. Razmišljamo... Uh, elastic je također velik, teško ga je ponovo pokrenuti iz backup-a, što učiniti? Shvaćamo da se elastic u našem slučaju koristi za pretraživanje. A kako prodaje naš internetski trgovina? Idemo prema marketinškim stručnjacima, pitamo odakle ljudi dolaze. Oni odgovaraju: "90% dolazi direktno iz Yandex-marketa na stranicu proizvoda". I kupuju ili ne. Dakle, pretraživanje je potrebno 10% korisnika. A održavanje replikacije elastic-a, posebno između različitih data centara u različitim zonama, ima stvarno mnogo nijansi. Koji je izlaz? Uzimamo elastic na rezerviranoj platformi i ne radimo ništa s njim. Ako se proces oduži, možda ćemo ga nekada kasnije podići, ali to nije sigurno. U suštini, zaključak je manje-više isti: usluge koje ne utječu na novac, ponovo, ne rezerviramo. Da bi shema ostala jednostavnija.
Primjer broj četiri, još složenije
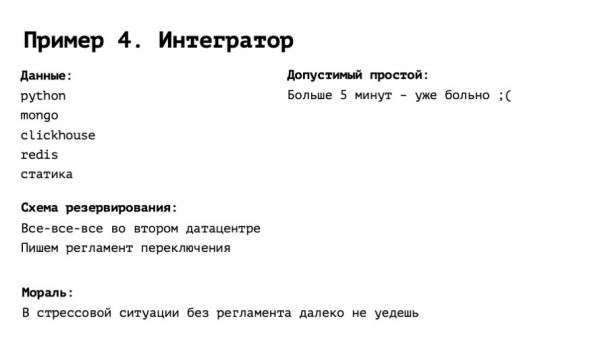
Integrator: prodaja cvijeća, pozivanje taksija, prodaja roba, u suštini, bilo što. Ozbiljna stvar koja radi 24/7 za veliki broj korisnika. S potpuno zanimljivim okvirom, gdje postoje zanimljive baze, rješenja, visoka opterećenja, i što je najvažnije, ne može ležati više od 5 minuta. Ne samo zato što ljudi neće kupiti, već zato što će ljudi vidjeti da ta stvar ne funkcionira, razočarati se i možda se uopće ne vratiti drugi put.
U redu. Pet minuta. Što ćemo s tim učiniti? U ovom slučaju, ozbiljno, ulažemo sve novce u izgradnju stvarne rezervne platforme, s replikacijom svega i svačega, i možda čak maksimalno automatiziramo prebacivanje na ovu platformu. A osim toga, ne smijemo zaboraviti učiniti jednu važnu stvar: zapravo, napisati regulativu za prebacivanje. Regulativa, čak i ako je sve automatizirano, može biti vrlo jednostavna. U stilu "pokrenuti ovakav scenarij ansible", "u route 53 označiti ovu opciju" i tako dalje — ali to mora biti neki točan popis radnji.
Sve izgleda jasno. Prebaciti replikaciju — trivijalni zadatak, ili će se sama prebaciti. Promijeniti naziv domene u dns-u — iz iste serije. Problem je što kada ovakav projekt propadne, počinje panika, i čak i najiskusniji administratori mogu biti podložni tome. Bez jasne upute 'otvorite terminal, idite ovdje, adresa našeg servera je još uvijek ovakva', teško je održati vremensko ograničenje od 5 minuta za reanimaciju. Također, kada koristimo ovaj regulativ, lako je zapisati neka promjene u infrastrukturi, na primjer, — i odgovarajuće promijeniti regulativ.
Ali, ako je sustav rezerviranja jako složen i u nekom trenutku napravimo grešku, možemo srušiti i našu rezervnu lokaciju, a uz to i podatke pretvoriti u bundeve na obje lokacije — to će biti jako tužno.
Primjer broj pet, potpuni hardcore
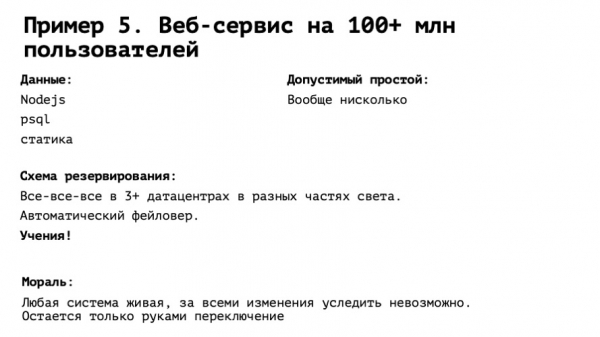
Međunarodna usluga s stotinama milijuna korisnika širom svijeta. Sve vremenske zone koje postoje, visoka opterećenja na maksimumu, ne smije biti nikakvih zastoja. Minuta — i bit će tužno. Što učiniti? Rezervirati, opet, po punom programu. Učinili smo sve što je spomenuto u prethodnom primjeru, i još malo više. Idealan svijet, a naša infrastruktura — ona je po svim definicijama devops IaaC. Znači sve je u git-u, samo pritisnite dugme.
Što nedostaje? Jedno — obuka. Bez toga se ne može. Čini se da je sve savršeno, da je sve pod kontrolom. Pritiskuje se dugme, sve se dešava. Čak i ako je to tako — a mi znamo da to nije moguće — naš sustav surađuje s nekim drugim sustavima. Na primjer, to je dns od route 53, s3 pohrana, integracija s nekim api-jem. Sve predvidjeti u ovom teoretskom eksperimentu ne možemo. I dok stvarno ne povučemo prekidač — nećemo znati hoće li raditi ili ne.
Na tome, vjerovatno, sve. Ne budite lijeni i ne pretjerujte. I neka s vama bude uptime!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish