

Predlažem da se upoznate s transkriptom prezentacije Alexandra Valjaljkina "Optimizacije Go u VictoriaMetrics" s kraja 2019. godine
— brza i skalabilna DBMS za pohranu i obradu podataka u obliku vremenskih serija (zapis stvara vrijeme i skup odgovarajućih vrijednosti za to vrijeme, na primjer, dobivenih putem periodičkog praćenja stanja senzora ili prikupljanja metrika).
Evo linka na video ove prezentacije —
Malo ću vam reći o sebi. Ja sam Alexander Valjaljkin. Evo . Zanima me Go i optimizacija performansi. Napisao sam mnogo raznih korisnih i manje korisnih biblioteka. One započinju s fast, ili s quick prefiksom.
Trenutno radim na VictoriaMetrics. Što je to i što tamo radim? O tome ću govoriti u ovoj prezentaciji.
Plan prezentacije je sljedeći:
- Na početku ću vam reći što je VictoriaMetrics.
- Zatim ću objasniti što su vremenske serije.
- Potom ću objasniti kako funkcionira baza podataka vremenskih serija.
- Nakon toga ću pričati o arhitekturi baze podataka: od čega se sastoji.
- A onda ćemo preći na optimizacije koje postoje u VictoriaMetrics. To su optimizacija inverznog indeksa i optimizacija za bitset implementaciju u Go.
Zna li netko u publici što je VictoriaMetrics? Izvrsno, puno ljudi zna. To je dobra vijest. Za one koji ne znaju – to je baza podataka za vremenske serije. Temelji se na arhitekturi ClickHouse, na nekim detaljima implementacije ClickHouse-a. Na primjer, na stvarima poput: MergeTree, paralelnog izvođenja na svim dostupnim jezgrama procesora i optimizacije performansi pomoću rada s blokovima podataka koji se stavljaju u CPU cache.
VictoriaMetrics nudi najbolje kompresije podataka u usporedbi s drugim bazama podataka za vremenske serije.
Vertikalno se skalira — tj. možete dodavati veći broj procesora, veći broj radne memorije na jednom računalu. VictoriaMetrics će uspješno iskoristiti te dostupne resurse i povećati linearnu učinkovitost.
VictoriaMetrics se također horizontalno skalira — tj. možete dodavati dodatne čvorove u klaster VictoriaMetrics, a njezina će se učinkovitost povećavati gotovo linearno.
Kao što ste pogodili, VictoriaMetrics je brza baza podataka, jer druge ne mogu opisati. I napisana je na Go-u, pa o njoj govorim na ovoj meet-up.
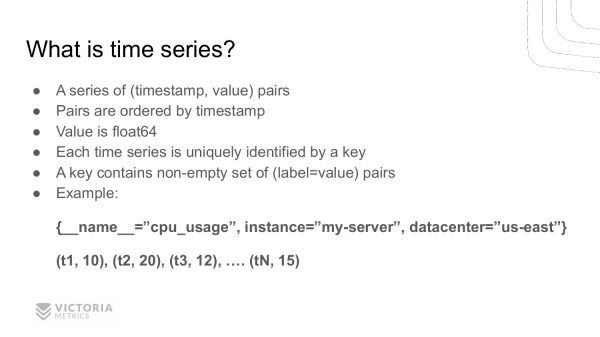
Tko zna što je vremenska serija? Također, puno ljudi zna. Vremenska serija – to je niz parova (timestamp, vrijednost), gdje su ti parovi sortirani prema vremenu. Vrijednost predstavlja broj s pokretnom decimalom – float64.
Svaka vremenska serija jedinstveno je identificirana ključem. Od čega se sastoji taj ključ? Sastoji se od ne-praznog skupa parova ključ-vrijednost.
Evo primjera vremenske serije. Ključ ove serije je lista parova: __name__="cpu_usage" – to je naziv metrike, instance="my-server" – to je računar na kojem je ta metrika prikupljena, datacenter="us-east" – to je data centar gdje se nalazi taj računar.
Dobijemo ime vremenske serije, sastavljeno od tri para ključ-vrijednost. Ovom ključu odgovara lista parova (timestamp, value). t1, t3, t3, ..., tN – to su timestamps, 10, 20, 12, ..., 15 – odgovarajuće vrijednosti. Ovo je cpu-usage u trenutnom vremenu za tu seriju.
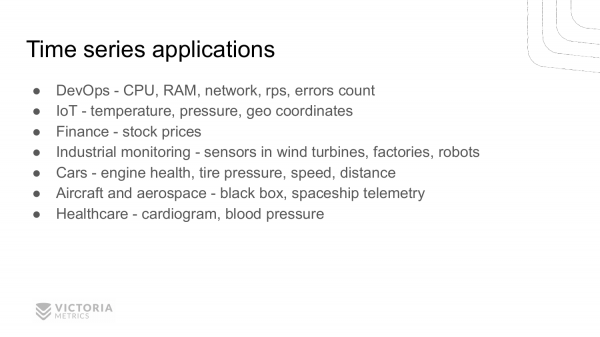
Gdje se mogu koristiti vremenske serije? Ima li netko ideje?
- U DevOps-u možemo mjeriti opterećenje CPU-a, RAM-a, mreže, rps, broj grešaka itd.
- IoT – možemo mjeriti temperaturu, tlak, geo koordinate i još puno toga.
- Također u financijama – možemo pratiti cijene na razne dionice i valute.
- Osim toga, vremenske serije mogu se koristiti za praćenje proizvodnih procesa u tvornicama. Imamo korisnike koji koriste VictoriaMetrics za praćenje vjetroturbina, za robote.
- Također, vremenske serije su korisne za prikupljanje informacija s senzora raznih uređaja. Na primjer, za motor; za mjerenje tlaka u gumama; za mjerenje brzine, udaljenosti; za mjerenje potrošnje benzina itd.
- Također, vremenske serije mogu se koristiti za praćenje aviona. U svakom avionu postoji crna kutija koja prikuplja vremenske serije o raznim parametrima zdravlja aviona. Vremenske serije se također koriste u zrakoplovnoj industriji.
- Zdravstvo – to su krvni tlak, puls itd.
Možda postoje još primjene za koje sam zaboravio, ali se nadam da ste shvatili da se vremenske serije aktivno koriste u suvremenom svijetu. A njihova upotreba raste svake godine.
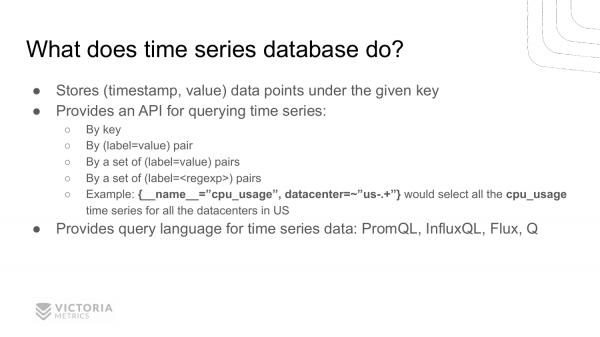
Zašto je potrebna baza podataka za vremenske serije? Zašto nije moguće koristiti običnu relacijsku bazu za pohranu vremenskih serija?
Zato što vremenske serije obično sadrže velike količine informacija koje je teško pohraniti i obraditi u običnim bazama podataka. Stoga su se pojavile specijalizirane baze podataka za vremenske serije. Ove baze učinkovito pohranjuju točke (timestamp, value) s zadanim ključem. One pružaju API za čitanje pohranjenih podataka po ključu, po jednoj parom ključ-vrijednost, ili po nekoliko takvih parova, ili po regexp-u. Na primjer, ako želite pronaći opterećenje procesora svih vaših usluga u podatkovnom centru u Americi, tada trebate koristiti ovakav pseudo-upit.
Obično baze podataka za vremenske serije nude specijalizirane jezike upita, jer SQL za vremenske serije nije baš najbolje prilagođen. Iako postoje baze podataka koje podržavaju SQL, on se ne uklapa najbolje. Bolje odgovaraju jezici upita poput , , , . Nadam se da je netko čuo barem za jedan od ovih jezika. O PromQL-u su vjerojatno mnogi čuli. To je jezik upita Prometheusa.
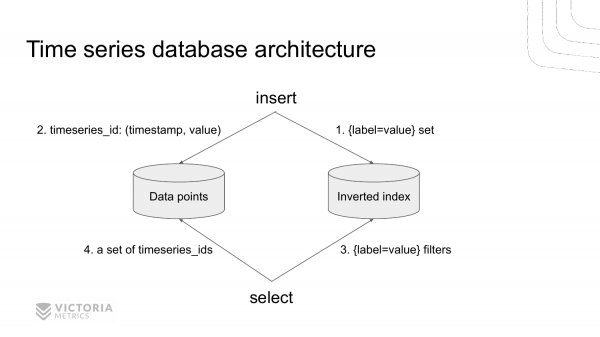
Evo kako izgleda arhitektura moderne baze podataka za vremenske serije na primjeru VictoriaMetrics.
Ona se sastoji od dva dijela. To je skladište za inverzivni indeks i skladište za vrijednosti vremenskih serija. Ova skladišta su odvojena.
Kada nova stavka dođe u bazu podataka, prvo se obraćamo inverzivnom indeksu kako bismo pronašli identifikator vremenske serije prema zadanom skupu label=value za ovu metriku. Pronalazimo taj identifikator i pohranjujemo vrijednost u skladištu podataka.
Kada dođe neki upit za dohvat podataka iz TSDB, prvo što radimo je da zavirimo u inverzivni indeks. Izvlačimo sve timeseries_ids zapise koji odgovaraju danom skupu. label=valueI potom izvlačimo sve potrebne podatke iz skladišta podataka indeksiranog po timeseries_ids.
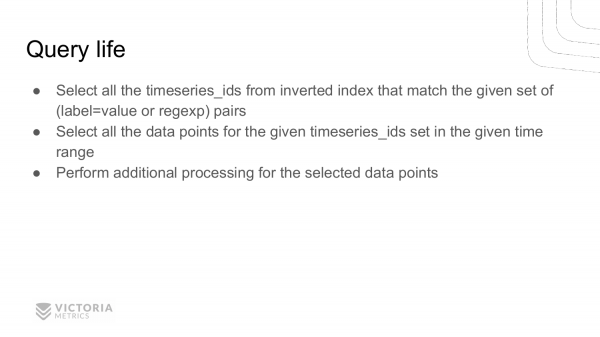
Razmotrimo primjer kako baza podataka za vremenske serije obrađuje dolazni select-upit.
- Prvo dobijamo sve
timeseries_idsiz inverzivnog indeksa koji sadrže zadan parlabel=value, ili udovoljavaju zadanom regularnom izrazu. - Nakon toga izvlačimo sve data points iz skladišta podataka za zadani vremenski interval za pronađene
timeseries_ids. - Nakon toga, baza podataka vrši određene proračune nad tim data pointima prema korisničkom zahtevu. I zatim vraća odgovor.
U ovoj prezentaciji ću vam pričati o prvom delu. To je pretraživanje timeseries_ids prema invertovanom indeksu. O drugom i trećem delu možete pogledati kasnije , ili da sačekate da pripravim druge izveštaje 🙂
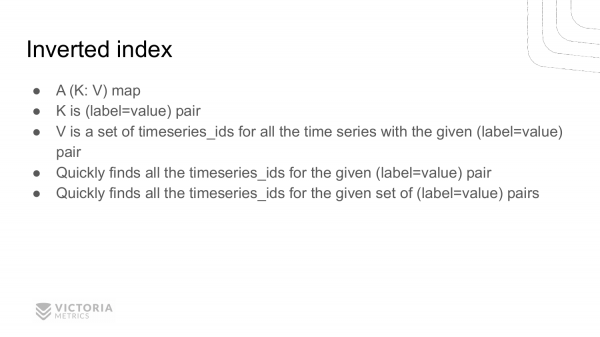
Krenimo prema invertovanom indeksu. Mnogima se može činiti da je to jednostavno. Ko zna šta je invertovani indeks i kako funkcioniše? Oh, već nije toliki broj ljudi. Pokušajmo da shvatimo šta je to.
Zapravo, sve je jednostavno. To je samo rečnik koji povezuje ključeve s vrednostima. Šta je ključ? Ta šifra label=value, gdje label i value — to su stringovi. A vrednosti su skup timeseries_ids, koji uključuje zadanu šifru label=value.
Invertovani indeks omogućava brzo pronalaženje svih timeseries_ids, koji imaju zadate label=value.
Takođe omogućava brzo pronalaženje timeseries_ids vremenskih serija za nekoliko parova label=value, ili za parove label=regexp. Kako to funkcioniše? Pomoću pronalaženja preseka seta timeseries_ids za svaki par label=value.
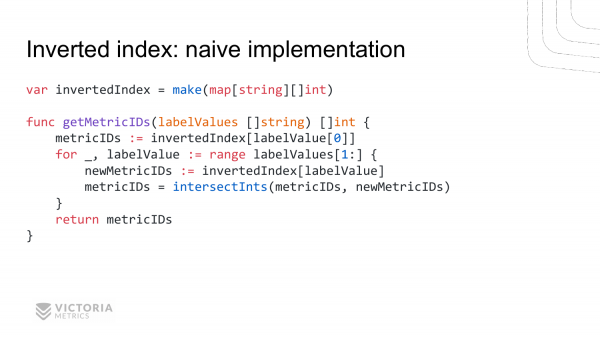
Razmotrite različite implementacije invertovanog indeksa. Počnimo s najjednostavnijom naivnom implementacijom. Izgleda ovako.
Funkcija getMetricIDs dobiće listu stringova. Svaki string sadrži label=value. Ova funkcija vraća listu metricIDs.
Kako to funkcioniše? Ovde imamo globalnu promenljivu koja se zove invertedIndex. To je običan rečnik (map), koji povezuje string s slice-om int-ova. String sadrži label=value.
Implementacija funkcije: uzimamo metricIDs za prvi label=value, zatim prolazimo kroz sve ostale label=value, uzimamo metricIDs za njih. I pozivamo funkciju intersectInts, o kojoj će biti reči kasnije. I ova funkcija vraća presek ovih listi.
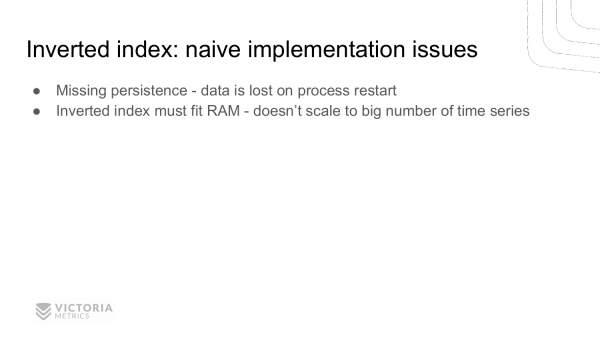
Kao što vidite, implementacija invertovanog indeksa nije previše složena. Ali to je naivna implementacija. Koji su njeni nedostaci? Glavni nedostatak naivne implementacije je to što se takav invertovani indeks čuva u radnoj memoriji. Nakon ponovnog pokretanja aplikacije gubimo ovaj indeks. Nema čuvanja ovog indeksa na disku. Za bazu podataka takav invertovani indeks teško da će odgovarati.
Drugi nedostatak također je povezan s memorijom. Inverzni indeks mora biti smješten u radnu memoriju. Ako premaši veličinu radne memorije, jasno je da ćemo dobiti – grešku zbog nedostatka memorije. Program neće raditi.
Ovaj problem može se riješiti pomoću gotovih rješenja kao što su , ili .
Ukratko, potrebna nam je baza podataka koja omogućuje brzo izvođenje tri operacije.
- Prva operacija je zapis
ključ-vrijednostu ovu bazu. Ona to radi vrlo brzo, gdjeključ-vrijednost– to su proizvoljni stringovi. - Druga operacija je brzo pretraživanje vrijednosti po zadanom ključu.
- I treća operacija je brzo pretraživanje svih vrijednosti prema zadanom prefiksu.
LevelDB i RocksDB – ove baze razvijene su u Googleu i Facebooku. Prvo je nastao LevelDB. Nakon toga, momci iz Facebooka su uzeli LevelDB i počeli ga poboljšavati, stvarajući RocksDB. Trenutno se gotovo sve unutarnje baze podataka u Facebooku temelje na RocksDB, uključujući i prebacivanje MySQL na RocksDB. Nazvali su to .
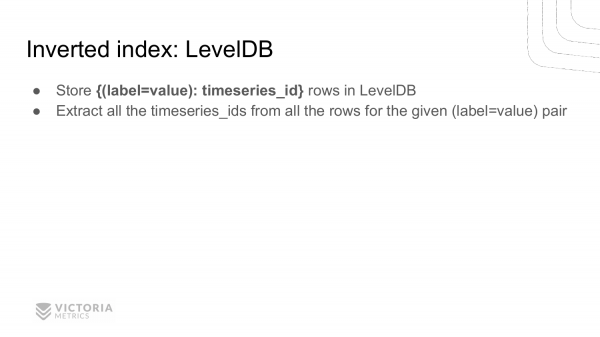
Inverzni indeks može se implementirati pomoću LevelDB. Kako to učiniti? Spremamo kao ključ label=value. A kao vrijednost – identifikator vremenskog niza u kojem postoji par label=value.
Ako imamo mnogo vremenskih nizova s ovom parom label=value, bit će mnogo redaka u ovoj bazi podataka s istim ključem i različitim timeseries_ids. Da bismo dobili popis svih timeseries_ids, koji počinju s ovim label=prefix, radimo range scan, za koji je ova baza podataka optimizirana. Dakle, odabiremo sve retke koji počinju s label=prefix i dobijamo potrebne timeseries_ids.
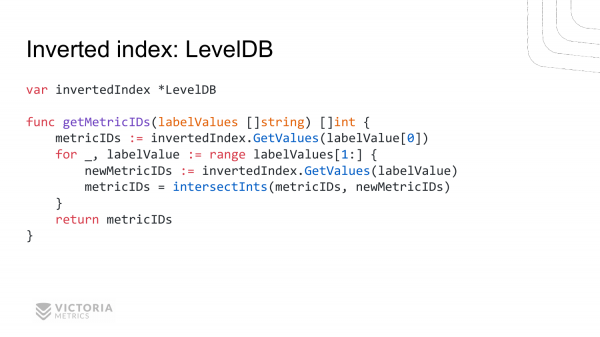
Evo okvirne implementacije, kako bi ona izgledala na Go. Imamo inverzni indeks. To je LevelDB.
Funkcija je ista kao za naivnu implementaciju. Gotovo se redak po redak ponavlja naivna implementacija. Jedina razlika je ta što umjesto pristupanja map pristupamo inverznom indeksu. Izvlačimo sve vrijednosti za prvi label=value. Zatim prolazimo kroz sve preostale parove label=value i izvlačimo odgovarajuće skupove metricIDs za njih. Zatim nalazimo presjek.
Čini se da je sve u redu, ali ovo rješenje ima nedostatke. VictoriaMetrics je u početku implementirala inverzni indeks temeljen na LevelDB. No, na kraju je morala odustati od njega.
Zašto? Zato što je LevelDB sporiji od naivne implementacije. U naivnoj implementaciji prema zadanoj ključnoj riječi odmah dobijamo cijeli slice. metricIDs. Ova vrlo brza operacija — cijeli slice je spreman za korištenje.
U LevelDB-u se prilikom svakog poziva funkcije GetValues mora proći kroz sve redove koji počinju s label=value. I za svaki redak izvući vrijednost timeseries_ids. Iz takvih timeseries_ids sakupiti slice ovih timeseries_ids. Očigledno je da je ovo znatno sporije od jednostavnog pristupa običnom mapu po ključi.
Drugi nedostatak je taj što je LevelDB napisan na C-u. Poziv C-funkcija iz Go-a nije jako brz. Traje stotine nanosekundi. To nije jako brzo, jer u usporedbi s običnim pozivom funkcije napisane na Go-u, koja traje 1-5 nanosekundi, razlika u performansama je nekoliko desetaka puta. Za VictoriaMetrics, ovo je bio fatalni nedostatak 🙂
Zbog toga sam napisao vlastitu implementaciju invertiranog indeksa. I nazvao je .
Mergeset je baziran na strukturi podataka MergeTree. Ova struktura podataka je preuzeta iz ClickHouse-a. Očigledno je da mergeset mora biti optimiziran za brzo pretraživanje timeseries_ids po zadanom ključi. Mergeset je potpuno napisan na Go-u. Možete pogledati . Implementacija mergeseta se nalazi u folderu . Možete pokušati shvatiti što se tamo događa.
API mergeseta je vrlo sličan LevelDB-u i RocksDB-u. T. j. omogućava brzo pohranjivanje novih zapisa i brzo biranje zapisa prema zadanom prefiksu.
O nedostacima mergeseta ćemo razgovarati kasnije. Sada ćemo razgovarati o problemima koji su nastali s VictoriaMetrics u produkciji prilikom implementacije invertiranog indeksa.
Zašto su se pojavili?
Prvi razlog je visoka promjena podataka. U prijevodu na hrvatski – to je česta promjena vremenskih serija. To se događa kada vremenska serija završava i počinje nova serija, ili počinju brojne nove vremenske serije. A to se događa često.
Drugi razlog je veliki broj vremenskih serija. Na početku, kada je monitoring postajao sve popularniji, broj vremenskih serija bio je mali. Na primjer, za svaki računar treba pratiti opterećenje procesora, memorije, mreže i diska. 4 vremenske serije po računalu. Imate, recimo, 100 računala i 400 vremenskih serija. To je jako malo.
S vremenom su ljudi smislili kako mjeriti detaljnije informacije. Na primjer, mjeriti opterećenje ne cijelog procesora, nego posebno svakog procesorskog jezgra. Ako imate 40 procesorskih jezgri, tada imate 40 puta više vremenskih serija za mjerenje opterećenja procesora.
No, to nije sve. Svako procesorsko jezgro može imati nekoliko stanja, kao što su idle, kada ne radi. Također, rad u user spaceu, rad u kernel spaceu i druga stanja. Svako takvo stanje također se može mjeriti kao zasebna vremenska serija. To dodatno povećava broj serija 7-8 puta.
Iz jedne metrike dobivamo 40 x 8 = 320 metrika samo za jedno računalo. Pomnožimo s 100, dobijemo 32 000 umjesto 400.
Kasnije je došao Kubernetes. I ponovno je pogoršao situaciju, jer se u Kubernetesu može hostati mnogo različitih servisa. Svaki servis u Kubernetesu sastoji se od mnogih podova. I sve to treba pratiti. Osim toga, imamo kontinuirani deployment novih verzija vaših servisa. Za svaku novu verziju trebamo kreirati nove vremenske serije. Na kraju se broj vremenskih serija eksponencijalno povećava i suočavamo se s problemom velikog broja vremenskih serija, što se naziva high-cardinality. VictoriaMetrics se s tim uspješno nosi u usporedbi s drugim bazama podataka za vremenske serije.
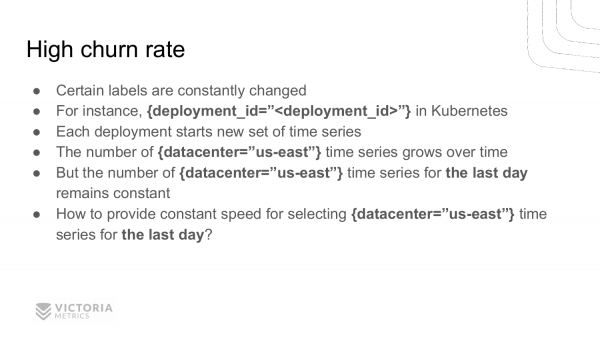
Pogledajmo detaljnije high churn rate. Zašto se javi high churn rate u produkciji? Zbog toga što se neka vrijednosti oznaka i tagova stalno mijenjaju.
Na primjer, uzmimo Kubernetes, u kojem postoji pojam deployment, tj. kada se objavljuje nova verzija vaše aplikacije. Razvijači Kubernetesa iz nekog razloga odlučili su dodati id oznake deploymenta.
Na što je to dovelo? Na to da se pri svakom novom deploymentu sve stare vremenske serije prekidaju, a umjesto njih počinju nove vremenske serije s novom vrijednosti oznake deployment_id. Takvih serija može biti stotine tisuća, pa čak i milijuni.
Važna značajka svega ovoga je da se ukupni broj vremenskih serija povećava, ali broj vremenskih serija koje su trenutno aktivne, na koje dolaze podaci, ostaje konstantan. Takvo stanje naziva se – high churn rate.
Glavni problem visoke stope izlaska je osigurati stalnu brzinu pretraživanja svih vremenskih serija za određeni skup oznaka unutar određenog vremenskog intervala. Obično se radi o vremenskom intervalu od posljednjeg sata ili posljednjeg dana.
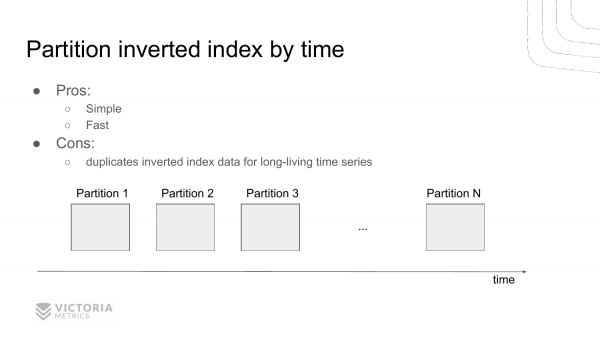
Kako riješiti ovaj problem? Ovo je prva opcija. Razdvojiti obrnuti indeks na neovisne dijelove po vremenu. Drugim riječima, prolazi određeni vremenski interval, prestajemo raditi s trenutnim obrnuto indeksom. Stvaramo novi obrnuti indeks. Prolazi još jedan vremenski interval, kreiramo još jedan i još jedan.
I pri odabiru iz tih obrnutih indeksa nalazimo skup obrnutih indeksa koji odgovaraju zadanom intervalu. Samim tim, biramo odatle ID-ove vremenskih serija.
To omogućuje uštedu resursa jer ne moramo pregledavati dijelove koji ne pripadaju zadanom intervalu. Drugim riječima, obično, ako biramo podatke za posljednji sat, propuštamo zahtjeve za prethodne vremenske intervale.
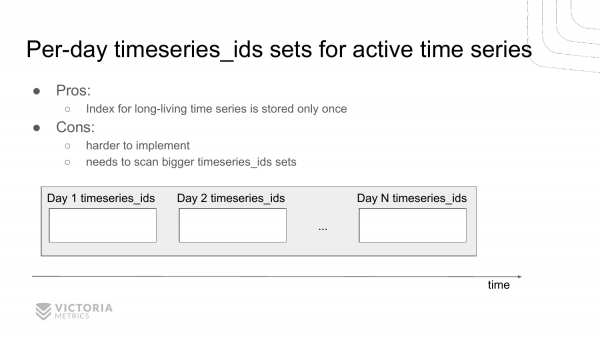
Postoji još jedna opcija za rješavanje ovog problema. To je da za svaki dan čuvamo zaseban popis ID-ova vremenskih serija koje su se pojavile tijekom tog dana.
Prednost ovog rješenja u odnosu na prethodno rješenje je u tome što ne dupliciramo informacije o vremenskim serijama koje ne nestaju tijekom vremena. One su stalno prisutne i ne mijenjaju se.
Nedostatak je u tome što je takvo rješenje složenije za implementaciju i teže za ispravak. I VictoriaMetrics je odabrala ovo rješenje. Povijesno se tako dogodilo. Ovo rješenje također se pokazuje dobro u usporedbi s prethodnim. Jer ovo rješenje nije implementirano zbog potrebe za dupliciranjem podataka u svakom dijelu za vremenske serije koje se ne mijenjaju, odnosno koje ne nestaju tijekom vremena. VictoriaMetrics je prvenstveno optimizovana za potrošnju diskovnog prostora, a prethodna implementacija pogoršavala je potrošnju diskovnog prostora. Ovo rješenje bolje odgovara minimiziranju potrošnje diskovnog prostora, stoga je odabrano.
Morao sam se boriti s tim. Borba se sastojala u tome da se u ovoj implementaciji mora odabrati mnogo više podataka. timeseries_ids za podatke, nego kada je obrnuti indeks razdvojen po vremenu.
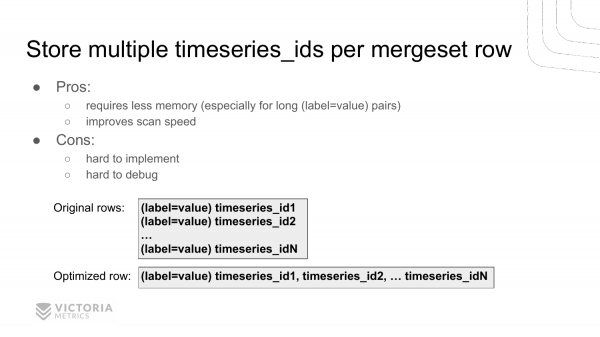
Kako smo riješili ovaj problem? Riješili smo ga na originalan način - tako da smo sačuvali nekoliko identifikatora vremenskih serija u svakoj stavci invertiranog indeksa umjesto jednog identifikatora. To jest, imamo ključ label=value, koji se pojavljuje u svakoj vremenskoj seriji. I sada čuvamo nekoliko timeseries_ids u jednoj stavci.
Evo primjera. Nekada smo imali N stavki, a sada imamo jednu stavku čiji je prefiks isti kao i kod svih ostalih. U prethodnoj stavci vrijednost sadrži sve id vremenskih serija.
To je omogućilo povećanje brzine skeniranja takvog invertiranog indeksa do 10 puta. Također je smanjilo potrošnju memorije za cache, jer sada čuvamo niz label=value samo jedanput u cacheu zajedno sa N puta. I taj niz može biti veliki, ako u oznakama i tagovima pohranjujete dugačke redove koje Kubernetes rado ubacuje.
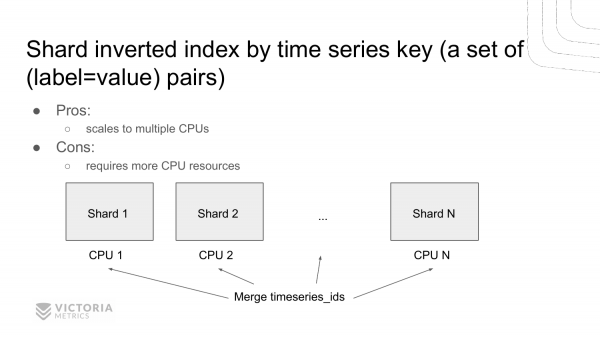
Još jedna opcija za ubrzanje pretraživanja kroz invertirani indeks je sharding. Kreiranje nekoliko invertiranih indeksa umjesto jednog i shardiranje podataka između njih po ključu. To je skup key=value parova. To jest, dobijamo nekoliko neovisnih invertiranih indeksa koje možemo paralelno ispitivati na nekoliko procesora. Prethodne implementacije omogućavale su rad samo u jednoj procesorskoj konfiguraciji, to jest skeniranje podataka samo na jednom jezgru. Ovo rješenje omogućava skeniranje podataka istovremeno na nekoliko jezgri, baš kao što to voli raditi ClickHouse. To planiramo implementirati.
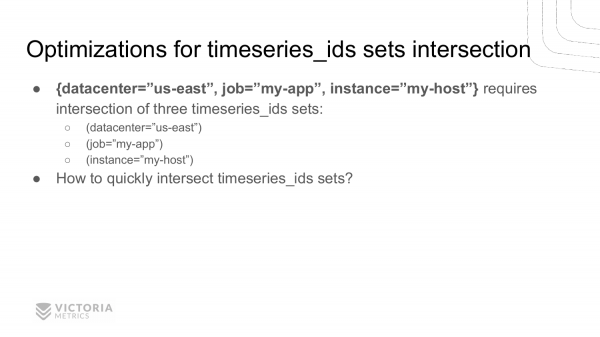
A sada se vratimo našim ovnima - funkciji presijecanja timeseries_ids. Razmotrimo koje bi mogle biti implementacije. Ova funkcija omogućava pronalaženje timeseries_ids za zadani skup label=value.
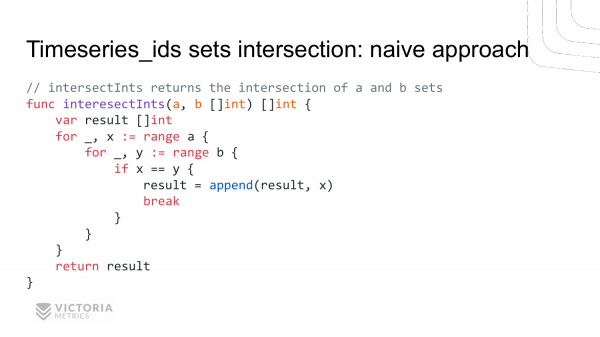
Prva opcija je naivna implementacija. Dva ugniježdena ciklusa. Tako dobijamo ulaz za funkcije intersectInts dva slices — a i b. Na izlazu treba vratiti presjek ovih slices.
Naivna implementacija izgleda ovako. Prolazimo kroz sve vrijednosti iz slice a, unutar ovog ciklusa prolazimo kroz sve vrijednosti slice b. I uspoređujemo ih. Ako se poklapaju, tada smo pronašli presjek. I spremamo ga u result.
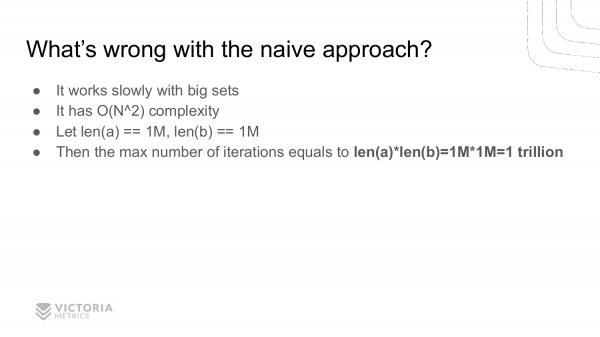
Koje su nedostatke? Kvadratna složenost - to je njen glavni nedostatak. Na primjer, ako imate veličine slice a i b Ako tražite milijun, ova funkcija nikada neće dati odgovor. Jer će morati napraviti jedan trilijun iteracija, što je jako puno čak i za moderne računare.
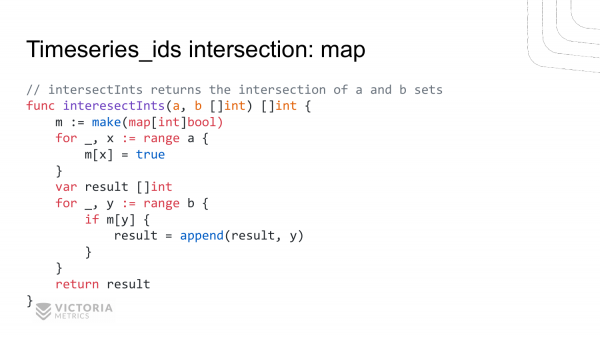
Druga implementacija se temelji na map. Napravimo map. Stavimo sve vrijednosti iz slice u tu map. a. Zatim prolazimo kroz slice odvojenom petljom. b. I provjeravamo – postoji li ta vrijednost iz slice. b u mapi. Ako postoji, dodajemo je u rezultat.
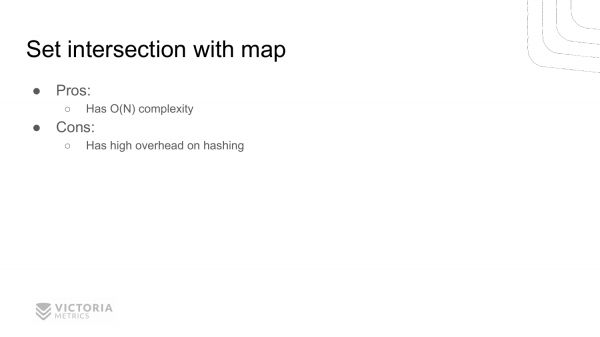
Koje su prednosti? Prednost je u tome što ovdje postoji samo linearna složenost. To jest, funkcija će se mnogo brže izvršiti za velike veličine slices. Za milijun veličinu slice, ova funkcija će se izvršiti za 2 milijuna iteracija, za razliku od trilijun iteracija, kao u prethodnoj funkciji.
A nedostatak je u tome što ova funkcija zahtijeva više memorije da bi se stvorila ova mapa.
Drugi nedostatak – to je veliki overhead za hashiranje. Ova mana nije toliko očita. I za nas to također nije bilo toliko očito, pa je u početku u VictoriaMetrics implementacija intersection bila putem mape. No, profiliranje je pokazalo da se najveće procesorsko vreme troši na zapisivanje u mapu i na provjeru prisutnosti vrijednosti u toj mapi.
Zašto se procesorsko vreme troši na tim mjestima? Zato što u tim redovima Go provodi operaciju hashiranja. To jest, izračunava hash od ključa da bi se zatim obratio po zadanom indeksu u HashMap. Operacija izračunavanja hasha se izvršava za desetine nanosekundi. To je sporo za VictoriaMetrics.
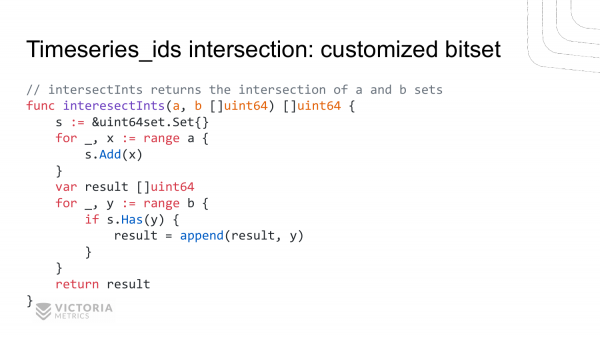
Odlučio sam realizirati bitset, optimiziran posebno za ovaj slučaj. Tako sada izgleda presjek dva slices. Ovdje stvaramo bitset. Dodajemo u njega elemente iz prvog slice. Zatim provjeravamo prisutnost tih elemenata u drugom slice. I dodajemo ih u rezultat. To jest, gotovo se ne razlikuje od prethodnog primjera. Jedina razlika je u tome što smo ovdje zamijenili pristup mapi s prilagođenim funkcijama. add i has.
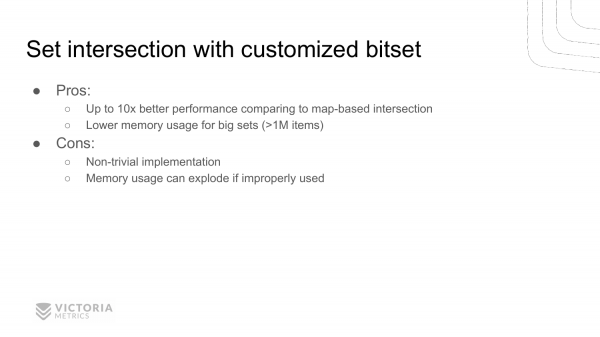
Na prvi pogled čini se da bi to trebalo raditi sporije, ako je ranije korištena standardna mapa, a ovdje se još pozivaju neke funkcije, ali profiliranje pokazuje da ova stvar radi 10 puta brže od standardne mape za slučaj s VictoriaMetrics.
Osim toga, koristi mnogo manje memorije u odnosu na implementaciju s mapom. Jer ovdje spremamo bitove umjesto osmobajtnih vrijednosti.
Nedostatak ove implementacije je u tome što nije tako očigledna, nije trivijalna.
Još jedan nedostatak koji mnogi možda neće primijetiti je da ova implementacija može loše raditi u nekim slučajevima. To jest, optimizirana je za specifični slučaj, za ovaj slučaj preklapanja ids vremenskih serija VictoriaMetrics. To ne znači da će odgovarati svim slučajevima. Ako se ne koristi ispravno, može doći do nedostatka memorije i usporavanja performansi.
Razmotrite implementaciju ove strukture. Ako želite pogledati, nalazi se u izvorima VictoriaMetrics, u direktoriju . Optimizirana je upravo za slučaj VictoriaMetrics, gdje timeseries_id predstavlja 64-bitnu vrijednost, pri čemu se prvih 32 bita u osnovi stalno, a samo se posljednjih 32 bita mijenjaju.
Ova struktura podataka ne pohranjuje se na disku, već radi samo u memoriji.
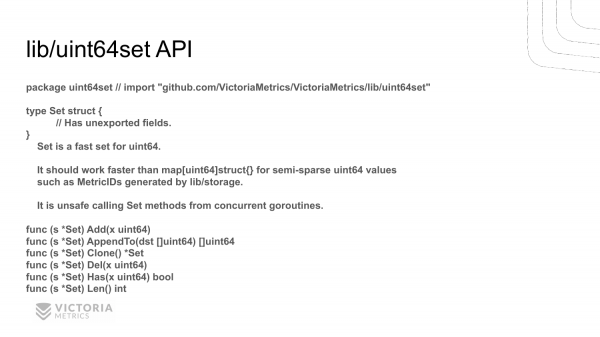
Evo njenog API-a. Nije previše složen. API je prilagođen konkretnoj primjer koristi VictoriaMetrics. To jest, ovdje nema suvišnih funkcija. Ovdje su funkcije koje se jasno koriste u VictoriaMetrics.
Postoje funkcije add, koja dodaje nove vrijednosti. Postoji funkcija has, koja provjerava nove vrijednosti. A postoji funkcija del, koja uklanja vrijednosti. Tu je i pomoćna funkcija len, koja vraća veličinu skupa. Funkcija clone klonira skup. I funkcija appendto pretvara ovaj skup u slice timeseries_ids.
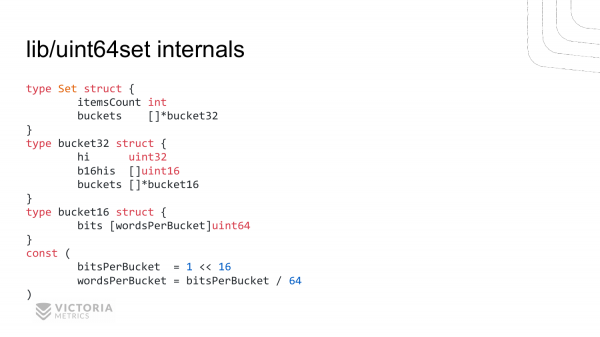
Ovako izgleda implementacija ove strukture podataka. U skupu su dva elementa:
ItemsCount– to je pomoćno polje koje omogućava brzo vraćanje broja elemenata u skupu. Mogli bismo proći bez ovog pomoćnog polja, ali je morali dodati ovdje jer VictoriaMetrics često provjerava duljinu bitseta u svojim algoritmima.Drugo polje je
buckets. To je slice strukturebucket32. U svakoj strukturi pohranjuje sehipolje. To su gornjih 32 bita. I dva slice —b16hisibucketsizbucket16struktura.
Ovdje su pohranjeni gornjih 16 bita druge polovice 64-bitne strukture. A ovdje su bitsetovi za nižih 16 bita svakog bajta.
Bucket64 se sastoji od niza uint64. Duljina se izračunava pomoću ovih konstanti. U jednom bucket16 maksimum može pohranjivati 2^16=65536 bita. Ako podijelimo s 8, to je 8 kilobajta. Ako podijelimo ponovno s 8, to je 1000 uint64 vrijednosti. To jest, Bucket16 – to je 8-kilobajtna struktura.
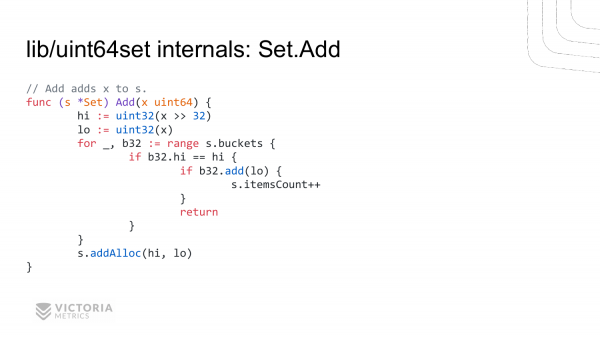
Pogledajmo kako je implementirana jedna od metoda ove strukture za dodavanje nove vrijednosti.
Sve započinje s uint64 vrijednosti. Izračunavamo gornjih 32 bita, izračunavamo donjih 32 bita. Prolazimo kroz sve buckets. Uspoređujemo gornjih 32 bita u svakom bucket-u s dodanom vrijednošću. Ako se poklapaju, pozivamo funkciju add u strukturi b32 buckets. I dodajemo donjih 32 bita. Ako to vrati true, to znači da smo dodali takvu vrijednost i da je nismo imali. Ako vraća false, tada je takva vrijednost već bila. Zatim povećavamo broj elemenata u strukturi.
Ako nismo pronašli odgovarajući bucket s potrebnom hi-vrijednošću, pozivamo funkciju addAlloc, koja dodjeljuje novi bucket, dodajući ga u bucket-strukturu.
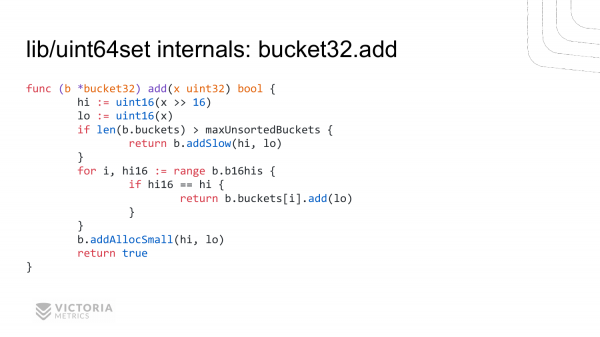
To je implementacija funkcije b32.add. Slična je prethodnoj implementaciji. Izračunavamo gornjih 16 bita, donjih 16 bita.
Zatim prolazimo kroz sve gornje 16 bita. Pronalazimo podudaranja. U slučaju podudaranja pozivamo metodu add, koju ćemo razmotriti na sljedećoj stranici za bucket16.
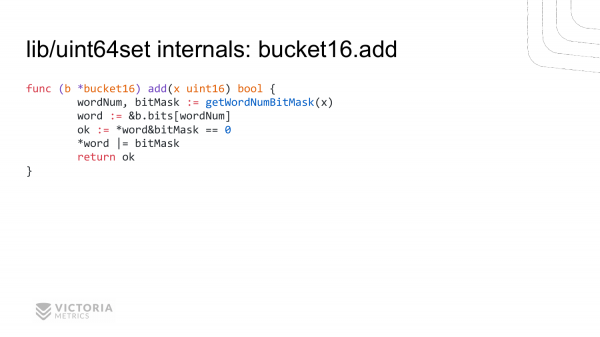
I ovo je najniža razina koja bi trebala biti maksimalno optimizirana. Izračunavamo za uint64 id vrijednost u slice bitu, kao i bitmask. Ovo je maska za ovu 64-bitnu vrijednost, kojom se može provjeriti postojanje ovog bita ili ga postaviti. Provjeravamo postojanje ovog bita, postavljamo ga i vraćamo njegovo postojanje. Ova implementacija nam je omogućila da ubrzamo operaciju preklapanja ids vremenskih serija 10 puta u odnosu na obične mape.
U VictoriaMetrics, osim ove optimizacije, postoji mnogo drugih optimizacija. Većina tih optimizacija nije dodana tek tako, već nakon profiliranja koda u produkciji.
To je glavno pravilo optimizacije – ne dodavati optimizaciju pretpostavljajući da će ovdje biti usko grlo, jer se može pokazati da neće biti uskog grla. Optimizacija obično pogoršava kvalitetu koda. Stoga bi trebalo optimizirati samo nakon profiliranja i po mogućstvu u produkciji, kako bi to bili stvarni podaci. Tko je zainteresiran, može pogledati izvorne kodove VictoriaMetrics i proučiti druge optimizacije koje postoje.
Imam pitanje o bitsetu. Jako podsjeća na implementaciju C++ vector bool, optimizirani bitset. Jeste li uzeli implementaciju odatle?
Ne, to nije izvor. Prilikom implementacije ovog bitset-a, orijentirao sam se na znanje strukture ovih ids vremenskih serija koje se koriste u VictoriaMetrics. Njihova struktura je takva da je gornjih 32 bita uglavnom stalno. Donjih 32 bita se mogu mijenjati. Što je niži bit, to se češće može mijenjati. Stoga je ova implementacija optimizirana upravo za ovu strukturu podataka. C++ implementacija, koliko znam, optimizirana je za opći slučaj. Ako se radi optimizacija za opći slučaj, to znači da neće biti najoptimalnija za konkretni slučaj.
Preporučujem vam da još pogledate izlaganje Alekseja Milovida. Prije otprilike mjesec dana govorio je o optimizacijama u ClickHouse-u za konkretne specijalizacije. On baš objašnjava da su u općem slučaju C++ implementacija ili neka druga implementacija prilagođene za dobar rad u prosjeku. Mogu raditi lošije od specijalizirane implementacije koja se temelji na konkretnim saznanjima, kao kod nas, kada znamo da su gornji 32 bita uglavnom stalni.
Imam drugo pitanje. Koja su kardinalna razlikovanja od InfluxDB-a?
Postoji mnogo kardinalnih razlika. Što se tiče performansi i potrošnje memorije, InfluxDB u testovima pokazuje 10 puta veću potrošnju memorije za vremenske serije visoke kardinalnosti, kada ih imate puno, na primjer, milijune. Na primjer, VictoriaMetrics troši 1 GB na milijun aktivnih serija, dok InfluxDB troši 10 GB. I to je velika razlika.
Druga kardinalna razlika je u tome što InfluxDB ima čudne jezike upita – Flux i InfluxQL. Nisu baš zgodni za rad s vremenskim serijama u usporedbi s , koji se podržava u VictoriaMetrics-u. PromQL – jezik upita iz Prometheusa.
I još jedna razlika je ta da InfluxDB ima pomalo neobičan model podataka, gdje u svakom retku može biti pohranjeno nekoliko polja s različitim skupovima oznaka. Ti redovi se dijele na razne tablice. Ova dodatna složenja otežavaju daljnji rad s ovom bazom. Teško je održavati i razumjeti.
U VictoriaMetrics-u je sve puno jednostavnije. Tamo svaka vremenska serija predstavlja ključ-vrijednost. Vrijednost – to je skup točaka – (timestamp, value), a ključ – to je skup label=value. Nema podjele na fields i measurements. To vam omogućuje da birate bilo koje podatke, a zatim ih kombinirate, zbrajate, oduzimate, množite i dijelite, za razliku od InfluxDB-a gdje izračuni između različitih redaka još uvijek nisu implementirani, koliko ja znam. Čak i ako su implementirani, to je teško, potrebno je napisati puno koda.
Imam dodatno pitanje. Jesam li dobro shvatio da je postojala neka poteškoća koju ste spominjali, da taj obrnuti indeks ne stane u memoriju, pa se podaci dijele?
Na početku sam pokazao naivnu implementaciju obrnutog indeksa na standardnoj Go-ovoj map. Takva implementacija nije pogodna za baze podataka, jer ovaj obrnuti indeks ne ostaje spremljen na disku, a baza podataka mora pohraniti podatke na disk kako bi po ponovnom pokretanju ti podaci ostali dostupni. U ovoj implementaciji, pri ponovnom pokretanju aplikacije, obrnuti indeks će nestati. I izgubiti ćete pristup svim podacima jer ih nećete moći pronaći.
Pozdrav! Hvala na izlaganju! Zovem se Pavel. Dolazim iz kompanije Wildberries. Imam nekoliko pitanja za vas. Prvo pitanje. Kako vam se čini, da ste izabrali drugi princip pri građenju arhitekture svoje aplikacije i partijonirali podatke prema vremenu, možda biste mogli raditi presjek podataka pri pretraživanju, temeljen samo na tome da se u jednoj particiji nalaze podaci za jedan vremenski interval, tj. da ne biste morali brinuti o razbacanim dijelovima? Pitanje broj 2 — budući da implementirate sličan algoritam s bitset-om i svim ostalim, jeste li možda pokušali koristiti procesorske instrukcije? Možda ste isprobali takve optimizacije?
Na drugo odmah odgovaram. Nismo još stigli do toga. Ali ako bude potrebno, doći ćemo. A koje je bilo prvo pitanje?
Raspravili ste o dva scenarija. I rekli ste da ste izabrali drugi s složenijom implementacijom. I niste preferirali prvi, gdje su podaci podijeljeni prema vremenu.
Da. U prvom slučaju ukupna količina indeksa bi bila veća, jer bismo u svakoj particiji morali čuvati duplikate podataka za one vremenske serije koje se protežu kroz sve te particije. I ako je vaš churn rate za vremenske serije mali, tj. ako se stalno koriste iste serije, u prvom slučaju bismo znatno više izgubili u količini zauzetog diskovnog prostora u odnosu na drugi slučaj.
Ali da, vremensko particioniranje je dobra opcija. To koristi i Prometheus. No, Prometheus ima još jedan nedostatak. Kada spaja te delove podataka, treba zadržati u memoriji meta-informacije o svim labelima i vremenskim serijama. Stoga, ako su delovi podataka veliki koje spaja, potrošnja memorije znatno raste tokom spajanja, za razliku od VictoriaMetrics. Tokom spajanja, VictoriaMetrics uopće ne troši memoriju, potroši nekoliko kilobajta, bez obzira na veličinu spajanih delova podataka.
Algoritam koji koristite koristi memoriju. U njoj se beleže oznake vremenskih serija koje imaju vrednosti. Tako proveravate prisutnost u jednom i drugom skupu podataka. I shvatate da li je došlo do preseka ili ne. Obično se u bazama podataka implementiraju kursori, iteratori, koji čuvaju svoje trenutno stanje i prolaze kroz sortirane podatke, zbog čega imate jednostavnu složenost tih operacija.
Zašto ne koristimo kursor za presek podataka?
Da.
U našem LevelDB ili u mergesetu čuvaju se sortirani redovi. Možemo proći kursorom i pronaći presek. A zašto ne koristimo? Zato što je sporo. Zato što kursori podrazumevaju da se za svaki red mora pozvati funkcija. Poziv funkcije traje 5 nanosekundi. A ako imate 100 000 000 redova, dobijate da trošimo pol sekunde samo na poziv funkcije.
To postoji, da. I poslednje moje pitanje. Pitanje koje možda zvuči malo čudno. Zašto se u trenutku prijema podataka ne mogu izračunati svi potrebni agregati i sačuvati ih u potrebnom obliku? Zašto čuvati ogromne količine u sistemima poput VictoriaMetrics, ClickHouse itd., da bi kasnije trošili mnogo vremena na njih?
Dat ću primjer da bude jasnije. Recimo, kako radi mali igračka brzinomjer? On bilježi udaljenost koju ste prešli, stalno je dodajući u jedan iznos, a u drugi – vrijeme. I dijeli. I dobije prosječnu brzinu. Možemo učiniti otprilike isto. Zbrajati u hodu sve potrebne činjenice.
Dobro, razumijem pitanje. Vaš primjer ima smisla. Ako znate koje su vam potrebne agregate, to je najbolja implementacija. No, problem je u tome što ljudi pohranjuju te metrike, neke podatke u ClickHouse i ne znaju još kako će ih u budućnosti agregirati, filtrirati, pa moraju pohranjivati sve sirove podatke. Ali ako znate da trebate izračunati nešto prosječno, zašto ga ne biste izračunali, umjesto da ondje pohranjujete hrpu sirovih vrijednosti? Ali to samo ako znate što vam točno treba.
Usput, baze za pohranu vremenskih serija podržavaju izračunavanje agregata. Na primjer, Prometheus podržava . Odnosno, to se može napraviti ako znate koji su vam potrebni agregati. U VictoriaMetrics toga trenutno nema, ali ispred nje obično se stavlja Prometheus, u kojem to možete učiniti u pravilima snimanja.
Na primjer, na prethodnom poslu trebalo je brojati broj događaja u pomičnom prozoru u zadnjem satu. Problem je bio u tome što je trebalo napraviti prilagođenu implementaciju na Go, tj. servis za brojanje te stvari. Taj servis na kraju nije bio trivijalan, jer je teško računati. Implementacija može biti jednostavna ako trebate brojati neke agregate na fiksnim vremenskim intervalima. Međutim, ako želite brojati događaje u pomičnom prozoru, to nije tako jednostavno kao što izgleda. Mislim da to još uvijek nije implementirano u ClickHouse ili u bazama vremenskih serija, jer je to teško za implementaciju.
I još jedno pitanje. Sada smo govorili o prosječenju, i sjetio sam se da je nekad postojala stvar kao što je Graphite s backendom Carbon. I on je znao prorijediti stare podatke, tj. ostaviti jednu točku u minuti, jednu točku na satu itd. U principu, to je prilično zgodno, ako nam trebaju sirovi podaci, uvjetno rečeno, za mjesec dana, a sve ostalo se može prorijediti. No, Prometheus i VictoriaMetrics ne podržavaju tu funkcionalnost. Planira li se podržavati? Ako ne, zašto?
Hvala na pitanju. Naši korisnici nas to povremeno pitaju. Pitaju kada ćemo dodati podršku za downsampling. Ovdje se pojavljuje nekoliko problema. Prvo, svaki korisnik pod downsampling razumije nešto drugo: netko želi dobiti bilo koju točku na zadanom intervalu, netko želi maksimalne, minimalne, prosječne vrijednosti. Ako vaša baza podataka prima podatke iz više sustava, ne možete ih sve razdvojiti. Može se dogoditi da za svaki sustav treba koristiti različito prorjeđivanje. I to je teško za implementirati.
Drugo je to da je VictoriaMetrics, kao i ClickHouse, optimizirana za rad s velikim količinama sirovih podataka, stoga može obraditi milijardu redaka za manje od sekunde, ako imate mnogo jezgri u vašem sustavu. Skeniranje točaka vremenskih serija u VictoriaMetrics iznosi 50 000 000 točaka u sekundi po jednoj jezgri. I ta se izvedba skalira na dostupne jezgre. Drugim riječima, ako imate 20 jadra, na primjer, može se skenirati milijardu točaka u sekundi. Ova osobina VictoriaMetrics i ClickHouse smanjuje potrebu za downsamplingom.
Još jedna osobina je da VictoriaMetrics učinkovito komprimira te podatke. Kompresija u prosjeku na produkciji iznosi od 0,4 do 0,8 bajta po točki. Svaka točka je timestamp + vrijednost. I ona se komprimira na manje od jednog bajta u prosjeku.
Sergej. Imamo pitanje. Kolika je minimalna granica vremena zapisivanja?
Jedna milisekunda. Nedavno smo razgovarali s drugim programerima baza podataka za vremenske serije. Njihova minimalna granica vremena je jedna sekunda. U Graphiteu, na primjer, također je jedna sekunda. U OpenTSDB također je jedna sekunda. U InfluxDB – nanosjekundna preciznost. U VictoriaMetrics – jedna milisekunda, jer u Prometheusu imamo jednu milisekundu. I VictoriaMetrics je prvotno razvijena kao udaljeni spremnik za Prometheus. No sada može čuvati podatke i iz drugih sustava.
Osoba s kojom sam razgovarao kaže da imaju sekundarnu preciznost — to im je dovoljno, jer ovisi o vrsti podataka koji se spremaju u bazu vremenskih serija. Ako su to DevOps podaci ili podaci s infrastrukture, gdje ih prikupljate u intervalima od 30 sekundi do jedne minute, tada je sekundna preciznost dovoljna, manje ne treba. No ako prikupljate te podatke iz sustava s visokom frekvencijom trgovanja, tada je potrebna nanosjekundna preciznost.
Millisekundna preciznost u VictoriaMetrics pogodna je i za DevOps slučajeve, i može odgovarati većini slučajeva koje sam spomenuo na početku izlaganja. Jedino za što možda neće biti prikladna su sustavi za visoko frekventno trgovanje.
Hvala! I još jedno pitanje. Koja je kompatibilnost u PromQL?
Potpuna unazadna kompatibilnost. VictoriaMetrics potpuno podržava PromQL. Osim toga, dodaje još dodatnu proširenu funkcionalnost na PromQL koja se zove . Što se tiče te proširene funkcionalnosti, postoji izlaganje na YouTubeu. Govorio sam o tome na Monitoring Meetup-u u proljeće u Peterburgu.
Telegram kanal .
Samo registrirani korisnici mogu sudjelovati u anketi. , molimo.
Što vas sprečava da pređete na VictoriaMetrics kao dugotrajno skladište za Prometheus? (Napišite u komentarima, dodati ću u anketu))
71,4%Ne koristim Prometheus5
28,6%Nisam znao za VictoriaMetrics2
Glasalo je 7 korisnika. Suzdržalo se 12 korisnika.
Izvor: habr.com
