

Svi govore o procesima razvoja i testiranja, obuci osoblja, povećanju motivacije, ali tih procesa je malo kada minuta zastoja servisa košta astronomske novce. Što učiniti kada provodite financijske transakcije pod strogim SLA-om? Kako povećati pouzdanost i otpornost vaših sustava, a da preskočite razvoj i testiranje?
Sljedeća konferencija HighLoad++ održat će se 6. i 7. travnja 2020. u Sankt Peterburgu. Detalji i karte po . 9. studenog, 18:00. HighLoad++ Moskva 2018, dvorana „Delhi + Kalkuta“. Sažeci i .
Evgenij Kuzovlev (dalje – EK): – Prijatelji, pozdrav! Zovem se Kuzovlev Evgenij. Ja sam iz tvrtke EcommPay, konkretno odjel – EcommPay IT, IT odjel grupacije. I danas ćemo razgovarati o zastoju – kako ih izbjeći, kako minimizirati njihove posljedice ako izbjegavanje nije moguće. Tema je postavljena ovako: „Što učiniti kada minuta zastoja košta 100000 dolara“? Da rezimiram, brojke su usporedive.
Čime se bavi EcommPay IT?
Tko smo mi? Zašto ja ovdje stojim pred vama? Zašto imam pravo pričati o ovome? I o čemu ćemo ovdje detaljnije razgovarati?
Grupacija EcommPay je međunarodni acquirer. Procesiramo uplate širom svijeta – u Rusiji, Europi, jugoistočnoj Aziji (Diljem svijeta). Imamo 9 ureda, ukupno 500 zaposlenika i otprilike malo manje od polovine među njima su IT stručnjaci. Sve što radimo, sve na čemu zarađujemo, sami smo napravili.
Svi naši proizvodi (a imamo ih prilično mnogo – u našoj liniji velikih IT proizvoda imamo oko 16 različitih komponenti) sami smo napisali; sami programiramo, sami razvijamo. Trenutno obavljamo oko milijun transakcija dnevno (milijuni – vjerojatno tako bi bilo ispravno reći). Mi smo prilično mlada kompanija – staro smo svega oko šest godina.
Prije 6 godina to je bio start-up, kada su momci došli zajedno s poslom. Bili su ujedinjeni idejom (nije bilo ništa osim ideje), i krenuli smo. Kao i svaka start-up tvrtka, trčali smo brže... Brzina nam je bila važnija od kvalitete.
U nekom trenutku smo stali: shvatili smo da ne možemo nastaviti s tom brzinom i kvalitetom i da nam prvo treba postaviti fokus na kvalitetu. Tada smo donijeli odluku da napišemo novu platformu koja će biti ispravna, skalabilna i pouzdana. Tu platformu smo počeli razvijati (počeli smo ulagati, razvijati razvoj, testiranje), ali smo u nekom trenutku shvatili da razvoj i testiranje ne omogućuju uspon na novu razinu kvalitete usluge.
Izradite novi proizvod, postavite ga na produkciju, ali opet nešto neće ići u redu. Danas ćemo razgovarati o tome kako doći do novog kvalitativnog nivoa (kako smo mi to postigli, o našem iskustvu), izostavljajući razvoj i testiranje; razgovarat ćemo o tome što je dostupno u eksploataciji – što eksploatacija može sama učiniti, što može ponuditi testiranju kako bi utjecala na kvalitetu.
Ukinuća. Zapovijedi eksploatacije.
Uvijek je osnovni kamen o čemu ćemo danas govoriti – downtime. Strašna riječ. Ako imamo downtime – sve je loše. Trčimo da ga ispravimo, administratori drže server – bože, da ne padne, kao u onoj pjesmi. O tome ćemo danas razgovarati.
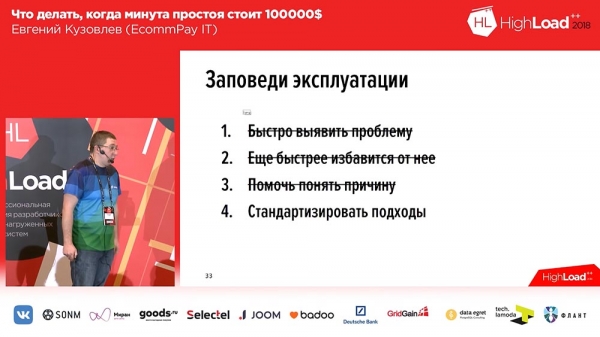
Kada smo počeli mijenjati svoje pristupe, formulirali smo 4 zapovijedi. One su prikazane na slajdovima:
Te zapovijedi su dovoljno jednostavne:
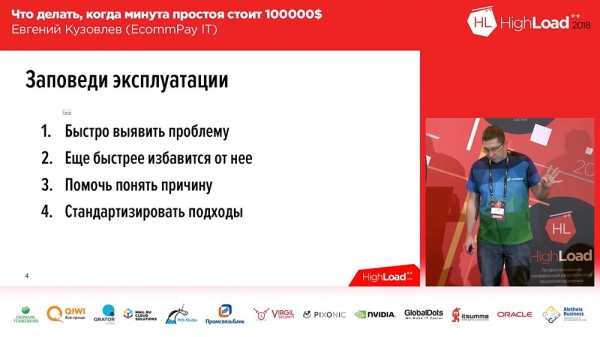
- Brzo otkriti problem.
- Još brže se riješiti problema.
- Pomoći razumjeti uzrok (kasnije, za programere).
- I standardizirati pristupe.
Skrećem vašu pažnju na točku br. 2. Oslobađamo se problema, a ne rješavamo ga. Rješavanje je sekundarno. Za nas je primarno to što je korisnik zaštićen od tog problema. On će postojati u nekakvom izoliranom okruženju, ali to okruženje neće imati kontakt s njim. Proći ćemo kroz te četiri skupine problema (neke detaljnije, a neke manje detaljno), reći ću vam što mi radimo, kakvo imamo adekvatno iskustvo u rješenjima.
Uklanjanje problema: kada se javljaju i što s njima učiniti?
No, počnimo ne redom, već s točke br. 2 – kako brzo riješiti problem? Postoji problem – trebamo ga ukloniti. "Što da radimo s tim?" – to je osnovno pitanje. A kada smo počeli razmišljati o tome kako ukloniti problem, formulirali smo određene zahtjeve koje rješavanje problema mora ispuniti.
Da bismo formulirali te zahtjeve, postavili smo si pitanje: "Kada se suočavamo s problemima?" I problemi, kako se pokazalo, pojavljuju se u četiri slučaja:
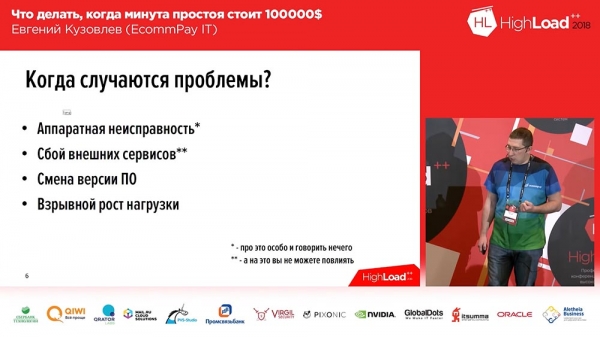
- Hardverska greška.
- Kvar vanjskih usluga.
- Promjena verzije softvera (taj famozni deployment).
- Eksplozivni porast opterećenja.
O prva dva nećemo razgovarati. Hardverska greška se rješava prilično jednostavno: sve što imate treba biti duplicirano. Ako su to diskovi, diskovi trebaju biti u RAID-u, ako je to server – server treba biti dupliciran, ako imate mrežnu infrastrukturu – trebate imati drugu kopiju mrežne infrastrukture, to jest, uzimate i duplicirate. A ako vam nešto otkaže, prebacujete se na rezervne kapacitete. Ovdje je teško reći više.
Drugo – kvar vanjskih usluga. Za većinu sustava to uopće nije problem, ali ne za nas. Budući da obrađujemo plaćanja, mi smo aglomerator koji stoji između korisnika (koji unosi svoje kartične podatke) i banaka, platnih sustava ("Visa", "MasterCard", "Mir" i slično). Vanjskim našim uslugama (platnim sustavima, bankama) svojstveno je da ne rade. Ni mi ni vi (ako imate takve usluge) na to ne možemo utjecati.
Što tada učiniti? Ima dva rješenja. Prvo, ako možete, trebate duplicirati tu uslugu na neki način. Na primjer, mi, ako možemo, preusmjeravamo promet s jedne usluge na drugu: ako smo obrađivali kartice kroz "Sberbank", a "Sberbank" ima problema – prebacujemo promet [uvjetno] na "Raiffeisen". Drugo, što možemo učiniti – vrlo brzo primijetiti kvar vanjskih usluga, pa ćemo o brzini reakcije razgovarati u sljedećem dijelu izlaganja.
U suštini, od ovih četiri, možemo konkretno utjecati na promjenu verzija softvera – poduzeti mjere koje će poboljšati situaciju u kontekstu implementacija i u kontekstu naglog rasta opterećenja. Zapravo, to smo i učinili. Ovdje, opet, mala napomena…
Od ovih četiriju problema, nekoliko se rješava odmah ako imate oblak. Ako ste na „Microsoft Azure”, „Ozon” oblacima, koristite naše oblake od „Yandex-a” ili „Mail.ru”, barem se hardverski kvarovi pretvaraju u njihov problem i vama odmah sve postaje dobro u kontekstu hardverskih kvarova.
Mi smo pomalo neobična kompanija. Ovdje svi govore o „Kubernetesu”, o oblacima – kod nas nema ni „Kubernetes-a”, ni oblaka. Umjesto toga, imamo rackove sa hardverom u brojnim data centrima, i na tom hardveru moramo živjeti, moramo biti odgovorni za sve to. Stoga, u tom kontekstu, razgovarajmo. Dakle, o problemima. Prva dva su izostavljena.
Promjena verzije softvera. Osnove
Naši developeri nemaju pristup produkciji. Zašto? Jednostavno, mi smo certificirani prema PCI DSS, i naši developeri jednostavno nemaju pravo ulaziti u „produktion”. Sve, točka. Potpuno. Stoga odgovornost razvoja završava točno u trenutku kada je razvoj predao build za objavu.
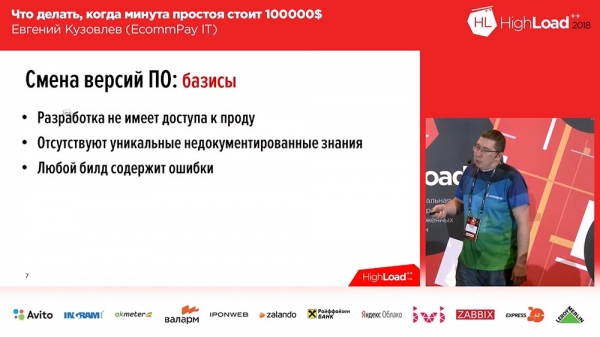
Naša druga osnova, koja nam također puno pomaže – je odsustvo jedinstvenog nedokumentiranog znanja. Nadam se da je i kod vas tako. Jer, ako nije – imat ćete problema. Problemi će nastati kada to jedinstveno nedokumentirano znanje ne bude prisutno u pravo vrijeme na pravom mjestu. Recimo, jedan čovjek zna kako implementirati određenu komponentu – tog čovjeka nema, na godišnjem je odmoru ili je bolestan – i sve, imate probleme.
I treća osnova do koje smo došli. Došli smo do nje kroz bol, krv, suze – došli smo do spoznaje da svaki naš build sadrži greške, čak i ako je bez grešaka. Tako smo odlučili za sebe: kada nešto implementiramo, kada nešto idemo u produkciju – naš build sadrži greške. Formirali smo zahtjeve kojima naš sustav mora udovoljiti.
Zahtjevi za promjenu verzije softvera
Ovih zahtjeva ima tri:
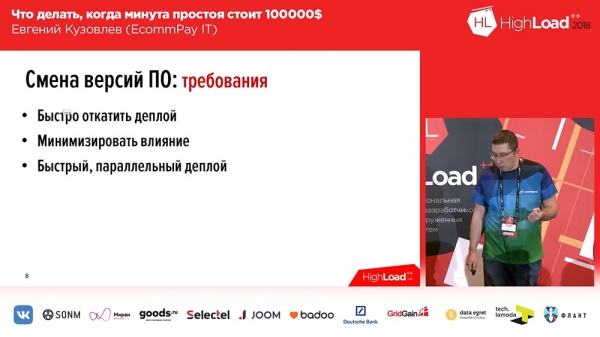
- Moramo brzo vratiti implementaciju.
- Moramo minimizirati utjecaj neuspješne implementacije.
- I trebamo imati mogućnost brzog paralelnog deploy-a.
Upravo tako! Zašto? Zato što pri deploy-u nove verzije brzina nije ključna, ali ako nešto krene po zlu, važno je brzo se vratiti i imati minimalan utjecaj. No ako imate set verzija u produkciji za koje se ispostavi da sadrže greške (kako to obično biva, deploy uopće nije bio, ali greška postoji) – vaša brzina narednog deploy-a postaje ključna. Što smo učinili da zadovoljimo te zahtjeve? Približili smo se toj metodologiji:
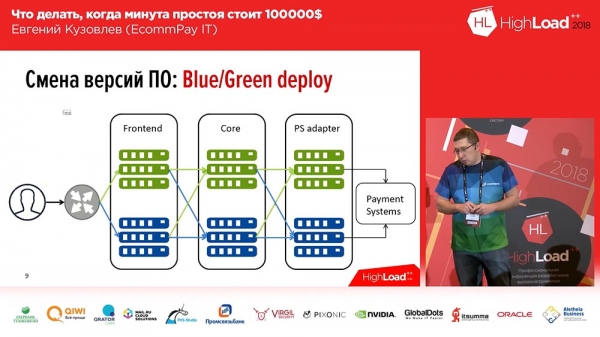
Ona je prilično poznata, nikada je nismo izumili – to je Blue/Green deploy. Što to znači? Za svaku grupu servera na kojima se nalaze vaši aplikacije, trebate imati kopiju. Ta kopija je "topla": na njoj nema prometa, ali u bilo kojem trenutku taj promet možete preusmjeriti na tu kopiju. Ova kopija sadrži prethodnu verziju. Tijekom deploy-a, izlažete kod na neaktivnu kopiju. Nakon toga preusmjeravate dio prometa (ili sav) na novu verziju. Dakle, da biste promijenili tok prometa sa stare verzije na novu, trebate učiniti samo jednu stvar: trebate promijeniti balansator u upstream-u, promijeniti smjer – s jednog upstream-a na drugi. To je vrlo praktično i rješava problem brzog prebacivanja i brzog vraćanja.Ovdje je rješenje drugog pitanja - minimizacija: možete usmjeriti novi promet, na liniju s novim kodom samo za dio vašeg prometa (recimo, 2%). A tih 2% – to nije 100%! Ako ste izgubili 100% prometa tijekom neuspješnog deploy-a – to je strašno, dok gubitak 2% prometa – to je neugodno, ali ne i strašno. Štoviše, korisnici vjerojatno čak neće niti primijetiti, jer u nekim slučajevima (ne u svim) jedan te isti korisnik, pritiskom na F5, će završiti na drugoj, funkcionalnoj verziji.
Blue/Green deploy. Ruting
Međutim, nije sve tako jednostavno sa "Blue/Green deploy-om"… Sve naše komponente mogu se podijeliti u tri grupe:
- to su frontend (stranice za plaćanje koje vide naši klijenti);
- jezgra procesiranja;
- adapter za rad s platnim sustavima (banke, "MasterCard", "Visa"…).
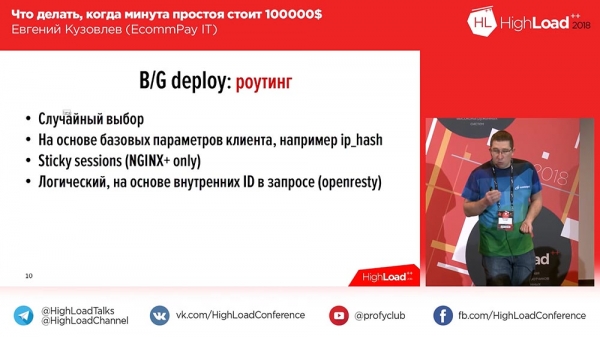
I ovdje postoji nijansa – nijansa se odnosi na usmjeravanje između linija. Ako samo prebacujete 100% prometa, nemate tih problema. No, ako želite prebaciti 2%, javljaju se pitanja: "Kako to učiniti?" Najjednostavnije je, očigledno: možete postaviti slučajni odabir, Round Robin u Nginx-u, i imate 2% - lijevo, 98% - desno. No, to ne odgovara uvijek.
Kod nas, na primjer, korisnik ne komunicira sa sustavom s jednim zahtjevom. To je normalno: 2, 3, 4, 5 zahtjeva – vaši sustavi mogu biti slični. I ako vam je važno da svi zahtjevi korisnika dođu na istu liniju na koju je stigao prvi zahtjev, ili (druga stvar) da svi zahtjevi korisnika dođu na novu liniju nakon prebacivanja (možda je počeo raditi ranije s sustavom, prije prebacivanja) – tada vam to slučajno raspoređivanje ne odgovara. Tada postoje sljedeće opcije:
Prva opcija, najjednostavnija – na temelju osnovnih parametara korisnika (IP Hash). Imate IP, i po IP adresi dijelite lijevo-desno. Tada će se ostvariti drugi opisani slučaj kada je došlo do implementacije, korisnik je već mogao početi raditi s vašim sustavom, i od trenutka implementacije svi zahtjevi otići će na novu liniju (na istu, recimo).Ako to iz nekog razloga ne odgovara i morate nužno slati zahtjeve na onu liniju na koju je stigao prvotni, inicijalni zahtjev korisnika, tada imate dvije opcije…
Prva opcija: možete uzeti plaćeni Nginx+. Tamo postoji mehanizam Sticky sessions, koji prilikom inicijalnog zahtjeva korisnika dodjeljuje sesiju i povezuje je s određenim upstream-om. Svi sljedeći zahtjevi korisnika unutar trajanja sesije bit će poslani na isti upstream na koji je sesija postavljena.To nam nije odgovaralo, jer smo već imali obični Nginx. Prelazak na Nginx+ nije bio preskup, ali bilo je to za nas pomalo bolno i ne baš ispravno. "Sticky sessions" za nas, na primjer, nisu radile iz jednostavnog razloga što „Sticky sessions“ ne omogućuju usmjeravanje po načelu „ili-ili“. Tamo možete postaviti da radimo „Sticky sessions“, na primjer, po IP adresi ili po IP adresi i kolačićima ili po post parametrima, a to „ili-ili“ – to je već složenije.
Zato smo došli do četvrte opcije. Uzeli smo nginx na „steroidima“ (to je openresty) – to je isti nginx koji dodatno podržava uključivanje last skripti. Možete napisati last skriptu, dodati je ovom „openaresu“, i ta last skripta će se izvršiti kada dođe zahtjev korisnika.
I napisali smo, zapravo, takvu skriptu, postavili sebi „openares“ i u toj skripti prolazimo kroz 6 različitih parametara po spajanju „Ili“. Ovisno o prisutnosti određenog parametra, znamo da je korisnik došao na jednu stranicu ili na drugu, na jednu liniju ili na drugu.
Blue/Green deploy. Prednosti i nedostaci
Naravno, moglo se to možda malo jednostavnije napraviti (koristiti iste „Sticky sessions“), ali imamo još jednu nijansu da s nama ne samo korisnik interagira unutar jedne obrade jedne transakcije… S nama interagiraju i platni sustavi: mi, nakon što obradimo transakciju (poslavši zahtjev u platni sustav), primamo callback.
I recimo, ako unutar našeg okvira možemo proslijediti IP adresu korisnika u svim zahtjevima i na osnovi IP adrese korisnika dijeliti, ne možemo reći istoj „Visi”: „Dečki, mi smo takva retro kompanija, mi kao da smo međunarodni (na stranici i u Rusiji)… A proslijedite nam, molim vas, IP adresu korisnika dodatno u dodatno polje, vaš standardizirani protokol”! Jasno je da se neće složiti.
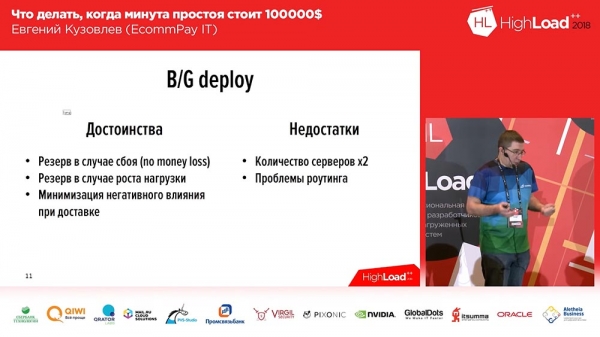
Dakle, to nije bilo prihvatljivo za nas – napravili smo openresty. Shodno tome, s routingom smo to postavili ovako:Blue/Green deploy ima, shodno tome, prednosti o kojima sam govorio, i nedostatke.
Dva su nedostatka:
- morate se mučiti s routingom;
- drugi osnovni nedostatak – to su troškovi.
Trebate dvostruko više servera, trebate dvostruko više operativnih resursa, trebate trošiti dvostruko više truda na održavanje cijelog ovog zoo parka.
Usput, među prednostima postoji još jedna stvar o kojoj do sada nisam spomenuo: imate rezervu u slučaju porasta opterećenja. Ako vam se dogodi nagli porast opterećenja, odnosno ako vas preplavi veliki broj korisnika, jednostavno uključite drugu liniju raspodjele 50 na 50 – i odmah imate dvostruko više servera u vašem klasteru dok ne riješite problem s brojem servera.
Kako brzo izvršiti implementaciju?
Razgovarali smo o tome kako riješiti problem minimalizacije i brzog povratka, ali pitanje ostaje: "Kako se brzo implementirati"?
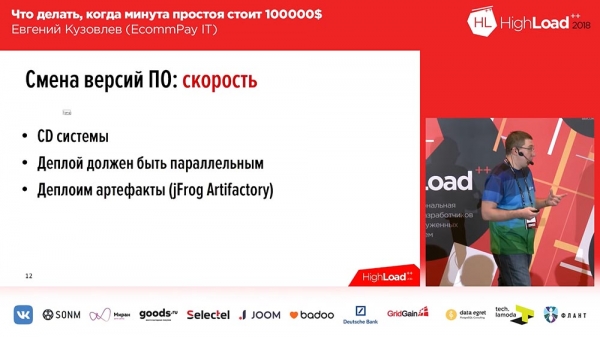
Evo sažeto i jednostavno.- Trebate imati CD sustav (Continuous Delivery) – bez njega ne možete. Ako imate jedan server, možete rukom izvršiti implementaciju. Mi imamo oko tisuću i pol servera, a rukom tisuću i pol, jasno je – mogli bismo zaposliti cijeli tim veličine ove dvorane samo za implementaciju.
- Implementacija mora biti paralelna. Ako je vaša implementacija sekvencijalna, sve je loše. Jedan server – u redu, tisuću i pol servera implementirat ćete cijeli dan.
- Opet, za ubrzanje, to možda više nije obavezno. Tijekom implementacije obično se izvodi izgradnja projekta. Imate web projekt, postoji front-end dio (tamo radite web-pakete, okupljate npm – nešto slično), i ovaj proces zapravo nije dug – traje pet minuta, ali tih pet minuta može biti kritičnih. Zato, na primjer, mi tako ne radimo: te pet minuta smo eliminirali, implementiramo artefakte.
Što je artefakt? Artefakt je izgrađena verzija u kojoj je već izvršen cijeli proces izgradnje. Taj artefakt pohranjujemo u skladištu artefakata. U svom smo vremenu koristili dva takva skladišta – to su bili Nexus i sada jFrog Artifactory. "Nexus" smo isprva koristili jer smo počeli primjenjivati ovaj pristup u java aplikacijama (dobro je odgovarao). Kasnije smo tu stavili dio aplikacija napisanih u PHP-u; i "Nexus" više nije odgovarao, pa smo izabrali jFrog Artifactory koji može upravljati gotovo svime. Došli smo čak do toga da u tom skladištu artefakata čuvamo vlastite binarne pakete koje gradimo za servere.
Nagli porast opterećenja
Razgovarali smo o promjeni verzije softvera. Sljedeće što imamo jest nagli porast opterećenja. Ovdje vjerojatno pod naglim porastom opterećenja mislim na nešto što nije potpuno ispravno...
Napisali smo novi sustav – on je orijentiran na usluge, moderan i lijep, svuda su radnici, svuda redovi, svuda asinkronost. U takvim sustavima podaci mogu prolaziti kroz različite tokove. Za prvu transakciju mogu biti uključeni 1., 3., 10. radnik, za drugu transakciju – 2., 4., 5. I danas, recimo, ujutro imate tok podataka koji uključuje prva tri radnika, a navečer se iznenada mijenja i sve uključuje druga tri radnika.
I tu dolazimo do situacije da morate nekako skalirati radnike, morate nekako skalirati svoje usluge, ali pritom ne smijete dopustiti povećanje resursa.
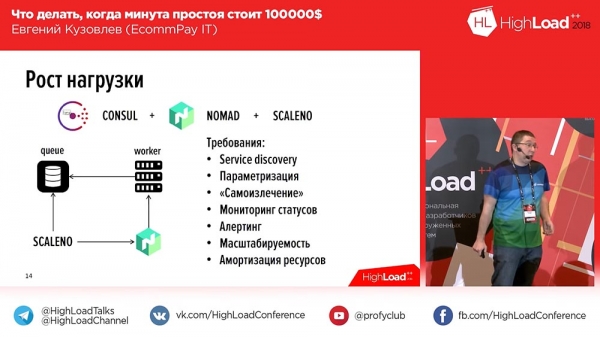
Odredili smo zahtjeve. Ti zahtjevi su prilično jednostavni: da se provede otkrivanje usluga, parametarizacija – sve standardno za izgradnju takvih skalabilnih sustava, osim jedne stavke – to je amortizacija resursa. Rekli smo da nismo spremni amortizirati resurse da serveri griju zrak. Uzimamo 'Consul', uzimamo 'Nomad', koji upravlja našim radnicima.Zašto je to problem za nas? Idemo malo unatrag. Trenutno imamo oko 70 platnih sustava. Ujutro promet ide kroz 'Sberbank', zatim 'Sberbank' pada, na primjer, i prebacujemo ga na drugi platni sustav. Imali smo 100 radnika do 'Sberbanka', a nakon toga moramo naglo podići 100 radnika za drugi platni sustav. I sve to poželjno bi bilo da se dogodi bez ljudskog sudjelovanja. Jer ako je ljudsko sudjelovanje – ondje mora sjediti inženjer 24/7 koji se time bavi, jer takvi kvarovi, kada 70 sustava prati vas, događaju se redovito.
Zato smo pogledali 'Nomad', koji ima otvorenu IP adresu, i napisali našu stvar Scale-Nomad – ScaleNo, koja približno radi sljedeće: prati rast reda i smanjuje ili povećava broj radnika ovisno o dinamici promjene reda. Kada smo to napravili, pomislili smo: 'Možda da to postavimo kao open source?' Onda smo ga pogledali – jednostavan je kao dvije lipe.
Do sada nismo postavili kao open source, ali ako nakon prezentacije, nakon shvaćanja da vam je takva stvar potrebna, osjetite potrebu za njom, na posljednjem slajdu su moji kontakti – molim vas, javite mi. Ako se skupi barem 3-5 ljudi – postavit ćemo je kao open source.
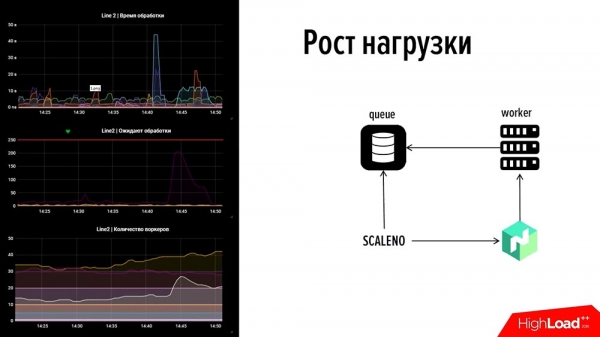
Kako to funkcionira? Pogledajmo! U naprijed: s lijeve strane je dio našeg monitoringa: to je jedna linija, na vrhu – vrijeme obrade događaja, u sredini – broj transakcija, na dnu – broj radnika.Ako pogledamo, na ovoj slici postoji greška. Na gornjem grafu jedan od grafova je iskočio nakon 45 sekundi – jedan od platnih sustava je pao. Odmah je prikazan promet za 2 minute i počeo je rast reda na drugom platnom sustavu, gdje nije bilo radnika (nismo trošili resurse – naprotiv, iskoristili smo resurs korektno). Nismo htjeli preopteretiti – bilo je minimalno radnika, oko 5-10, ali nisu se nosili.
Na posljednjem grafu vidi se 'brdo', koje upravo govori da je 'Scale' povećao tu količinu dvostruko. A zatim, kada je graf malo opao, malo se smanjio – broj radnika je automatski promijenjen. Tako ovaj sustav funkcionira. Razgovarali smo o točki br. 2 – „Kako brzo ukloniti uzroke”.
Monitoring. Kako brzo otkriti problem?
Sada prva točka – „Kako brzo otkriti problem?” Monitoring! Moramo brzo razumjeti određene stvari. Koje stvari moramo brzo razumjeti?
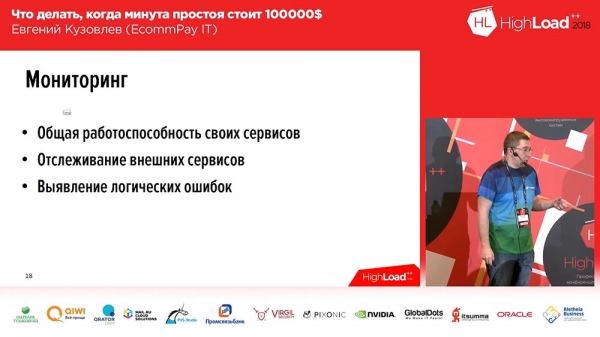
Tri stvari!- Moramo brzo razumjeti i brzo pratiti funkcionalnost naših vlastitih resursa.
- Moramo brzo prepoznati ispade, pratiti funkcionalnost sustava koji su za nas vanjski.
- Treća točka – otkrivanje logičkih grešaka. To je kada sustav radi za vas, prema svim pokazateljima sve je u redu, ali se događa nešto neobično.
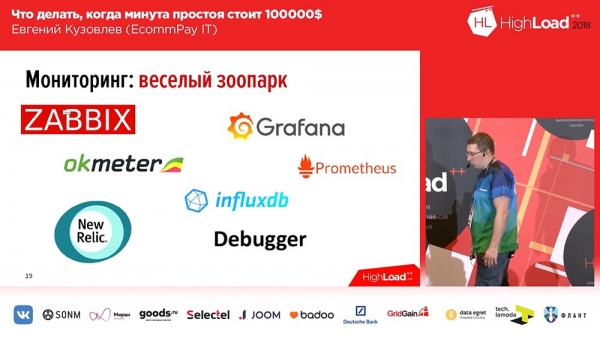
Ovdje vjerojatno neću reći ništa posebno. Bit ću kapetan Očiglednih stvari. Istraživali smo što je dostupno na tržištu. Imamo 'veseli zoološki vrt'. Ovaj zoološki vrt smo sada stvorili:
Imamo 'Zabbix' koji se koristi za monitoring 'hardvera', za monitoring osnovnih pokazatelja poslužitelja. 'Okmeter' koristimo za baze podataka. 'Grafana' i 'Prometheus' koristimo za sve druge pokazatelje koji nisu odgovarali prva dva, pri čemu dio – s 'Grafanom' i 'Prometheusom', dio – 'Grafana' s 'Influxom' i Telegrafom.Prije godine smo željeli koristiti New Relic. Odlična stvar, ima sve funkcije. Međutim, koliko god je funkcionalna, toliko je i skupa. Kada smo se povećali na 1,5 tisuća poslužitelja, došao nam je dobavljač i rekao: „Hajde da potpišemo ugovor za sljedeću godinu.“ Pogledali smo cijenu i rekli da to nećemo raditi. Sada se odričemo „New Relic-a“, pod nadzorom nam je ostalo oko 15 poslužitelja.
Imamo jedan alat koji smo razvili sami – to je Debugger. Prvo smo ga nazvali „Bagger“, ali nakon što je prošao naš učitelj engleskog, smijao se do suza, pa smo ga preimenovali u „Debugger“. Što je to? To je alat koji u biti u 15-30 sekundi na svakom komponentu, poput „crne kutije“ sustava, pokreće testove za opću funkcionalnost komponente.
Na primjer, ako vanjska stranica (stranica za plaćanje) – jednostavno je otvara i gleda kako bi trebala izgledati. Ako je u pitanju procesiranje, šalje testnu „transakciju“ – gleda da li je ta „transakcija“ prošla. Ako je riječ o vezi s platnim sustavima – tada šaljemo testni zahtjev gdje možemo i provjeravamo da li je sve u redu.
Koji su pokazatelji važni za praćenje?
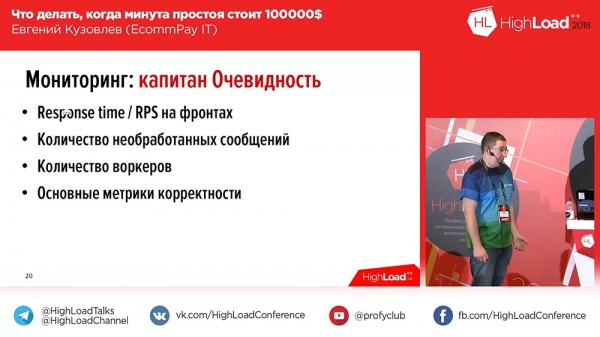
Što uglavnom pratimo? Koji su pokazatelji za nas važni?
- Vrijeme odziva / RPS na frontovima – vrlo važan pokazatelj. Odmah pokazuje ako nešto nije u redu.
- Broj obrađenih poruka u svim redovima.
- Broj radnika.
- Osnovne metrike točnosti.
Zadnja stavka – „poslovna“, „poslovna“ metrika. Ako želite pratiti isto, trebate odrediti jednu ili dvije metrike koje su vam glavni pokazatelji. Naša takva metrika je prolaznost (omjer uspješnih transakcija i ukupnog toka transakcija). Ako se u njoj nešto mijenja na intervalu od 5-10-15 minuta – to znači da imamo problema (ako se drastično mijenja).
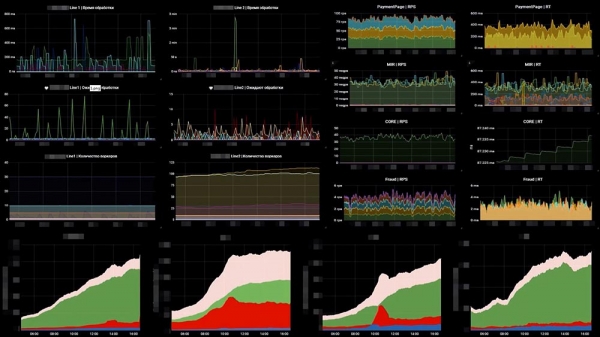
Kako to izgleda kod nas – primjer jednog od naših panela:
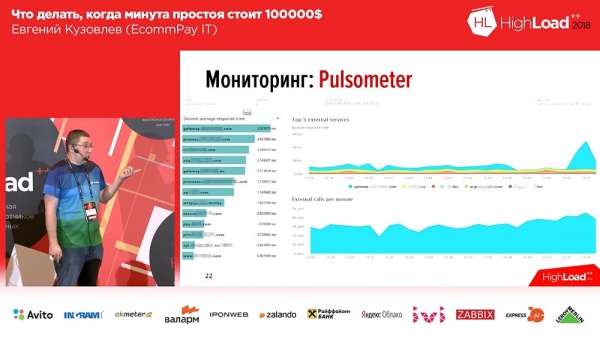
S lijeve strane – 6 grafova, što odgovara linijama – broj radnika i broj poruka u redu. S desne strane – RPS, RTS. Ispod – onaj važni poslovni metrika. Na toj poslovnoj metrikama odmah vidimo da nešto nije u redu na dva srednja grafika… To je upravo trenutak kada je pao još jedan sustav koji nas podržava.Druga stvar koju smo morali učiniti – pratiti pad vanjskih sustava plaćanja. Ovdje smo uzeli OpenTracing – mehanizam, standard, paradigma koja omogućuje praćenje distribuiranih sustava; a malo smo ga modificarali. Standardna OpenTracing paradigma govori da gradimo praćenje svakog pojedinačnog zahtjeva. Nama to nije bilo potrebno, pa smo to obavili u agregiranoj, ukupnoj praćenju. Napravili smo alat koji nam omogućava da pratimo brzinu sustava koji nas podržavaju.
Grafikon nam pokazuje da je jedan od sustava plaćanja počeo odgovarati za 3 sekunde – imali smo problema. Ujedno, ovaj sustav reagira kada problemi započnu, u intervalu od 20-30 sekundi.Treća klasa grešaka u nadzoru su logički nadzor.
Iskreno, nisam znao što da nacrtam na ovom slajdu, jer smo dugo tražili na tržištu nešto što bi nam odgovaralo. Nismo našli ništa, pa smo morali napraviti sami.
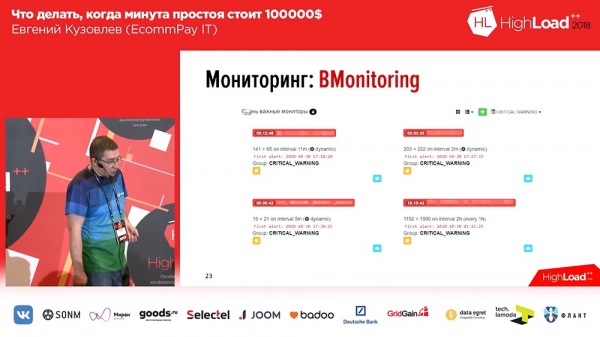
Što podrazumijevam pod logičkim nadzorom? Pa, zamislite: pravite sustav (na primjer, klon „Tindera”); napravite ga, pokrenete. Uspješan menadžer Vasja Pupkin ga instalira na svoj telefon, vidi djevojku, lajka je… a lajk ne odlazi djevojci – lajk odlazi čuvaru Mihaliču iz iste poslovne zgrade. Menadžer se spušta dolje, a zatim se zbunjuje: „Zašto se taj čuvar Mihalič tako veselo smiješi?”U takvim situacijama... Za nas ova situacija zvuči malo drugačije jer (kao što sam rekao) to je reputacijski gubitak koji neizravno dovodi do financijskih gubitaka. Imamo obratnu situaciju: možemo pretrpjeti izravne financijske gubitke – na primjer, ako smo transakciju označili kao uspješnu, a ona je bila neuspješna (ili obratno). Morali smo napisati vlastiti alat koji prati uspješnost transakcija kroz poslovne pokazatelje u dinamičkom vremenskom intervalu. Na tržištu nismo našli ništa! Ovo je bila misao koju sam htio prenijeti. Za rješavanje ovakvih problema na tržištu ništa ne postoji.
To je bilo u vezi s pitanjem kako brzo uočiti problem.
Kako utvrditi uzroke implementacije
Treća grupa zadataka koju rješavamo – to je nakon što smo identificirali problem, nakon što smo ga riješili, dobro bi bilo razumjeti uzrok za razvoj, za testiranje i nešto s tim učiniti. Stoga, potrebno je istražiti, potrebno je pregledati logove.
Ako govorimo o logovima (glavni uzrok – logovi), većina naših logova je u ELK Stacku – praktički svi tako rade. Neki možda ne koriste ELK, ali ako zapisujete logove u gigabajtima, рано ili kasnije ćete doći do ELK-a. Mi ih zapisujemo u terabajtima.
Ovde postoji problem. Popravili smo grešku za korisnika, počeli istraživati što se to dogodilo, zavirili smo u "Kibanu", unijeli ID transakcije i dobili ovakav ispis (pokazuje mnogo). I u tom ispisi ništa nije jasno. Zašto? Zato što nije jasno koji dio se odnosi na kojeg radnika, koji dio se odnosi na koji komponente. I u tom trenutku shvatili smo da nam je potrebna praćenje – ono što se zove OpenTracing, o kojem sam govorio.Razmislili smo o tome prije godinu dana, usmjerili smo svoj pogled prema tržištu i tamo su se našla dva alata – "Zipkin" i "Jaeger". "Jaeger" je zapravo ideološki naslednik, ideološki nastavak "Zipkina". U "Zipkinu" je sve dobro, osim što ne može agregirati, ne može uključivati logove u praćenje, samo praćenje vremena. A "Jaeger" to podržava.
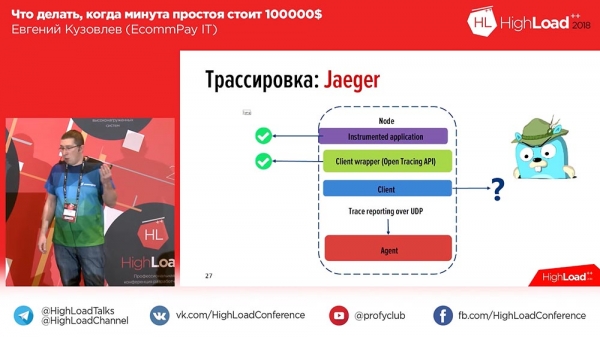
Pogledali smo na „Eger”, možemo instrumentirati aplikacije, možemo pisati u Api (standard Api za PHP u to vrijeme, doduše, nije bio odobren – to je bilo prije godinu dana, a sada je već odobren), apsolutno nije bilo klijenta. „U redu”, pomislili smo, i napisali vlastiti klijent. Kako to izgleda? Otprilike ovako:
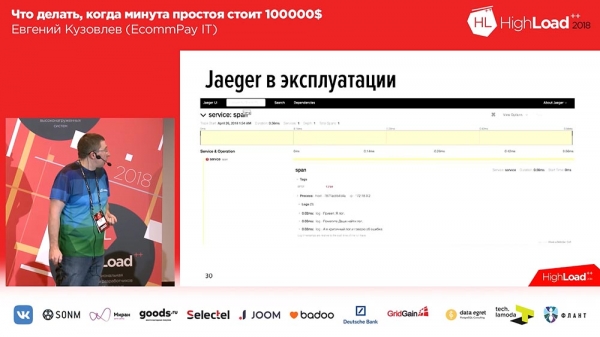
U „Egeru” za svaku poruku se stvaraju span-ovi. Dakle, kada korisnik otvori sustav, vidi jedan ili dva bloka za svaki dolazni zahtjev (1-2-3 – koliko dolaznih zahtjeva od korisnika je bilo, toliko i blokova). Da bi korisnicima bilo lakše, dodali smo oznake logovima i vremenskoj trasi. U skladu s tim, u slučaju greške, naša aplikacija označava log odgovarajućom oznakom Error. Može se filtrirati po oznaci Error i prikazat će se samo spans koji sadrže taj blok s greškom. Ovako to izgleda ako razvijemo span:
Unutar spana se nalazi set tragova. U ovom slučaju to su tri testna traga, a treći trag nam govori da je došlo do greške. U isto vrijeme ovdje vidimo vremensku traku: na vrhu imamo vremensku liniju, i vidimo u kojem je vremenskom intervalu zabilježen taj ili onaj log.U skladu s tim, uspjeli smo odlično. Napisali smo vlastiti dodatak i otvorili smo ga kao open source. Ako želite raditi s trasažom, ako želite raditi s „Egerom” na jeziku PHP – postoji naš dodatak, dobrodošli da koristite, kako se kaže:
Naš dodatak je klijent za rad s OpenTracing Api, napravljen kao php-extension, to jest, morate ga sastaviti i naložiti u sustav. Prije godinu dana nije bilo ničega drugog. Sada su se pojavili još drugi klijenti, koji su kao komponenti. Ovdje je na vama: ili preuzimate komponente putem composera, ili koristite dodatak, na vama je.Korporativni standardi
Razgovarali smo o tri zapovijedi. Četvrta zapovjed – standardizirati pristupe. O čemu se ovdje radi? To je otprilike o tome:
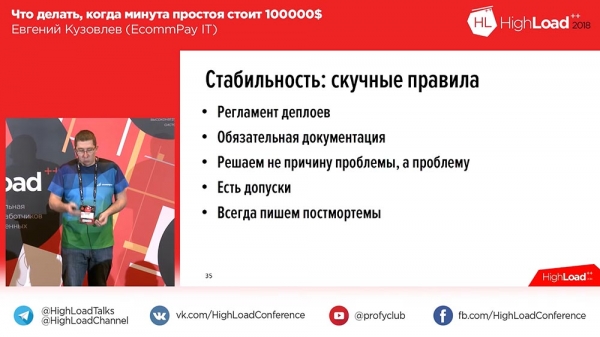
Zašto ovdje riječ „korporativni”? Ne zato što smo velika ili birokratska kompanija, ne! Riječ „korporativna” ovdje sam htio upotrijebiti u kontekstu da svaka kompanija, svaki proizvod trebaju imati svoje standarde, a tako i vi. Koji su standardi kod nas?- Imamo regulaciju za deployeve. Bez nje ne možemo napredovati. Deployujemo otprilike 60 puta nedeljno, što znači da naši deployi događaju praktično neprekidno. Međutim, imamo, na primer, zabranu na deploye u petak – suštinski, ne radimo deploye tada.
- Dokumentacija je obavezna. Nijedan novi komponent ne ide u produkciju ako nema dokumentaciju, čak i ako je to nastalo pod rukama naših RnD timova. Od njih zahtevamo uputstvo za deploy, mapu za monitoring i opis (pa, kako programeri to mogu napisati) kako taj komponent funkcioniše, kako ga rešiti u slučaju problema.
- Ne rešavamo uzrok problema, već problem – o čemu sam već govorio. Važno nam je zaštititi korisnika od problema.
- Imamo dopuštenja. Na primer, ne smatramo da je dobijanje 2% prometa tokom dve minute downtime. To u principu ne ulazi u našu statistiku. Ako je veće u procentualnom ili vremenskom smislu, već računamo.
- I uvek pišemo postmorteme. Šta god da se desi, svaka situacija koja se nije ponašala standardno u produkciji, biće zabeležena u postmortemu. Postmortem je dokument u kojem pišete što se dogodilo, detaljan vremenski raspored, što ste uradili da to ispravite i (to je obavezan deo!) što ćete učiniti da to ne dozvolite u budućnosti. To je obavezno, neophodno za buduću analizu.
Šta se smatra downtimeom?
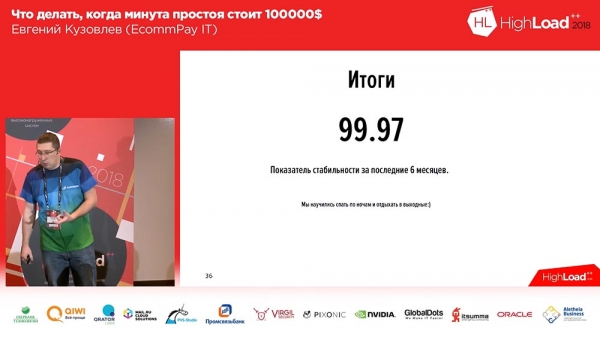
Šta je sve ovo izazvalo?To je dovelo do toga da (imali smo određenih problema sa stabilnošću, što nije zadovoljilo ni klijente ni nas) u poslednjih 6 meseci naš pokazatelj stabilnosti iznosi 99,97. Može se reći da to nije mnogo. Da, imamo čemu težiti. Otprilike polovina tog pokazatelja dolazi od stabilnosti koja nije naša, već našeg web aplikacijskog vatrozida koji je ispred nas i koristi se kao servis, ali klijentima je to svejedno.
Naučili smo da spavamo noću. Napokon! Pre šest meseci nismo znali. I na ovoj tački sa rezultatima želim da napomenem jednu stvar. Juče uveče je održano divno predavanje o sistemu upravljanja nuklearnim reaktorom. Ako me čuju ljudi koji su pisali taj sistem – molim vas, zaboravite na ono što sam rekao o „2% – to nije downtime“. Za vas 2% je downtime, čak i ako je na dve minute!
Na to sve! Vaša pitanja.
O balansirnicima i migraciji iz baze podataka
Pitanje iz publike (dalje – P): – Dobro veče. Hvala vam puno na ovom administratorskom izlaganju! Pitanje je kratko, na temu vaših balansirnika. Spomenuli ste da imate WAF, što znači da koristite neki vanjski…
EK: – Ne, u ulozi balansirnika koristimo svoje vlastite servise. U ovom slučaju WAF nam je isključivo alat zaštite od DDoS-a.
P: – Možete li reći nekoliko reči o balansirnicima?
EK: – Kao što sam već rekao, to je grupa servera u openresty. Trenutno imamo 5 rezervisanih grupa koje isključivo odgovaraju… dakle, server na kojem je isključivo openresty, samo proksira saobraćaj. Što se tiče razumevanja, koliko održavamo: trenutno je naš uobičajeni protok saobraćaja nekoliko stotina megabita. Oni se dobro snalaze, čak se i ne naprežu.
P: – Takođe jednostavno pitanje. Postoji Blue/Green deployment. A šta radite, na primer, sa migracijama iz baze podataka?
EK: – Dobro pitanje! Gledajte, u Blue/Green deployment-u imamo odvojene redove za svaku liniju. Dakle, kada govorimo o redovima događaja koji se prenose od radnika do radnika, postoje odvojeni redovi za plavu liniju i za zelenu liniju. Kada govorimo o samoj bazi podataka, svesno smo je suzili koliko god smo mogli, premestili smo gotovo sve u redove, u bazi podataka samo čuvamo stak transakcija. I stak transakcija je jedinstven za sve linije. O bazi podataka u ovom kontekstu: ne delimo je na plavu i zelenu, jer oba verzije koda moraju znati šta se događa s transakcijom.
Prijatelji, imam još jedan mali poklon da vas podstaknem – knjigu. I moram je uručiti za najbolje pitanje.
P: – Zdravo. Hvala na izlaganju. Pitanje je ovakvo. Pratite plaćanja, pratite servise s kojima komunicirate… Kako pratite to da je osoba na neki način došla na vašu stranicu za plaćanje, izvršila uplatu, a projekat joj je uzeo novac? Dakle, kako pratite da je merchant dostupan i prihvatio vaš callback?
EK: – Merchant za nas u ovom slučaju je vanjski servis, kao i platna sistema. Pratimo brzinu odgovora 'merchanta'.
O šifriranju baze podataka
P: – Pozdrav. Imam jedno pitanje u vezi. Imate osjetljive podatke prema PCI DSS-u. Htio bih znati kako čuvate PAN-ove u redovima kroz koje ih morate proslijediti? Koristite li neko šifriranje? I odavde proizlazi drugo pitanje: prema PCI DSS-u, potrebno je povremeno ponovno šifrirati bazu u slučaju promjena (kada se administratori povuku i slično) – kako tada izgleda dostupnost?
EK: – Odličan pitanje! Prvo, mi ne čuvamo PAN-ove u redovima. Nemamo pravo čuvati PAN na otvorenom bilo gdje, stoga koristimo posebnu uslugu (nazivamo je „Keydemon”) – to je usluga koja radi samo jednu stvar: prima poruku i vraća je šifriranu. I s tom šifriranom porukom sve pohranjujemo. Tako da imamo dužinu ključa ispod kilobajta, kako bi to bilo stvarno ozbiljno i sigurno.P: – Treba li sada već 2 kilobajta?
EK: – Čini se da je jučer bilo 256… Pa куда još?!
Dakle, to je prvo. A drugo, rješenje koje imamo podržava postupak ponovne šifriranja – postoje dva para „keka” (ključeva) koji daju „dek” (dekriptorne ključeve) koji šifriraju (key – to su ključevi, dek – to su izvedeni ključevi koji šifriraju). U slučaju iniciranja postupka (koji se redovito provodi, od 3 mjeseca do ± nečega) učitavamo novi par „keka” i vrši se ponovna šifriranja podataka. Imamo posebne usluge koje izvlače sve podatke, ponovno ih šifriraju; hranimo podatke uz identifikator ključa koji je korišten za šifriranje. Kada su podaci šifrirani novim ključevima, stari ključevi se brišu.
Ponekad je potrebno ručno provoditi uplatu...
P: – Znači, ako dođe povrat sredstava za neku transakciju, tada dešifrirate starim ključem?
EK: – Da.
P: – Onda još jedno malo pitanje. Kada dođe do nekakvog kvara, pada ili incidenta, potrebno je ručno proći kroz transakciju. Biva takva situacija.
EK: – Da, dogodi se.
P: – Odakle uzimate te podatke? Ili sami idete ručno u to skladište?
EK: – Ne, naravno – imamo neki back-office sustav koji sadrži sučelje za našu podršku. Ako ne znamo u kojem je statusu transakcija (na primjer, dok platni sustav ne odgovori zbog isteka vremena) – unaprijed ne znamo, dakle konačnu ocjenu dodjeljujemo samo kada smo potpuno sigurni. U tom slučaju, transakciju stavljamo u poseban status za ručno obraćenje. Ujutro, sljedećeg dana, čim podrška dobije informaciju o tome koje su transakcije ostale u platnom sustavu, oni ih ručno obrađuju u tom sučelju.
P: – Imam par pitanja. Jedno od njih se tiče produžetka PCI DSS zone: kako iznosite logove iz njihovog okvira? Postavljam ovo pitanje jer je programer mogao staviti što god u logove! Drugo pitanje: kako isporučujete hitne ispravke? Ručno u bazi – to je jedna opcija, ali mogu postojati slobodne hitne ispravke – koja je procedura? I treće pitanje, vjerojatno, odnosi se na RTO, RPO. Imali ste dostupnost od 99,97, gotovo četiri devetke, ali razumijem da imate i drugi podatkovni centar, i treći podatkovni centar, i peti podatkovni centar… Kako se bavite njihovom sinhronizacijom, replikacijom i svime ostalim?EK: – Počnimo s prvim. Prvo pitanje o logovima, zar ne? Kada se logovi pišu, tu je sloj koji maskira sve osjetljive podatke. Gleda prema maski i dodatnim poljima. U skladu s tim, naši logovi izlaze s već zamaskiranim podacima i okvirom PCI DSS. To je jedan od redovitih zadataka koji je dodijeljen odjelu testiranja. Oni su obvezni provjeravati svaki zadatak uključujući logove koje pišu, i to je jedan od redovitih zadataka tijekom pregledavanja koda, kako bi se kontroliralo da programer nije zapisao nešto što ne bi trebao. Naknadna provjera toga se redovito provodi odjelom za informatičku sigurnost otprilike jednom tjedno: nasumično se uzimaju logovi za posljednji dan i prolaze kroz specijalni skener-analizator s testnih poslužitelja kako bi se sve provjerilo.
O hot-fixovima. To je uključeno u našu politiku implementacije. Imamo odvojenu tačku o hotfixovima. Smatramo da hotfixove implementiramo 24/7 kada god nam to zatreba. Čim je verzija sastavljena, čim je testirana, čim imamo artefakt – dežurni sistemski administrator se javi na poziv iz podrške i implementira to onog trenutka kada je potrebno.O "četiri devetke". Ta brojka koju trenutno imamo zaista je postignuta i ka njoj smo težili još na jednom datacentru. Sada imamo drugi datacentar, i počinjemo da rutiramo između njih, a pitanje replikacije između datacentara zaista je složeno. Pokušavali smo to rešiti raznim sredstvima: pokušali smo koristiti isti „Taranto” – nije nam uspjelo, odmah da kažem. Stoga smo došli do toga da ručno naručujemo „sensus”. Svaka aplikacija zapravo u asinhronom režimu neophodne sinhronizacije „promena – urađeno” se šalje između datacentara.
P: – Ako ste dobili drugi, zašto ne i treći? Zato što Split-brain još niko…
EK: – A mi nemamo „Split-brain”. Pošto svaka aplikacija koristi multimaster, nije nam bitno u koji centar je stigao zahtev. Spremni smo na to da, u slučaju da jedan datacentar padne (u to se ugrađujemo) i da prebacimo korisnika na drugi datacentar tokom njegovog zahteva, spremni smo da izgubimo tog korisnika, zaista; ali to će biti jedinstveni slučajevi, apsolutni jedini.
P: – Dobro veče. Hvala na izlaganju. Govorili ste o svom debageru koji u proizvodnji pokreće određene testne transakcije. A recite nam nešto o testnim transakcijama! Koliko duboko to ide?
EK: – To prolazi kroz puni ciklus celog komponenata. Za komponentu nema razlike između testne i produkcijske transakcije. A sa stanovišta logike to je samo neki odvojeni projekat u sistemu, na kojem se obavljaju samo testne transakcije.
P: – A gde vi to isključujete? Core je poslao…
EK: – Mi prati „Core” u ovom slučaju za testne transakcije… Imamo pojam rutiranja: „Core” zna u koju plaćensku sistemu treba poslati – šaljemo u lažnu plaćensku sistemu koja samo daje http-odbijanje i to je to.
P: – Molim vas, je li vaša aplikacija napisana kao jedan veliki monolit ili ste je podijelili na servise ili čak mikroservise?
EK: – Nemamo monolit, naravno, imamo aplikaciju usmjerenu na servise. Imamo šalu da imamo servis od monolita – oni su zaista prilično veliki. Ne mogu to nazvati mikroservisima, ali to su zapravo servisi unutar kojih rade radnici distribuiranih mašina.
Ako je servis na serveru kompromitiran...
P: – Tada imam sljedeće pitanje. Čak i da je to bio monolit, rekli ste da imate mnogo tih instant-servera, svi oni u suštini obrađuju podatke, i pitanje je: "U slučaju kompromitacije jednog od instant-servera ili aplikacije, nekog pojedinog elementa, imaju li oni neki kontrolni pristup? Tko od njih što može raditi? Tko se može obratiti za koje podatke?
EK: – Da, nesumnjivo. Zahtjevi za sigurnost su dovoljno ozbiljni. Prvo, imamo otvoreni promet podataka, a portovi su samo oni za koje unaprijed pretpostavljamo promet. Ako komponenta komunicira s bazom podataka (recimo, s 'MySQL-om') preko 5-4-3-2, bit će joj otvoreni samo 5-4-3-2, a drugi portovi, drugačiji pravci prometa neće biti dostupni. Osim toga, treba razumjeti da u našoj produkciji postoji oko 10 različitih sigurnosnih kontura. I čak ako je aplikacija nekako kompromitirana, ne daj Bože, napadač neće moći dobiti pristup konzoli za upravljanje serverom, jer je to druga sigurnosna mrežna zona.P: – U ovom kontekstu me više zanima aspekt da imate određene ugovore sa servisima – što oni mogu raditi, kroz koje 'akcije' mogu međusobno komunicirati... U normalnom toku određeni servisi traže određeni niz 'akcija' kod drugih. Na druge obično ne obraćaju pažnju u normalnim okolnostima, a imaju i druge odgovornosti. Ako bi jedan od njih bio kompromitiran, može li on povući 'akcije' tog servisa?
EK: – Razumijem. Ako je u normalnoj situaciji s drugim serverom komunikacija uopće bila dopuštena, onda – da. Prema SLA ugovoru, ne pratimo da ti je dopušteno samo prva 3 „akcije“, dok četvrta „akcija“ nije dopuštena. To je vjerojatno za nas suvišno, jer već imamo 4-nivojski sustav zaštite u načelu za konture. Preferiramo se zaštititi konturama, a ne na razini unutrašnjosti.
Kako funkcioniraju Visa, MasterCard i „Sberbank“
P: – Želim razjasniti pitanje o prijelazu korisnika iz jednog data centra u drugi. Koliko znam, „Visa“ i „MasterCard“ djeluju po binarnom sinkronom protokolu 8583, tu su postavljeni miksevi. I htio sam saznati, odnosi li se prijelaz – točno na „Visu“ i „MasterCard“ ili na platne sustave, na procesorske centre?
EK: – To se odnosi na mikseve. Miksevi su postavljeni u jednom data centru.
P: – Pojednostavljeno, imate li jednu točku spojnice?
EK: – Na „Visi“ i „MasterCardu“ – da. Jednostavno zato što „Visa“ i „MasterCard“ zahtijevaju prilično ozbiljna ulaganja u infrastrukturu za sklapanje zasebnih ugovora za dobivanje druge par mikseva, primjerice. Oni su rezervirani unutar jednog data centra, ali ako se, ne daj Bože, dogodi da propadne data centar gdje su miksevi za spajanje na „Visu“ i „MasterCard“, onda ćemo izgubiti vezu s „Visom“ i „MasterCard“...
P: – Kako mogu biti rezervirani? Znam da „Visa“ u načelu dopušta samo jedno spajanje!
EK: – Oni sami isporučuju opremu. U svakom slučaju, stigla nam je oprema koja je unutar željeza rezervirana.
P: – Znači, ormarić od njihovih Connects Orange?..
EK: – Da.
P: – A kako u tom slučaju: ako vam data centar propadne, kako dalje koristiti? Ili jednostavno prestaje promet?
EK: – Ne. U tom slučaju jednostavno ćemo prebaciti promet na drugi kanal, koji će, naravno, biti skuplji za nas, skuplji za klijente. Ali promet neće ići preko našeg direktnog spajanja na „Visu“, „MasterCard“, nego preko uvjetnog „Sberbanka“ (veoma pojednostavljeno).
Ispričavam se ako sam uvrijedio zaposlenike „Sberbanka“. No prema našim statistikama, među ruskim bankama „Sberbank“ pada najčešće. Nema mjeseca da nešto ne otkaže kod „Sberbanka“.

Malo reklame 🙂
Hvala što ostajete s nama. Sviđa li vam se naše članke? Želite li vidjeti više zanimljivih materijala? Podržite nas narudžbom ili preporučite prijateljima, , jedinstveni analog entry-level servera koji smo razvili za vas: (dostupne opcije s RAID1 i RAID10, do 24 jezgre i do 40GB DDR4).
Dell R730xd je 2 puta jeftiniji u data centaru Equinix Tier IV u Amsterdamu? Samo kod nas u Nizozemskoj! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Pročitajte o tome
Izvor: habr.com
