

Sljedeća konferencija HighLoad++ održat će se 6. i 7. travnja 2020. u Sankt Peterburgu.
Detalji i karte . HighLoad++ Sibira 2019. Dvorana „Krasnoyarsk“. 25. lipnja, 12:00. Sažeci i .
Ponekad praktični zahtjevi sukobljavaju se s teorijom, gdje nisu uzete u obzir važne aspekte za komercijalni proizvod. U ovom izvješću predstavljen je proces odabira i kombiniranja različitih pristupa za izradu komponenti uzrokovne dosljednosti (Causal consistency) na temelju akademskih istraživanja, uzimajući u obzir zahtjeve komercijalnog proizvoda. Slušatelji će saznati o postojećim teorijskim pristupima za logičke satove, praćenje ovisnosti, sigurnost sustava, sinkronizaciju satova, i zašto je MongoDB odabrala određena rješenja.
Mihail Tulenev (dalje - MT): – Pričati ću o uzrokovnoj dosljednosti (Causal consistency) - to je značajka na kojoj smo radili u MongoDB-u. Radim u timu za distribuirane sustave, a to smo razvili prije otprilike dvije godine.
U procesu sam morao upoznati se s velikim brojem akademskih istraživanja, jer je ta značajka dobro proučena. Ispostavilo se da niti jedan članak ne odgovara onome što je potrebno u produkciji, zbog vrlo specifičnih zahtjeva koji postoje, vjerojatno, u bilo kojoj produkcijskoj aplikaciji.
Govorit ću o tome kako mi, kao korisnici akademskih istraživanja, pripremamo nešto što možemo zatim predstaviti našim korisnicima kao gotovu jelo, koje je lako i sigurno koristiti.
Uzrokovna dosljednost (Causal consistency). Odredimo pojmove
Za početak želim ukratko reći što je to uzrokovna dosljednost. Ima dva lika - Leonard i Penny (serija „Teorija velikog praska“):
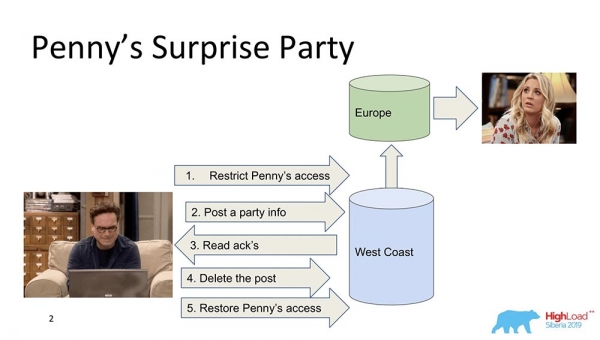
Pretpostavimo da je Penny u Europi, a Leonard želi napraviti neku iznenađenje za nju, zabavu. I ne može smisliti ništa bolje nego da je izbaci iz prijatelja, pošalje svim prijateljima ažuriranje na feed: „Hajde da obradujemo Penny!“ (ona je u Europi, dok spava, ne vidi sve to i ne može vidjeti jer nije tamo). Na kraju briše ovu objavu, uklanja iz „Feed-a“ i obnavlja pristup, kako ona ništa ne primijeti i da ne dođe do skandala.
Sve je to divno, ali pretpostavimo da je sustav distribuiran i da su događaji krenuli malo drugačije. Može se dogoditi, na primjer, da je ograničenje pristupa Pennyju nastalo nakon što je post objavljen, ako događaji nisu međusobno uzrokovani. Ovo je primjer kada je potrebna uzročna konzistentnost kako bi se izvršila poslovna funkcija (u ovom slučaju).
U stvari, to su prilično netrivijalna svojstva baza podataka – vrlo malo njih ih podržava. Pređimo na modele.
Modeli konzistentnosti (Consistency Models)
Što je zapravo model konzistentnosti u bazama podataka? To su određene garantije koje distribuirani sustav daje u vezi s tim koje podatke i u kojem redoslijedu klijent može dobiti.
U suštini, svi modeli konzistentnosti svode se na to koliko je distribuirani sustav sličan sustavu koji radi, na primjer, na jednom nodu na prijenosnom računalu. I koliko je sustav koji radi na tisućama geo-raspoređenih nodova sličan prijenosnom računalu, u kojem su svi ti atributi u osnovi automatski ispunjeni.
Stoga se modeli konzistentnosti primjenjuju samo na distribuirane sustave. Svi sustavi koji su prethodno postojali i radili na jednom vertikalnom skaliranju nisu imali takve probleme. Tamo je postojao jedan Buffer Cache i sve se uvijek čitalo iz njega.
Model Jakost (Strong)
Prvi model – Jakost (ili linija uzlazne sposobnosti, kako je često nazivaju). To je model konzistentnosti koji jamči da svaka promjena, čim dobije potvrdu da se dogodila, postaje vidljiva svim korisnicima sustava.
To stvara globalni redoslijed svih događaja u bazi podataka. To je vrlo snažno svojstvo konzistentnosti i općenito je vrlo skupo. Ipak, vrlo se dobro podržava. Samo je jako skupo i sporo – rijetko se koristi. Ovo se naziva uzlazna sposobnost.
Tu je još jedno, jače svojstvo koje se podržava u ‘Spanneru’ – naziva se Vanjska konzistentnost (External Consistency). O tome ćemo razgovarati malo kasnije.
Uzročna (Causal)
Sljedeće je Causal, upravo ono o čemu sam govorio. Između Strong i Causal postoji još nekoliko podrazina o kojima neću govoriti, ali se sve svode na Causal. To je važan model jer je najjači od svih modela, najjača konzistencija u prisutnosti mreže ili particija.
Causals su situacija u kojoj su događaji povezani uzročnoposljedičnom vezom. Vrlo često ih doživljavaju kao Read your on rights s gledišta klijenta. Ako je klijent promatrao neke vrijednosti, ne može vidjeti vrijednosti koje su bile u prošlosti. Već počinje vidjeti prefiksna očitanja. Sve se svodi na isto.
Causals kao model konzistencije – parcijalno uređen događaja na serveru, pri čemu se događaji sa svih klijenata promatraju u istom redoslijedu. U ovom slučaju – Leonard i Penny.
Eventual
Treći model – Eventual Consistency. To je ono što podržava apsolutno sve distribuirane sustave, minimalni model koji uopće ima smisla. To znači sljedeće: kada se odvijaju neke promjene u podacima, one u nekom trenutku postaju konzistentne.
U tom trenutku ona ništa ne govori, inače bi se pretvorila u External Consistency – bila bi potpuno druga priča. Ipak, to je vrlo popularan model, najrašireniji. Po defaultu svi korisnici distribuiranih sustava koriste upravo Eventual Consistency.
Želim navesti nekoliko usporednih primjera:
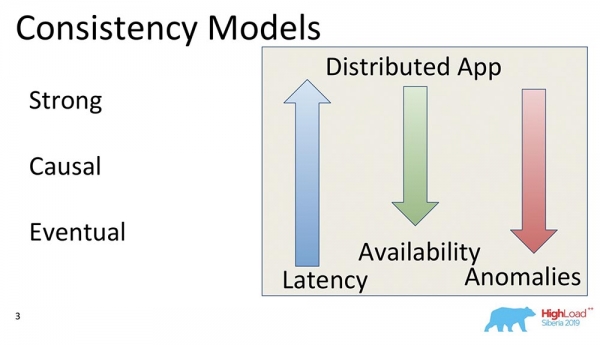
Što ove strelice znače?
- Latency. S povećanjem snage konzistencije, ona postaje veća iz očitih razloga: potrebno je napraviti više zapisa, dobiti potvrdu od svih hostova i nodova koji sudjeluju u klasteru da podaci već postoje. Stoga je u Eventual Consistency najbrži odgovor, jer se obično može čak i u memoriju zapisati i to će biti dovoljno.
- Availability. Ako to shvatimo kao mogućnost sustava da odgovori u prisutnosti prekida mreže, particija ili nekih kvarova – otpornost na kvarove raste smanjenjem modela konzistencije, jer je dovoljno da jedan host opstane i u tom slučaju prikazuje neke podatke. Eventual Consistency uopće ne jamči ništa o podacima – to može biti sve, što god.
- Anomalies. Naravno, s time raste i broj anomlija. U modelima Snažne konzistentnosti skoro da ih ne bi trebalo biti, dok anomlije kod Eventualne konzistentnosti mogu biti bilo kakve. Postavlja se pitanje: zašto ljudi biraju Eventualnu konzistentnost, ako sadrži anomlije? Odgovor leži u tome što se modeli Eventualne konzistentnosti mogu primijeniti, a anomlije postoje, na primjer, u kratkom vremenskom razdoblju; postoji mogućnost korištenja majstora za čitanje i prilično konzistentnog očitavanja podataka; često postoji mogućnost korištenja snažnih modela konzistentnosti. U praksi to funkcionira, a često je broj anomlija vremenski ograničen.
CAP teorema
Kada vidite reči konzistentnost, dostupnost – šta vam pada na pamet? Tačno – CAP teorema! Želim da razbijem mit... Nije to moja zasluga – tu je Martin Kleppmann, koji je napisao sjajan članak, sjajnu knjigu.
CAP teorema je princip formulisan 2000-ih godina koji kaže da je dostupnost, konzistentnost, particije: uzmite bilo koja dva, i ne možete izabrati tri. To je bio određeni princip. Dokazana je kao teorema nekoliko godina kasnije, uradili su to Gilbert i Lynch. Onda je to počelo da se koristi kao mantra – sistemi su se počeli deliti na CA, CP, AP i tako dalje.
Ova teorema je zapravo dokazana za sledeće slučajeve... Prvo, dostupnost se nije razmatrala kao kontinuirana vrednost od nule do stotke (0 – sistem je 'mrtav', 100 – odgovara brzo; tako smo je navikli posmatrati), već kao osobina algoritma, koja garantuje da prilikom svih izvršavanja vraća podatke.
O vremenu odgovora tu nema nijedne reči! Postoji algoritam koji vraća podatke posle 100 godina – potpuno odličan available-algoritam, koji je deo CAP teoreme.
Drugo: teorema je dokazana za promene u vrednostima istog ključa, pri čemu su te promene linija resizable. To znači da se zapravo retko koriste, jer su modeli druge Eventualne konzistentnosti, Snažne konzistentnosti (možda).
Zašto je sve to bitno? Teorema CAP u obliku u kojem je dokazana, praktično nije primenljiva, retko se koristi. U teoretskom obliku ona nekako sve ograničava. Dobija se određeni princip koji je intuitivno tačan, ali na neki način, uopšte nije dokazan.
Kauzalna konzistentnost – najjači model
Trenutno se može postići sve tri stvari: Konzistentnost, Dostupnost uz pomoć Particija. Konkretno, Uzrokovni konzistentnost – najjači model konzistentnosti koji, unatoč prisutnosti Particija (prekida u mreži), i dalje funkcionira. Zato predstavlja toliko veliki interes, zato smo se njome i bavili.
Ona, s jedne strane, olakšava rad programerima aplikacija. Konkretno, prisutnost velike podrške sa strane servera: kada su svi zapisi koji se događaju unutar jednog klijenta zajamčeno dostavljeni u takvoj sekvenci drugom klijentu. S druge strane, izdržava particije.
Unutarnja kuhinja MongoDB
S obzirom na to da je ručak, selimo se u kuhinju. Pričat ću o modelu sustava, a konkretno – što je MongoDB za one koji prvi put čuju za ovu bazu podataka.
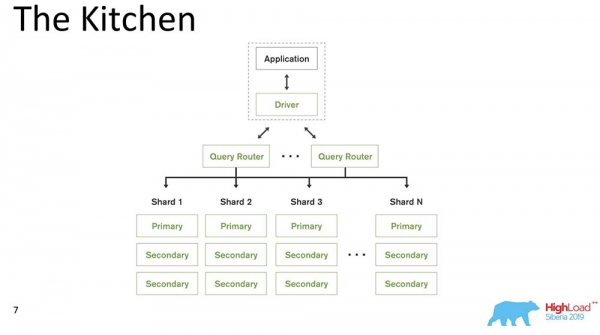
MongoDB (dalje – „MongoDB”) je distribuirani sustav koji podržava horizontalno skaliranje, tj. šarding; i unutar svakog shard-a također podržava redundanciju podataka, tj. replikaciju.
Šarding u „MongoDB” (ne-relacijska Baza Podataka) izvršava automatsku ravnotežu, tj. svaka kolekcija dokumenata (ili „tablica” u terminima relacijskih podataka) se dijeli na komade, a server automatski premješta te dijelove između shard-ova.
Query Router, koji raspoređuje upite, za klijenta predstavlja određenog klijenta kroz kojeg on radi. Već zna gdje i koje podatke se nalaze, usmjerava sve upite ka pravom shard-u.
Još jedna važna točka: MongoDB je single master. Postoji jedan Primary – on može primati zapise koji podržavaju ključevima koje sadrži. Nije moguće napraviti Multi-master write.
Objavili smo verziju 4.2 – dodane su nove zanimljive stvari. Konkretno, integrirali smo Lucene – pretraživanje – točno izvršivog java direktno u „Mongo”, i omogućeno je pretraživanje putem Lucene-a, slično kao u „Elasticsearchu”.
I razvili smo novi proizvod – Charts, koji je također dostupan na „Atlasu” (vlastiti Cloud „Mongo”). Imaju Free Tier – možete se igrati s tim. Charts mi se jako svidio – vizualizacija podataka, vrlo intuitivna.
Sastojci Uzrokovne konzistentnosti
Brojao sam otprilike 230 članaka koji su objavljeni na ovu temu – od Leslie Lamperta. Sada ću vam donijeti neke dijelove ovih materijala iz svoje memorije.
Sve je počelo s člankom Leslie Lamperta, koji je napisan 1970-ih. Kao što vidite, istraživanja na ovu temu i dalje se nastavljaju. Trenutno se Causal consistency suočava s interesom zbog razvoja distribuiranih sustava.
Ograničenja
Koja su ograničenja? To je zapravo jedna od glavnih točaka, jer se ograničenja koja postavlaju produkcijski sustavi znatno razlikuju od ograničenja koja postoje u akademskim člancima. Često su prilično umjetna.
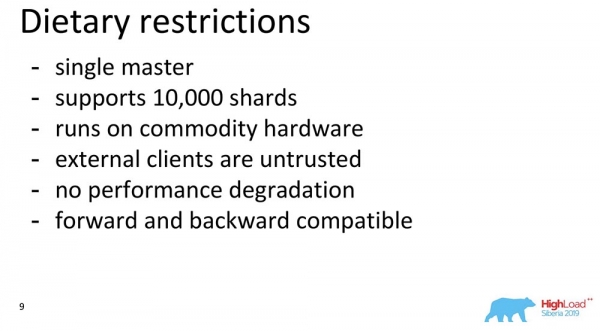
- Prvo, 'MongoDB' je single master, kao što sam već spomenuo (što znatno pojednostavljuje).
- Smatramo da sustav treba podržavati oko 10 tisuća shardova. Ne možemo donijeti arhitektonske odluke koje će otvoreno ograničiti ovu vrijednost.
- Imamo oblak, ali pretpostavljamo da korisnik treba imati mogućnost preuzimanju binarnih datoteka, pokretanju na svom laptopu, i sve bi trebali uspješno raditi.
- Pretpostavljamo ono što se rijetko koristi u istraživanjima: vanjski klijenti mogu raditi što žele. 'MongoDB' je open-source. Stoga, klijenti mogu biti pametni, zli – mogu htjeti srušiti sve. Pretpostavljamo da se mogu dogoditi bizantski failori.
- Za vanjske klijente, koji su izvan perimetra – važno ograničenje: ako je ova funkcija isključena, ne smije doći do performansnih degradacija.
- Još jedna točka – potpuno antiakademska: kompatibilnost prethodnih i budućih verzija. Stari drajveri trebaju podržavati nove ažuriranja, a baza podataka treba podržavati stare drajvere.
Uglavnom, sve ovo postavlja ograničenja.
Komponente Causal consistency
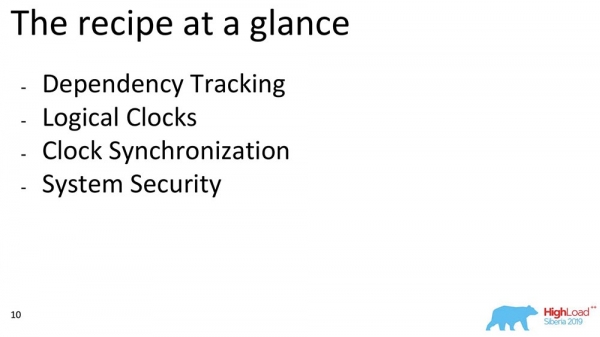
Sada ću govoriti o nekim komponentama. Ako uopće razmatramo Causal consistency, možemo izdvojiti blokove. Birali smo iz radova koji se odnose na određeni blok: Praćenje zavisnosti, odabir satova, kako se ti satovi mogu međusobno sinhronizirati, i kako osiguravamo sigurnost – to je okvirni plan o čemu ću govoriti:
Potpuno praćenje zavisnosti (Full Dependency Tracking)
Zašto je to potrebno? Kada se podaci repliciraju – svaki zapis, svaka promjena podataka sadrži informacije o tome od kojih promjena ovisi. Najprva i naivna promjena je kada svaka poruka koja sadrži zapis, sadrži informacije o prethodnim porukama:
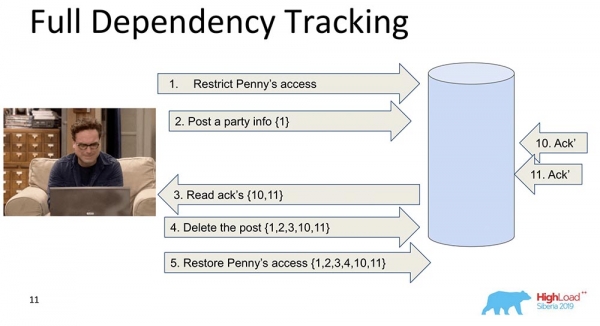
U ovom primjeru broj u vitičastim zagradama – to su brojevi zapisa. Ponekad se ti zapisi sa vrijednostima prenose čak i u cijelosti, ponekad se prenose neki verzije. Suština je da svaka promjena sadrži informacije o prethodnoj (jasno nosi sve to u sebi).
Zašto smo odlučili ne koristiti takav pristup (potpuno praćenje)? Očigledno, jer je taj pristup nepraktičan: svaka promjena u društvenoj mreži ovisi o svim prethodnim promjenama u toj društvenoj mreži, prenoseći, recimo, ‘Facebook’ ili ‘Vkontakte’ u svakom ažuriranju. Ipak, postoji mnogo istraživanja o Full Dependency Tracking – to su pre-socijalne mreže, za neke situacije to zaista funkcionira.
Jasno praćenje zavisnosti (Explicit Dependency Tracking)
Sljedeći – ograničeniji. Ovdje se također razmatra prijenos informacija, ali samo onih koje su jasno ovisne. Što o čemu ovisi, obično već određuje Aplikacija. Kada se podaci repliciraju, na zahtjev se daju samo odgovori kada su prethodne zavisnosti zadovoljene, to jest kada su prikazane. U tome je suština načina na koji Causal consistency funkcionira.
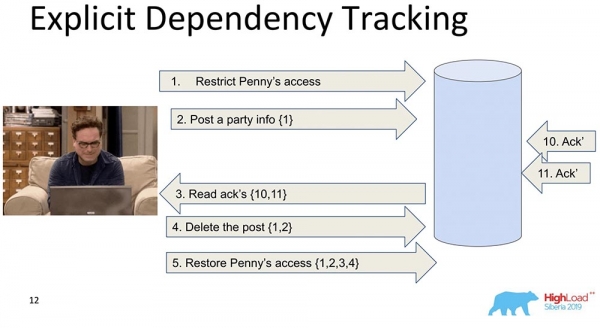
Ona vidi da zapis 5 ovisi o zapisima 1, 2, 3, 4 – prema tome, ona čeka, prije nego što klijent dobije pristup promjenama koje je donijela odluka pristupa Penny, kada su sve prethodne promjene već prošle u bazi podataka.
To nas također ne zadovoljava, jer ipak ima previše informacija, i to će usporiti. Postoji drugi pristup...
Lamportovi satovi (Lamport Clock)
Oni su jako stari. Lamport Clock podrazumijeva da se ove zavisnosti svode u skalarnu funkciju koja se naziva Lamport Clock.
Skalarnom funkcijom smatra se određeni apstraktni broj. Često ga nazivaju logičkim vremenom. Sa svakim događajem, ovaj counter se povećava. Counter koji je trenutno poznat procesu šalje svaku poruku. Jasno je da procesi mogu biti desinkronizovani, i da mogu imati potpuno različito vreme. Ipak, takvom razmenom poruka sistem nekako balansira svoje sate. Šta se u ovom slučaju dešava?
Podelio sam taj veliki shard na dva dela, kako bi bilo jasnije: Friends mogu živeti u jednoj nodi koja sadrži deo kolekcije, dok Feed može biti u potpuno drugoj nodi koja sadrži deo te kolekcije. Jasno je kako oni ne mogu stati u red? Prvo će Feed reći: "Replikuo se", a zatim - Friends. Ako sistem ne obezbeđuje nikakva jamstva da Feed neće biti prikazan dok zavisnosti Friends u kolekciji Friends ne budu isporučene, tada ćemo doći u situaciju o kojoj sam govorio.
Vidite kako logičko vreme counter-a na Feed-u raste:
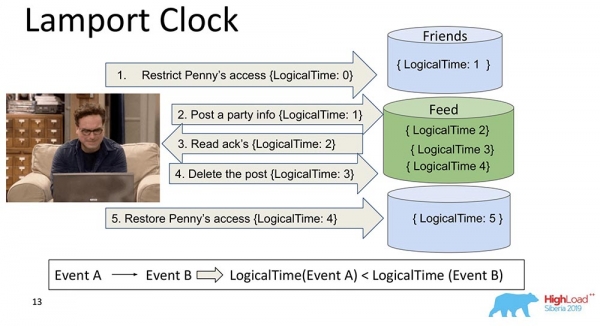
Dakle, osnovna osobina ovog Lamport Clock-a i Kausalne doslednosti (objašnjene kroz Lamport Clock) je sledeća: ako imamo događaje A i B, a događaj B zavisi od događaja A *, to implicira da je LogicalTime događaja A manje od LogicalTime događaja B.
* Ponekad se kaže da je A dogodio pre B, što znači da se A desilo pre B – to je odnos koji delimično uređuje celokupnu grupu događaja koji su se uopšte dogodili.
U obrnutom smeru to nije tačno. Ovo je zapravo jedan od osnovnih nedostataka Lamport Clock-a – delimični redosled. Postoji pojam simultanih događaja, što su događaji u kojima ni (A dogodio se pre B), ni (B dogodio se pre A). Primer može biti paralelno dodavanje prijatelja od strane Leonarda nekome drugome (čak ne i od strane Leonarda, već Šeldona, na primer).
To je svojstvo koje se često koristi prilikom rada sa Lamport-časovima: gleda se upravo na funkciju i na osnovu toga se donosi zaključak – možda su ti događaji zavisni. Jer u jednom smeru to je tačno: ako je LogicalTime A manje od LogicalTime B, tada B ne može biti dogodio pre A; a ako je veće, možda može.
Vektorski časovi (Vector Clock)
Logički razvoj Lamport-časova su Vektorski časovi. Oni se razlikuju po tome što svaka noda, koja ovde postoji, sadrži svoje, odvojene časove, a ti časovi se prenose kao vektor.
U ovom slučaju vidite da nulti indeks vektora odgovara za Feed, a prvi indeks vektora za Friends (svaki od ovih čvorova). I oni će sada rasti: nulti indeks "Feeda" raste na 1, 2, 3:
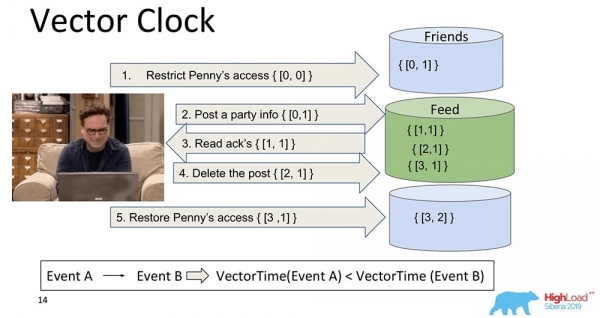
Što je bolje kod Vektorskih sati? To što omogućuju razumijevanje koja su događanja istovremena i kada se događaju na različitim čvorovima. Ovo je vrlo važno za sistem shardiranja, kao što je "MongoDB". Međutim, to nismo izabrali, iako je to divna stvar, odlično funkcioniše, i verovatno bi nam odgovaralo…
Ako imamo 10 hiljada shardova, ne možemo prenositi 10 hiljada komponenti, čak i ako kompresujemo, izmišljamo nešto drugo – korisni teret će i dalje biti nekoliko puta manji od celokupnog ovog vektora. Stoga, s težinom u srcu, odustali smo od ovog pristupa i prešli na drugi.
Spanner TrueTime. Atomski sati
Rekao sam da će biti priče o "Spanneru". To je nevjerojatna stvar, pravo XXI vek: atomski sati, GPS-sinhronizacija.
Koja je ideja? "Spanner" je Googleov sistem koji je nedavno čak postao dostupan ljudima (priključili su mu SQL). Svaka transakcija ima svoj vremenski žig. Budući da je vreme sinhronizovano*, svakom događaju se može dodeliti određeni vremenski trenutak – atomički sati imaju vreme čekanja, nakon čega se garantuje da "se dogodi" drugo vreme.
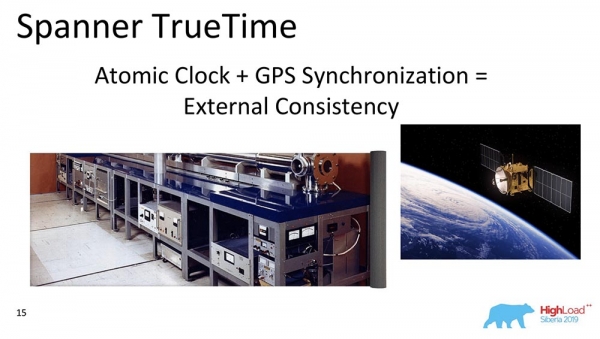
Na taj način, jednostavno beležeći u bazu podataka i čekajući određeni vremenski period, automatski se garantuje serializabilnost događaja. Imaju najjači model konzistentnosti koji u principu može postojati – to je eksternom konzistentno.
* To je glavni problem Lamportovih sati – nikada nisu sinhronizovani u distribuiranim sistemima. Mogu da se razdvoje, čak i uz NTP ne funkcionišu baš najbolje. „Spanner“ ima atomske sate i sinhronizaciju, čini se, do mikrosekundi.
Zašto nismo izabrali? Ne pretpostavljamo da naši korisnici imaju ugrađene atomske sate. Kada se pojave, kao ugrađeni u svaku laptop računar, biće neka super cool GPS-sinhronizacija – tada da… A za sada, najbolje što je moguće – to su "Amazon", bazne stanice – za fanatike… Zato smo koristili druge sate.
Hibridni sati (Hybrid Clock)
To je zapravo ono što kuca u 'MongoDB' kada osigurava uzročnu konzistentnost. U čemu su hibridni? Hibrid je skalarni broj, ali se sastoji od dvije komponente:
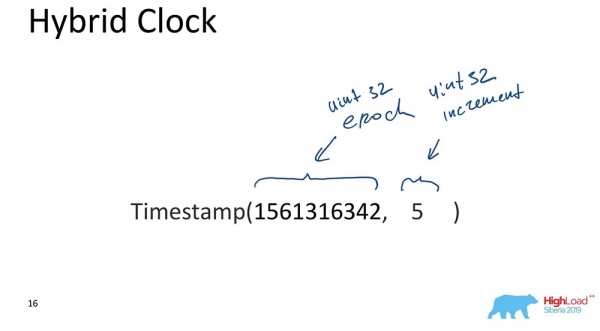
- Prvo – to je Unixova epoha (koliko sekundi je prošlo od 'početka računalnog svijeta').
- Drugo – neki inkrement, također 32-bitni unsigned int.
To je zapravo sve. Postoji pristup: dio koji odgovara za vrijeme uvijek se sinkronizira s satovima; svaki put kada se dogodi ažuriranje, taj dio se sinkronizira sa satovima i tako se dobije da je vrijeme uvijek više-manje ispravno, dok inkrement omogućava razlikovanje događaja koji su se dogodili u isti trenutak.
Zašto je to važno za 'MongoDB'? Zato što omogućava izradu nekih backup vraćanja na određeni trenutak vremena, to jest događaj se indeksira vremenom. To je važno kada su potrebni neki događaji; za baze podataka događaji su promjene u bazi koje su se dogodile u određenim vremenskim intervalima.
Najvažniju razlog ću reći samo vama (molim vas, samo nikome ne govorite)! Uradili smo to jer tako izgledaju uređeni, indeksirani podaci u MongoDB OpLogu. OpLog je struktura podataka koja sadrži sve promjene u bazi: prvo dolaze u OpLog, a zatim se primjenjuju na pohranu u slučaju kada su to replicirani podaci ili shard.
To je bio glavni razlog. Ipak postoje i praktični zahtjevi za razvoj baze, a to znači da treba biti jednostavno – malo koda, što manje slomljenih stvari koje treba prepisivati i testirati. To što su naši oplogi bili indeksirani hibridnim satovima, značajno je pomoglo i omogućilo ispravan izbor. To se doista isplatilo i na neki način čarobno funkcioniralo, već na prvom prototipu. Bilo je stvarno sjajno!
Sinkronizacija sati
Postoji nekoliko načina za sinkronizaciju opisano u naučnoj literaturi. Govorim o sinkronizaciji kada imamo dva različita shard-a. Ako postoji jedan replika-set, tada nije potrebna nikakva sinkronizacija: to je "single-master"; imamo OpLog, u koji svi promena ulaze – u tom slučaju je sve već sekvencijalno poređano u samom "OpLogu". Ali ako imamo dva različita shard-a, ovde je sinkronizacija vremena važna. Evo, vektorski satovi su mnogo pomogli! Ali mi ih nemamo.
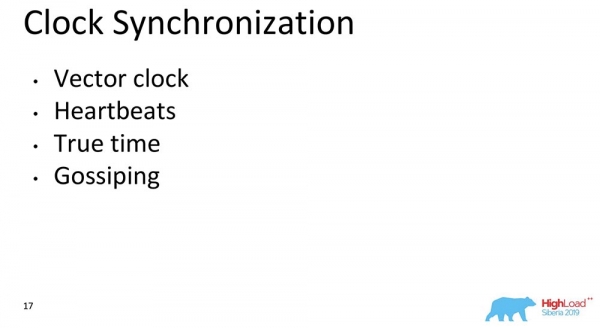
Drugi pristup je "Heartbeats". Mogu se razmenjivati neki signali koji se dešavaju svake jedinice vremena. Ali "Heartbeats" su previše spori, ne možemo obezbediti latenciju našem klijentu.
Pravi vreme – naravno, divna stvar. Ali, opet, to je verovatno budućnost... Iako u "Atlasu" već može to da se uradi, već postoje brzi "amazonški" sinhronizatori vremena. Ali to neće biti dostupno svima.
Gossiping – to je kada sve poruke uključuju vreme. To je otprilike ono što i koristimo. Svaka poruka između nodova, drajver, ruter data-nodova, apsolutno sve za "MongoDB" – to su neki elementi, sastavni delovi baze podataka, koji sadrže satove koji teče. Svuda imaju vrednost hibridnog vremena, koja se prenosi. 64 bita? To je moguće.
Kako sve ovo zajedno funkcioniše?
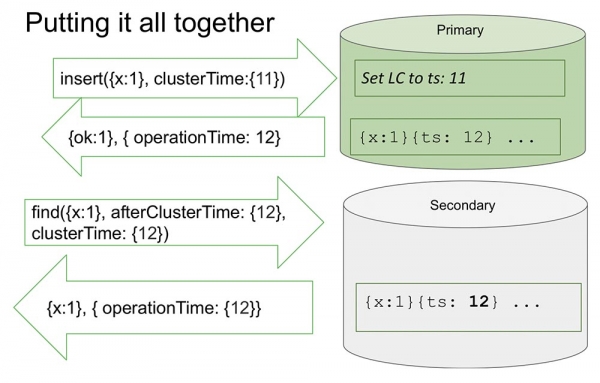
Ovde razmatram jedan replika-set, da bi bilo malo jednostavnije. Ima Primary i Secondary. Secondary obavlja replikaciju i ne uvek je potpuno sinkronizovan sa Primary.
Dešava se umetanje (insert) u "Primary" sa određenom vremenskom vrednošću. Ova umetanja povećava unutrašnji brojač za 11, ako je to maksimum. Ili će proveravati vrednosti satova i sinkronizovati se prema satovima, ako su vrednosti satova veće. To omogućava vremensko poređenje.
Nakon što napravi zapis, dešava se važan trenutak. Satovi u "MongoDB" se inkrementiraju samo u slučaju pisanja u "Oplog". To je događaj koji menja stanje sistema. U svim klasičnim člancima događajem se smatra dolazak poruke u nod: poruka je stigla – znači, sistem je promenio svoje stanje.
To je povezano s time da se tijekom istraživanja ne može potpuno razumjeti kako će ova poruka biti interpretirana. Sigurno znamo da ako nije odražena u "Oplogu", neće se nimalo interpretirati, a promjena stanja sustava je samo zapis u "Oplogu". Ovo nam pojednostavljuje stvari: model je pojednostavljen, a omogućuje i vođenje uređivanja unutar jednog replika skupa, kao i mnoge druge korisne stvari.
Vraća se vrijednost koja je već zapisana u "Oplog" – znamo da je u "Oplogu" već spremljena ta vrijednost, a njezino vrijeme je 12. Sada, recimo, počinje čitanje s druge čvora (Sekundarni), i on već prenosi afterClusterTime u samoj poruci. Kaže: "Trebam sve što se dogodilo barem nakon 12 ili u vrijeme dvanaest" (vidi sliku iznad).
To je ono što se naziva Causal a consistent (CAT). Postoji takav pojam u teoriji, da je to određeni trenutak vremena koji je sam po sebi konzistentan. U ovom slučaju možemo reći da je to stanje sustava koje je zabilježeno u trenutku vremena 12.
Trenutno ovdje još nema ništa, jer to donekle imitira situaciju kada je potrebno da Sekundarni replicira podatke s Primarnog. Čeka... I evo podaci su stigli – vraća te vrijednosti natrag.
Otprilike tako sve i funkcionira. Gotovo.
Što znači "gotovo"? Pretpostavimo da postoji neka osoba koja je pročitala i razumjela kako to sve funkcionira. Razumjela je da se svaki put događa ClusterTime, koji ažurira unutarnje logičke satove, a zatim sljedeći zapis se povećava za jedan. Ova funkcija zauzima 20 redaka. Recimo, ta osoba prosljeđuje maksimalni 64-bitni broj, minus jedan.
Zašto "minus jedan"? Zato što će unutarnji satovi biti umetnuti u tu vrijednost (očito, to je najveća moguća vrijednost i veća od trenutnog vremena), zatim će se dogoditi zapis u "Oplog", a satovi se još jednom inkrementiraju – tada će to biti u potpunosti maksimalna vrijednost (tu su svi jedinice, nema gdje dalje, unsaint int’ovi).
Jasno je da nakon toga sustav postaje potpuno nedostupan za bilo što. Može se samo izvući, očistiti – mnogo ručnog rada. Potpuna dostupnost:
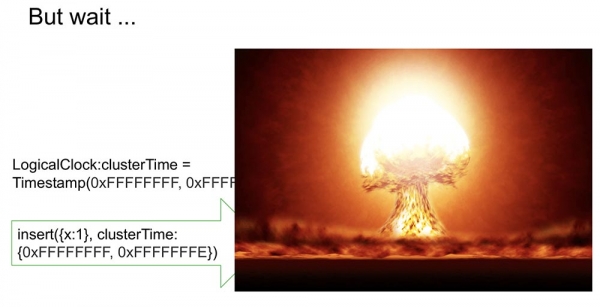
Kada se ovo replicira negdje drugdje, cijeli klaster jednostavno pada. Potpuno neprihvatljiva situacija koju bilo tko može vrlo brzo i lako izazvati! Stoga smo ovo smatrali jednim od najvažnijih pitanja. Kako to spriječiti?
Naš put je potpisivanje clusterTime
Tako se prenosi u poruci (do plavog teksta). No počeli smo i generirati potpis (plavi tekst):
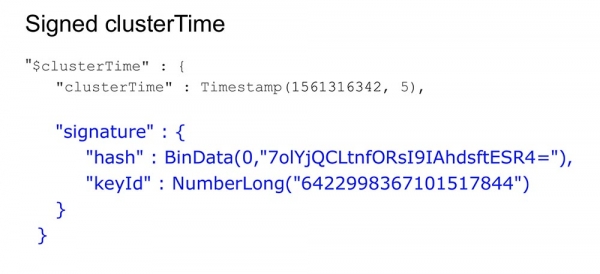
Potpis se generira ključem koji se čuva unutar baze podataka, unutar zaštićenog perimetra; sam se generira, ažurira (korisnici to ne vide). Generira se hash, a svaka poruka prilikom kreiranja se potpisuje, a prilikom primanja – validira.
Vjerojatno se postavlja pitanje: "Koliko ovo sve usporava?" Rekao sam da bi sve trebalo brzo raditi, posebno u odsustvu ove funkcionalnosti.
Što znači koristiti Causal consistency u ovom slučaju? To pokazuje afterClusterTime parametar. A bez toga će jednostavno prenositi vrijednosti u svakom slučaju. Gossiping, počevši od verzije 3.6, radi uvijek.
Ako ostavimo konstantno generiranje potpisa, to će usporiti sustav čak i u odsustvu funkcionalnosti, što nije u skladu s našim pristupima i zahtjevima. Što smo učinili?
Učini to brzo!
Prilično jednostavna stvar, ali zanimljiv trik – podijelit ću, možda će nekome biti zanimljivo.
Imamo hash u kojem se čuvaju potpisani podaci. Svi podaci prolaze kroz predmemoriju. Predmemorija ne potpisuje konkretno vrijeme, nego Range. Kada dođe određena vrijednost, generiramo Range, maskiramo posljednjih 16 bita, i tu vrijednost potpisujemo:
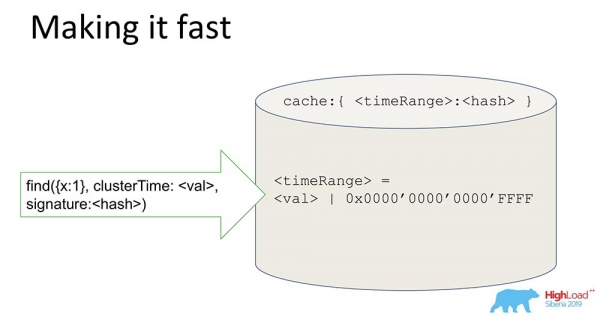
Dobivanjem takvog potpisa ubrzavamo sustav (pod uvjetom) 65 tisuća puta. Odlično radi: kada smo postavili eksperimente – vrijeme se stvarno skratilo 10 tisuća puta tijekom sekvencijalnog ažuriranja. Jasno je da kada su nesređeni, to ne funkcionira. No u većini praktičnih slučajeva to radi. Kombinacija potpisa Range zajedno s potpisom omogućila je rješavanje problema sigurnosti.
Jasno je da svaka usluga nastoji izbjeći zastoje. U našem slučaju, vjerujemo da su nedavni problemi pomogli da quay.io postane bolji. Za sebe smo izvukli nekoliko ključnih lekcija koje želimo podijeliti:
Lekcije koje smo iz toga izvukli:
- Treba čitati materijale, priče, članke, jer imamo mnogo zanimljivog sadržaja. Kada radimo na nekoj funkciji (osobito sada kada smo radili na transakcijama itd.), moramo čitati i razumevati. To oduzima vreme, ali je zapravo veoma korisno, jer postaje jasno gde se nalazimo. Nismo smislili ništa novo – samo smo uzeli sastojke.
Uopšte, primećuje se određena razlika u razmišljanju kada se održava akademska konferencija (npr. 'Sigmon') – svi su fokusirani na nove ideje. Koja je novost našeg algoritma? Ovde nema neke posebne novosti. Novost se pre sastoji u tome kako smo spojili postojeće pristupe. Zato prvo – treba čitati klasike, počevši od Lamporta.
- U produkciji su potpuno različiti zahtevi. Siguran sam da se mnogi od vas ne susreću sa 'sfernim' bazama podataka u apstraktnom vakuumu, već sa normalnim, stvarnim stvarima koje imaju probleme s dostupnošću, latencijom i otpornosti na greške.
- Poslednje – to je što smo morali razmotriti različite ideje i kombinovati nekoliko potpuno različitih članaka u jedan pristup, zajedno. Ideja o potpisivanju, na primer, zapravo je došla iz članka koji se bavio Paxos protokolom, koji za ne-vizantijske greške unutar autorizacionog protokola, za vizantijske – van autorizacionog protokola... U suštini, to je upravo ono što smo na kraju i uradili.
Nove ovde apsolutno nema! Ali čim smo sve to zajedno pomešali... Isto je kao reći da je recept za Olivier salatu glupost, jer su jaja, majonez i krastavci već smišljeni... To je otprilike ista priča.
Na tome ću završiti. Hvala!
Pitanja
Pitanje iz publike (dalje – P): – Hvala, Mihailo, na izlaganju! Tema o vremenu je zanimljiva. Koristite Gossiping. Rekli ste da svako ima svoje vreme, svi znaju svoje lokalno vreme. Shvatio sam da imamo drajver – klijenata sa drajverima može biti mnogo, query-planner-a takođe, shard-ova takođe mnogo... A k čemu dolazi sistem, ako iznenada dođe do neslaganja: neko odluči da je jednu minutu unapred, neko – jednu minutu unazad? Gde ćemo se naći?
MT: – Odličan je to pitanje! Baš sam htio govoriti o shardovima. Ako dobro razumijem pitanje, imamo sljedeću situaciju: postoji shard 1 i shard 2, čitanje se događa s ta dva shardova – imaju razlike, ne komuniciraju međusobno, jer vrijeme koje oni znaju – je različito, posebno vrijeme koje postoji u opalog.
Pretpostavimo da je shard 1 napravio milijun zapisa, shard 2 – ništa, a upit je stigao na ta dva shardova. I prvi ima afterClusterTime veći od milijun. U takvoj situaciji, kako sam objasnio, shard 2 nikada neće odgovoriti.
P: – Htio sam znati kako se sinkroniziraju i odabiru jedno logično vrijeme?
MT: – Vrlo se jednostavno sinkroniziraju. Shard, kada mu dođe afterClusterTime, i ne nalazi vrijeme u 'Opolagu' – inicira no approved. To znači da ručno podiže svoje vrijeme na tu vrijednost. To znači da nema događaja koji odgovaraju ovom zahtjevu. On umjetno stvara taj događaj i time postaje Causal Consistent.
P: – A što ako mu nakon toga dođu neki događaji koji su se negdje izgubili u mreži?
MT: – Shard je tako podešen da oni neće doći, jer je to single master. Ako je već zapisao, oni više ne mogu doći, već će se dogoditi kasnije. Ne može se dogoditi da je negdje nešto zapelo, zatim će napraviti no write, a onda ovi događaji dođu – i naruše Causal consistency. Kada se napravi no write, svi oni moraju doći dalje (on će ih pričekati).
P: – Imam nekoliko pitanja u vezi s redovima. Causal consistency pretpostavlja da postoji određeni red akcija koje treba izvršiti. Što će se dogoditi ako nam jedan paket ispadne? Evo, 10., 11... 12. je ispao, a svi ostali čekaju kada će se izvršiti. A iznenada nam je stroj umro, ne možemo učiniti ništa. Postoji li maksimalna duljina reda koja se akumulira prije nego što se izvrši? Kakvo se fatalno raskidanje događa pri gubitku bilo kojeg jednog stanja? Osim toga, ako zapišemo da postoji neko prethodno stanje, od njega se moramo na neki način oslanjati? A nismo se oslonili na njega!
MT: – Također odlično pitanje! Što radimo? U MongoDB-u postoji pojam quorum zapisivanja, quorum čitanja. U kojim slučajevima poruka može nestati? Kada zapis nije quorum ili kada čitanje nije quorum (također može doći neki garbage).
U vezi s Causal consistency proveli smo opsežno eksperimentalno istraživanje, čiji je rezultat bio da u slučajevima kada su zapisivanje i čitanje - nekvorumni, dolazi do kršenja Causal consistency. Točno to što govorite!
Naš savjet: koristiti barem kvorumno čitanje pri korištenju Causal consistency. Na taj način ništa se neće izgubiti, čak i ako kvorumni zapis nestane... To je ortogonalna situacija: ako korisnik ne želi da se podaci izgube, treba koristiti kvorumni zapis. Causal consistency ne jamči trajnost (durability). Jamstvo trajnosti osigurava replikacija i mehanizam vezan uz replikaciju.
P: – Kada kreiramo instancu koja izvodi sharding (ne master, nego slave), ona se oslanja na unix vrijeme vlastitog stroja ili na vrijeme "mastera"; sinkronizira se prvi put ili povremeno?
MT: – Sada ću pojasniti. Shard (tj. horizontalna particija) - uvijek ima Primary. A u shardu može biti "master" i mogu biti replikati. No, shard uvijek podržava zapisivanje, jer mora podržavati određenu domenu (u shardu je postavljen Primary).
P: – Znači, sve ovisi isključivo o "masteru"? Uvijek se koristi "master" vrijeme?
MT: – Da. Može se slikovito reći: satovi kucaju kada se zapisuje u "master", u "Oplogu".
P: – Imamo klijenta koji se spaja, i njemu nisu potrebne informacije o vremenu?
MT: – Uopće ništa ne mora znati! Ako govorimo o tome kako to funkcionira na klijentu: klijent, kada želi koristiti Causal consistency, treba otvoriti sesiju. Sada je sve tu: i transakcije u sesiji, i preuzimanje prava... Sesija je točno redoslijed logičkih događaja koji se odvijaju s klijentom.
Ako otvori tu sesiju i kaže da želi Causal consistency (ako sesija po defaultu podržava Causal consistency), sve automatski radi. Driver pamti to vrijeme i povećava ga kada dobije novu poruku. Pamti koji je odgovor prethodno vratio server koji je vratio podatke. Sljedeći zahtjev će sadržavati afterCluster ("vrijeme veće od ovog").
Klijent ne mora znati apsolutno ništa! To je potpuno neprozirno za njega. Ako ljudi koriste ove funkcionalnosti, što to omogućuje? Prvo, možete sigurno čitati iz sekundarnih izvora: možete pisati u primarni, a čitati iz geografski repliciranih sekundarnih i biti sigurni da to radi. U ovom slučaju, sesije koje su zapisane na primarnom se mogu prenijeti čak i na sekundarni, tj. možete koristiti ne jednu nego više sesija.
P: – Tema Eventual consistency je usko povezana s novim područjem računalne znanosti – tipovima podataka CRDT (Conflict-free Replicated Data Types). Jeste li razmatrali integraciju ovih tipova podataka u bazu i što možete reći o tome?
MT: – Dobro pitanje! CRDT ima smisla za sukobe pri pisanju: u MongoDB – jedinstveni master.
P: – Imam pitanje od devops stručnjaka. U stvarnom svijetu susreću se takve iezuitanske situacije, kada se dogodi vizantijski neuspjeh, a zli ljudi unutar zaštićenog perimetra počinju kvariti protokol, šaljući specijalno izrađene pakete?
MT: – Zli ljudi unutar perimetra – to je kao trojanski konj! Zli ljudi unutar perimetra mogu učiniti puno loših stvari.
P: – Očigledno je da ostavljati "rupe" u serveru, da tako kažem, kroz koje se može provući zoološki vrt slonova i srušiti cijeli klaster zauvijek... Trebat će vremena za ručnu obnovu... To je, blago rečeno, pogrešno. S druge strane, zanimljivo je što: u stvarnom životu, u praksi, susreću se takve situacije kada se zapravo događaju slični unutarnji napadi?
MT: – Budući da se rijetko susrećem s sigurnosnim probojem u stvarnom životu, ne mogu reći – možda se događaju. No, ako govorimo o developerskoj filozofiji, smatramo ovako: imamo perimetar koji osigurava tim koji se bavi sigurnošću – to je brava, zid; a unutar perimetra možete raditi što god želite. Jasno je da postoje korisnici koji mogu samo gledati, a postoje korisnici koji mogu obrisati direktorij.
Ovisno o pravima, šteta koju korisnici mogu učiniti može biti miš, a može biti i slon. Jasno je da korisnik s punim pravima može učiniti apsolutno sve. Korisnik s ograničenim pravima može prouzročiti znatno manje štete. Konkretno, ne može srušiti sustav.
P: – Unutar zaštićenog perimetra netko je pokušao stvoriti neočekivane protokole za server, kako bi ga onesposobio, a ako bude sreće, možda i cijeli klaster... Može li biti toliko "dobro"?
MT: – Nikad nisam čuo za takve stvari. To što se na taj način može srušiti server – nije tajna. Onemogućiti ga iznutra, kao autorizirani korisnik, koji može napisati nešto... U stvarnosti nije moguće, jer se svejedno mora verificirati. Postoji mogućnost isključivanja te autentifikacije za korisnike koji to ne žele – to su tada njihovi problemi; grubim rječnikom, sami su srušili zidove i možemo staviti slona unutra, koji će zgaziti... U svakom slučaju, može se oblačiti kao radnik za popravak, doći i izvući ga!
P: – Hvala na izvještaju. Sergey ("Yandex"). U "Mongu" postoji konstanta koja ograničava broj glasova članova u Replica Set-u, i ta konstanta je jednaka 7 (sedam). Zašto je to konstanta? Zašto nije neki parametar?
MT: – Replica Set može imati i do 40 čvorova. Tamo uvijek postoji većina. Ne znam koja je verzija...
P: – U Replica Set-u možemo pokretati i neglasače, ali glasača – maksimalno 7. Kako se u tom slučaju nositi s isključenjima, ako nam je Replica Set raspoređen na 3 data centra? Jedan data centar se može jednostavno isključiti, a još jedan uređaj može ispasti.
MT: – To je već malo izvan okvira izvještaja. To je opće pitanje. Možda ću ga moći kasnije objasniti.
Malo reklame 🙂
Hvala što ostajete s nama. Sviđa li vam se naše članke? Želite li vidjeti više zanimljivih materijala? Podržite nas narudžbom ili preporučite prijateljima, , jedinstveni analog entry-level servera koji smo razvili za vas: (dostupne opcije s RAID1 i RAID10, do 24 jezgre i do 40GB DDR4).
Dell R730xd je 2 puta jeftiniji u data centaru Equinix Tier IV u Amsterdamu? Samo kod nas u Nizozemskoj! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Pročitajte o tome
Izvor: habr.com
