

Kao i u , pojavila se problema s distribuiranom uslugom, nazovimo tu uslugu Elvin. Ovaj put nisam sam otkrio problem, obavijestili su me momci iz klijentskog dijela.
Jednom sam se probudio zbog nezadovoljavajuće poruke o velikim kašnjenjima kod Elvina, kojeg smo planirali pokrenuti uskoro. Naime, klijent se suočio s kašnjenjem 99. percentila oko 50 ms, što je značajno iznad našeg proračuna kašnjenja. To je bilo iznenađujuće, jer sam pažljivo testirao uslugu, posebno na kašnjenja, jer je to predmet čestih pritužbi.
Prije nego što sam predao Elvina na testiranje, proveo sam mnogo eksperimenata s 40 tisuća zahtjeva u sekundi (QPS), svi su pokazali kašnjenje manje od 10 ms. Bio sam spreman izjaviti da se ne slažem s njihovim rezultatima. No, ponovo gledajući poruku, primijetio sam nešto novo: ja sigurno nisam testirao uvjete koje su spomenuli, njihov QPS je bio daleko niži od mog. Ja sam testirao na 40k QPS, a oni samo na 1k. Pokrenuo sam još jedan eksperiment, ovaj put s nižim QPS, samo da ih umirim.
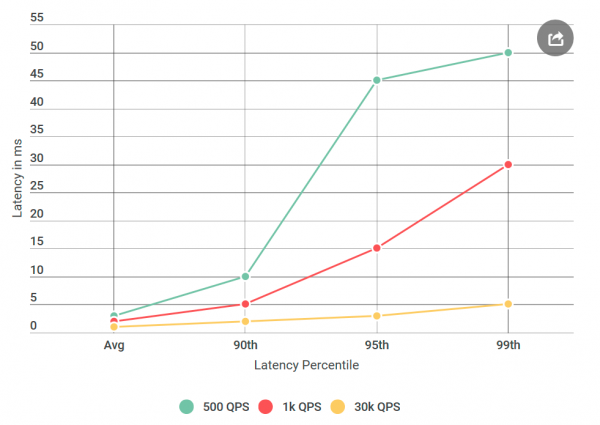
Budući da o tome pišem u blogu — vjerojatno ste već shvatili: njihovi su brojevi bili točni. Provjeravao sam svog virtualnog klijenta iznova i iznova, sve s istim rezultatom: niska količina zahtjeva ne samo da povećava kašnjenje, nego i povećava broj zahtjeva s kašnjenjem većim od 10 ms. Drugim riječima, dok je na 40k QPS oko 50 zahtjeva u sekundi premašilo 50 ms, na 1k QPS svake sekunde je bilo 100 zahtjeva iznad 50 ms. Paradoks!
Užavamo krug pretrage
Suočeni s problemom kašnjenja u distribuiranom sustavu s mnogo komponenti, prvo treba sastaviti kratak popis osumnjičenih. Kopajmo malo dublje u arhitekturi Elvina:
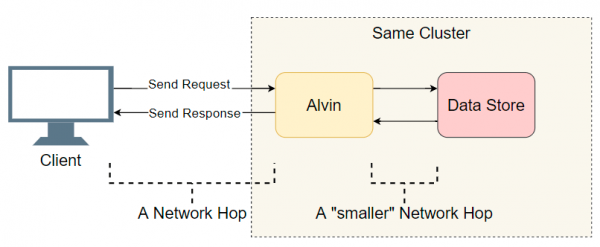
Dobra polazna točka je popis izvršenih ulaza/izlaza (mrežni pozivi/traženje na disku itd.). Pokušajmo otkriti gdje je kašnjenje. Osim očitih ulaza/izlaza s klijentom, Elvin čini dodatni korak: obraća se skladištu podataka. Međutim, to skladište radi u istom klasteru s Elvinom, stoga bi kašnjenje tamo trebalo biti manje nego s klijentom. Dakle, popis osumnjičenih:
- Mrežni poziv od klijenta do Elvina.
- Mrežni poziv od Elvina prema spremištu podataka.
- Pretraga na disku u spremištu podataka.
- Mrežni poziv iz spremišta podataka prema Elvinu.
- Mrežni poziv od Elvina prema klijentu.
Pokušajmo izostaviti neke stavke.
Spremište podataka nije u vezi s tim.
Prvo sam Elvina pretvorio u ping-ping server koji ne obrađuje zahtjeve. Kada primi zahtjev, vraća prazni odgovor. Ako se latencija smanjuje, onda je greška u implementaciji Elvina ili spremišta podataka - ništa izvanredno. U prvom eksperimentu dobivamo takav grafikon:
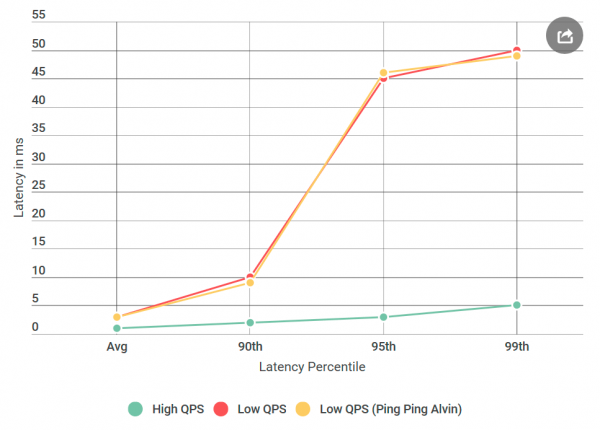
Kao što vidimo, korištenje ping-ping servera ne pokazuje nikakva poboljšanja. To znači da spremište podataka ne povećava latenciju, a popis osumnjičenika se prepolovio:
- Mrežni poziv od klijenta do Elvina.
- Mrežni poziv od Elvina prema klijentu.
Super! Popis se brzo smanjuje. Mislim da sam gotovo otkrio uzrok.
gRPC
Sada je vrijeme da vam predstavim novog igrača: . Ovo je knjižnica s otvorenim kodom od Googlea za međuprocesnu komunikaciju . Iako gRPC dobro je optimizirana i široko korištena, prvi put sam je koristio u sustavu takvih razmjera, i očekivao sam da će moja implementacija biti neoptimalna - blago rečeno.
Prisutnost gRPC u stogu je postavilo novo pitanje: možda moja implementacija ili sam gRPC uzrokuje problem latencije? Dodajemo novog osumnjičenika na popis:
- Klijent poziva knjižnicu
gRPC - Biblioteka
gRPCna klijentu izvodi mrežni poziv knjižnicegRPCna serveru - Biblioteka
gRPCobraća se Elvinu (operacija nije prisutna u slučaju ping-pong servera)
Da biste imali predodžbu o kodu, moja implementacija klijenta/Elvina ne razlikuje se mnogo od klijentsko-poslužiteljskih .
Napomena: gornji popis je malo pojednostavljen, jer
gRPComogućuje korištenje vlastitog (predloženog?) modela niti, u kojem se isprepliću stog izvršenjagRPCi korisnička implementacija. Radi jednostavnosti, pridržavat ćemo se ovog modela.
Profiliranje će sve popraviti.
Izostavljajući spremišta podataka, pomislio sam da sam gotovo završio: "Sada je lako! Primijenimo profil i saznajmo gdje se javlja latencija". Ja , jer su CPU vrlo brzi i najčešće nisu usko grlo. Većina latencija se događa kada procesor mora zaustaviti obradu da bi učinio nešto drugo. Točno profiliranje CPU-a upravo je napravljeno za to: ono precizno bilježi sve. i ukazuje gdje se javljaju zastoji.
Uzeo sam četiri profila: jedan za visoki QPS (mala latencija) i onaj s ping-pong serverom na niskom QPS (velika latencija), kako na strani klijenta, tako i na strani servera. I kao dodatak, također sam uzeo uzorak CPU profila. Kada uspoređujem profile, obično tražim abnormalan stog poziva. Na primjer, na lošoj strani s visokom latencijom dolazi do mnogo više prekidača konteksta (10 ili više puta). No, u mom slučaju, broj prekidača konteksta praktički je bio identičan. Na moje užas, nije bilo ničega značajnog.
Dodatno debagiranje
Bio sam očajan. Nisam znao koje druge alate mogu koristiti, a moj sljedeći plan bio je u biti ponoviti eksperiment s različitim varijacijama, umjesto da jasno dijagnosticiram problem.
Što ako
Od samog početka mučila me specifična latencija od 50 ms. To je vrlo dugo vrijeme. Odlučio sam da ću izrezati dijelove koda dok ne otkrijem točno koji dio uzrokuje ovu grešku. Zatim je uslijedio eksperiment koji je uspio.
Kao obično, unazad se čini da je sve bilo očito. Smjestio sam klijenta na jedan stroj s Elvinom - i poslao zahtjev u localhost. I povećanje latencije je nestalo!
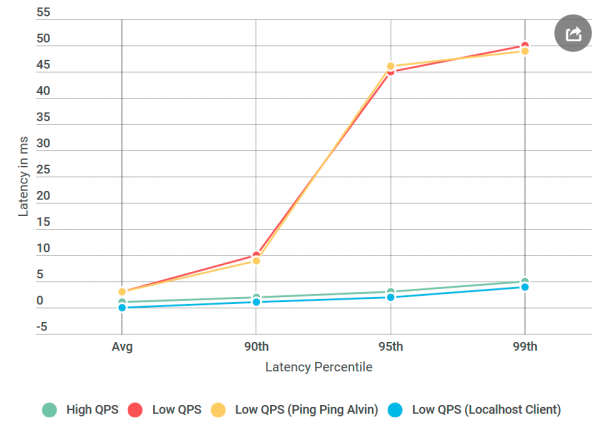
Nešto nije bilo u redu s mrežom.
Usvajajući vještine mrežnog inženjera
Moram priznati: moje znanje o mrežnim tehnologijama je strašno, posebno s obzirom na to da s njima radim svakodnevno. No, mreža je bila glavni sumnjivac, i trebao sam naučiti kako je debagirati.
Na sreću, internet voli one koji žele učiti. Kombinacija pinga i tracerta činila se kao dobar početak za debagiranje problema s mrežnim prijenosom.
Prvo sam pokrenuo na TCP portu Elvine. Koristio sam zadane postavke - ništa posebno. Od više od tisuću pingova, nijedan nije premašio 10 ms, osim prvog za zagrijavanje. To se protivi zabilježenom povećanju latencije od 50 ms u 99. percentilu: tamo smo za svakih 100 zahtjeva trebali vidjeti otprilike jedan zahtjev s latencijom od 50 ms.
Zatim sam isprobao : možda problem leži na jednom od čvorova na putu između Elvine i klijenta. No, tracert se također vratio s praznim rukama.
Tako je uzrok kašnjenja bio ne moj kod, ne implementacija gRPC i ne mreža. Već sam počeo brinuti se da to nikada neću shvatiti.
Na kojoj operativnoj sistemu se nalazimo
gRPC široko se koristi u Linuxu, ali za Windows je to egzotika. Odlučio sam provesti eksperiment, koji je uspio: stvorio sam virtualnu mašinu Linux, iskompajlirao Elvina za Linux i postavio ga.
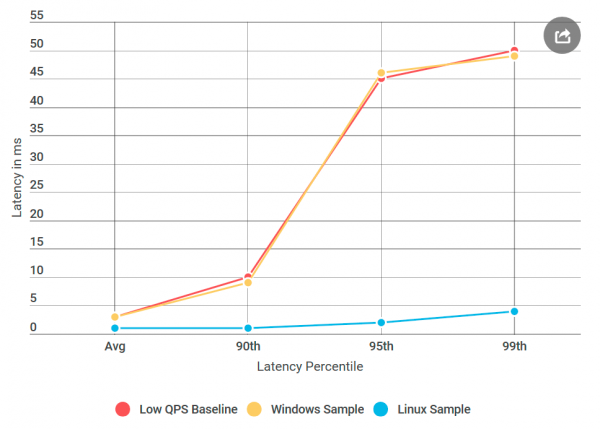
I evo što se dogodilo: u ping-pong serveru Linux nije bilo takvih kašnjenja, kao kod sličnog čvora na Windowsu, iako izvor podataka nije bio drugačiji. Ispostavilo se da je problem u implementaciji gRPC za Windows.
Nagleov algoritam
Cijelo to vrijeme mislio sam da mi nedostaje zastavica gRPC. Sada sam shvatio da zapravo nedostaje gRPC Windows zastavica. Našao sam internu RPC biblioteku, za koju sam bio siguran da dobro funkcionira za sve postavljene zastavice . Zatim sam dodao sve te zastavice u gRPC i postavio Elvina na Windows, u ispravljenom ping-pong serveru pod Windowsom!
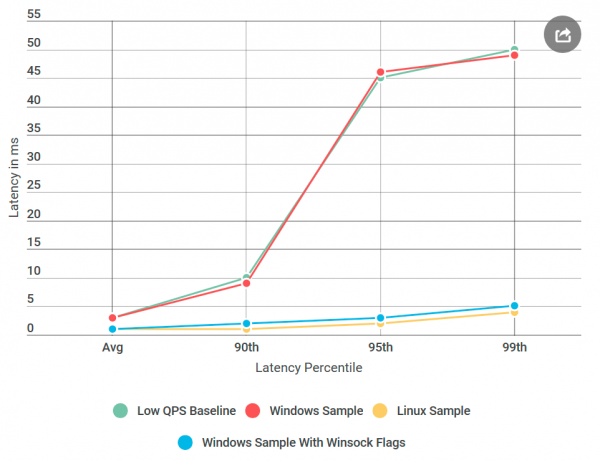
Skoro spremno: počeo sam uklanjati dodane zastavice jednu po jednu, dok se regresija nije vratila, tako da sam mogao točno odrediti njen uzrok. To je bila zloglasna , prekidač Nagleovog algoritma.
pokušava smanjiti broj paketa poslanih preko mreže odgađanjem slanja poruka dok veličina paketa ne premaši određeni broj bajtova. Iako to može biti korisno za prosječnog korisnika, uništava servere u stvarnom vremenu, jer OS odgađa neke poruke, uzrokujući kašnjenja pri niskom QPS-u. Ovaj gRPC bio je postavljen u implementaciji Linuxa za TCP sokete, ali ne i za Windows. To sam .
Zaključak
Veliko kašnjenje pri niskom QPS-u uzrokovala je optimizacija OS-a. Gledajući unatrag, profiliranje nije otkrilo kašnjenje jer je rađeno u kernel modu, a ne u . Ne znam može li se Nagleov algoritam promatrati kroz ETW snimke, ali to bi bilo zanimljivo.
Što se tiče eksperimenta localhost, vjerojatno se nije ticao stvarnog mrežnog koda, a Nagleov algoritam nije pokrenut, pa su problemi s kašnjenjem nestali kada je klijent pristupio Elvinu putem localhosta.
Sljedeći put kada primijetite povećanje kašnjenja prilikom smanjenja broja zahtjeva u sekundi, Nagleov algoritam trebao bi biti na vašem popisu osumnjičenih!
Izvor: habr.com
