

Industrijska izrada softverskih sustava zahtijeva veliku pažnju na otpornost konačnog proizvoda, kao i brzo reagiranje na kvarove i neuspjehe, ako se oni dogode. Praćenje, naravno, pomaže učinkovitije i brže reagirati na kvarove i probleme, ali to nije dovoljno. Prvo, vrlo je teško pratiti veliki broj poslužitelja — potrebno je puno ljudi. Drugo, potrebno je dobro razumjeti kako je aplikacija konstruirana kako bi se moglo predvidjeti njezino stanje. Stoga, potrebno je mnogo ljudi koji dobro razumiju sustave koje razvijamo, njihove pokazatelje i osobitosti. Pretpostavimo, čak i ako pronađemo dovoljan broj ljudi voljnih baviti se tim, potrebno je još puno vremena da ih obučimo.
Što učiniti? Tu nam u pomoć dolazi umjetna inteligencija. Ovaj članak će govoriti o (predictive maintenance). Ovaj pristup aktivno dobiva na popularnosti. Napisano je mnogo članaka, uključujući i na Habr-u. Velike tvrtke već koriste takav pristup za održavanje operativnosti svojih poslužitelja. Nakon što smo proučili mnogo članaka, odlučili smo isprobati ovaj pristup. Što se od toga izrodilo?
Uvod
Razvijeni softverski sustav prije ili kasnije ulazi u upotrebu. Korisniku je važno da sustav radi bez ikakvih problema. Ako se neočekivana situacija ipak dogodi, ona se mora riješiti s minimalnim kašnjenjem.
Za pojednostavljenje tehničke podrške softverskog sustava, posebno ako je poslužitelja mnogo, obično se koriste programi za praćenje koji prikupljaju metrike s radnog softverskog sustava, omogućuju dijagnosticiranje njegovog stanja i pomažu odrediti što je uzrokovalo kvar. Ovaj proces se naziva praćenjem softverskog sustava.
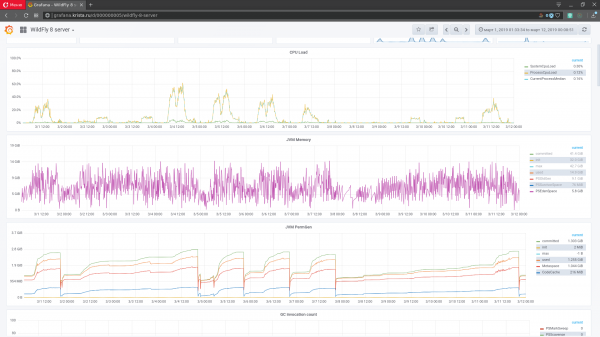
Slika 1. Sučelje za praćenje grafane
Metrike su različite mjere softverskog sustava, okruženja u kojem se izvršava ili fizičke računalne mašine ispod sustava, uz vremensku oznaku trenutka kada su metrički podaci prikupljeni. U statičkoj analizi, podaci metrika nazivaju se vremenskim serijama. Za nadgledanje stanja softverskog sustava, metrike se prikazuju u obliku grafova: na X osi je vrijeme, a na Y osi su vrijednosti (slika 1). Iz funkcionalnog softverskog sustava može se prikupljati nekoliko tisuća metrika (sa svakog čvora). One čine prostor metrika (višedimenzionalne vremenske serije).
Budući da se kod složenih softverskih sustava prikuplja veliki broj metrika, ručno nadgledanje postaje složen zadatak. Kako bi se smanjila količina podataka koje administratori analiziraju, alati za nadgledanje sadrže alate za automatsko otkrivanje mogućih problema. Na primjer, može se postaviti okidač koji se aktivira kada slobodni prostor na disku padne ispod naznačenog praga. Također, može se automatski dijagnosticirati zaustavljanje servera ili kritično usporavanje brzine usluge. U praksi, alati za nadgledanje prilično dobro obavljaju otkrivanje već dogovorenih neuspjeha ili prepoznavanje jednostavnih simptoma budućih neuspjeha, ali u cjelini, predviđanje mogućeg kvara ostaje težak zadatak. Predviđanje kroz ručnu analizu metrika zahtijeva uključivanje kvalificiranih stručnjaka. To je nedjelotvorno. Većina mogućih neuspjeha može ostati neprimijećena.
U posljednje vrijeme među velikim IT kompanijama koje se bave razvojem softvera, prediktivno održavanje softverskih sustava stječe sve veću popularnost. Suština ovog pristupa leži u pronalaženju kvarova koji dovode do degradacije sustava u ranim fazama, prije nego što dođe do kvara, koristeći umjetnu inteligenciju. Ovaj pristup ne isključuje potpuno ručno nadgledanje sustava. Ono je pomoćno za proces nadgledanja u cjelini.
Glavni alat za implementaciju prediktivnog održavanja je zadatak pretraživanja anomalija u vremenskim serijama, budući da u slučaju pojave anomalije u podacima postoji velika vjerojatnost da će nakon nekog vremena doći će do kvara ili greške. Anomalija je odstupanje u performansama softverskog sustava, kao što je otkrivanje degradacije brzine izvršavanja upita jednog tipa ili smanjenje prosječnog broja obrađenih zahtjeva pri stalnoj razini korisničkih sesija.
Zadatak pronalaženja anomalija u softverskim sustavima ima svoje specifičnosti. Ideja je da za svaki softverski sustav treba razviti ili doraditi postojeće metode, jer pronalaženje anomalija u velikoj mjeri ovisi o podacima u kojima se provodi, a podaci softverskih sustava vrlo su raznoliki, ovisno o alatima implementacije sustava pa čak i o hardverskoj platformi na kojoj je pokrenut.
Metode pronalaženja anomalija pri prognoziranju kvarova softverskih sustava
Prije svega, treba reći da je ideja prognoziranja kvarova inspirirana člankom . Za provjeru učinkovitosti pristupa automatiziranom pronalaženju anomalija, izabran je softverski sustav „Web-Konsolidacija“, koji je jedan od projekata tvrtke NPO „Krista“. Za njega se ranije provodio ručni nadzor temeljen na dobivenim metrima. Kako je sustav dovoljno složen, za njega se prikupljaju veliki brojevi metrika: pokazatelji JVM-a (opterećenje sakupljača smeća), pokazatelji OS-a na kojem je kod izvršen (virtualna memorija, % opterećenja CPU-a OS-a), pokazatelji mreže (opterećenje mreže), samog servera (opterećenje CPU-a, memorije), metri wildfly-a i vlastiti metri aplikacije po svim kritičnim podsustavima.
Sve metrike prikupljaju se iz sustava uz pomoć graphite-a. U početku je korištena baza whisper kao standardno rješenje za grafanu, ali s rastom baze korisnika, graphite više nije mogao podnijeti, dosegnuvši propusnost diskovnog sustava DC-a. Nakon toga donesena je odluka o pronalaženju učinkovitijeg rješenja. Odabir je pao na , što je omogućilo smanjenje opterećenja na disku za red veličine i pet-šest puta smanjenje zauzeća diska. Ispod je prikazana shema mehanizma prikupljanja metrika uz korištenje graphite+clickhouse (slika 2).
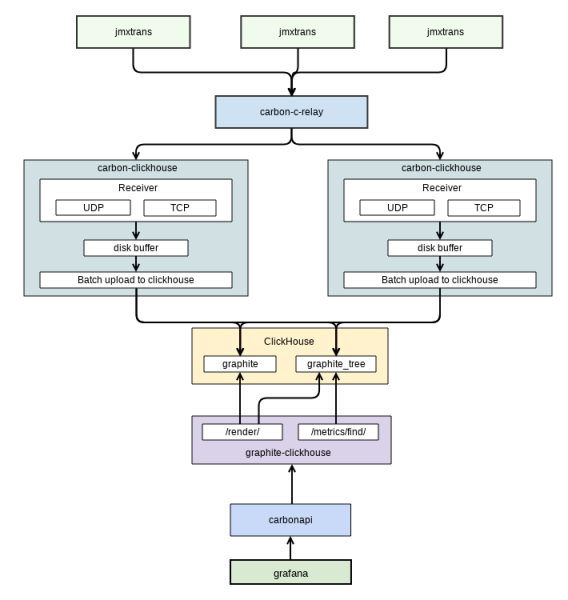
Slika 2. Shema prikupljanja metrika
Shema je preuzeta iz interne dokumentacije. Na njoj je prikazana razmena podataka između grafane (korisničkog interfejsa za praćenje koji koristimo) i graphite. Merenje metrika iz aplikacije vrši poseban softver – . On takođe čuva te podatke u graphite.
Sistem 'Web-Konsolidacija' ima niz karakteristika koje stvaraju probleme u prognoziranju kvarova:
- često dolazi do promene trenda. Na ovu softversku sistem izlaze različite verzije. Svaka od njih donosi promene u softverskom delu sistema. Shodno tome, programeri direktno utiču na metrike ovog sistema i mogu izazvati promenu trenda;
- karakteristike implementacije, kao i ciljevi korišćenja od strane korisnika često izazivaju anomalije bez prethodne degradacije;
- procena anomalija u odnosu na celokupni skup podataka je mala (< 5%);
- mogu se pojaviti prekidi u dobijanju pokazatelja iz sistema. U nekim kratkim vremenskim okvirima sistemu za praćenje ne uspeva da dobije metrike. Na primer, ako je server preopterećen. Za obučavanje neuronske mreže ovo je kritično. Pojavljuje se potreba za sintetičkim popunjavanjem praznina;
- Slučajevi s anomalijama često su relevantni samo za određenu brojku/mesece/vreme (sezonalnost). Ovaj sistem ima jasne regulative korišćenja od strane njegovih korisnika. Shodno tome, metrike su relevantne samo za određeno vreme. Sistem se može koristiti neprekidno, već samo u određenim mesecima: selektivno, zavisno od godine. Pojavljuju se situacije kada isto ponašanje metrika može dovesti do kvara softverskog sistema, dok u drugom slučaju ne.
U početku su analizirane metode otkrivanja anomalija u podacima praćenja softverskih sistema. U člancima na ovu temu se pri malim procentima anomalija u odnosu na ostatak skupa podataka najčešće predlaže korišćenje neuronskih mreža.
Osnovna logika za pretragu anomalija koristeći podatke neuronskih mreža prikazana je na slici 3:
Slika 3. Pretraga anomalija korišćenjem neuronske mreže
Na rezultatu prognoze ili obnove prozora trenutnog toka metrika izračunava se odstupanje od dobivenog s radnog programskog sustava. U slučaju velike razlike između dobivenih metrika iz programskog sustava i neuronske mreže, može se donijeti zaključak o anomalnosti trenutnog dijela podataka. Pojavljuje se sljedeći niz problema za korištenje neuronskih mreža:
- za ispravno funkcioniranje u streaming režimu podaci za obuku modela neuronskih mreža trebaju uključivati samo "normalne" podatke;
- neophodno je imati ažurirani model za točno otkrivanje. Promjena trenda i sezonalnosti u metrikama može uzrokovati veliki broj lažnih pozitivnih nalaza modela. Za njegovo ažuriranje potrebno je jasno odrediti vrijeme kada model postaje zastario. Ako se model ažurira prekasno ili prerano, vjerojatno će uslijediti veliki broj lažnih pozitivnih nalaza.
Također se ne smije zaboraviti na pronalaženje i sprečavanje čestog nastanka lažnih pozitivnih nalaza. Pretpostavlja se da će se oni najčešće pojavljivati u izvanrednim situacijama. Međutim, mogu biti i posljedica greške neuronske mreže zbog nedovoljnog treniranja. Potrebno je minimizirati broj lažnih pozitivnih nalaza modela. U suprotnom, lažne prognoze će oduzeti puno vremena administratoru, koje je namijenjeno provjeri sustava. Pr sooner ili kasnije završit će tako da administrator jednostavno prestane reagirati na "paranoičan" sustav nadzora.
Rekurentna neuronska mreža
Za otkrivanje anomalija u vremenskim serijama može se primijeniti s LSTM memorijom. Problem je samo u tome što se može koristiti samo za predviđene vremenske serije. U našem slučaju nisu sve metrike predvidive. Pokušaj primjene RNN LSTM za vremensku seriju prikazan je na slici 4.
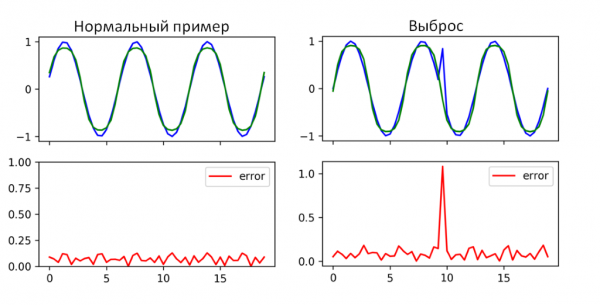
Slika 4. Primjer rada rekurentne neuronske mreže s LSTM memorijskim ćelijama
Kao što je prikazano na slici 4, RNN LSTM uspjela je prepoznati anomalije u ovom vremenskom razdoblju. Tamo gdje je rezultat imao visoku prediktivnu pogrešku (mean error), zapravo je došlo do anomalije u pokazateljima. Korištenje samo jedne RNN LSTM očito neće biti dovoljno, jer se primjenjuje na malom broju metrika. Može se koristiti kao pomoćna metoda za otkrivanje anomalija.
Autoenkoder za predviđanje kvarova
– suštinski umjetna neuronska mreža. Ulazni sloj – encoder, izlazni sloj – decoder. Nedostatak svih neuronskih mreža ovog tipa je loša lokalizacija anomalija. Odabrana je arhitektura sinkronog autoenkodera.
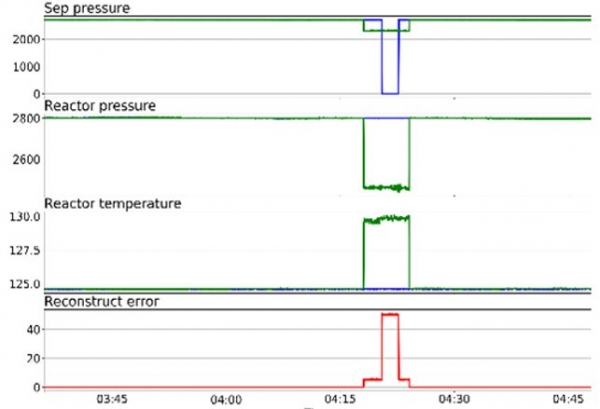
Slika 5. Primjer rada autoenkodera
Autoenkoderi se treniraju na normalnim podacima, a zatim pronalaze nešto anomalno u podacima koji se unose u model. To je upravo ono što je potrebno za ovaj zadatak. Ostaje samo odabrati koji autoenkoder odgovara ovom zadatku. Arhitektonski najjednostavniji oblik autoenkodera predstavlja direktnu, jednokratnu neuronsku mrežu koja vrlo sliči (multilayer perceptron, MLP), s ulaznim slojem, izlaznim slojem i jednim ili više skrivenih slojeva koji ih povezuju.
Međutim, razlike između autoenkodera i MLP-a leže u tome što u autoenkoderu izlazni sloj ima isti broj čvorova kao i ulazni, i što se umjesto predikcije ciljne vrijednosti Y, zadane ulazom X, autoenkoder trenira da rekonstruiše vlastite X. Stoga su autoenkoderi modeli za učenje bez nadzora.
Zadatak autoenkodera je pronaći vremenske indekse r0 … rn, koji odgovaraju anomalnim elementima u ulaznom vektoru X. Ovaj učinak postiže se pretraživanjem kvadratne pogreške.
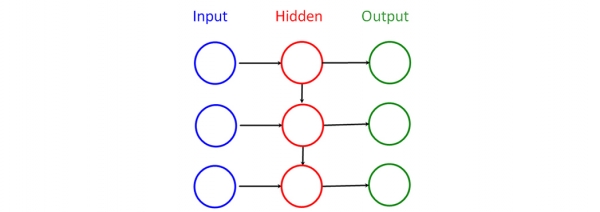
Slika 6. Sinkroni autoenkoder
Za autoenkoder je odabrana . Njezine prednosti: mogućnost korištenja struje podataka i relativno manji broj parametara neuronske mreže u odnosu na druge arhitekture.
Mehanizam minimizacije lažnih alarma
S obzirom na to da se javljaju različite nepredviđene situacije, kao i mogućnost nedovoljnog treniranja neuronske mreže, odlučeno je o potrebi razvoja mehanizma za minimiziranje lažnih uzbuna za razvijeni model otkrivanja anomalija. Ovaj mehanizam temelji se na bazi obrazaca koju klasificira administrator.
(DTW-algoritam, od eng. dynamic time warping) omogućuje pronalaženje optimalnog usklađenja između vremenskih nizova. Prvi put je primijenjen u prepoznavanju govora: korišten je za određivanje kako dva govorna signala predstavljaju istu izvorno izgovorenu frazu. Kasnije je pronađena primjena i u drugim područjima.
Osnovni princip minimizacije lažnih uzbuna je prikupljanje baze uzoraka uz pomoć operatora koji klasificira sumnjive slučajeve otkrivene pomoću neuronskih mreža. Slijedi usporedba klasificiranog uzorka s onim slučajem koji je sustav otkrio, te se donosi zaključak o pripadnosti slučaja lažnom uzbuni ili onom koji uzrokuje kvar. Upravo za usporedbu dva vremenska niza koristi se algoritam DTW. Glavni alat minimizacije i dalje ostaje klasifikacija. Pretpostavlja se da će nakon prikupljanja velikog broja uzoraka sustav početi manje tražiti od operatora zbog sličnosti većine slučajeva i pojave sličnih.
Na osnovu gore opisanih metoda neuronskih mreža izgrađen je eksperimentalni program za predikciju kvarova sustava 'Web-Konsolidacija'. Cilj ovog programa bio je, koristeći postojeći arhiv podataka o nadzoru i informacije o već nastalim kvarovima, procijeniti učinkovitost pristupa za naše softverske sustave. Shema rada programa prikazana je u nastavku, na slici 7.
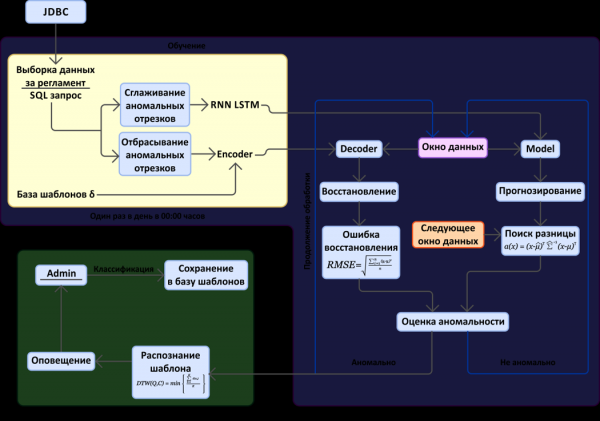
Slika 7. Shema predikcije kvarova na temelju analize prostora metrika
Na shemi se mogu izdvojiti dva osnovna bloka: pronalazak anomalnih vremenskih segmenata u protoku podataka o nadzoru (metrikama) i mehanizam minimiziranja lažnih uzbuna. Napomena: u eksperimentalne svrhe podaci se dobivaju putem JDBC veze iz baze podataka u koju ih pohranjuje graphite.
Nastavlja se s prikazom sučelja razvijenog sustava za praćenje (slika 8).
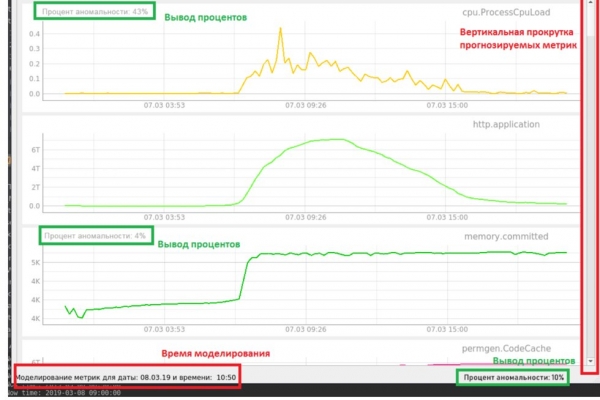
Slika 8. Sučelje eksperimentalnog sustava za praćenje
Na sučelju se prikazuje postotak anomalije temeljen na primljenim metrikanama. U našem slučaju, to se modelira. Već imamo sve podatke za nekoliko tjedana i postupno ih učitavamo kako bismo provjerili slučaj s anomalijom koja dovodi do zastoja. U donjoj statusnoj traci prikazan je ukupni postotak anomalije podataka u tom trenutku, koji se određuje pomoću autoenkodera. Također, za predviđene metrike prikazuje se zaseban postotak koji izračunava RNN LSTM.
Primjer otkrivanja anomalije prema pokazateljima CPU-a pomoću neuronske mreže RNN LSTM (slika 9).
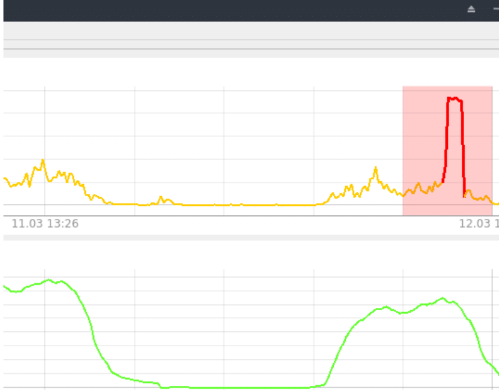
Slika 9. Otkrivanje RNN LSTM
Prilično jednostavan slučaj, zapravo običan izlet, ali dovodi do zastoja sustava, uspješno je identificiran pomoću RNN LSTM. Postotak anomalije u ovom vremenskom okviru iznosi 85 – 95%, sve što je iznad 80% (prag je eksperimentalno utvrđen) smatra se anomalijom.
Primjer otkrivanja anomalije kada sustav nije mogao pokrenuti nakon ažuriranja. Ovu situaciju detektira autoenkoder (slika 10).
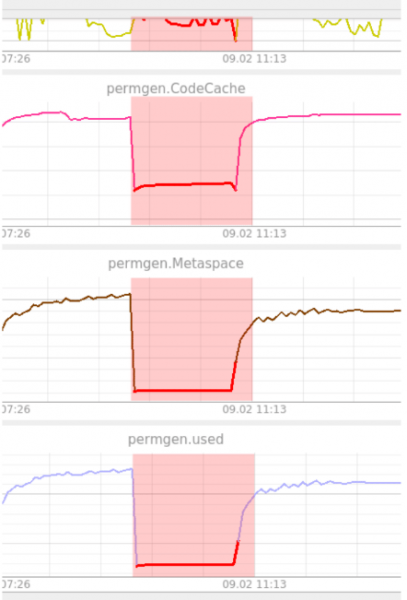
Slika 10. Primjer otkrivanja od strane autoenkodera
Kao što se može vidjeti na slici, PermGen je ostao na jednoj razini. Autoenkoder je to smatrao čudnim jer ranije nije vidio ništa slično. Anomalija se zadržava na 100% do povratka sustava u radno stanje. Anomalija se prikazuje za sve metrike. Kao što je ranije spomenuto, autoenkoder ne može lokalizirati anomalije. Operater ima zadaću izvršiti ovu funkciju u takvim situacijama.
Zaključak
Projekt "Web-Konsolidacija" se razvija već nekoliko godina. Sustav je u prilično stabilnom stanju, a broj registriranih incidenata je mali. Ipak, uspješno su pronađene anomalije koje su dovele do zastoja 5 – 10 minuta prije nego što je došlo do zastoja. U nekim slučajevima, pravovremeno obavještavanje o zastoju pomoglo bi uštedjeti vrijeme koje je dodijeljeno za izvođenje "popravnih" radova.
Na temelju eksperimenata koje smo proveli, još je prerano donositi konačne zaključke. Trenutni rezultati su kontradiktorni. S jedne strane, vidljivo je da algoritmi temeljeni na neuronskim mrežama mogu pronaći "korisne" anomalije. S druge strane, postoji veliki postotak lažnih uzbuna, a ne uspijevamo otkriti sve anomalije koje kvalificirani stručnjak može identificirati neuronskom mrežom. Među nedostacima je i to što trenutna neuronska mreža zahtijeva učenje pod nadzorom za normalan rad.
Za daljnji razvoj sustava predikcije kvarova i njegovog dovođenja do zadovoljavajuće razine, mogu se razmotriti nekoliko putova. To je detaljnija analiza slučajeva s anomalijama koje dovode do kvara, nadogradnjom popisa važnih metrika koje značajno utječu na stanje sustava, te odbacivanje onih koje nemaju utjecaja. Također, ako krenemo u tom smjeru, možemo pokušati specijalizirati algoritme konkretno za naše slučajeve s anomalijama koje dovode do kvarova. Postoji i drugi put. To je unapređenje arhitektura neuronskih mreža i povećanje točnosti otkrivanja uz smanjenje vremena potrebnog za učenje.
Izražavam zahvalnost kolegama koji su mi pomagali u pisanju i održavanju ažurnosti ovog članka: i Sergiju Finogenovu.
Izvor: habr.com
