

Bok, Habr!
Nastavljamo istraživati temu i , uključujući i na razini baza podataka. Danas predlažemo da pročitate zašto prilikom dizajniranja velikih aplikacija struktura baze podataka, a ne Java kod, treba imati odlučujuću važnost, kako to raditi i koje su iznimke od ovog pravila.
U ovom prilično zakašnjelom članku objašnjavam zašto smatram da u praktički svim slučajevima model podataka u aplikaciji treba biti projektiran "iz baze podataka", a ne "iz mogućnosti Jave" (ili drugog klijentskog jezika s kojim radite). Birajući drugi pristup, upuštate se na dug put boli i patnje čim vaš projekt počne rasti.
Članak je napisan prema motivima , postavljenog na Stack Overflow.
Zanimljive rasprave na reddit u odjeljcima i .
Generiranje koda
Kako me iznenadilo što postoji tako mali sloj korisnika koji, upoznavši se s jOOQ-om, negoduju zbog činjenice da se pri radu s jOOQ-om ozbiljno oslanja na generiranje izvornog koda. Nitko vas ne sprječava da koristite jOOQ onako kako smatrate potrebnim i ne prisiljava vas na korištenje generiranja koda. No prema zadanim postavkama (kako je opisano u priručniku) rad s jOOQ-om izgleda ovako: započinjete s (naslijeđenom) shemom baze podataka, izvršavate njeno obrnuto projektiranje pomoću jOOQ generatora koda kako biste dobili skup klasa koje predstavljaju vaše tablice, a zatim pišete tip-safe upite za te tablice:
	for (Record2 record : DSL.using(configuration)
//   ^^^^^^^^^^^^^^^^^^^^^^^ Informacije o tipovima zaključene su na
//   osnovu generiranog koda na koji se poziva navedeno
//   dolje uvjet SELECT

       .select(ACTOR.FIRST_NAME, ACTOR.LAST_NAME)
//           vvvvv ^^^^^^^^^^^^  ^^^^^^^^^^^^^^^ generirana imena
       .from(ACTOR)
       .orderBy(1, 2)) {
    // ...
}
Kod se generira ili ručno izvan gradnje, ili ručno pri svakoj gradnji. Na primjer, takva regeneracija može uslijediti odmah nakon .
Generiranje izvornog koda
Pristupi generiranju koda, kako ručni tako i automatski, povezani su s različitim filozofijama, prednostima i nedostacima koje ne namjeravam detaljno razrađivati u ovom članku. No, u suštini, cijela poanta generiranog koda je u tome da omogućuje reprodukciju na Javi te 'istine' koju prihvaćamo kao činjenicu, bilo unutar našeg sustava, bilo izvan njega. Na neki način, to isto rade kompajleri, generirajući bajt-kod, strojni kod ili neku drugu vrstu koda na temelju izvornih kodova – dobivamo predstavu naše 'istine' na drugom jeziku, neovisno o specifičnim razlozima.
Postoji mnogo takvih generatora koda. Na primjer, Princip je uvijek isti:
- Postoji neka istina (unutarnja ili vanjska) – primjerice, specifikacija, model podataka itd.
- Trebamo lokalnu reprezentaciju te istine na našem programskom jeziku.
Osim toga, generirati takvu reprezentaciju gotovo uvijek je smisleno – kako bi se izbjegla suvišnost.
Provođenje tipova i obrada anotacija
Napomena: još jedan, moderniji i specifičniji pristup generaciji koda za jOOQ povezan je s korištenjem provoditelja tipova, U tom slučaju kod generira kompajler, zapravo u fazi kompajliranja. U obliku izvornog koda takav kod u načelu ne postoji. U Javi postoje slični, iako manje elegantni alati – to su procesori anotacija, na primjer, .
U određenom smislu, ovdje se dešava iste stvari kao u prvom slučaju, osim što:
- Ne vidite generirani kod (možda se nekome čini da ta situacija nije toliko odbijajuća?)
- Morate jamčiti da se tipovi mogu pružiti, odnosno, 'istina' uvijek mora biti dostupna. To je lako u slučaju Lomboka, koji anotira 'istinu'. Malo je složenije s modelima baza podataka čiji rad ovisi o stalno dostupnoj aktivnoj vezi.
Koji je problem s generacijom koda?
Osim zagonetnog pitanja o tome kako bolje pokrenuti generaciju koda – ručno ili automatski, treba spomenuti i da postoje ljudi koji smatraju da generacija koda uopće nije potrebna. Objašnjenje ovog stava, koje sam najčešće susretao, jest da je tada teško podesiti tijek izgradnje. Da, zaista je teško. Pojavljuju se dodatni infrastrukturni troškovi. Ako tek počinjete raditi s određenim proizvodom (bilo da je to jOOQ, JAXB, Hibernate itd.), na podešavanje radnog okruženja troši se vrijeme koje biste radije potrošili na učenje samog API-a kako biste kasnije izvukli vrijednost iz njega.
Ako su troškovi povezani s razumijevanjem radnje generatora preveliki – tada je u API-ju loše odrađeno korisničko sučelje generatora koda (a ispostavilo se da je i korisničko podešavanje u njemu složeno). Upotrebljivost treba biti najviši prioritet za bilo koji takav API. No, to je samo jedan argument protiv generacije koda. Inače, potpuno ručno pisanje lokalnog predstavljanja unutarnje ili vanjske istine.
Mnogi će reći da nemaju vremena time se baviti. Imaju rokove za isporuku svog Super-Proizvoda. Kasnije ćemo srediti tijekove izgradnje, imat ćemo vremena. Ja im kažem:
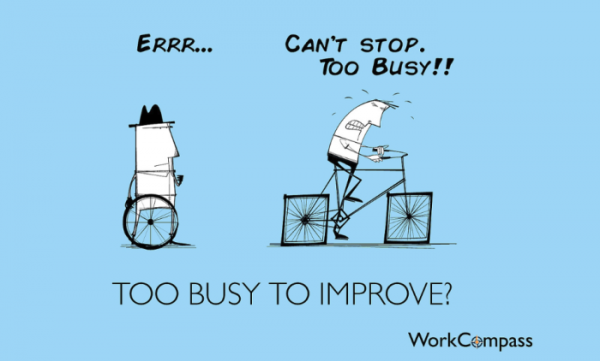
,
Ali u Hibernateu / JPA tako je lako pisati kod "za Javu".
Zaista. Za Hibernate i njegove korisnike to je istovremeno blagoslov i prokletstvo. U Hibernateu možete jednostavno napisati nekoliko entiteta, ovako:
	@Entity
class Knjiga {
  @Id
  int id;
  String naslov;
}
I gotovo je sve spremno. Sada je zadatak Hibernatea – generirati složene "detalje" o tome kako će ova entitet biti definirana na DDL vašeg "dijalekta" SQL:
	CREATE TABLE knjiga (
  id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
  naslov VARCHAR(50),

  CONSTRAINT pk_knjiga PRIMARY KEY (id)
);

CREATE INDEX i_knjiga_naslov ON knjiga (naslov);
… i počinjemo pokretati aplikaciju. Zaista izvrsna mogućnost za brzo započinjanje rada i isprobavanje različitih stvari.
Međutim, dozvolite. Prevario sam.
- Hoće li Hibernate zaista primijeniti definiciju ovog imenovanog primarnog ključa?
- Hoće li Hibernate stvoriti indeks u NASLOVU? – Sigurno znam da će nam biti potreban.
- Hoće li Hibernate sigurno učiniti ovaj ključ identifikacijskim u Specifikaciji identiteta?
Vjerojatno ne. Ako razvijate svoj projekt od nule, uvijek je zgodno jednostavno odbaciti staru bazu podataka i generirati novu, čim dodate potrebne anotacije. Tako će entitet Book na kraju izgledati ovako:
	@Entity
@Table(name = "book", indexes = {
  @Index(name = "i_book_title", columnList = "title")
})
class Book {
  @Id
  @GeneratedValue(strategy = IDENTITY)
  int id;
  String title;
}
Super. Ponovno generirati. Ponovno, u tom slučaju, na početku će biti vrlo lako.
Ali kasnije ćete za to morati platiti.
Pr sooner ili kasnije morat ćete preći u produkciju. Tada će takav model prestati raditi. Zato što:
U produkciji više nećete moći odbaciti staru bazu podataka i početi iznova s čistog lista. Vaša baza podataka postat će naslijeđena.
Od sada i zauvijek morat ćete pisati . A što će se tada dogoditi s vašim entitetima? Možete ih ili prilagoditi ručno (i tako povećati svoj radni opseg), ili narediti Hibernateu da ih ponovno generira za vas (kolike su šanse da će generirani entiteti odgovarati vašim očekivanjima?) U svakom slučaju gubite.
Tako da, čim pređete u produkciju, trebaju vam hitne ispravke. A one se moraju isporučiti u produkciju vrlo brzo. Budući da se niste pripremili i organizirali glatku proizvodnu liniju za vaše migracije, sve ćete ga patchevati. A onda nećete stići sve učiniti ispravno. I krivite Hibernate, jer je uvijek kriv netko drugi osim vas…
Umjesto toga, od samog početka sve se moglo raditi sasvim drugačije. Na primjer, staviti okrugle kotače na bicikl.
Prvo baza podataka.
Prava "istina" u shemi vaše baze podataka i "suverenitet" nad njom leži unutar baze podataka. Shema se određuje samo u samoj bazi podataka i nigdje drugdje, i svaki od klijenata ima kopiju te sheme, stoga je potpuno razumno nametati poštivanje sheme i njene cjelovitosti točno u bazi podataka - tamo gdje se podaci i pohranjuju.
To je stara, čak i potrošena mudrost. Primarni i jedinstveni ključevi - to je dobro. Vanjski ključevi - dobro. Provjera ograničenja - dobro. - dobro.
I to nije sve. Na primjer, koristeći Oracle, vjerojatno ćete htjeti navesti:
- U kojem tablespace-u se nalazi vaša tablica
- Koja je njezina vrijednost PCTFREE
- Kolika je veličina cache-a u vašoj sekvenci (za identifikatorom)
Možda sve ovo nije bitno za male sustave, ali ne morate čekati prelazak u područje "velikih podataka" — možete početi koristiti prednosti optimizacija pohrane podataka od strane dobavljača, kao što su spomenute. Nijedna ORM koju sam vidio (uključujući jOOQ) ne pruža pristup cjelokupnom skupu DDL opcija koje možda želite koristiti u svojoj bazi podataka. ORM nudi neke alate koji pomažu u pisanju DDL-a.
Ali, na kraju, dobro projektirana shema je ručno napisana u DDL-u. Svaki generirani DDL je samo njega aproksimacija.
Što je s klijentskim modelom?
Kao što je ranije spomenuto, na klijentu će vam trebati kopija sheme vaše baze podataka, klijentska predstavnost. Suvišno je reći da ova klijentska predstavnost mora biti sinkronizirana s pravim modelom. Kako to najbolje postići? Pomoću generatora koda.
Sve baze podataka pružaju svoju metainformaciju putem SQL-a. Evo kako dobiti sve tablice iz vaše baze podataka na različitim SQL dijalektima:
	-- H2, HSQLDB, MySQL, PostgreSQL, SQL Server
SELECT table_schema, table_name
FROM information_schema.tables

-- DB2
SELECT tabschema, tabname
FROM syscat.tables

-- Oracle
SELECT owner, table_name
FROM all_tables

-- SQLite
SELECT name
FROM sqlite_master

-- Teradata
SELECT databasename, tablename
FROM dbc.tables
Ovi upiti (ili slični, ovisno o tome uzimate li u obzir i prikaze, materializirane prikaze, funkcije s tabličnim vrijednostima) također se izvršavaju pomoću poziva iz JDBC-a, ili pomoću meta-modula jOOQ.
Iz rezultata tih upita relativno je lako generirati bilo koju klijentsku predstavnost modela vaše baze podataka, bez obzira na to koja tehnologija se koristi na klijentu.
- Ako koristite JDBC ili Spring, možete stvoriti skup string konstantama
- Ako koristite JPA, možete generirati sami entitete
- Ako koristite jOOQ, možete generirati jOOQ meta-model
Ovisno o tome kakav opseg mogućnosti nudi vaše klijentsko API (npr. jOOQ ili JPA), generirani meta-model može biti stvarno bogat i sveobuhvatan. Uzmimo, na primjer, mogućnost neizravnih spajanja, , koja se oslanja na generirane metainformacije o odnosima vanjskih ključeva koji djeluju između vaših tablica.
Sada će svaka promjena u bazi podataka automatski dovesti do ažuriranja klijentskog koda. Zamislite, na primjer:
ALTER TABLE book RENAME COLUMN title TO book_title;Doista biste željeli raditi taj posao dvaput? Ni u kojem slučaju. Samo zabilježite DDL, prođite ga kroz vaš gradbeni sustav i dobit ćete ažuriranu entitet:
@Entity
@Table(name = "book", indexes = {

  // Jeste li o tome razmišljali?
  @Index(name = "i_book_title", columnList = "book_title")
})
class Book {
  @Id
  @GeneratedValue(strategy = IDENTITY)
  int id;

  @Column("book_title")
  String bookTitle;
}
Ili ažurirana klasa jOOQ. Većina promjena DDL također se odražava na semantici, a ne samo na sintaksi. Stoga je korisno pogledati u kompajlirani kod koji će (ili može biti) zahvaćen promjenom vaše baze podataka.
Jedina istina
Bez obzira na tehnologiju koju koristite, uvijek postoji jedan model koji predstavlja jedini izvor istine za neku podsustavu – ili, barem, trebali bismo težiti tome i izbjegavati takvu poduzetničku zbrku gdje je "istina" odmah svugdje i nigdje. Sve može biti mnogo jednostavnije. Ako samo razmjenjujete XML datoteke s nekom drugom sustavom, jednostavno koristite XSD. Pogledajte metamodel INFORMATION_SCHEMA iz jOOQ u XML formatu:
- XSD je dobro razumljiv
- XSD vrlo dobro označava sadržaj XML-a i omogućuje validaciju na svim klijentskim jezicima
- XSD se dobro verzionira i ima razvijenu unazadnu kompatibilnost
- XSD se može prevesti u Java kod pomoću XJC
Posljednja točka je važna. Kada komuniciramo s vanjskim sustavima putem XML poruka, želimo biti sigurni u validnost naših poruka. To je vrlo lako postići pomoću JAXB, XJC i XSD. Bilo bi potpuno ludilo očekivati da će se u pristupu dizajnu "najprije Java", gdje stvaramo naše poruke kao Java objekte, one na neki način razumno mapirati na XML i poslati za korištenje u drugom sustavu. XML generiran na taj način bio bi vrlo loše kvalitete, nedovoljno dokumentiran i teško bi se razvijao. Kada bi postojala SLA za takav sučelje, odmah bismo je pokvarili.
Iskreno, upravo se to neprekidno događa s API-jem na JSON, ali to je već druga priča, sljedeći put ću se ljutiti…
Baze podataka: to je isto
Kada radite s bazama podataka, shvaćate da su sve one, u načelu, slične. Baza posjeduje svoje podatke i treba upravljati shemom. Sve modifikacije u shemi trebaju se provoditi izravno na DDL-u kako bi se ažurirao jedinstveni izvor istine.
Kada se ažurira izvor, svi klijenti također moraju ažurirati svoje kopije modela. Neki klijenti mogu biti napisani na Javi koristeći jOOQ i Hibernate ili JDBC (ili sve zajedno). Drugi klijenti mogu biti napisani u Perlu (sretno im), treći u C#. Nije važno. Glavni model se nalazi u bazi podataka. Modeli generirani pomoću ORM obično su loše kvalitete, slabo dokumentirani i teški za razvoj.
Zato nemojte praviti greške. Od samog početka ne pravite greške. Radite na osnovi baze podataka. Izgradite takav pipeline za implementaciju koji se može automatizirati. Uključite generatore koda kako biste lako mogli kopirati model vaše baze podataka i prenijeti ga na klijente. I prestanite brinuti o generatorima koda. Oni su dobri. S njima ćete postati produktivniji. Trebate samo na početku potrošiti malo vremena na njihovo podešavanje – i zatim vas očekuju godine povećane produktivnosti, od kojih će se sastojati povijest vašeg projekta.
Za sada ne zahvaljujte, kasnije.
Objašnjenje
Za jasnoću: Ovaj članak nikako ne promovira ideju da se cijeli sustav (tj. predmetno područje, poslovna logika itd.) mora prilagoditi modelu vaše baze podataka. U ovom članku govorim o tome da klijentski kod koji komunicira s bazom podataka treba djelovati temeljem modela baze podataka, tako da se u njemu samom ne replicira model baze podataka kao "prvi razred". Takva logika obično se nalazi na razini pristupa podacima na strani klijenta.
U dvostranim arhitekturama, koje su još uvijek prisutne u nekim mjestima, takav model sustava može biti jedini mogući. Međutim, u većini sustava razina pristupa podacima mi se čini kao "pod sustav", koji enkapsulira model baze podataka.
Izuzeci
Svakoj pravilu postoje izuzeci, i već sam spomenuo da pristup s primarnošću baze podataka i generiranjem izvornog koda ponekad može biti neprimjeren. Evo nekoliko takvih izuzetaka (vjerojatno postoje i drugi):
- Kada je shema nepoznata i treba je otkriti. Na primjer, vi ste davatelj alata koji pomaže korisnicima da se orijentiraju u bilo kojoj shemi. Uf. Ovdje je potrebno generirati kod. No, opet – baza podataka prije svega.
- Kada shema treba biti generirana u hodu za rješavanje određenog zadatka. Ovaj primjer izgleda kao malo pretjerana verzija obrasca , tj. stvarno nemate jasno definiranu shemu. U ovom slučaju, često se ne može biti siguran hoće li vam odgovarati RDBMS.
Izuzeci su po prirodi iznimni. U većini slučajeva povezanih s korištenjem RDBMS-a, shema je unaprijed poznata, smještena unutar RDBMS-a i predstavlja jedini izvor "istine", dok svi klijenti moraju imati kopije, izvedene iz nje. U idealnom slučaju, pri tome bi trebalo koristiti generator koda.
Izvor: habr.com
