

Pozdravljamo vas, Habr!
U svoje vreme, prvi smo uveli temu i nastavljamo njezin razvoj. Konkretno, činilo nam se zanimljivom tema interakcije između Kafke i . Pregledna (i prilično oprezna) o ovoj temi objavljena je u blogu kompanije Confluent još u oktobru prošle godine, pod autorstvom Gwen Shapire. Danas želimo skrenuti vašu pažnju na noviji, aprilski članak Johann Gygera, koji, iako se nije ustručavao postaviti pitanje u naslovu, ovu temu proučava u konkretnijem kontekstu, prateći tekst zanimljivim linkovima. Molimo vas da oprostite naš slobodan prevod 'chaos monkey', ako možete!
Uvod
Kubernetes je namenjen za rad s radnim opterećenjima koja ne čuvaju stanje. Obično su takva radna opterećenja predstavljena u obliku mikroservisne arhitekture, lagana su, dobro se horizontalno skaliraju, podlažu principima 12-faktorskih aplikacija, omogućuju rad s automatskim prekidačima (circuit breaker) i majmunima haosa (chaos monkeys).
Kafka, koja se nalazi s druge strane, u suštini deluje kao distribuirana baza podataka. Stoga, prilikom rada, morate se nositi sa stanjem, a ono je mnogo teže od mikroservisa. Kubernetes podržava opterećenja s očuvanjem stanja, ali, kako ukazuje Kelsey Hightower u dva svoja tvita, s njima treba postupati oprezno:
Nekima se čini da ako se primeni Kubernetes na opterećenje s očuvanjem stanja, on postaje potpuno upravljana baza podataka, sposobna da konkuriše RDS-u. To nije tačno. Možda, ako dovoljno uložite truda, dodate dodatne komponente i okupite tim SRE inženjera, može se uspostaviti RDS preko Kubernetesa.
Uvek svim preporučujem da budu izuzetno oprezni prilikom pokretanja opterećenja s očuvanjem stanja na Kubernetesu. Većina onih koji se pitaju 'Mogu li pokrenuti opterećenja s očuvanjem stanja na Kubernetesu' nemaju dovoljno iskustva u radu s Kubernetesom, a često ni s onim opterećenjem o kojem pitaju.
Dakle, treba li pokrenuti Kafka na Kubernetesu? Uzvratno pitanje: hoće li Kafka bolje raditi bez Kubernetesa? Zato želim istaknuti u ovom članku kako se Kafka i Kubernetes međusobno dopunjuju, te koje zamke mogu nastati pri njihovom kombiniranju.
Vrijeme izvršavanja
Hajdemo razgovarati o osnovnoj stvari — runtime okruženju kao takvom
Proces
Kafka brokeri su pogodni za rad s CPU-om. TLS može donijeti određene troškove. Međutim, Kafka klijenti mogu više opteretiti CPU ako koriste enkripciju, ali to ne utječe na brokere.
Memorija
Kafka brokeri troše memoriju. Veličina heap-a JVM-a obično bi bila ograničena na 4–5 GB, ali trebat ćete i puno sistemske memorije, jer Kafka vrlo aktivno koristi stranice predmemorije. Na Kubernetesu pravilno postavite limit na resurse i zahtjeve kontejnera.
Skladište podataka
Skladište podataka u kontejnerima je efemerno – podaci se gube prilikom ponovnog pokretanja. Za podatke Kafke možete koristiti volumen emptyDir, a učinak će biti sličan: podaci vašeg brokera bit će izgubljeni nakon završetka. Vaše poruke još uvijek mogu ostati sačuvane na drugim brokerima kao replike. Stoga, nakon ponovnog pokretanja, neispravan broker treba prvo replicirati sve podatke, a taj proces može potrajati.
Zato je važno koristiti trajno skladište podataka. Neka to bude nelokalno trajno skladište s datotečnim sustavom XFS ili, preciznije, ext4. Ne koristite NFS. Upozoravam vas. NFS verzije v3 ili v4 neće raditi. Ukratko, broker Kafke će se srušiti ako ne može izbrisati katalog s podacima zbog problema s "glupim preimenovanjima" koja su aktualna kod NFS-a. Ako vas još nisam uvjerio, vrlo pažljivo . Skladište podataka treba biti nelokalno kako bi Kubernetes mogao fleksibilnije odabrati novi čvor nakon ponovnog pokretanja ili relokacije.
Mreža
Kao i u većini distribuiranih sustava, performanse Kafke u velikoj mjeri ovise o tome da su latencije u mreži minimalne, a propusnost maksimalna. Ne pokušavajte smjestiti sve brokere na isti čvor, jer će to smanjiti dostupnost. Ako se čvor Kubernetes-a sruši, cijeli klaster Kafka će se srušiti. Također, ne raspršujte klaster Kafka po cijelim data centrima. Ista stvar vrijedi i za klaster Kubernetes. Dobar kompromis u ovom slučaju je odabrati različite zone dostupnosti.
Konfiguracija
Uobičajeni manifesti
Na web stranici Kubernetes postoji o tome kako konfigurirati ZooKeeper pomoću manifestacija. Budući da ZooKeeper dolazi s Kakfom, to je odlična polazna točka za upoznavanje s konceptima Kubernetes-a koji se ovdje primjenjuju. Kada se s tim upoznate, moći ćete primijeniti iste koncepte i na klaster Kafka.
- Pod: pod – to je minimalna jedinica koja se može rasporediti u Kubernetes-u. U podu se nalazi vaša radna opterećenja, a sam pod odgovara procesu u vašem klasteru. U podu se može nalaziti jedan ili više kontejnera. Svaki ZooKeeper poslužitelj u ansamblu i svaki broker u klasteru Kafka radit će u zasebnom podu.
- StatefulSet: StatefulSet – to je Kubernetes objekt koji radi s više radnih opterećenja koja održavaju stanje, a takva opterećenja zahtijevaju koordinaciju. StatefulSet pruža jamstva o redoslijedu podova i njihovoj jedinstvenosti.
- Beheadless usluge: Usluge omogućuju odvezivanje podova od klijenata putem logičkog imena. U ovom slučaju, Kubernetes je odgovoran za ravnotežu opterećenja. Međutim, prilikom rada s radnim opterećenjima koja održavaju stanje, kao što su ZooKeeper i Kafka, klijentima je potrebno razmjenjivati informacije s određenim instancama. Tu će vam pomoći beheadless usluge: na taj način klijent će imati logičko ime, ali se neće morati direktno obraćati podu.
- Volume za dugotrajno pohranjivanje: takvi volumeni su potrebni za konfiguraciju nelokalnog blokovnog dugotrajnog skladišta, koje je prethodno spomenuto.
Na nudi opsežan skup manifestacija koje olakšavaju rad s Kafkom na Kubernetes-u.
Helm dijagrami
Helm je upravitelj paketa za Kubernetes koji se može usporediti s upraviteljima paketa za operacijske sustave, kao što su yum, apt, Homebrew ili Chocolatey. Uz njegovu pomoć jednostavno je instalirati unaprijed definirane programske pakete opisane u Helm dijagramima. Dobro pripremljeni Helm dijagram olakšava složen zadatak: kako pravilno konfigurirati sve parametre za korištenje Kafke na Kubernetesu. Postoji nekoliko dijagrama Kafke: službeni je u , postoji jedan od , još jedan – od .
Operatori
Budući da Helm ima određene nedostatke, sve veću popularnost stiče još jedno sredstvo: operatori Kubernetesa. Operator ne samo da pakira softver za Kubernetes, već vam omogućava da taj softver postavite i njime upravljate.
Na popisu spominju se dva operatora za Kafku. Jedan od njih je . Uz pomoć Strimzija nije teško pokrenuti Kafkin klaster u nekoliko minuta. Gotovo nikakva konfiguracija nije potrebna, osim toga, sam operator nudi nekoliko korisnih mogućnosti, poput TLS enkripcije tipa "točka-do-točke" unutar klastera. Confluent također pruža .
Performanse
Vrlo je važno testirati performanse opskrbljujući vaš instalirani primjerak Kafke kontrolnim točkama. Takva testiranja pomoći će vam da otkrijete potencijalna uska grla prije nego što nastanu problemi. Srećom, u Kafki su već dostupna dva alata za testiranje performansi: kafka-producer-perf-test.sh i kafka-consumer-perf-test.sh. Aktivno ih koristite. Za referencu možete se osloniti na rezultate opisane u Jaya Krepsa ili se orijentirati na Amazon MSK od Stéphane Maarek.
Operacije
Monitoring
Transparentnost u sustavu je vrlo važna – inače nećete shvatiti što se u njemu događa. Danas postoji solidan alat za praćenje temeljen na metrima u stilu cloud native. Dva popularna alata za ovu svrhu su Prometheus i Grafana. Prometheus može prikupljati metrike sa svih Java procesa (Kafka, Zookeeper, Kafka Connect) putem JMX eksportera – na najjednostavniji način. Ako dodate metrike cAdvisor, moći ćete bolje razumjeti kako se resursi koriste u Kubernetesu.
Strimzi ima vrlo praktčan primer Grafana nadzornog panela za Kafka. Prikazuje ključne metrike, poput nedovoljno replikovanih delova ili onih koji su izvan mreže. Sve je veoma jasno. Ove metrike se dopunjuju podacima o korišćenju resursa i performansama, kao i indikatorima stabilnosti. Na taj način dobijate osnovni nadzor klastera Kafka besplatno!
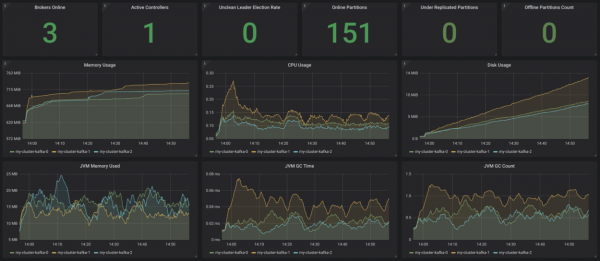
Izvor:
Sve to bi bilo dobro dopuniti nadzorom klijenata (metrike o potrošačima i proizvođačima), kao i nadzorom kašnjenja (za to postoji ) i sveobuhvatnim nadzorom – za to koristite .
Logiranje
Logovanje je još jedan važan zadatak. Uverite se da se svi kontejneri u vašoj Kafka instalaciji loguju u stdout i stderr, i takođe obezbedite da vaš Kubernetes klaster agregira sve logove u centralnoj infrastrukturi za logovanje, na primer, u .
Proveravanje funkcionalnosti
Kubernetes koristi 'liveness' i 'readiness' probe kako bi proverio da li vaši podovi rade normalno. Ako proba za 'liveness' ne uspe, Kubernetes će zaustaviti taj kontejner, a zatim ga automatski ponovo pokrenuti ako je politika ponovnog pokretanja postavljena adekvatno. Ako proba za 'readiness' ne uspe, Kubernetes će izolovati taj pod od obrade zahteva. Na taj način u takvim slučajevima nije potrebno ručno intervenisati, što je velika prednost.
Izbacivanje ažuriranja
StatefulSet podržava automatska ažuriranja: pri izboru strategije RollingUpdate, svaki pod Kafka će se ažurirati redom. Na taj način se može svesti trajanje zastoja na nulu.
Skaliranje
Skaliranje klastera Kafka nije lak zadatak. Međutim, u Kubernetesu je veoma lako skalirati podove do određenog broja replika, što znači da možete deklarativno odrediti onoliko Kafka brokera koliko želite. Najteži deo u ovom slučaju je preusmeravanje sektora nakon skaliranja na više ili pre skaliranja na manje. Ponovo, u ovoj zadatku pomoći će vam Kubernetes.
Administracija
Zadaci vezani uz administraciju vašeg Kafka klastera, posebno kreiranje tema i ponovna dodela sektora, mogu se obavljati pomoću dostupnih shell skripti, otvaranjem komandne linije u vašim podovima. Međutim, ovo rešenje nije posebno elegantno. Strimzi podržava upravljanje temama putem drugog operatora. Ovdje ima što doraditi.
Izrada rezervnih kopija i obnova
Sada će dostupnost Kafke zavisiti i od dostupnosti Kubernetesa. Ako vam padne klaster Kubernetes, u najgorem slučaju pasti će i klaster Kafka. Prema Murphyjevom zakonu, to će se sigurno dogoditi i izgubićete podatke. Da biste smanjili rizik od takvih situacija, dobro obradite koncept rezervnog kopiranja. Možete koristiti MirrorMaker, a druga opcija je da za to angažujete S3, kao što je opisano u ovom od Zalanda.
Zaključak
Kada radite s malim ili srednjim klasterima Kafke, svakako je korisno koristiti Kubernetes, jer on pruža dodatnu fleksibilnost i olakšava rad s operatorima. Ako imate vrlo ozbiljne nefunkcionalne zahteve u vezi s kašnjenjem i/ili propusnošću, možda bi bilo bolje razmotriti neku drugu opciju implementacije.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish