

U ovom članku objašnjavamo kako i zašto smo razvili – mehanizam koji prenosi informacije između klijentskih aplikacija i 1C:Enterprise poslužitelja – od postavljanja zadatka do razmatranja arhitekture i detalja implementacije.
Sustav Interakcije (dalje – SI) je distribuirani sustav razmjene poruka otporan na greške s garantiranom isporukom. SI je dizajniran kao visoko opterećen servis s visokom skalabilnošću, dostupan je kao online servis (nudi ga tvrtka 1C) i kao licencirani proizvod koji se može instalirati na vlastitim poslužiteljskim resursima.
SI koristi distribuiranu pohranu i pretraživački sustav . Također ćemo razgovarati o Javi i o tome kako horizontalno skaliramo PostgreSQL.
Postavljanje zadatka
Da bi bilo jasno zašto smo napravili Sustav Interakcije, reći ću malo o tome kako je organiziran razvoj poslovnih aplikacija u 1C.
Za početak – malo o nama za one koji još ne znaju čime se bavimo :) Radimo na tehnološkoj platformi „1C:Enterprise”. Platforma uključuje alat za razvoj poslovnih aplikacija, kao i runtime koji omogućuje poslovnim aplikacijama rad u okruženju koje podržava više platformi.
Klijent-poslužitelj paradigma razvoja
Poslovne aplikacije razvijene na „1C:Enterprise” rade u trostupanjskoj arhitekturi „DBMS – poslužiteljski server – klijent”. Aplikacijski kod napisan na , može se izvršavati na poslužitelju aplikacija ili na klijentu. Sav rad s aplikacijskim objektima (referencama, dokumentima itd.), kao i čitanje i zapisivanje u bazu podataka obavlja se samo na poslužitelju. Funkcionalnost obrazaca i komandnog sučelja također je ostvaren na poslužitelju. Na klijentu se izvršava dobivanje, otvaranje i prikaz obrazaca, „komunikacija” s korisnikom (upozorenja, pitanja…), manji proračuni unutar obrazaca koji zahtijevaju brzu reakciju (na primjer, množenje cijene s količinom), rad s lokalnim datotekama, rad s opremom.
U aplikacijskom kodu, u naslovima procedura i funkcija, treba izričito navesti gdje će se kod izvršavati – pomoću direktiva &НаКлиенте / &НаСервере (&AtClient / &AtServer u engleskoj verziji jezika). Programeri na 1C će me sada ispraviti, rekavši da direktive u stvarnosti , ali to za nas trenutno nije bitno.
Iz klijentskog koda može se pozvati serverski kod, ali iz serverskog koda nije moguće pozvati klijentski. Ovo je temeljno ograničenje koje smo postavili iz više razloga. Konkretno, zato što serverski kod treba biti napisan tako da se izvršava identično, bez obzira odakle ga pozvali – iz klijenta ili iz servera. U slučaju poziva serverskog koda iz drugog serverskog koda, klijent kao takav ne postoji. A takođe, tokom izvršavanja serverskog koda klijent koji ga je pozvao mogao je zatvoriti aplikaciju, i server više nema koga pozvati.

Kod koji obrađuje pritisak dugmeta: poziv serverske procedure iz klijenta će funkcionisati, poziv klijentske procedure iz servera – neće.
To znači da, ako želimo da prenesemo poruku u klijentsku aplikaciju sa servera, na primer, da je završeno generisanje "dugotrajnog" izveštaja koji se može pogledati – nemamo takav način. Moramo pribegavati raznim trikovima, na primer, da klijentski kod periodično ispituje server. No, takav pristup opterećuje sistem suvišnim pozivima, a i uopšte deluje neprikladno.
A takođe postoji potreba, na primer, da prilikom dolaznog telefonskog -poziva obavestimo klijentsku aplikaciju, kako bi ona po broju pozivatelja pronašla informacije o njemu u bazi podataka i prikazala korisniku podatke o pozivatelju. Ili, na primer, obavestiti klijentsku aplikaciju kupca prilikom dolaska narudžbe u skladište. U principu, ima mnogo slučajeva u kojima bi ovaj mehanizam bio koristan.
Sama postavka
Kreirati mehanizam za razmenu poruka. Brz, pouzdan, sa garantovanom isporukom, sa mogućnošću fleksibilnog pretraživanja poruka. Na osnovu mehanizma realizovati mesendžer (poruke, video pozivi) koji radi unutar 1C aplikacija.
Dizajnirati sistem horizontalno skalabilnim. Povećano opterećenje treba se pokrivati povećanjem broja nodova.
Implementacija
Server sku odlučili smo ne integrirati izravno u platformu 1C:Poduzeće, već je realizirati kao poseban proizvod čiji API možemo pozivati iz koda aplikacijskih rješenja 1C. To je učinjeno iz više razloga, od kojih je glavni želja omogućiti razmjenu poruka između različitih aplikacija 1C (na primjer, između Upravljanja Trgovinom i Računovodstva). Različite aplikacije 1C mogu raditi na različitim verzijama platforme 1C:Poduzeće, nalaziti se na različitim poslužiteljima itd. U takvim uvjetima, realizacija servera kao posebnog proizvoda, koji je "sa strane" instalacija 1C, predstavlja optimalno rješenje.
Dakle, odlučili smo razvijati server kao poseban proizvod. Malim tvrtkama preporučujemo korištenje servera koji smo postavili u našem oblaku (wss://1cdialog.com), kako bismo izbjegli troškove povezane s lokalnom instalacijom i konfiguracijom servera. Veliki klijenti, međutim, mogli bi smatrati prikladnim instaliranje vlastitog servera na svojim resursima. Sličan pristup koristili smo u našem SaaS proizvodu u oblaku. – objavljuje se kao serijski proizvod za instalaciju kod klijenata, a također je raspoređen u našem oblaku. .
Aplikacija
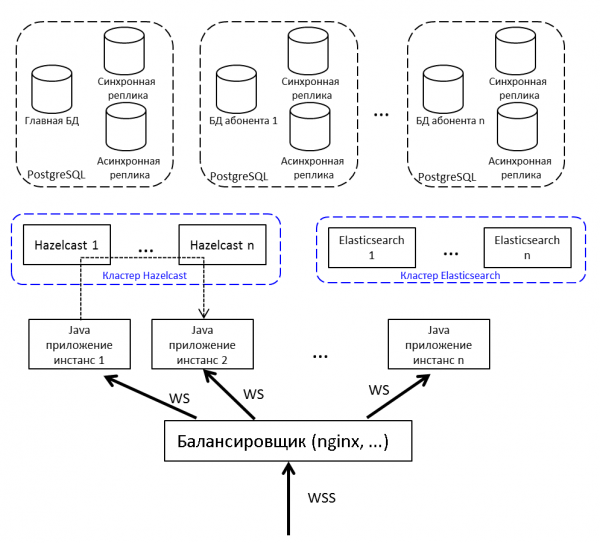
Kako bismo raspodijelili opterećenje i osigurali otpornost na kvarove, nećemo pokrenuti samo jednu Java-aplikaciju, već nekoliko njih, a ispred njih ćemo staviti ravnoteživač opterećenja. Ako je potrebno prenijeti poruku s čvora na čvor – koristimo publish/subscribe u Hazelcastu.
Komunikacija klijenta sa serverom obavlja se putem websocket-a. Ovaj pristup je vrlo prikladan za sustave u stvarnom vremenu.
Raspodijeljeno predmemoriranje
Birali smo između Redis-a, Hazelcast-a i Ehcache-a. Godina je 2015. Redis je upravo objavio novi klaster (previše nov, zastrašujuće), ima Sentinel s mnoštvom ograničenja. Ehcache ne podržava klasteriranje (ta funkcionalnost je uvedena kasnije). Odlučili smo isprobati Hazelcast 3.4.
Hazelcast se klasterira "iz kutije". U načinu jedne čvora nije osobito koristan i može se koristiti samo kao predmemorija – ne zna pohranjivati podatke na disk, ako izgubimo jedini čvor – gubimo podatke. Postavljamo nekoliko Hazelcast instanci, između kojih radimo backup kritičnih podataka. Predmemoriju ne backupiramo – nije žao.
Za nas, Hazelcast je:
- Skladište korisničkih sesija. Svaki put odlaziti po sesiju u bazu – predugo je, pa sve sesije spremamo u Hazelcast.
- Cache. Ako tražite korisnički profil – provjerite u cache-u. Napisali ste novu poruku – stavite je u cache.
- Teme za komunikaciju instanci aplikacije. Čvor generira događaj i smješta ga u Hazelcast temu. Drugi čvorovi aplikacije, koji su pretplaćeni na tu temu, primaju i obrađuju događaj.
- Klaster zaključavanja. Na primjer, stvaramo raspravu po jedinstvenom ključi (singleton rasprava unutar 1C baze):
conversationKeyChecker.check("BENZINSKA_POSTAJA");

      doInClusterLock("BENZINSKA_POSTAJA", () -> {

          conversationKeyChecker.check("BENZINSKA_POSTAJA");

          createChannel("BENZINSKA_POSTAJA");
      });
Provjerili smo da kanal ne postoji. Uzeli smo zaključavanje, ponovno provjerili, stvorili. Ako nakon uzimanja zaključavanja ne provjerite, postoji šansa da je drugi thread u tom trenutku također provjerio i sad pokušava stvoriti istu raspravu – a ona već postoji. Ne može se raditi zaključavanje kroz synchronized ili običan java Lock. Kroz bazu – sporo, a i šteta je za bazu, kroz Hazelcast – to je ono što nam treba.
Biramo DBMS
Imamo veliko i uspješno iskustvo s PostgreSQL i suradnjom s programerima ovog DBMS-a.
S klasterom PostgreSQL nije lako – postoje , , , ali to nije noSQL, koje se skaliraju odmah. NoSQL nismo razmatrali kao glavno skladište, bilo je dovoljno uzeti Hazelcast, s kojim prije nismo radili.
Ako je potrebno skalirati relacijsku bazu podataka – znači . Kao što znate, pri sharding-u dijelimo bazu podataka na odvojene dijelove kako bismo svaku od njih mogli premjestiti na poseban server.
Prva varijanta našeg sharding-a predviđala je mogućnost razdvajanja svake od tablica naše aplikacije po različitim serverima u različitim omjerima. Puno poruka na serveru A – slobodno, premjestimo dio ove tablice na server B. Takvo rješenje jednostavno je vikalo na preranu optimizaciju, pa smo odlučili ograničiti se na multi-tenant pristup.
O multi-tenant-u možete pročitati, na primjer, na stranici .
U SV postoje pojmovi aplikacije i pretplatnika. Aplikacija je konkretna instalacija poslovne aplikacije, poput ERP-a ili Računovodstva, sa svojim korisnicima i poslovnim podacima. Pretplatnik je organizacija ili fizička osoba u ime koje se vrši registracija aplikacije na SV serveru. Pretplatnik može imati registrirane više aplikacija, a te aplikacije mogu razmjenjivati poruke međusobno. Pretplatnik postaje stanar (tenant) u našem sustavu. Poruke više pretplatnika mogu se nalaziti u jednoj fizičkoj bazi; ako primijetimo da neki pretplatnik generira puno prometa – premještamo ga u zasebnu fizičku bazu (ili čak zaseban BD server).
Imamo glavnu BD, gdje se nalazi tablica usmjeravanja s informacijama o lokacijama svih pretplatničkih baza podataka.
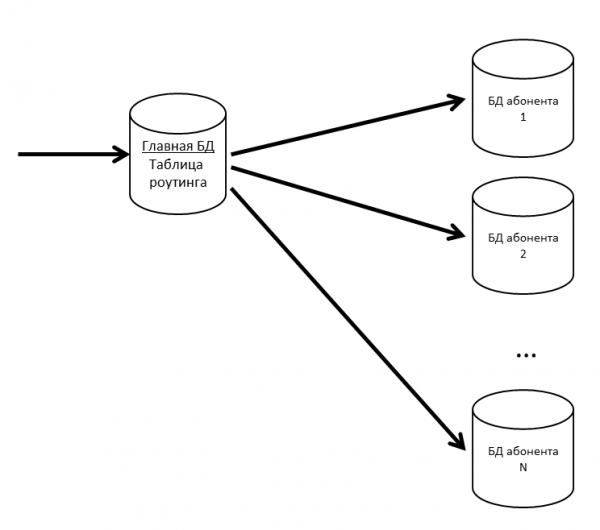
Kako glavna BD ne bi postala usko grlo, tablicu usmjeravanja (i druge često tražene podatke) čuvamo u predmemoriji.
Ako počne usporavati BD pretplatnika, unutar nje ćemo napraviti particije. Na drugim projektima za particioniranje velikih tablica koristimo .
Budući da gubitak poruka korisnika nije dobar, održavamo naše BD replikama. Kombinacija sinkronih i asinkronih replik omogućava nam zaštitu u slučaju gubitka glavne BD. Gubitak poruke će se dogoditi samo u slučaju simultanog otkazivanja glavne BD i njene sinkrone replike.
Ako se izgubi sinkrona replika – asinkrona replika postaje sinkrona.
Ako se izgubi glavna BD – sinkrona replika postaje glavna BD, asinkrona replika – sinkrona replika.
Elasticsearch za pretragu
Budući da, pored ostalog, SV predstavlja i messenger, ovdje je potreban brzi, jednostavni i fleksibilni pretraživač koji uzima u obzir morfologiju, uz neprecizne podudarnosti. Odlučili smo ne izmišljati bicikl i koristiti slobodni pretraživač Elasticsearch, koji je stvoren na temelju biblioteke . Elasticsearch također postavljamo u klaster (master – data – data), kako bismo isključili probleme u slučaju kvara čvorova aplikacije.
Na githubu smo pronašli za Elasticsearch i koristimo ga. U indeksu Elasticsearch pohranjujemo korijene riječi (koje određuje plugin) i N-gramove. Kako korisnik unosi tekst za pretraživanje, tražimo unoseni tekst među N-gramovima. Kada se pohrani u indeks, riječ „tekstovi” će se razbiti na sljedeće N-gramove:
[te, tek, tekst, tekstovi, ek, eks, ekstrem, ekstremi, ks, kst, ksti, st, stovi, ti],
Također će biti pohranjen korijen riječi „tekst”. Takav pristup omogućava pretraživanje i na početku, i na sredini, i na kraju riječi.
Sveukupna slika
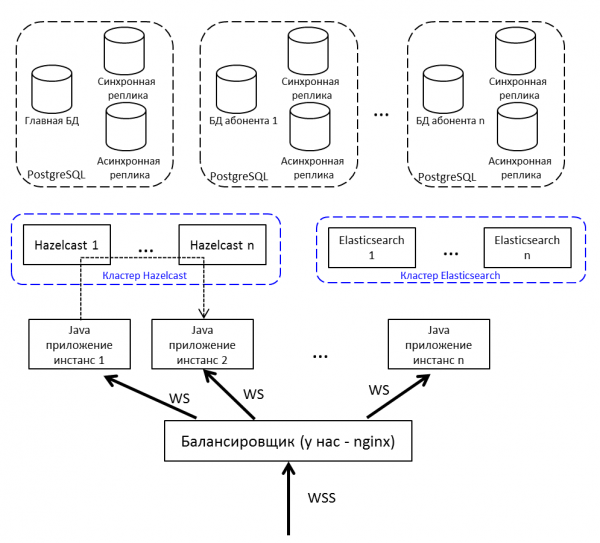
Ponovite sliku s početka članka, ali već s pojašnjenjima:
- Balansirnik izložen na internetu; kod nas – nginx, može biti bilo koji.
- Instanci Java aplikacije komuniciraju međusobno putem Hazelcasta.
- Za rad s web-socketom koristimo .
- Java aplikacija napisana je na Java 8, sastoji se od bundlova . U planu je migracija na Java 10 i prelazak na module.
Razvoj i testiranje
U procesu razvoja i testiranja SV-a naišli smo na niz zanimljivih osobitosti proizvoda koje koristimo.
Opterećenje i curenje memorije
Svako izdanje SV-a je opterećenje. Smatra se uspješnim kada:
- Test je radio nekoliko dana i nije bilo otkazivanja usluge
- Vrijeme odgovora za ključne operacije nije premašilo ugodnu granicu
- Pogoršanje performansi u odnosu na prethodnu verziju nije veće od 10%
Testnu bazu punimo podacima – za to dobivamo informacije s produkcijskog servera o najaktivnijem korisniku, množit ćemo njegove brojke s 5 (broj poruka, rasprava, korisnika) i tako testiramo.
Opterećenje sustava interakcije provodimo u tri konfiguracije:
- Stres test
- Samo veze
- Registracija korisnika
Tijekom stres testa pokrećemo nekoliko stotina niti koje bez stajanja opterećuju sustav: šalju poruke, stvaraju rasprave, dobivaju popis poruka. Imitiramo akcije običnih korisnika (dobiti popis mojih nepročitanih poruka, nekome napisati) i programskih rješenja (prenijeti paket druge konfiguracije, obraditi obavijest).
Na primjer, ovako izgleda dio stres testa:
- U sustav ulazi korisnik
- Traži svoje nepročitane rasprave
- S 50% vjerojatnosti čita poruke
- S 50% vjerojatnosti piše poruke
- Dalje korisnik:
- S 20% vjerojatnosti stvara novu diskusiju
- Slučajno odabire bilo koju od svojih diskusija
- Ulazi unutra
- Zahtijeva poruke, profile korisnika
- Stvara pet poruka upućenih slučajnim korisnicima iz te diskusije
- Ispisuje se iz diskusije
- Ponovljeno 20 puta
- Odjavljuje se, vraća se na početak scenarija
- U sustav ulazi chatbot (emulira razmjenu poruka iz koda aplikacijskih rješenja)
- S 50% vjerojatnosti stvara novi kanal za razmjenu podataka (specijalna diskusija)
- S 50% vjerojatnosti piše poruku u bilo koji od postojećih kanala
Scenarij 'Samo povezivanja' nije se pojavio bez razloga. Postoji situacija: korisnici su povezali sustav, ali nisu se još uključili. Svaki korisnik ujutro u 09:00 uključuje računalo, uspostavlja vezu s poslužiteljem i šuti. Ovi tipovi su opasni, ima ih mnogo – u paketima imaju samo PING/PONG, ali održavaju vezu s poslužiteljem (ne mogu je prekinuti – a što ako stigne nova poruka). Test reproducira situaciju kada se u sustavu pokušava prijaviti veliki broj takvih korisnika u pola sata. Sličan je stres testu, ali fokus mu je upravo na ovom prvom ulazu – kako ne bi bilo odbijanja (čovjek ne koristi sustav, a on već pada – teško je smisliti ništa gore).
Scenarij registracije pretplatnika počinje s prvim pokretanjem. Proveli smo stres test i bili sigurni da u prepisci sustav ne zastaje. No, korisnici su počeli dolaziti i registracija je počela odpadati zbog vremenskih ograničenja. Pri registraciji koristili smo , koji je vezan za entropiju sustava. Poslužitelj nije mogao skupiti dovoljno entropije i pri zahtjevu za novim SecureRandom-om stajao je i do desetak sekundi. Rješenja za ovu situaciju ima mnogo, na primjer: preći na manje siguran /dev/urandom, postaviti posebnu ploču koja generira entropiju, generirati nasumične brojeve unaprijed i čuvati ih u bazenu. Privremeno smo zatvorili problem bazenom, ali od tada provodimo poseban test za registraciju novih pretplatnika.
Kao generator opterećenja koristimo . Ne može raditi s websocketom, potreban je plugin. Prvi u rezultatima pretraživanja za upit 'jmeter websocket' su , u kojima preporučuju .
S njim smo odlučili započeti.
gotovo odmah nakon početka ozbiljnog testiranja, otkrili smo da u JMeteru počinju curenja memorije.
Dodatak je zasebna velika priča, s 176 zvjezdica ima 132 forkova na githubu. Sam autor ne doprinosi od 2015. godine (uzeli smo ga 2015. godine, tada to nije izazvalo sumnju), nekoliko github issue-a o curenjima memorije, 7 neodgovorenih pull requestova.
Ako odlučite provesti stres testiranje pomoću ovog dodatka, obratite pažnju na sljedeće rasprave:
- U višeprocesnom okruženju koristio se obični LinkedList, na kraju smo dobili u runtime-u. Rješava se ili prelaskom na ConcurrentLinkedDeque, ili korištenjem synchronized blokova. Odlučili smo se za prvu opciju ().
- Curenje memorije, prilikom disconecta ne brišu se informacije o vezi ().
- U streaming načinu (kada websocket ne zatvara na kraju uzorka, već se koristi dalje u planu) ne rade Response pattern-i ().
To je jedan od onih na githubu. Što smo napravili:
- Uzimamo (@elyrank) – u njemu su ispravljeni problemi 1 i 3
- Riješen problem 2
- Ažurirali smo jetty s 9.2.14 na 9.3.12
- Obavili smo SimpleDateFormat u ThreadLocal; SimpleDateFormat nije thread-safe, što je dovelo do NPE u runtime-u
- Eliminirali smo još jedno curenje memorije (veza se nije ispravno zatvarala prilikom disconecta)
A opet, curi!
Memorija je počela ponestajati ne nakon dana, već nakon dva. Nismo imali puno vremena, odlučili smo pokrenuti manje procesa, ali na četiri agenta. To bi trebalo biti dovoljno, barem, za tjedan dana.
Prošlo je dva dana...
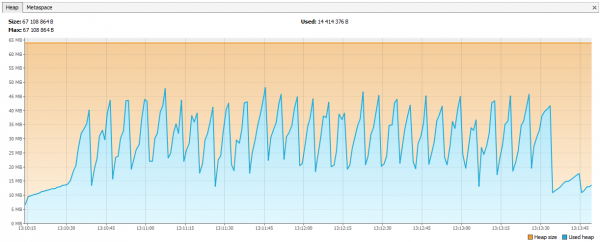
Sada je memorija počela ponestajati na Hazelcast-u. U logovima se moglo vidjeti da nakon nekoliko dana testiranja Hazelcast počinje žaliti na nedostatak memorije, a nakon nekog vremena klaster se ruši, a čvorovi nastavljaju umirati jedan po jedan. Povezali smo JVisualVM s hazelcast-om i vidjeli 'uzlaznu pilu' – redovito je pozivao GC, ali nije mogao očistiti memoriju.
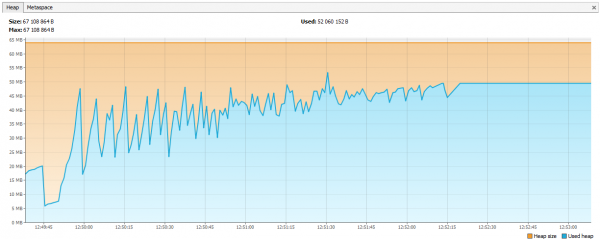
Ispostavilo se da u hazelcast 3.4, prilikom brisanja map / multiMap (map.destroy()), memorija se ne oslobađa potpuno:
Trenutno je greška ispravljena u 3.5, ali tada je to bio problem. Kreirali smo nove multiMap s dinamičkim imenima i brisali prema našoj logici. Kod je izgledao otprilike ovako:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Poziv:
service.join(auth1, "NOVI_POZIVI_U_RASPRAVI_UUID1");
service.join(auth2, "NOVI_POZIVI_U_RASPRAVI_UUID1");
multiMap je stvaran za svaku pretplatu i uklanjan kada nije bio potreban. Odlučili smo uvesti Map, gdje će ključno ime biti naziv pretplate, a vrijednosti identifikatori sesija (prema kojima se mogu dobiti identifikatori korisnika ako je potrebno).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Grafikon se popravio.
Što smo još saznali o testiranju opterećenja
- JSR223 treba pisati na groovyju i uključiti compilation cache – to je znatno brže. .
- Grafikon Jmeter-Plugins je lakše razumjeti od standardnih. .
Naše iskustvo s Hazelcastom
Hazelcast je za nas bio novi proizvod, počeli smo raditi s njim od verzije 3.4.1, a sada na našem produkcijskom poslužitelju je verzija 3.9.2 (u trenutku pisanja članka, posljednja verzija Hazelcast-a bila je 3.10).
Generiranje ID-a
Počeli smo s cjelobrojnim identifikatorima. Pretpostavimo da nam je potreban još jedan Long za novu entitet. Sequence u bazi podataka ne odgovara, tablice sudjeluju u shardingu – dogodit će se da postoji poruka ID=1 u DB1 i poruka ID=1 u DB2, u Elasticsearchu takav ID ne možeš pohraniti, niti u Hazelcastu, ali najgore je ako odlučite spojiti podatke iz dvije baze u jednu (na primjer, odlučivši da je jedna baza dovoljna za te pretplatnike). Možete stvoriti nekoliko AtomicLong u Hazelcastu i držati brojnik tamo, tada će performanse dobivanja novog ID-a – incrementAndGet plus vrijeme na zahtjev u Hazelcast. No, u Hazelcastu postoji nešto optimiziranije – FlakeIdGenerator. Svakom klijentu prilikom pristupa dodjeljuje se raspon ID-a, na primjer, prvom – od 1 do 10 000, drugom – od 10 001 do 20 000 i tako dalje. Sada klijent može izdavati nove identifikatore samostalno sve dok se ne ispuni dodijeljeni raspon. Radi brzo, ali pri ponovnom pokretanju aplikacije (i Hazelcast klijenta) počinje nova sekvenca – odavde odlazi i tako dalje. Također, programerima nije baš jasno zašto su ID-ovi cjelobrojni, ali idu tako jako nasumice. Sve smo to razmotrili i prešli na UUID-ove.
Usput, za one koji žele biti poput Twittera, postoji biblioteka Snowcast – to je implementacija Snowflake preko Hazelcasta. Možete je pogledati ovdje:
No, do toga mi već nije bilo stalo.
TransactionalMap.replace
Još jedno iznenađenje: TransactionalMap.replace ne radi. Evo takvog testa:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Očekivano: newValue
Stvarno: oldValue
Morao sam napisati svoj vlastiti replace, koristeći getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Zamjena vrijednosti u transakcijskoj mapi");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Zamjena vrijednosti u ne-transakcijskoj mapi");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Testirajte ne samo obične strukture podataka, već i njihove transakcijske verzije. Ponekad IMap radi, dok TransactionalMap već ne radi.
Postaviti novi JAR bez zastoja
Prvo smo odlučili zapisivati u Hazelcast objekte svojih klasa. Na primjer, imamo klasu Application, želimo je spremiti i pročitati. Spremamo:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Čitamo:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Sve funkcionira. Potom smo odlučili izgraditi indeks u Hazelcastu kako bismo tražili prema njemu:
map.addIndex("subscriberId", false);I prilikom zapisivanja nove entiteta počeli smo dobivati ClassNotFoundException. Hazelcast je pokušavao nadopuniti indeks, ali nije znao ništa o našoj klasi i htio da mu damo JAR s tom klasom. Tako smo i učinili, sve je proradilo, ali se pojavio novi problem: kako ažurirati JAR bez potpune obustave klastera? Hazelcast ne prepoznaje novi JAR prilikom nadogradnje. U tom trenutku smo odlučili da možemo živjeti bez pretraživanja po indeksu. Naime, ako koristimo Hazelcast kao skladište tipa ključ-vrijednost, onda bi sve trebalo raditi? Ne baš. Tu se ponašanje IMap i TransactionalMap ponovo razlikuje. Tamo gdje je IMap-u svejedno, TransactionalMap daje grešku.
IMap. Spremamo 5000 objekata, čitamo. Sve očekivano.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
A u transakciji ne radi, dobijamo ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
U verziji 3.8 uveden je mehanizam User Class Deployment. Možete odrediti jednu glavnu čvor i ažurirati JAR datoteku na njoj.
Sada smo potpuno promenili pristup: sami serijalizujemo u JSON i čuvamo u Hazelcastu. Hazelcastu nije potrebna struktura naših klasa, a mi se možemo ažurirati bez zastoja. Verzionarstvo domena objekata kontrolira aplikacija. U isto vreme mogu se pokrenuti različite verzije aplikacije, i može se desiti situacija da nova aplikacija upisuje objekte sa novim poljima, dok stara aplikacija o tim poljima još ne zna. I istovremeno nova aplikacija čita objekte koje je upisala stara aplikacija, a koji nemaju nova polja. Takve situacije obrađujemo unutar aplikacije, ali radi jednostavnosti ne menjamo i ne brišemo polja, već samo proširujemo klase dodavanjem novih polja.
Kako obezbeđujemo visoke performanse
Četiri poziva u Hazelcast – dobro, dva u Bazu podataka – loše
Prikupljati podatke iz keša uvijek je bolje nego iz Baze Podataka, ali ne želimo ni čuvati nepotrebne zapise. Odluku o tome što keširati odgađamo za posljednju fazu razvoja. Kada je nova funkcionalnost kodirana, uključujemo u PostgreSQL logiranje svih upita (log_min_duration_statement na 0) i pokrećemo stresno testiranje na 20 minuta. Na temelju prikupljenih logova alati poput pgFouine i pgBadger mogu generirati analitičke izvještaje. U izvještajima prvo tražimo spore i učestale upite. Za spore upite izrađujemo plan izvršenja (EXPLAIN) i procjenjujemo možemo li ubrzati takav upit. Učesti upiti s istim ulaznim podacima dobro se smještaju u keš. Trudimo se da upite održimo "ravnima", po jednu tablicu u upitu.
Eksploatacija
SV kao online usluga pokrenuta je u proljeće 2017. godine, kao zaseban proizvod SV je izašao u studenom 2017. (tada u statusu beta verzije).
Više od godine dana korištenja, ozbiljnih problema u radu online usluge SV nije bilo. Online uslugu pratimo kroz , prikupljamo i implementiramo iz .
Distribucija servera SV dolazi u obliku nativnih paketa: RPM, DEB, MSI. Osim toga, za Windows pružamo jedinstveni instalater u obliku jednog EXE, koji instalira server, Hazelcast i Elasticsearch na jednoj mašini. U početku smo ovu verziju instalacije nazivali "demonstracijskom", ali sada je jasno da je to najpopularnija opcija implementacije.
Izvor: habr.com
