

Zovem se Pavel Parkhomenko, ja sam ML razvijač. U ovom članku želim govoriti o strukturi usluge Yandex.Zen i podijeliti tehnička poboljšanja koja su omogućila poboljšanje kvalitete preporuka. Iz ovog posta saznat ćete kako u samo nekoliko milisekundi pronaći među milijunima dokumenata one najrelevantnije za korisnika; kako izvršiti kontinuiranu dekompoziciju velike matrice (sastojeći se od milijuna kolona i desetaka milijuna redova), tako da novi dokumenti dobiju svoj vektor za desetke minuta; kako ponovo iskoristiti dekompoziciju matrice korisnik-artikl, kako bismo dobili dobro vektorsko predstavljanje za video.
Naša preporučena baza sadrži milijune dokumenata različitih formata: tekstualni članci stvoreni na našoj platformi i uzeti s vanjskih sajtova, video, narativi i kratki postovi. Razvoj ovakve usluge povezan je s velikim brojem tehničkih izazova. Evo nekoliko od njih:
- Podijeliti računalne zadatke: sve teške operacije obaviti izvan mreže, dok u stvarnom vremenu izvršavamo samo brzo primjenjivanje modela kako bismo odgovarali u 100-200 ms.
- Brzo uzimati u obzir postupke korisnika. Za to je potrebno da svi događaji odmah budu isporučeni u preporučivač i utjecali na rezultat rada modela.
- Učinite feed takvim da se brzo prilagođava ponašanju novih korisnika. Ljudi koji su upravo stigli u sustav trebaju osjećati da njihov povratak utječe na preporuke.
- Brzo razumjeti kome preporučiti novi članak.
- Odmah reagirati na stalni priljev novog sadržaja. Desetci tisuća članaka izlaze svaki dan, a mnogi od njih imaju ograničen rok trajanja (recimo, vijesti). To ih razlikuje od filmova, muzike i drugog dugotrajnog i skupog sadržaja za stvaranje.
- Prenijeti znanje s jedne domene na drugu. Ako u preporučivačkom sustavu postoje obučeni modeli za tekstualne članke i dodajemo video, možemo ponovo iskoristiti postojeće modele kako bi sadržaj novog tipa bio bolje rangiran.
Ispričat ću vam kako smo rješavali ove zadatke.
Odabir kandidata
Kako u nekoliko milisekundi smanjiti broj razmatranih dokumenata tisuću puta, gotovo ne pogoršavajući kvalitetu rangiranja?
Pretpostavimo da smo obučili mnogo ML modela, generirali značajke na temelju njih i obučili još jedan model koji rangira dokumente za korisnika. Sve bi bilo u redu, ali nije moguće jednostavno izračunati sve značajke za sve dokumente u stvarnom vremenu, ako je tih dokumenata milijun, a preporuke je potrebno izraditi za 100-200 ms. Zadatak je odabrati iz milijuna određeni podskup koji će se rangirati za korisnika. Ovaj se korak obično naziva odabir kandidata. Postavi se nekoliko zahtjeva. Prvo, odabir mora biti vrlo brz kako bi što više vremena ostalo za samo rangiranje. Drugo, uz drastično smanjenje broja dokumenata za rangiranje, trebamo maksimalno sačuvati one dokumente koji su relevantni za korisnika.
Naš princip odabira kandidata evolucijski se razvijao, i do sada smo došli do višestupanjske sheme:
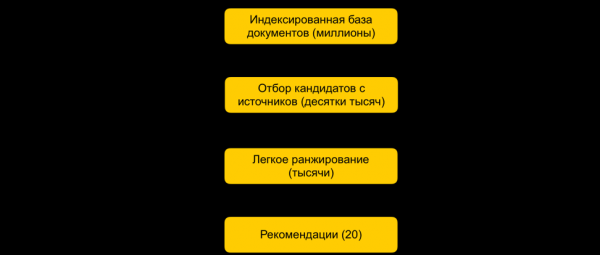
Prvo se svi dokumenti razdvajaju u grupe, a iz svake grupe se uzimaju najpopularniji dokumenti. Grupe mogu biti web stranice, teme, klasteri. Za svakog korisnika na temelju njegove povijesti odabiremo najbliže grupe i iz njih se uzimaju najbolji dokumenti. Također koristimo kNN indeks za odabir najbližih dokumenata u stvarnom vremenu. Postoji nekoliko metoda za izradu kNN indeksa, a kod nas se najbolje pokazao (Hijerarhijski navigacijski mali svijetovi). Ovo je hijerarhijski model koji omogućava pronalaženje N najbližih vektora za korisnika iz baze od milijun dokumenata u nekoliko milisekundi. Unaprijed indeksiramo cijelu našu bazu dokumenata izvan mreže. Kako pretraživanje u indeksu radi prilično brzo, uz nekoliko jakih ugradnji, možemo stvoriti nekoliko indeksa (po jedan indeks za svaku ugradnju) i obraćati se svakom od njih u stvarnom vremenu.
Imamo desetke tisuća dokumenata za svakog korisnika. To je još uvijek mnogo za brojanje svih značajki, pa u ovoj fazi primjenjujemo lagano rangiranje — pojednostavljeni model teškog rangiranja s manjim brojem značajki. Cilj je predvidjeti koji će dokumenti biti na vrhu kod teškog modela. Dokumenti s najvećim predikcijama će se koristiti u teškom modelu, tj. u posljednjoj fazi rangiranja. Ovaj pristup omogućuje smanjenje broja dokumenata koje korisnik razmatra s milijuna na tisuće u desetinama milisekundi.
ALS korak u stvarnom vremenu
Kako uzeti u obzir povratne informacije korisnika odmah nakon klika?
Važan faktor u preporukama je vrijeme reakcije na povratne informacije korisnika. To je posebno važno za nove korisnike: kada osoba prvi put počne koristiti preporučeni sustav, dobiva nepersonalizirani tijek raznolikih dokumenata. Čim izvrši prvi klik, potrebno je odmah uzeti to u obzir i prilagoditi se njenim interesima. Ako se svi faktori računaju offline, brza reakcija sustava postaje nemoguća zbog kašnjenja. Stoga je potrebno obraditi korisničke radnje u stvarnom vremenu. U tu svrhu koristimo ALS korak u stvarnom vremenu za izgradnju vektorskog prikaza korisnika.
Pretpostavimo da imamo vektorski prikaz za sve dokumente. Na primjer, možemo offline izgraditi embeddinge na temelju teksta članka koristeći ELMo, BERT ili druge modele strojnog učenja. Kako možemo dobiti vektorski prikaz korisnika u istom prostoru na temelju njihovih interakcija u sustavu?
Opći princip formiranja i dekompozicije matrice korisnik-dokumentPretpostavimo da imamo m korisnika i n dokumenata. Za neke korisnike poznat je njihov odnos prema nekim dokumentima. Tada se te informacije mogu predstaviti u obliku matrice m x n: redovi odgovaraju korisnicima, a stupci dokumentima. Budući da većina dokumenata korisnik nije vidio, veći dio polja matrice će ostati prazan, dok će neka druga biti ispunjena. Za svaki događaj (lajk, dislajk, klik) u matrici predviđena je neka vrijednost — no, razmotrimo pojednostavljeni model u kojem lajku odgovara 1, a dislajku –1.
Razložimo matricu na dvije: P (m x d) i Q (d x n), gdje je d dimenzija vektorskog prikaza (obično je to malo broj). Tada će svakom objektu odgovarati d-dimenzionalni vektor (korisniku — red u matrici P, dokumentu — stupac u matrici Q). Ovi vektori bit će ugradnje odgovarajućih objekata. Da bismo predvidjeli hoće li se korisniku svidjeti dokument, jednostavno možemo pomnožiti njihove ugradnje.
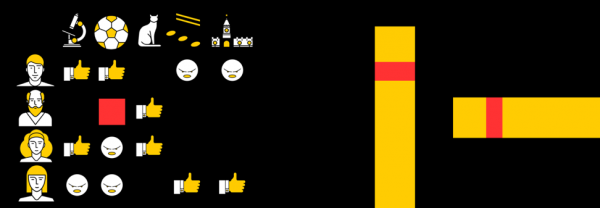
Jedan od mogućih načina dekompozicije matrice je ALS (Alternating Least Squares). Optimizirat ćemo sljedeću funkciju gubitka:

Ovdje rui predstavlja interakciju korisnika u s dokumentom i, qi — vektor dokumenta i, pu — vektor korisnika u.
Tada se optimalni vektor korisnika s obzirom na srednju kvadratnu pogrešku (pri fiksnim vektorima dokumenata) analitički dobiva rješavanjem odgovarajuće linearne regresije.
To se naziva „korak ALS“. Sam algoritam ALS sastoji se u tome da naizmjence fiksiramo jednu od matrica (korisnika i dokumenata) i ažuriramo drugu, nalazeći optimalno rješenje.
Srećom, pronalaženje vektorskog prikaza korisnika — prilično je brza operacija koja se može izvoditi u runtime-u, koristeći vektorske instrukcije. Ova metoda omogućuje odmah uzimanje u obzir povratnih informacija korisnika u rangiranju. Ista ugradnja može se koristiti i u kNN indeksu za poboljšanje selekcije kandidata.
Distribuirana kolaborativna filtracija
Kako provesti inkrementalnu distribuiranu faktorizaciju matrice i brzo pronaći vektorski prikaz novih članaka?
Sadržaj nije jedini izvor signala za preporuke. Drugi važan izvor je kolaborativna informacija. Dobre indikacije u rangiranju tradicionalno se mogu dobiti iz raspodjele matrice korisnik-dokument. Međutim, prilikom pokušaja razlaganja suočili smo se s problemima:
1. Imamo milijune dokumenata i desetke milijuna korisnika. Matrica se ne može potpuno smjestiti na jednom stroju, i razlaganje će trajati dugo.
2. Većina sadržaja u sustavu ima kratak životni vijek: dokumenti ostaju relevantni samo nekoliko sati. Stoga je potrebno što brže izgraditi njihovo vektorsko predstavljanje.
3. Ako radimo razlaganje odmah nakon objavljivanja dokumenta, dovoljan broj korisnika ga možda neće stignuti ocijeniti. Stoga će njegovo vektorsko predstavljanje vjerojatno biti neučinkovito.
4. Ako korisnik da lajk ili dislajk, nećemo moći odmah uzeti to u obzir u razlaganju.
Kako bismo riješili navedene probleme, implementirali smo distribuirano razlaganje matrice korisnik-dokument s čestim inkrementalnim ažuriranjem. Kako točno to funkcionira?
Pretpostavimo da imamo klaster od N strojeva (N se računa u stotinama) i želimo izvršiti distribuirano razlaganje matrice koja se ne može smjestiti na jednom stroju. Pitanje je — kako izvršiti to razlaganje, tako da, s jedne strane, svaki stroj ima dovoljno podataka, a s druge strane, da su izračuni neovisni?
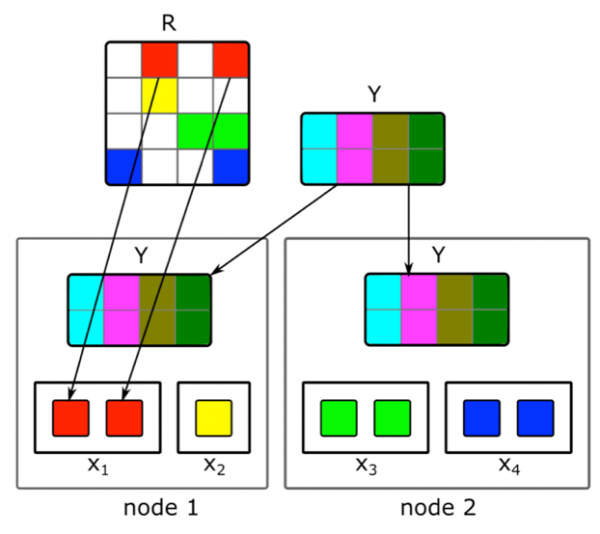
Upotrijebit ćemo gore opisani ALS algoritam razlaganja. Razmotrit ćemo kako distribuirano izvršiti jedan korak ALS-a — ostali koraci će biti slični. Pretpostavimo da imamo fiksnu matricu dokumenata i želimo izgraditi matricu korisnika. Za to ćemo je podijeliti na N dijelova po redovima, pri čemu će svaki dio sadržavati otprilike jednake količine redova. Poslat ćemo na svaki stroj neispunjene ćelije odgovarajućih redova, kao i matricu ugrađivanja dokumenata (u cijelosti). Budući da je njezina veličina relativno mala, a matrica korisnik-dokument obično jako rijetka, ovi podaci stane na obični stroj.
Ovu tehniku možemo ponavljati kroz nekoliko epoha do konvergencije modela, izmjenjujući fiksnu matricu. No, čak i tada, razlaganje matrice može trajati nekoliko sati. To ne rješava problem brzog dobivanja ugradnji novih dokumenata i ažuriranja ugradnji onih koji su imali malo informacija prilikom izrade modela.
Pomoglo nam je uvođenje brzih inkrementalnih ažuriranja modela. Pretpostavimo da imamo trenutni obučeni model. Od vremena njegovog treniranja pojavili su se novi članci s kojima su naši korisnici komunicirali, kao i članci koji su imali malo interakcija tijekom obuke. Za brzo dobivanje ugradnji takvih članaka koristimo ugradnje korisnika dobivene tijekom prvog velikog treniranja modela i radimo jedan korak ALS kako bismo izračunali matricu dokumenata uz fiksnu matricu korisnika. To omogućava brzo dobivanje ugradnji — unutar nekoliko minuta nakon objave dokumenta — i često ažuriranje ugradnji svježih dokumenata.
Kako bismo odmah uzeli u obzir ljudske akcije za preporuke, u runtime-u ne koristimo ugradnje korisnika dobivene offline. Umjesto toga, radimo korak ALS i dobivamo relevantni vektor korisnika.
Prijenos na drugu domenu
Kako iskoristiti povratne informacije korisnika o tekstualnim člancima za izgradnju vektorskog prikaza video sadržaja?
Isprva smo preporučivali samo tekstualne članke, stoga su mnogi naši algoritmi prilagođeni ovom tipu sadržaja. Međutim, prilikom dodavanja sadržaja druge vrste suočili smo se s potrebom adaptacije modela. Kako smo riješili ovaj problem na primjeru videa? Jedna od opcija je ponovno obučavanje svih modela od nule. No, to traje dugo, a dio algoritama zahtijeva veliku količinu podataka za obuku, koje još uvijek nemamo u potrebnoj količini za novi tip sadržaja u prvim trenucima njegove prisutnosti na servisu.
Odlučili smo se za drugačiji pristup i ponovo iskoristili modele tekstova za video. U stvaranju vektorskih prikaza videa pomogla nam je ista ona tehnika s ALS-om. Uzeli smo vektorski prikaz korisnika temeljen na tekstualnim člancima i napravili ALS korak koristeći podatke o pregledima videa. Tako smo lako dobili vektorski prikaz videa. Tijekom izvođenja jednostavno izračunavamo bliskost između vektora korisnika, dobivenog na temelju tekstualnih članaka, i vektora videa.
Zaključak
Razvoj jezgre sustava preporuka u stvarnom vremenu suočen je s mnogim izazovima. Potrebno je brzo obraditi podatke i primijeniti metode strojnog učenja za učinkovitu upotrebu tih podataka; graditi složene distribuirane sustave sposobne obraditi korisničke signale i nove jedinice sadržaja u minimalnom vremenu; i mnoge druge zadatke.
U trenutnom sustavu, čija svojstva opisujem, kvaliteta preporuka za korisnika raste s njegovom aktivnošću i dužinom boravka na usluzi. No, naravno, tu leži i najveći izazov: sustavu je teško odmah razumjeti interese osobe koja je malo interagirala s sadržajem. Poboljšanje preporuka za nove korisnike naš je ključni zadatak. Nastavit ćemo optimizirati algoritme kako bi relevantan sadržaj brže došao u njihov feed, a nerelevantan se ne prikazivao.
Izvor: habr.com
