

Kada je tvoj posao stvarati nešto lijepo, o njemu se ne treba previše pričati jer je rezultat svima pred očima. No, ako brišeš natpise sa zidova, tvoj rad nitko ne primjećuje sve dok zidovi izgledaju pristojno ili dok ne izbriješ nešto što ne treba.
Svaka usluga koja omogućava ostavljanje komentara, recenzija, slanje poruka ili uploading slika, рано ili kasno suočava se s problemom spama, prijevara i nepristojnog sadržaja. To se ne može izbjeći, ali se s tim treba boriti.
Zovem se Mihail, radim u timu Antispama koji štiti korisnike Yandexovih usluga od sličnih problema. Naš rad rijetko je uočljiv (i dobro je tako!), stoga ću vam danas malo detaljnije govoriti o tome. Saznat ćete u kojim slučajevima moderiranje nije učinkovito i zašto točnost nije jedini pokazatelj njegove učinkovitosti. Također ćemo razgovarati o psovkama kroz primjere mačaka i pasa i o tome zašto je ponekad korisno 'razmišljati kao psovač'.
U Yandexu se pojavljuje sve više usluga gdje korisnici objavljuju svoj sadržaj. Možete postaviti pitanje ili odgovoriti u Yandex.Q, razgovarati o kvartu u Yandex.Distriktu, podijeliti informacije o prometu u razgovorima na Yandex.Mapama. No, kada publika usluge raste, postaje privlačna za prevarante i spamače. Oni dolaze i ispunjavaju komentare: nude lako zarađivanje, reklamiraju čarobna sredstva i obećavaju socijalne isplate. Zbog spama, neki korisnici gube novac, a drugi — želju provesti vrijeme na zanemarenoj usluzi ispunjenoj spamom.
I to nije jedini problem. Nastojimo ne samo zaštititi korisnike od prevaranata, već i stvoriti ugodno okruženje za komunikaciju. Ako se ljudi u komentarima susreću s psovkama i uvredama, velika je vjerojatnost da će otići i više se ne vratiti. To znači da se s tim također treba boriti.
Čist Internet
Kao što to obično biva, prvi radovi su se pojavili u Pretraživanju, u onom dijelu koji se bori protiv spama u rezultatima pretraživanja. Prije desetak godina pojavila se potreba za filtriranjem sadržaja za odrasle za obiteljsko pretraživanje i za upite koji ne impliciraju odgovore iz kategorije 18+. Tako su nastali prvi, ručno sastavljeni rječnici pornografije i psovki, koje su nadopunjavali analitičari. Glavni zadatak bio je klasifikacija upita na one gdje je prikazivanje sadržaja za odrasle dozvoljeno i gdje nije. Za tu potrebu prikupljala se oznaka, gradile su se heuristike, obučavali su se modeli. Tako su stvoreni prvi radovi za filtriranje neželjenog sadržaja.
S vremenom je u Yandexu počeo se pojavljivati UGC (sadržaj generiran od strane korisnika) — poruke koje sami pišu korisnici, a Yandex ih samo objavljuje. Iz gore opisanih razloga mnoge poruke nije bilo moguće objaviti bez pregleda — potrebna je bila moderacija. Tada je odlučeno napraviti uslugu koja bi pružala zaštitu od spama i zlonamjernika za sve UGC proizvode Yandexa i koristila bi radove za filtriranje neželjenog sadržaja u Pretraživanju. Usluga je nazvana „Čistiji Web“.
Novi zadaci i pomoć tolokera
Prvo je radila samo jednostavna automatizacija: servisi su nam slali tekstove, a mi smo ih provodili kroz rječnike psovki, rječnike pornografije i regularne izraze — analitičari su sve sastavljali ručno. No, usluga je s vremenom korištena u sve više proizvoda Yandexa, i morali smo naučiti kako se nositi s novim problemima.
Često umjesto recenzije korisnici objavljuju besmisleni skup slova, pokušavajući steći svoj pečat, ponekad reklamiraju svoju tvrtku u recenzijama konkurentske tvrtke, a ponekad jednostavno miješaju organizacije i u recenziji o trgovini za kućne ljubimce pišu: „Odlično pripremljena riba!“. Moguće je da će umjetna inteligencija jednog dana naučiti savršeno shvatiti smisao bilo kojeg teksta, ali trenutno automatizacija ponekad loše obavlja posao u usporedbi s ljudima.
Postalo je jasno da bez ručne obrade ovdje ne možemo, pa smo dodali drugu fazu našem procesu — slanje na ručnu provjeru od strane ljudi. Tamo su dolazili objavljeni tekstovi za koje klasifikator nije primijetio probleme. Mogućnosti takvog zadatka lako možete zamisliti, stoga nismo samo oslonili na ocjenjivače, već smo se poslužili 'mudrošću mase', odnosno obratili smo se talentiranim ljudima. Oni nam pomažu otkriti ono što je stroj propustio, te tako podučavaju naš sustav.
Pametno predmemoriranje i LSH heširanje
Još jedan problem s kojim smo se susreli pri radu s komentarima je spam, a točnije, njegovi opsezi i brzina širenja. Kada je publika Yandex.Rai nebrzo rasla, spammeri su se pojavili. Naučili su zaobići regularne izraze, malo mijenjajući tekst. Spam su, naravno, i dalje pronalazili i uklanjali, ali u opsegu Yandexa, objavljeno neprimjereno poruka, čak i na 5 minuta, mogli su vidjeti stotine ljudi.
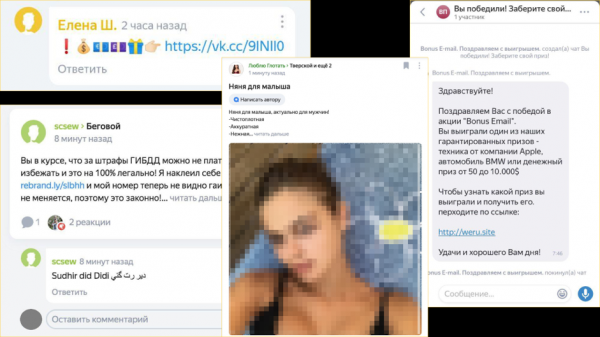
To nas, naravno, nije zadovoljilo, pa smo implementirali pametno predmemoriranje tekstova na bazi LSH (). Funkcija radi ovako: normalizirali smo tekst, uklonili linkove i rezali ga na n-gramove (sekvencije od n slova). Nadalje, računali smo heševe od n-gramova, a zatim gradili LSH vektor dokumenta na temelju njih. Poanta je da slični tekstovi, čak i kada su malo promijenjeni, postaju slični vektori.
Ovo rješenje omogućilo je ponovno korištenje presuda klasifikatora i ocjenjivača za slične tekstove. Tijekom napada spama, čim prva poruka prođe provjeru i dođe u predmemoriju s presudom 'spam', sve nove slične poruke, čak i one izmijenjene, dobivale su istu presudu i automatski su se brisale. Kasnije smo naučili obučavati i automatski reobučavati klasifikatore spama, ali ova 'pametna predmemorija' ostala je s nama i još uvijek nam često pomaže.
Klasifikator dobrih tekstova
Nakon što se nismo uspjeli odmoriti od borbe protiv spama, shvatili smo da 95% sadržaja moderiramo ručno: klasifikatori reagiraju samo na kršenja, a većina tekstova je dobra. Angažirali smo radnike koji u 95 slučajeva od 100 daju ocjenu "Sve u redu". Morali smo se uhvatiti u koštac s nezahvalnim poslom – stvaranje klasifikatora dobrog sadržaja, srećom, akumulirali smo dovoljno oznaka.
Prvi klasifikator izgledao je ovako: lematiziramo tekst (dovedemo riječi u njihov osnovni oblik), izbacujemo sve pomoćne dijelove govora i primjenjujemo unaprijed pripremljeni "rječnik dobrih lemama". Ako su sve riječi u tekstu "dobre", to znači da cijeli tekst ne sadrži kršenja. Na različitim servisima, takav pristup odmah je donio automatizaciju ručne oznake od 25 do 35%. Naravno, takav pristup nije savršen: nije teško kombinirati nekoliko nevinih riječi i dobiti vrlo uvredljivu izjavu, ali nam je omogućio da brzo postignemo dobar nivo automatizacije i dali smo više vremena za obučavanje složenijih modela.
Sljedeće verzije klasifikatora dobrih tekstova već su uključivale i linearne modele, i odlazne drveće, te njihove kombinacije. Za označavanje grubosti i uvreda, na primjer, pokušavamo koristiti neuronsku mrežu BERT. Ovdje je važno uhvatiti značenje riječi u kontekstu i povezanost riječi iz različitih rečenica, a BERT se dobro snalazi u tome. (Usput, nedavno su kolege iz Vijesti , kako primjenjuju tehnologiju za nestandardni zadatak – traženje grešaka u naslovima.) Na kraju smo uspjeli automatizirati do 90% toka, ovisno o servisu.
Točnost, kompletna i brzina
Kako bismo se razvijali, potrebno je razumjeti kakvu korist donose razni automatski klasifikatori, promjene u njima, a također i ne propada li kvaliteta ručnih provjera. Zato primjenjujemo pokazatelje točnosti i kompletnosti.
Točnost je udio ispravnih presudâ među svim presudama o lošem sadržaju. Što je točnost veća, to je manje lažnih alarma. Ako se ne prati točnost, teoretski bi se moglo ukloniti sav spam i psovke, a zajedno s njima i polovica dobrih poruka. S druge strane, ako se oslanjamo samo na točnost, najbolja bi bila tehnologija koja nikoga ne detektira. Stoga postoji još jedan pokazatelj: potpunost, što je udio otkrivenog lošeg sadržaja među ukupnim obimom lošeg sadržaja. Ova dva mjerila međusobno se uravnotežuju.
Za mjerenje uzimamo uzorke cijelog ulaznog toka za svaku uslugu i predajemo uzorke sadržaja procjeniteljima za stručnu evaluaciju i usporedbu s rješenjima mašine.
Ali postoji još jedan važan pokazatelj.
Gore sam napisao da neprimjerenu poruku čak u 5 minuta može vidjeti stotine ljudi. Stoga računamo koliko smo puta uspjeli pokazati ljudima loš sadržaj prije nego što smo ga sakrili. To je važno, jer nije dovoljno raditi kvalitetno — također treba raditi brzo. A kada smo gradili zaštitu od psovki, to smo u potpunosti osjetili.
Antipsovke na primjeru mačaka i pasa
Malo lirsko odmak. Netko bi mogao reći da psovke i uvrede nisu toliko opasne kao zlonamjerne veze i nisu toliko iritantne kao spam. Ali težimo održavanju ugodnih uvjeta za komunikaciju milijuna korisnika, a ljudi ne vole vraćati se na mjesta gdje ih vrijeđaju. Nije bez razloga zabrana psovki i uvreda propisana u pravilima mnogih zajednica, uključujući i na Habr-u. No, skrenuli smo s teme.
Rječnici psovki ne mogu obuhvatiti svu bogatstvo ruskog jezika. Iako postoje samo četiri osnovna korijena psovki, od njih se može sastaviti neizmjerno mnogo riječi koje se ne mogu uhvatiti nikakvim regularnim izrazima. Osim toga, moguće je pisati tranliterate dijela riječi, zamijeniti slova sličnim kombinacijama, premještati slova, dodavati zvjezdice itd. Ponekad je bez konteksta jednostavno nemoguće odrediti što je korisnik mislio reći psovkom. Poštujemo pravila Habr-a, stoga ćemo to demonstrirati ne na živim primjerima, nego na mačkama i psima.
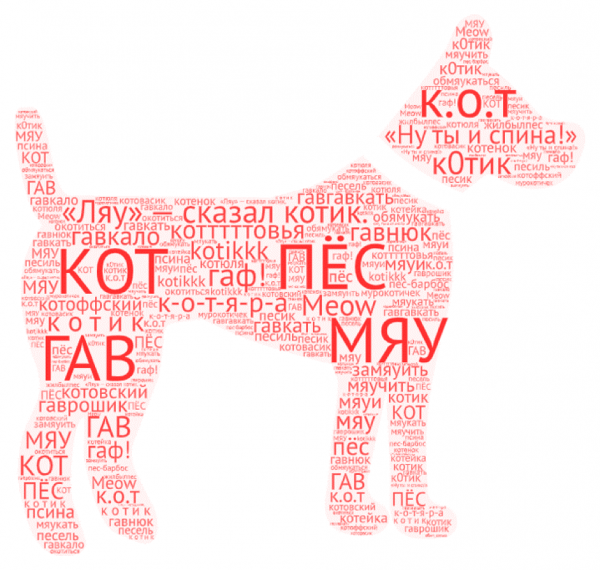
"Mau", rekao je mačak. No, razumijemo da je mačak rekao drugu riječ...
Počeli smo razmišljati o algoritmima „neizvjesnog podudaranja“ našeg rječnika i o pametnijem preprocesiranju: prebacivali smo u transliteraciju, uklanjali razmake i interpunkciju, tražili obrasce i pisali za njih odvojene regularne izraze. Ovakav pristup je davao rezultate, ali često je smanjivao preciznost, ne dajući željenu potpunost.
Tada smo odlučili „razmišljati poput psovki“. Počeli smo sami unositi šum u podatke: premještali smo slova, generirali tipfelere, zamjenjivali slova sličnima po izgledu itd. Početnu oznaku za to uzeli smo, primjenjujući rječnike psovki na velike korpuse tekstova. Ako uzmemo jednu rečenicu i izobličimo je na nekoliko načina, dobit ćemo već mnogo rečenica. Tako možemo povećati skup za obuku nekoliko puta. Ostalo je samo obučiti neku više-manje pametnu aplikaciju koja uzima u obzir kontekst.
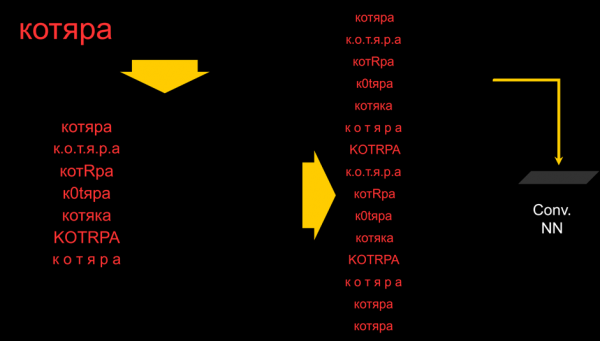
O konačnoj odluci još je rano govoriti. I dalje eksperimentiramo s pristupima ovom problemu, ali već vidimo da jednostavna konvolucijska mreža sa nekoliko slojeva značajno nadmašuje rječnike i regularne izraze: moguće je povećati i preciznost i potpunost.
Naravno, razumijemo da će uvijek postojati načini zaobići čak i najnapredniju automatiku, posebno kada je stvar toliko uzbudljiva: napisati tako da glupa mašina ne shvati. Ovdje, kao i u borbi protiv spama, naše ambicije nisu iskorijeniti mogućnost pisanja nečega neprimjerenog, naš cilj je osigurati da igra ne bude skuplja od svijeća.
Otvoriti mogućnost dijeljenja vlastitog mišljenja, komunikacije i komentiranja — nije teško. Puno je teže postići sigurne, ugodne uvjete i poštovanje prema ljudima. A bez toga neće biti razvoja bilo koje zajednice.
Izvor: habr.com
