

Bok, Habr! Ja sam Artyom Karamyshev, voditelj tima za sistemsko upravljanje. . Tijekom protekle godine imali smo mnogo lansiranja novih proizvoda. Željeli smo osigurati da se API usluge lako skaliraju, budu otporne na greške i spremne za brzi rast korisničkog opterećenja. Naša platforma je realizirana na OpenStacku, a želim podijeliti koje smo probleme otpornosti komponenti morali riješiti kako bismo dobili otporan sustav. Mislim da će to biti zanimljivo onima koji također razvijaju proizvode na OpenStacku.
Ukupna otpornost platforme sastoji se od otpornosti njenih komponenata. Tako ćemo postupno proći kroz sve razine na kojima smo uočili rizike i riješili ih.
Video verziju ove priče, koja je proizašla iz izlaganja na konferenciji Uptime Day 4, organiziranoj , možete pogledati .
Otpornost fizičke arhitekture
Javni dio oblaka MCS trenutno se bazira u dva data centra razine Tier III, između kojih postoji vlastita tamna vlakna, rezervirana na fizičkoj razini raznim rutama, s propusnošću od 200 Gbit/s. Razina Tier III osigurava potrebnu razinu otpornosti fizičke infrastrukture.
Tamno vlakno je rezervirano kako na fizičkom, tako i na logičkom nivou. Proces rezervacije kanala bio je iterativan, pojavili su se problemi, i konstantno poboljšavamo vezu između data centara.
Na primjer, nedavno je prilikom radova u šahtu pored jednog od data centara bager probio cijev, unutar koje su se našli i glavni i rezervni optički kabel. Naš otporan komunikacijski kanal s data centrom bio je ranjiv na jednom mjestu, u šahtu. Slijedom toga, izgubili smo dio infrastrukture. Izvukli smo zaključke, poduzeli niz mjera, uključujući postavljanje dodatne optike kroz susjedni šaht.
U podatkovnim centrima postoje prisutne tačke pružatelja usluga, kojima emitujemo svoje prefikse putem BGP-a. Za svaki mrežni pravac bira se najbolja metrika, što omogućava da različiti klijenti imaju najbolje kvalitetne veze. Ako veza preko jednog pružatelja bude prekinuta, preusmjeravamo svoju routingu preko dostupnih pružatelja.
U slučaju kvara na radu pružatelja automatski se prebacujemo na sljedećeg. U slučaju kvara jednog od podatkovnih centara, imamo oglednu kopiju naših usluga u drugom podatkovnom centru, koji preuzima sav teret.
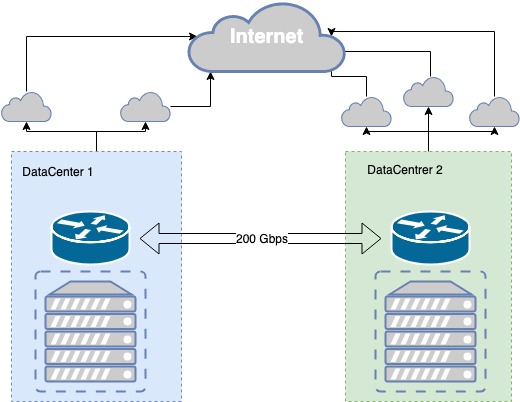
Otpornost fizičke infrastrukture
Što koristimo za otpornost na razini aplikacija
Naša usluga je izgrađena na nizu opensource komponenti.
ExaBGP — usluga koja implementira niz funkcija koristeći protokol dinamičkog usmjeravanja temeljenog na BGP-u. Aktivno ga koristimo za oglašavanje naših bijelih IP adresa, putem kojih korisnici pristupaju API-ju.
Dalje, klijentski zahtjev se slao u HAProxy, koji je rješavao sljedeće zadatke: — visoko opterećen balancer koji omogućava postavljanje vrlo fleksibilnih pravila za ravnotežu prometa na različitim razinama OSI modela. Koristimo ga za balansiranje ispred svih usluga: baza podataka, posrednici poruka, API usluge, web usluge, naši unutarnji projekti — sve to stoji iza HAProxy.
API aplikacija — web aplikacija napisana na pythonu, putem koje korisnik upravlja svojom infrastrukturom, svojim uslugama.
Worker aplikacija (dalje jednostavno worker) — u uslugama OpenStack to je infrastrukturni demon koji omogućava emitiranje API komandi na infrastrukturu. Na primjer, stvaranje diska događa se upravo u workeru, dok se zahtjev za stvaranje šalje u API aplikaciju.
Standardna arhitektura OpenStack aplikacije
Većina usluga razvijenih pod OpenStackom nastoji slijediti jedinstvenu paradigmu. Usluga se obično sastoji od dva dijela: API-ja i radnika (backend izvršitelji). API je obično WSGI aplikacija napisana u pythonu, koja se pokreće ili kao samostalni proces (daemon), ili uz pomoć postojećeg web servera Nginx ili Apache. API obrađuje korisničke zahtjeve i prosljeđuje dodatne instrukcije radnoj aplikaciji. Prosljeđivanje se vrši putem posrednika poruka, obično RabbitMQ, dok se drugi slabo podržavaju. Kada poruke stignu do posrednika, njih obrađuju radnici koji u slučaju potrebe vraćaju odgovor.
Ova paradigma podrazumijeva izolirane zajedničke točke neuspjeha: RabbitMQ i bazu podataka. Međutim, RabbitMQ je izoliran unutar jedne usluge i prema ideji može biti pojedinačan za svaku uslugu. Tako da u MCS-u maksimalno dijelimo ove usluge, za svaki poseban projekt kreiramo posebnu bazu, posebni RabbitMQ. Ovaj pristup ima tu prednost što u slučaju kvara u nekim ranjivim točkama ne propada cijela usluga, već samo njezin dio.
Broj radnih aplikacija nije ograničen, tako da se API može lako horizontalno skalirati iza balancerâ radi povećanja performansi i otpornosti na kvarove.
U nekim uslugama potrebna je koordinacija unutar usluge — kada se događaju složene sekvencijalne operacije između API-ja i radnika. U tom slučaju se koristi jedinstveni centar koordinacije, klasterski sustav poput Redisa, Memcachea, etcd, koji omogućuje jednom radniku da kaže drugom da je taj zadatak dodijeljen njemu (‘ti, molim te, ne uzimaj to’). Mi koristimo etcd. Obično radnici aktivno komuniciraju s bazom podataka, pišu i čitaju informacije iz nje. Kao bazu podataka koristimo mariadb, koja se nalazi u multimaster klasteru.
Takva klasična jedinstvena usluga organizirana je općeprihvaćenim načinom za OpenStack. Može se smatrati zatvorenim sustavom, za koji su načini skaliranja i otpornosti na kvarove dovoljno očigledni. Na primjer, za otpornost na kvarove, API-ju je dovoljno postaviti balancer ispred njega. Skaliranje radnika postiže se povećanjem njihovog broja.
Slaba točka cijele sheme su RabbitMQ i MariaDB. Njihova arhitektura zaslužuje poseban članak. U ovom članku želim se fokusirati na otpornost API-ja.
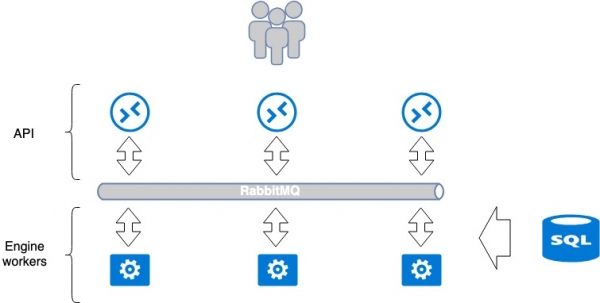
Arhitektura Openstack Application. Balansiranje i otpornost oblaka platforme.
Učinite HAProxy balansirnik otpornim uz pomoć ExaBGP.
Kako bi naši API-ji bili skalabilni, brzi i otporni, postavili smo ispred njih balansirnik. Odabrali smo HAProxy. Po mom mišljenju, on ima sve potrebne karakteristike za naš zadatak: balansiranje na više razina OSI, upravljačko sučelje, fleksibilnost i skalabilnost, veliki broj metoda balansiranja, podršku za tablice sesija.
Prvi problem koji se morao riješiti je otpornost samog balansirnika. Samo postavljanje balansirnika također stvara točku otkaza: balansirnik se kvari - usluga pada. Da to ne bi bilo tako, koristili smo HAProxy zajedno sa ExaBGP.
ExaBGP omogućuje implementaciju mehanizma provjere stanja usluge. Ovaj mehanizam koristili smo za provjeru funkcionalnosti HAProxy-a i u slučaju problema isključivanje HAProxy usluge iz BGP-a.
Shema ExaBGP+HAProxy.
- Instaliramo potrebni softver, ExaBGP i HAProxy, na tri poslužitelja.
- Na svakom od poslužitelja kreiramo loopback sučelje.
- Na sva tri poslužitelja dodajemo istu javnu IP adresu na to sučelje.
- Javna IP adresa oglašava se na internetu putem ExaBGP-a.
Otpornost se postiže oglašavanjem iste IP adrese sa sva tri poslužitelja. S mrežne strane, ista adresa dostupna je s tri različita next hop-a. Usmjerivač vidi tri identična puta, odabire onaj s najvišim prioritetom prema vlastitoj metriji (što je obično ista opcija), i promet ide samo na jedan od poslužitelja.
U slučaju problema s radom HAProxy-a ili kvara poslužitelja, ExaBGP prestaje oglašavati put, a promet se glatko prebacuje na drugi poslužitelj.
Tako smo postigli otpornost balansirnika.
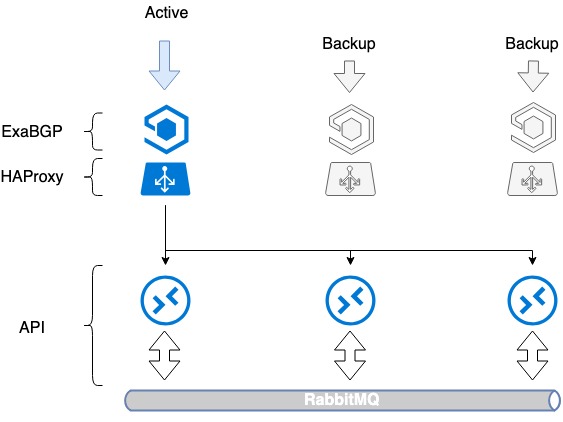
Otpornost HAProxy balansirnika.
Shema nije ispala savršena: naučili smo rezervirati HAProxy, ali nismo naučili raspodjeljivati opterećenje unutar usluga. Stoga smo ovu shemu malo proširili: prešli smo na balansiranje između nekoliko javnih IP adresa.
DNS i BGP temeljen balansiranjem
Pitanje balansiranja opterećenja ispred naših HAProxy još uvijek nije riješeno. Međutim, moguće ga je jednostavno riješiti, kao što smo to učinili i kod nas.
Za balansiranje tri servera potrebna su 3 javne IP adrese i stari dobri DNS. Svaka od tih adresa se definira na loopback sučelju svakog HAProxy-a i oglašava se na internetu.
U OpenStack-u se za upravljanje resursima koristi katalog usluga, u kojem se definira endpoint API-ja svake od usluga. U ovom katalogu upisujemo naziv domene — public.infra.mail.ru, koji se riješava putem DNS-a na tri različite IP adrese. Kao rezultat toga, dobivamo raspodjelu opterećenja između tri adrese putem DNS-a.
Međutim, budući da prilikom oglašavanja javnih IP adresa ne upravljamo prioritetima odabira servera, to nije balansiranje. Obično će se odabrati samo jedan server prema redoslijedu IP adrese, dok će druga dva stajati neiskorištena, jer nisu navedene nikakve metrike u BGP-u.
Počeli smo oglašavati rute putem ExaBGP-a s različitim metrima. Svaki balansirnik oglašava sve tri javne IP adrese, ali jedna od njih, glavna za taj balansirnik, oglašava se s minimalnom metrikom. Tako dok su svi tri balansirnika u radu, zahtjevi za prvom IP adresom odlaze na prvi balansirnik, zahtjevi za drugom na drugi, a za trećom na treći.
Što se događa kada jedan od balansirnika padne? U slučaju otkaza bilo kojeg balansirnika, njegova osnovna adresa još uvijek se oglašava s dva druga, a promet između njih se preraspodjeljuje. Na taj način korisniku posredujemo putem DNS-a odmah nekoliko IP adresa. Kroz DNS balansiranje i različite metrike dobivamo ravnomjernu raspodjelu opterećenja na sve tri balansirnika. Istovremeno ne gubimo otpornost na otkazivanje.
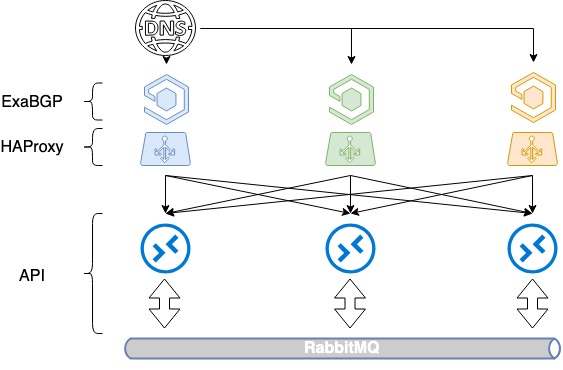
HAProxy balansiranje zasnovano na DNS-u + BGP
Interakcija između ExaBGP-a i HAProxy-a
Dakle, implementirali smo otpornost na slučaj kraha servera, temeljen na prestanku oglašavanja ruta. Ali HAProxy može prestati raditi iz drugih razloga osim kvara servera: greške u administraciji, unutarnji kvarovi usluge. Želimo isključiti neispravan balansirnik iz opterećenja i u tim slučajevima, potreban je drugi mehanizam.
Stoga, proširujući prethodnu shemu, implementirali smo heartbeat između ExaBGP i HAProxy. Ovo je softverska implementacija interakcije između ExaBGP i HAProxy, pri čemu ExaBGP koristi prilagođene skripte za provjeru statusa aplikacija.
Za to je potrebno konfigurirati health checker u ExaBGP koji može provjeravati status HAProxy. U našem slučaju, postavili smo health backend u HAProxy, a s ExaBGP provjeravamo jednostavnim GET zahtjevom. Ako se oglas prestaje događati, tada HAProxy vjerojatno ne radi i nije potrebno oglašavati ga.
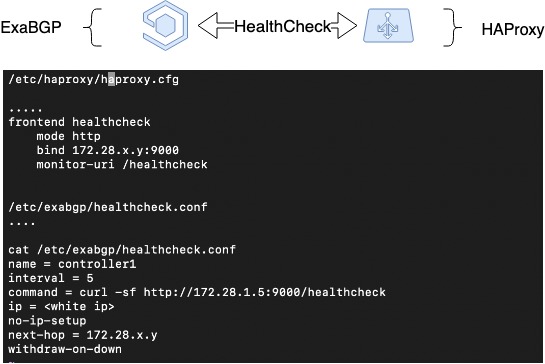
HAProxy Health Check
HAProxy Peers: sinkronizacija sesija
Sljedeće što je trebala učiniti je sinkronizacija sesija. Kada radimo kroz distribuirane balansere, teško je organizirati pohranu informacija o sesijama klijenata. No, HAProxy je jedan od rijetkih balansirača koji to može učiniti zahvaljujući funkcionalnosti Peers — mogućnosti prijenosa tablica sesija između različitih HAProxy procesa.
Postoje različite metode balansiranja: jednostavne, kao što su , i napredne, kada se zapamti sesija klijenta i on svaki put dolazi na isti server kao i prije. Željeli smo implementirati drugu opciju.
U HAProxy za pohranu sesija klijenata koristi se stick-tables mehanizam. Oni pohranjuju izvorne IP adrese klijenta, odabranu ciljanju adresu (backend) i određene administrativne informacije. Obično se stick-tablice koriste za pohranu para source-IP + destination-IP, što je posebno korisno za aplikacije koje ne mogu prenijeti kontekst korisničke sesije prilikom prelaska na drugog balansirača, primjerice — u RoundRobin načinu balansiranja.
Ako stick-tablicu naučimo da se kreće između različitih HAProxy procesa (između kojih se događa balansiranje), naši balansiralići će moći raditi s jednom grupom stick-tablica. Ovo će omogućiti neprimjetno prebacivanje mreže klijenta u slučaju pada jednog od balansirača, a rad sa sesijama klijenata nastavit će se na istim backendima koji su bili odabrani ranije.
Za pravilno funkcioniranje mora biti riješen problem izvorne IP adrese balansirača s kojeg je uspostavljena sesija. U našem slučaju, to je dinamička adresa na loopback sučelju.
Ispravna funkcija peers postiže se samo pod određenim uvjetima. To znači da TCP timeouti moraju biti dovoljno dugi ili prebacivanje mora biti dovoljno brzo kako bi se TCP sesija održala. Ipak, to omogućuje neprimjetno prebacivanje.
Imamo u IaaS-u uslugu koja je izgrađena na istoj tehnologiji. To je , koja se zove Octavia. Oslanja se na dva procesa HAProxy, a podrška za peers je prvotno ugrađena. U ovoj usluzi oni su se odlično pokazali.
Na slici je shematski prikaz prijenosa peers tablica između tri instance HAProxy, predložen je konfiguracijski primjer kako to može biti postavljeno:
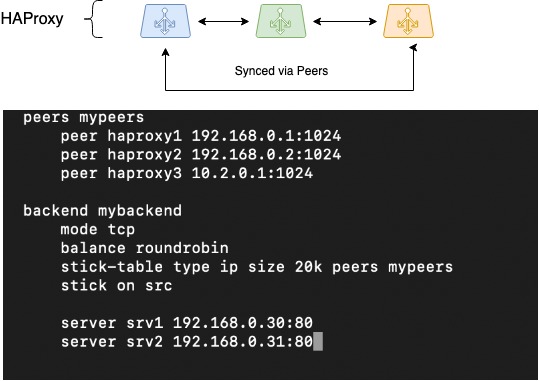
HAProxy Peers (synchronizacija sesija)
Ako ćete implementirati sličnu shemu, rad je potrebno pažljivo testirati. Nije jamstvo da će to funkcionirati na isti način u 100% slučajeva. No, barem nećete gubiti stick-tablice kada je potrebno zapamtiti source IP klijenta.
Ograničenje broja istovremenih zahtjeva s istog klijenta
Bilo koje usluge koje su dostupne na otvorenom, uključujući naše API-je, mogu biti podložne lavinama zahtjeva. Razlozi mogu biti potpuno različiti, od grešaka korisnika do ciljanih napada. Periodično nas DDoS-aju po IP adresama. Klijenti često griješe u svojim skriptama, prave nam mini-DDoS-ove.
U svakom slučaju, potrebno je osigurati dodatnu zaštitu. Očito rješenje je ograničiti broj zahtjeva prema API-ju i ne trošiti procesorsko vrijeme na obradu zlonamjernih zahtjeva.
Za implementaciju takvih ograničenja koristimo rate limits, organizirane na temelju HAProxy, uz pomoć istih stick-tablica. Postavljanje limita je prilično jednostavno i omogućuje ograničavanje korisnika po broju zahtjeva prema API-ju. Algoritam pamti source IP s kojeg se šalju zahtjevi i ograničava broj istovremenih zahtjeva s jednog korisnika. Naravno, izračunali smo prosječni profil opterećenja API-ja za svaku uslugu i postavili limit otprilike 10 puta veći od te vrijednosti. I dalje pomno pratimo situaciju i držimo ruku na pulsu.
Kako to izgleda u praksi? Imamo klijente koji neprekidno koriste naše API-jeve za automatsko skaliranje. Kreiraju otprilike dvjesto do tristo virtualnih mašina ujutro i brišu ih navečer. Za OpenStack, kreiranje virtualne mašine, zajedno s PaaS uslugama, uključuje najmanje 1000 API poziva, budući da se interakcija između usluga također odvija putem API-ja.
Takvi prijenosi zadataka stvaraju prilično veliki opterećenje. To opterećenje smo procijenili, prikupili dnevne vrhunce, povećali ih deseterostruko, i to je postalo naš rate-limit. Držimo ruku na pulsu. Često uočavamo robote i skener koji pokušavaju provjeriti imamo li neke CGA skripte koje se mogu pokrenuti, a mi ih aktivno uklanjamo.
Kako neprimjetno ažurirati kodnu bazu
Implementiramo otpornost na greške i na razini procesa distribucije koda. Tijekom isporuka može doći do kvarova, ali njihov utjecaj na dostupnost usluga može se minimalizirati.
Neprekidno ažuriramo svoje usluge i moramo osigurati proces ažuriranja kodne baze bez efekta na korisnike. Ovaj problem riješili smo koristeći mogućnosti upravljanja HAProxy-jem i implementirajući Graceful Shutdown u našim uslugama.
Za rješavanje ovog problema potrebno je osigurati upravljanje ravnotežom opterećenja i "ispravno" gašenje usluga:
- U slučaju HAProxy-a, upravljanje se vrši putem stats datoteke, koja je u suštini socket, a određuje se u HAProxy konfiguraciji. Moguće je slati mu naredbe putem stdio-a. Međutim, naš glavni alat za kontrolu konfiguracija je ansible, pa ima ugrađeni modul za upravljanje HAProxy-jem koji aktivno koristimo.
- Većina naših API i Engine usluga podržava tehnologije graceful shutdown: prilikom gašenja čekaju da se trenutni zadatak završi, bilo da se radi o http zahtjevu ili nekoj servisnoj zadaći. Isto se odnosi i na radnika. On zna sve zadatke koje izvodi i završava kada je sve uspješno obavio.
Zahvaljujući ova dva aspekta, sigurni algoritam naše distribucije izgleda ovako.
- Programer prikuplja novi paket koda (to je RPM za nas), testira u dev okruženju, testira u stage, i ostavlja u stage repozitoriju.
- Programer postavlja zadatak za implementaciju s maksimalno detaljnim opisom "artefakata": verzija novog paketa, opis nove funkcionalnosti i druge pojedinosti o implementaciji u slučaju potrebe.
- Sistemski administrator započinje ažuriranje. Pokreće Ansible playbook, koji zauzvrat radi sljedeće:
- Uzima paket iz stage repozitorija, na temelju njega ažurira verziju paketa u proizvodnom repozitoriju.
- Sastavlja popis backendova ažurirane usluge.
- Isključuje prvi ažurirani servis u HAProxy i čeka da se završi njegovo procesiranje. Zahvaljujući graceful shutdown-u, sigurni smo da će svi trenutačni zahtjevi klijenata završiti uspješno.
- Nakon potpunog zaustavljanja API-ja, workera, isključenja HAProxy, dolazi do ažuriranja koda.
- Ansible pokreće servise.
- Za svaku uslugu pokreće određene "ručne" operacije, koje provode unit testiranje prema nizu unaprijed definiranih ključnih testova. Provodi se osnovna provjera novog koda.
- Ako na prethodnom koraku nisu otkrivene greške, backend se aktivira.
- Prelazimo na sljedeći backend.
- Nakon ažuriranja svih backendova, pokreću se funkcionalni testovi. Ako ih nema dovoljno, programer pregledava svaku novu funkcionalnost koju je implementirao.
Na ovom je implementacija završena.
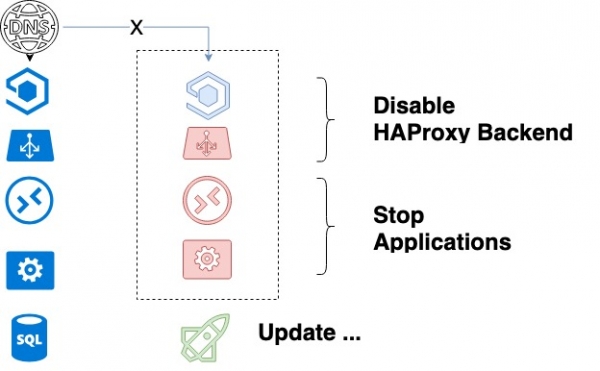
Ciklus ažuriranja usluge
Ova shema ne bi bila funkcionalna da nemamo jedno pravilo. Istovremeno održavamo staru i novu verziju u produkciji. Unaprijed, u fazi razvoja softvera, ugrađuje se da čak i ako dođe do promjena u bazi podataka usluge, one neće srušiti prethodni kod. Kao rezultat toga, dolazi do postupnog ažuriranja kodne baze.
Zaključak
Dijeleći vlastite misli o otpornoj WEB arhitekturi, želim još jednom istaknuti njezine ključne točke:
- fizička otpornost;
- mrežna otpornost (balansiranje opterećenja, BGP);
- otpornost korištenog i razvijenog softvera.
Svima stabilan uptime!
Izvor: habr.com
