

Zdravo, članovi Habr. Danas započinju nastave u prvoj grupi kursa . U vezi s tim, želimo vam ispričati kako je prošao otvoreni vebinar o ovom kursu.
U razgovarali smo o izazovima sa kojima se SQL baze suočavaju u eri oblaka i Kubernetesa. Takođe smo razmotrili kako se SQL baze podataka prilagođavaju i mutiraju pod uticajem ovih izazova.
Vebinar je vodio , menadžer za isporuku Google Cloud praksi u EPAM Systems.
Kada su drveće bila mala...
Za početak, podsetimo se kako je započelo biranje DBMS-a krajem prošlog veka. Ipak, to neće biti teško, jer je izbor DBMS-a u to vreme počinjao i završavao se Oracle.
Krajem 90-ih - početkom 2000-ih, zapravo nije bilo mnogo izbora kada je reč o industrijskim skalabilnim DBMS-ima. Da, postojali su IBM DB2, Sybase i još neki sistemi baza podataka koji su se pojavljivali i nestajali, ali u celini nisu bili tako primetni naspram Oracle-a. U skladu s tim, veštine inženjera tog vremena bile su na ovaj ili onaj način vezane za jedini izbor koji je postojao.
Oracle DBA je trebao da zna:
- instalirati Oracle Server iz distribucije;
- konfigurisati Oracle Server:
- init.ora;
- listener.ora;
— kreirati:
- tabelarna prostora;
- sheme;
- korisnike;
— izvoditi rezervne kopije i obnavljanje;
— vršiti nadzor;
— boriti se sa neoptimalnim upitima.
Pri tome, od Oracle DBA se posebno nije zahtevalo:
- da zna kako da izabere optimalni DBMS ili drugu tehnologiju za skladištenje i obradu podataka;
- da obezbedi visoku dostupnost i horizontalnu skalabilnost (to nije uvek bilo pitanje DBA);
- da dobro poznaje predmetnu oblast, infrastrukturu, aplikativnu arhitekturu, OS;
- da obavlja učitavanje i ispuštanje podataka, migraciju podataka između različitih DBMS-a.
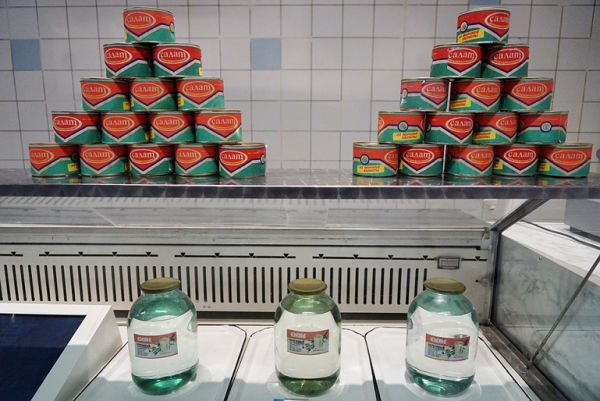
Uopšteno govoreći, ako govorimo o izboru u to vreme, podseća na izbor u sovjetskoj prodavnici krajem 80-ih:
Naše vreme
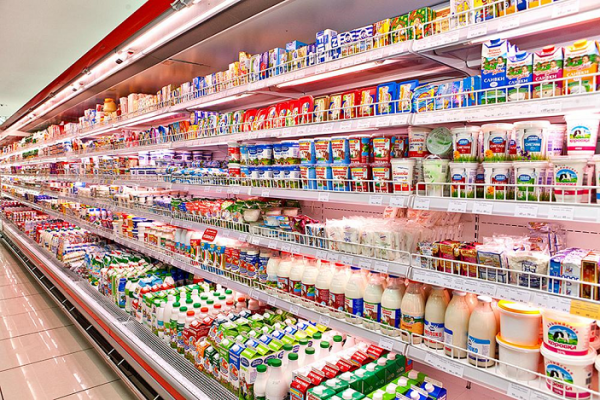
Od tada, naravno, drveće je odraslo, svet se promenio, i postalo je nekako ovako:
Promenio se i tržište DBMS-a, što je dobro vidljivo iz svežeg izveštaja kompanije Gartner:
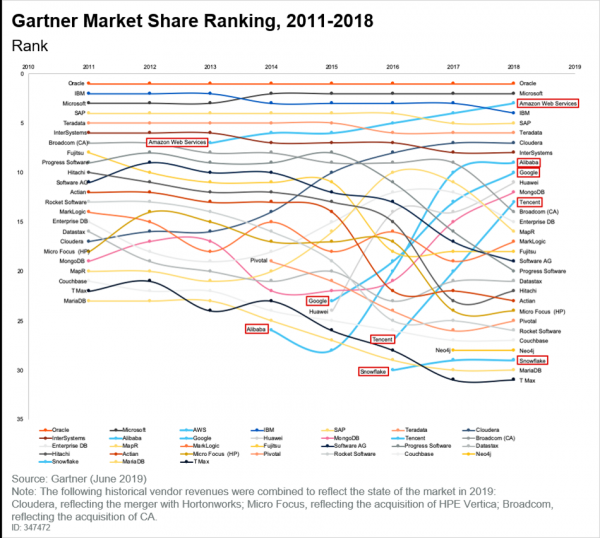
I ovde ne možemo a da ne primetimo da su svoju nišu zauzele oblak, čija popularnost raste. Ako pročitate isti izveštaj kompanije Gartner, videćemo sledeće zaključke:
- Mnogi klijenti su na putu prebacivanja aplikacija u oblak.
- Nove tehnologije prvo se pojavljuju u oblaku i nije garantirano da će se ikada preseliti u neoblačnu infrastrukturu.
- Postao je uobičajen model određivanja cijena prema principu pay-as-you-go. Svi žele plaćati samo za ono što koriste, a to više nije trend, već jednostavna konstanta.
Što je sada?
Danas smo svi u oblaku. A pitanja koja se javljaju su pitanja izbora. A izbor je ogroman, čak i kada govorimo samo o odabiru tehnologija DBMS-a u On-premises formatu. Također imamo managed services i SaaS. Na taj način, izbor postaje sve složeniji svake godine.
Osim pitanja izbora, postoje i ograničavajući faktori:
- cena. Mnoge tehnologije još uvijek koštaju novac;
- vještine. Kada govorimo o slobodnom softveru, postavlja se pitanje vještina, jer besplatan softver zahtijeva od ljudi koji ga implementiraju i koriste dovoljnu kompetentnost;
- funkcionalnosti. Nisu sve usluge koje su dostupne u oblaku i izgrađene, recimo, na bazi Postgresa, opremljene istim karakteristikama kao Postgres On-premises. To je značajan faktor koji treba znati i razumjeti. Štoviše, ovaj faktor dobiva važnije značenje od poznavanja nekih skrivenih mogućnosti određene DBMS.
Što se sada očekuje od DA/DE:
- dobro razumijevanje predmetne oblasti i primijenjene arhitekture;
- sposobnost pravilnog odabira odgovarajuće tehnologije DBMS-a s obzirom na zadatak;
- sposobnost usklađivanja optimalne metode implementacije odabrane tehnologije u kontekstu postojećih ograničenja;
- sposobnost prijenosa i migracije podataka;
- sposobnost realizacije i eksploatacije odabranih rješenja.
Slijedeći primjer na bazi GCP demonstrira kako se vrši izbor određene tehnologije rada s podacima ovisno o njihovoj strukturi:
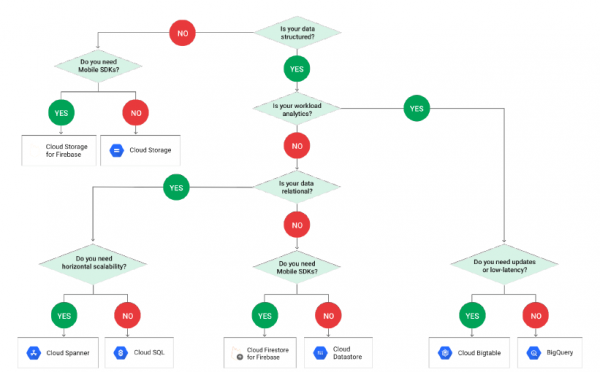
Obratite pažnju da u shemi nedostaje PostgreSQL, a sve zbog toga što se skriva pod terminologijom Cloud SQL. I kada uđemo u Cloud SQL, ponovno moramo napraviti izbor:
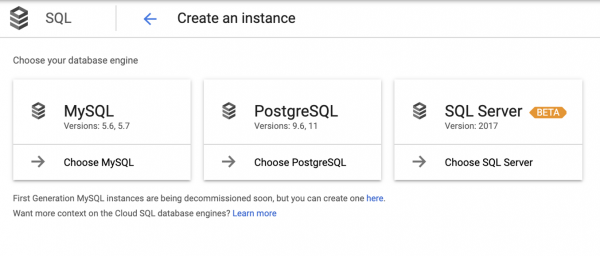
Valja napomenuti da ovaj izbor nije uvijek jasan, stoga programeri aplikacija često vode računa o intuitivnom pristupu.
Ukratko:
- Kako vrijeme prolazi, pitanje izbora postaje sve važnije. Čak i kada razmatramo samo GCP, upravljane usluge i SaaS, neko spominjanje RDBMS-a pojavljuje se tek u 4. koraku (a tu je i Spanner). Osim toga, izbor PostgreSQL-a pojavljuje se tek u 5. koraku, a uz njega su tu još MySQL i SQL Server, što znači ima mnogo opcija, ali izbor je potreban.
- Ne možemo zaboraviti na ograničenja uz brojne privlačnosti. Uglavnom, svi žele Spanner, ali je on skup. Na kraju, tipični zahtjev izgleda otprilike ovako: „Molimo vas, napravite nam Spanner, ali po cijeni Cloud SQL-a, pa vi ste profesionalci!“
Što učiniti?
Ne pretvarajući se da imamo konačnu istinu, recimo ovo:
Trebamo promijeniti pristup obrazovanju:
- nema smisla učiti kao nekad DBA;
- znanje o jednom proizvodu sada već nije dovoljno;
- a poznavanje desetaka na razini jednog — nemoguće je.
Trebamo znati ne samo proizvod, već i:
- upotrebu za koju se koristi;
- različite metode implementacije;
- prednosti i nedostatke svake metode;
- slične i alternativne proizvode, kako bismo donijeli svjesne i optimalne izbore, a ne uvijek u korist poznatog proizvoda.
A također trebamo znati migirati podatke i razumjeti osnovne principe integracije s ETL-om.
Konkretn slučaj
U nedavnoj prošlosti morao sam raditi backend za mobilnu aplikaciju. U trenutku kada sam započeo rad na njemu, backend je već bio razvijen i spreman za implementaciju, a tim programera potrošio je na ovaj projekt gotovo dvije godine. Pri tome su postavljeni sljedeći zadaci:
- izraditi CI/CD;
- napraviti pregled arhitekture;
- pokrenuti sve to u rad.
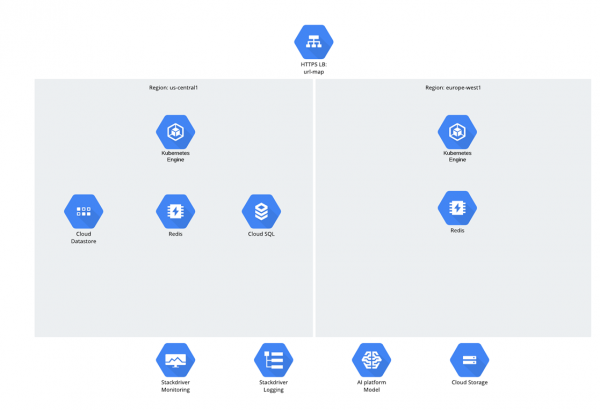
Istraživana aplikacija bila je mikroslužbena, a kod na Python/Django razvijen je ispočetka i odmah u GCP-u. Što se tiče ciljne publike, pretpostavljalo se da će postojati dva područja — SAD i EU, a promet je raspoređen putem Global Load balancera. Svi workloads i obračunski teret radili su u Google Kubernetes Engineu.
Što se tiče podataka, bile su 3 strukture:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
Može se postaviti pitanje, zašto je odabran Cloud SQL? Istini za volju, takvo pitanje posljednjih godina izaziva neku nelagodu — stječe se dojam da se ljudi srame relacijskih baza, no one se i dalje aktivno koriste ;-).
Što se tiče našeg slučaja, Cloud SQL je odabran iz sljedećih razloga:
- Kao što je spomenuto, aplikacija je razvijena uz pomoć Djanga, a u njoj postoji model za prikaz trajnih podataka iz SQL baze u Python objekte (Django ORM).
- Sam okvir podržava prilično konačan popis DBMS-a:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Stoga je PostgreSQL odabran iz ovog popisa više intuitivno (pa zar ćemo stvarno birati Oracle?).
Što je nedostajalo:
- aplikacija je implementirana samo u 2 regije, a u planu je bila dodavanje 3. (Azija);
- Baza podataka se nalazila u sjevernoameričkoj regiji (Iowa);
- s druge strane, naručitelj je imao zabrinutosti glede mogućih kašnjenja u pristupu iz Europe i Azije te prekida u usluzi u slučaju zastoja baze podataka.
Iako sam Django može raditi s nekoliko baza podataka paralelno i dijeliti ih prema čitanju i pisanju, zapisa u aplikaciji nije bilo toliko (više od 90 % — čitanje). I u cjelini, ako bi se mogla napraviti read-replika glavne baze u Europi i Aziji, to bi bio kompromisno rješenje. No, što tu ima komplicirano?
A složenost je bila u tome što naručitelj nije želio odustati od korištenja upravljanih usluga i Cloud SQL-a. A mogućnosti Cloud SQL-a su u tom trenutku ograničene. Cloud SQL podržava visoku dostupnost (HA) i Read Replica (RR), ali ista RR se podržava samo u jednoj regiji. Stvaranjem baze podataka u američkoj regiji, nije moguće napraviti read-repliku u europskoj regiji sredstvima Cloud SQL-a, iako sam PostgreSQL to ne sprječava. Dopisivanje s zaposlenicima Googlea nije dovelo do ničega i završilo je obećanjima u stilu „znamo za problem i radimo na njemu, jednom će pitanje biti riješeno”.
Ako bismo naveli mogućnosti Cloud SQL-a u tezama, izgledalo bi to otprilike ovako:
1. Visoka dostupnost (HA):
- unutar jedne regije;
- putem replikacije diska;
- ne koriste se mehanizmi PostgreSQL-a;
- moguće automatsko i ručno upravljanje — failover/failback;
- prilikom prebacivanja, baza podataka nije dostupna nekoliko minuta.
2. Read Replica (RR):
- unutar jedne regije;
- hot standby;
- PostgreSQL streaming replikacija.
Osim toga, kao što to obično biva, prilikom odabira tehnologije uvijek se susrećeš s nekim ograničenjima:
- naručitelj nije želio stvarati entitete i koristiti IaaS osim putem GKE-a;
- naručitelj ne bi želio implementirati self service PostgreSQL/MySQL;
- U stvari, Google Spanner bi bio dobar izbor, da nije njegova cijena. Nažalost, Django ORM ne može raditi s njim, a sve ostalo je dobra stvar.
S obzirom na situaciju, klijent je postavio zbunjujuće pitanje: «Možete li napraviti nešto slično, da bude kao Google Spanner, ali da radi i s Django ORM?»
Opcija rješenja br. 0
Prvo što mi je pala na pamet:
- ostati unutar CloudSQL;
- ugrađena replikacija između regija neće postojati u bilo kojem obliku;
- pokušati povezati replikaciju s postojećim Cloud SQL by PostgreSQL;
- negdje i kako pokrenuti instancu PostgreSQL, ali barem ne dodirivati master.
Nažalost, ispostavilo se da to ne može funkcionirati, jer nemamo pristup hostu (on je zapravo u drugom projektu) — pg_hba i slično, a još nemamo pristup kao superuser.
Opcija rješenja br. 1
Nakon dodatnog razmišljanja i uzimajući u obzir prethodne okolnosti, način razmišljanja se malo promijenio:
- i dalje pokušavamo ostati unutar CloudSQL, ali prelazimo na MySQL, jer Cloud SQL by MySQL ima vanjski master koji:
— služi kao proxy za vanjske MySQL;
— izgleda kao instanca MySQL;
— osmišljen je za migraciju podataka iz drugih oblaka ili On-premises.
Budući da podešavanje replikacije MySQL ne zahtijeva pristup hostu, načelno je sve to radilo pomalo nestabilno i nezgodno. A kad smo to nastavili dalje, postalo je i potpuno zastrašujuće, jer smo cijelu strukturu razvijali terraformom, a možda bi se pokazalo da vanjski master nije podržan terraformom. Da, Google ima CLI, ali iz nekog razloga, i tu je sve radilo povremeno — ponekad se stvara, ponekad ne. Možda zato što je CLI osmišljen za migraciju podataka izvana, a ne za replikate.
U biti, postalo je jasno da Cloud SQL potpuno ne odgovara. Kao što se kaže, učinili smo sve što smo mogli.
Opcija rješenja br. 2
Budući da nismo mogli ostati unutar Cloud SQL, pokušali smo formulirati zahtjeve za kompromisno rješenje. Zahtjevi su se pokazali sljedećima:
- rad u Kubernetesu, maksimalno iskorištavanje resursa i mogućnosti Kubernetesa (DCS, …) i GCP (LB, …);
- nedostatak balasta od hrpe nepotrebnih stvari u oblaku poput HA proxy;
- mogućnost pokretanja HA PostgreSQL ili MySQL u glavnoj regiji; u ostalim regijama — HA iz RR glavne regije plus njezina kopija (za pouzdanost);
- multi master (nije bilo želje povezivanja s njim, ali to nije bilo presudno)
.
Kao rezultat ovih zahtjeva, na horizontu su se napokon pojavile mogućnosti.odgovarajuće opcije SDB-a i povezivanja:
- MySQL Galera;
- CockroachDB;
- PostgreSQL alati
:
— pgpool-II;
— Patroni.
MySQL Galera
Tehnologiju MySQL Galera razvila je firma Codership i predstavlja plugin za InnoDB. Osobitosti:
- multi master;
- sinhrona replikacija;
- čitanje s bilo kojeg čvora;
- pisanje na bilo koji čvor;
- ugrađeni mehanizam HA;
- ima Helm chart od Bitnami.
CockroachDB
Prema opisu, stvar je potpuno fenomenalna i predstavlja open source projekt napisan u Go. Glavni učesnik — Cockroach Labs (osnovali bivši radnici Google-a). Ova relacijska SDB prvotno je stvorena da bude distribuirana (s horizontalnim skaliranjem "iz kutije") i otporna na greške. Autori iz kompanije postavili su cilj "spojiti bogatstvo funkcionalnosti SQL-a s horizontalnom dostupnošću, svojstvenom za NoSQL rešenja."
Kao prijatan bonus — podrška za PostgreSQL protokol povezivanja.
Pgpool
Ovo je nadogradnja za PostgreSQL, zapravo nova entitet, koja preuzima sve veze i obrađuje ih. Ima svoj load balancer i parser, licencira se prema BSD licenci. Pruža široke mogućnosti, ali izgleda pomalo zastrašujuće, jer postojanje nove entitete može postati izvor dodatnih izazova.
Patroni
Ovo je posljednje na što sam naišao, i ispostavilo se da nije bez razloga. Patroni — open source alat koji, zapravo, predstavlja demon na Pythonu, koji omogućava automatsko održavanje klastera PostgreSQL s raznim tipovima replikacije i automatskim prebacivanjem uloga. Stvar se pokazala vrlo zanimljivom, jer se dobro integrira s Kubernetesom i ne nosi nikakve nove entitete.
Što smo na kraju odabrali
Izbor nije bio lak:
- CockroachDB — odličan, ali pomalo riskantan;
- MySQL Galera — takođe nije loše, koristi se u mnogim mestima, ali MySQL;
- Pgpool — mnogo suvišnih entiteta, slaba integracija s cloud-om i K8s;
- Patroni — odlična integracija s K8s, nema suvišnih entiteta, dobro se integrira s GCP LB.
Tako da je izbor pao na Patroni.
Zaključci
Došlo je vreme za kratko sumiranje. Da, svet IT infrastrukture se značajno promenio, i ovo je samo početak. Iako su ranije cloudovi bili samo druga vrsta infrastrukture, sada je sve drugačije. Štaviše, inovacije u cloud-u se neprestano pojavljuju, nastaviće se pojavljivati, i možda će se pojavljivati isključivo u cloud-ima, a zatim, snagom startapa, prenositi na On-premises.
Što se tiče SQL-a, SQL će opstati. To znači da trebate poznati PostgreSQL i MySQL te znati raditi s njima, ali je još važnije znati ih pravilno primijeniti.
Izvor: habr.com
