

Kada je novogodišnji Olivier bio pojeden, nisam imao što raditi, pa sam odlučio preuzeti sve članke s HabrHabra (i srodnih platformi) i istražiti ih.
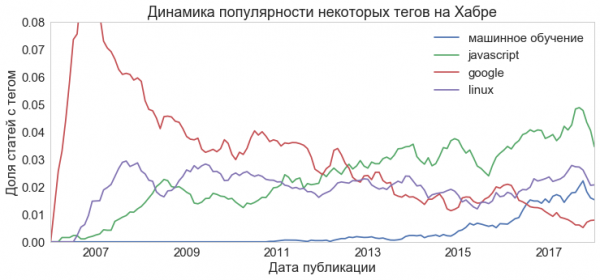
Ispalo je nekoliko zanimljivih tema. Prva od njih je razvoj formata i tematike članaka tijekom 12 godina postojanja stranice. Na primjer, dinamika nekih tema je vrlo ilustrativna. Nastavak - u nastavku.
Proces parsiranja
Kako bih razumio kako se Habr razvijao, trebao sam proći kroz sve njegove članke i izdvojiti iz njih meta informacije (na primjer, datume). Prolazak je bio jednostavan, jer su linkovi na sve članke u obliku 'habrahabr.ru/post/337722/', a brojevi su strogo poredani. Znajući da posljednji post ima broj nešto manji od 350 tisuća, jednostavno sam prošao kroz sve moguće id-ove dokumenata u petlji (kôd na Pythonu):
import numpy as np
from multiprocessing import Pool
with Pool(100) as p:
    docs = p.map(download_document, np.arange(350000))
Funkcija download_document pokušava učitati stranicu s odgovarajućim id-om i iz strukture html-a izvući sadržajnu informaciju.
import requests
from bs4 import BeautifulSoup

def download_document(pid):
    """ Preuzmi i obradi Habr dokument i njegove komentare """
    # preuzimanje dokumenta
    r = requests.get('https://habrahabr.ru/post/' + str(pid) + '/')
    # parsiranje dokumenta
    soup = BeautifulSoup(r.text, 'html5lib') # umjesto html.parser
    doc = {}
    doc['id'] = pid
    if not soup.find("span", {"class": "post__title-text"}):
        # to se događa ako članak ne postoji ili je uklonjen
        doc['status'] = 'title_not_found'
    else:
        doc['status'] = 'ok'
        doc['title'] = soup.find("span", {"class": "post__title-text"}).text
        doc['text'] = soup.find("div", {"class": "post__text"}).text
        doc['time'] = soup.find("span", {"class": "post__time"}).text
        # kreirajte druga polja: hubovi, oznake, pregledi, komentari, glasovi itd.
        # ...
    # spremanje rezultata u zasebnu datoteku
    fname = r'files/' + str(pid) + '.pkl'
    with open(fname, 'wb') as f:
        pickle.dump(doc, f)
Tijekom parsiranja otkrio sam nekoliko novih stvari.
Prvo, kažu da je beskorisno stvoriti više procesa nego što je jezgri u procesoru. No, u mom slučaju se pokazalo da je ograničavajući resurs - ne procesor, već mreža, i 100 procesa radi brže nego 4 ili, recimo, 20.
Drugo, u nekim postovima pojavili su se spektakularni simboli — na primjer, eufemizmi tipa '%&#@'. Ispostavilo se da html.parser, kojeg sam prvotno koristio, reagira na kombinaciju &# bolno, smatrajući to početkom html-entiteta. Već sam mislio da ću se upustiti u crnu magiju, ali su mi na forumu rekli da mogu jednostavno promijeniti parser.
Treće, uspio sam preuzeti sve objave osim tri. Dokumente pod brojevima 65927, 162075 i 275987 odmah je obrisao moj antivirus. To su članci o lancu JavaScript-a koji učitava zlonamjerni pdf, SMS ucjenjivaču u obliku skupa dodataka za preglednike, i stranici CrashSafari.com koja prisiljava iPhone-ove na ponovno pokretanje. Jedan članak antivirus je otkrio kasnije, tijekom skeniranja sustava: post 338586 o skriptama na web stranici trgovine za kućne ljubimce koje koriste procesor korisnika za rudarenje kriptovaluta. Tako da se može smatrati da antivirus obavlja prilično dobar posao.
"Živih" članaka bilo je samo polovica od potencijalnog maksimuma — 166307 komada. Za ostale Habr daje mogućnosti "stranica je zastarjela, bila je obrisana ili nije nikada ni postojala". Pa, svašta se događa.
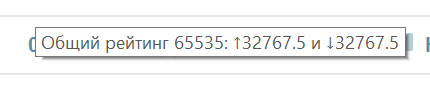
Nakon preuzimanja članaka uslijedio je tehnički rad: na primjer, datumi objave trebali su se prevesti iz formata "’21. prosinca 2006. u 10:47" u standardni datetime, a "12,8k" pregleda — u 12800. U ovoj fazi pojavilo se još nekoliko zanimljivosti. Najzabavnija je povezana s brojanjem glasova i tipovima podataka: u nekim starim postovima došlo je do preopterećenja inta, i oni su dobili po 65535 glasova.
Kao rezultat, tekstovi članaka (bez slika) zauzeli su mi 1.5 gigabajta, komentari s metainformacijama još 3, a oko stotinu megabajta — metainformacije o člancima. To se može u potpunosti držati u radnoj memoriji, što me iznenadilo.
Analizu članaka započeo sam ne s tekstovima, već s metainformacijama: datumima, oznakama, hubovima, pregledima i "lajkovima". Ispostavilo se da i ona može puno toga ispričati.
Trendi razvoja HabrHabra
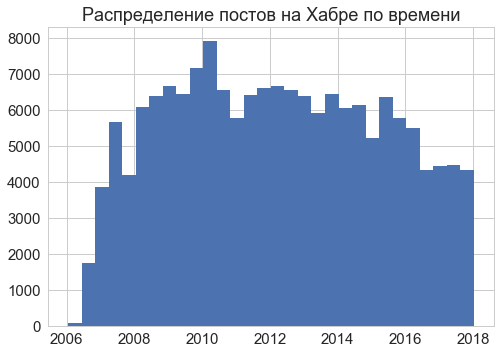
Članci na stranici objavljuju se od 2006. godine; najintenzivnije — od 2008. do 2016. godine.
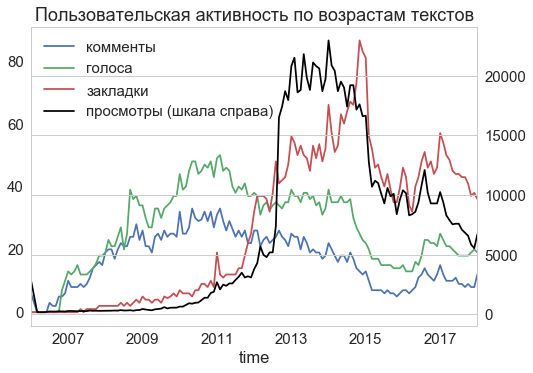
Nije lako procijeniti koliko su aktivno ti članci čitani u različitim vremenima. Tekstovi iz 2012. i mlađi aktivnije su komentirani i bodovani, ali noviji tekstovi imaju više pregleda i dodavanja u oznake. Te su metrike ponašale se identično (pala su za dvostruko) samo jednom, 2015. godine. Možda je, u situaciji ekonomskih i političkih kriza, pažnja čitatelja prešla s IT blogova na bolnija pitanja.
Osim samih članaka, preuzela sam i komentare na njih. Ukupno je bilo 6 milijuna komentara, ali 240 tisuća od njih je bilo zabranjeno ("NLO je sletio i objavio ovu poruku ovdje"). Korisna osobina komentara je to što je za njih navedeno vrijeme. Istražujući vrijeme komentara, može se otprilike shvatiti i kada se članci uopće čitaju.
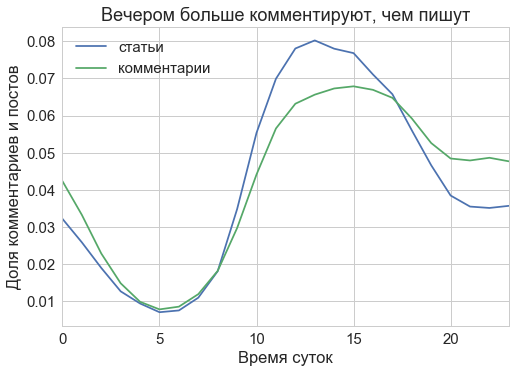
Ispostavilo se da se većina članaka piše i komentira negdje između 10 i 20 sati, tj. u tipičnom moskovskom radnom danu. To može značiti da se Habr čita u profesionalne svrhe, kao i da je to dobar način za procrastinaciju na poslu. Usput, ova raspodjela tijekom dana ostala je stabilna od samog osnivanja Habra do danas.
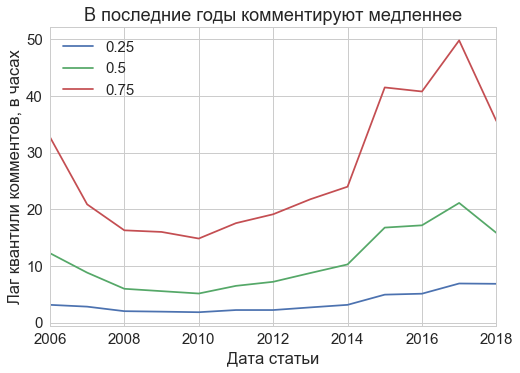
Međutim, glavna korist od vremenskog oznaka komentara nije vrijeme dana, već trajanje "aktivnog života" članka. Izračunala sam kako je raspodijeljeno vrijeme od objavljivanja članka do njegovog komentara. Ispostavilo se da trenutni medijan komentara (zelena linija) dolazi otprilike nakon 20 sati, tj. u prvih 24 sata nakon objave ostavi se u prosjeku nešto više od polovice svih komentara na članak. A za dva dana ostavi se 75% svih komentara. Pri tome su se prije članci čitali još brže — tako, 2010. godine polovica komentara dolazila je već u prvih 6 sati.
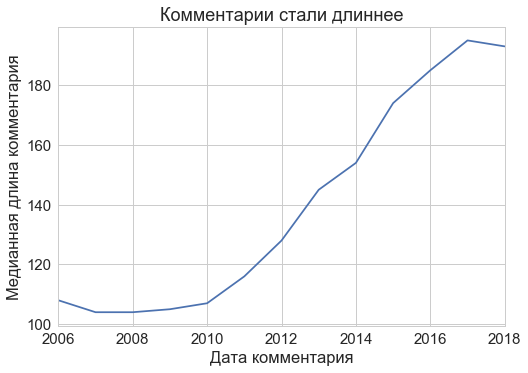
Za mene je bilo iznenađenje da su se komentari produžili: prosječan broj znakova u komentaru tijekom postojanja Habra gotovo se udvostručio!
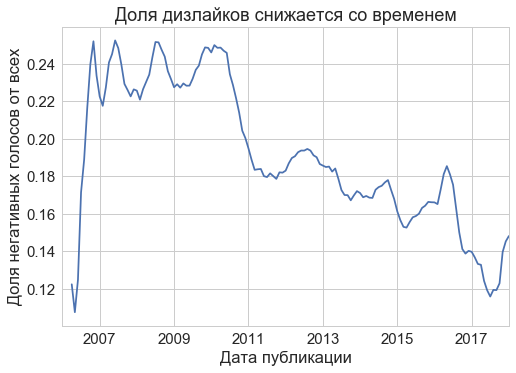
Jednostavnija povratna informacija od komentara su glasovi. Za razliku od mnogih drugih resursa, na Habru možete dodavati ne samo pluseve, nego i minuse. Ipak, čitatelji ne koriste često ovu posljednju mogućnost: trenutni udio neslaganja iznosi oko 15% od svih danih glasova. Ranije je bilo više, ali s vremenom su čitatelji postali dobri.
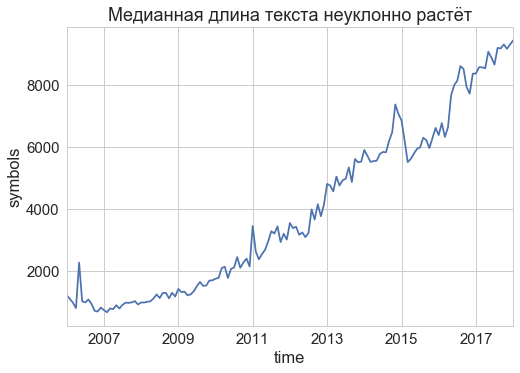
Tekstovi su se s vremenom mijenjali. Na primjer, tipična dužina teksta neprestano raste od samog pokretanja sajta, unatoč krizama. Tijekom deset godina tekstovi su postali gotovo deset puta duži!
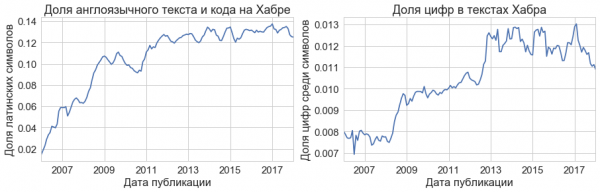
Stilistika tekstova (u prvom pristupu) također se mijenjala. U prvim godinama postojanja Habra, na primjer, porastao je udio koda i brojeva u tekstovima:
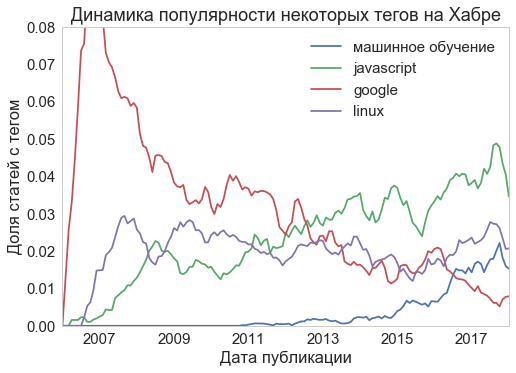
Nakon što sam se upoznao s općom dinamikom web stranice, odlučio sam izmjeriti kako su se mijenjale popularnosti različitih tema. Tematski sadržaj se može automatski izdvojiti iz tekstova, no za početak možemo iskoristiti gotove oznake koje su postavili autori svake vijesti. Četiri tipična trenda prikazana su na grafu. Tema "Google" je izvorno dominirala (vjerojatno, uglavnom zbog SEO optimizacije), no s godinama je gubila na važnosti. Javascript je bila popularna tema i nastavlja biti, dok je strojno učenje počelo brzo stjecati popularnost tek u posljednjim godinama. Linux ostaje jednako relevantan tijekom cijelog desetljeća.
Naravno, zanimalo me koje teme privlače najviše pažnje čitatelja. Izračunao sam medijanu broja pregleda, glasova i komentara za svaku temu. Evo što sam dobio:
- Najviše pregledane teme: arduino, web dizajn, web razvoj, pregled, linkovi, css, html, html5, nginx, algoritmi.
- Najviše "lajkabilne" teme: vk, humor, jquery, opera, c, html, web razvoj, html5, css, web dizajn.
- Najviše raspravljane teme: opera, skype, freelance, vk, ubuntu, posao, nokia, nginx, arduino, firefox.
Usput, pošto uspoređujem teme, možemo napraviti njihov rang prema učestalosti (i usporediti rezultate s ).
- Tijekom svih godina postojanja Habra, najpopularnije oznake (redoslijedom opadajuće popularnosti) postali su google, android, javascript, microsoft, linux, php, apple, java, python, programiranje, startupi, razvoj, ios, startup, društvene mreže.
- Godine 2017. najpopularniji su bili javascript, python, java, android, razvoj, linux, c++, programiranje, php, c#, ios, strojno učenje, informatička sigurnost, microsoft, react.
Prilikom usporedbe ovih rang listi možemo primijetiti, primjerice, pobjednički hod Pythona i izumiranje php-a, ili "zalazak" startup teme i uspon strojnog učenja.
Nisu svi tagovi na Habr-u tako očigledno tematski obojeni. Evo, na primer, deset tagova koji su se pojavili samo jednom, ali su mi delovali zabavno. Dakle: "ideja pokretač napretka", "učitavanje sa slike diskete", "država Iowa", "dramaturgija", "super Aleša", "parni stroj", "čime se baviti subotom", "imam lisicu u mlinu", "a ispalo je kao i obično", "nismo uspeli da smislimo smešne tagove". Da bismo odredili temu takvih članaka, tagovi nisu dovoljni — potrebno je izvršiti tematsko modelovanje nad tekstovima članaka.
Detaljnija analiza sadržaja članaka biće u sledećem postu. Prvo, planiram da izradim model koji predviđa broj pregleda članka u zavisnosti od njegovog sadržaja. Drugo, želim da naučim neuronsku mrežu da generiše tekstove u istom stilu kao i autori Habr-a. Dakle, pratite me 🙂
P.S. A evo i zamagljenog .
Izvor: habr.com
