

Pozdrav, Habrovi! Ova knjiga je pogodna za svakog programera koji želi razumjeti obradu podataka u stvarnom vremenu. Razumijevanje distribuiranog programiranja pomoći će vam bolje proučiti Kafka i Kafka Streams. Bilo bi dobro poznavati i sam framework Kafka, no to nije obavezno: reći ću vam sve što trebate znati. Iskusni programeri Kafke, kao i početnici, zahvaljujući ovoj knjizi naučit će kako stvoriti zanimljive aplikacije za obradu podataka s bibliotekom Kafka Streams. Java programeri srednje i visoke razine, koji su već navikli na takve pojmove kao što je serijalizacija, naučit će primjenjivati svoje vještine za izradu aplikacija Kafka Streams. Izvorni kod knjige napisan je na Javi 8 i značajno koristi sintaksu lambda izraza Jave 8, stoga će vam znanje rada s lambda funkcijama (čak i na drugom programskom jeziku) biti od koristi.
Isječak. 5.3. Agregacija i prozorske operacije
U ovom odjeljku prelazimo na proučavanje najperspektivnijih dijelova Kafka Streams. Do sada smo razmotrili sljedeće aspekte Kafka Streams:
- kreiranje topologije obrade;
- korištenje stanja u aplikacijama za obradu podataka;
- izvršavanje spajanja tokova podataka;
- razlike između tokova događaja (KStream) i tokova ažuriranja (KTable).
U sljedećim primjerima spojit ćemo sve te elemente zajedno. Osim toga, upoznat ćete se s prozorskim operacijama — još jednom izvrsnom mogućnošću aplikacija za obradu podataka. Naš prvi primjer bit će jednostavna agregacija.
5.3.1. Agregacija volumena prodaje dionica po industrijama
Agregacija i grupiranje su od vitalne važnosti pri radu s podacima u stvarnom vremenu. Istraživanje pojedinih zapisa dok dolaze često se pokazuje nedovoljnim. Kako biste iz podataka izvukli dodatne informacije, potrebni su grupiranje i kombiniranje.
U ovom primjeru trebat ćete preuzeti ulogu intra-dnevnog trgovca koji treba pratiti volumene prodaje dionica kompanija u nekoliko industrija. Konkretno, zanimaju vas pet kompanija s najvećim volumenima prodaje dionica u svakoj industriji.
Za takvu agregaciju bit će potrebno nekoliko sljedećih koraka za pretvorbu podataka u željeni oblik (ako govorimo u općim crtama).
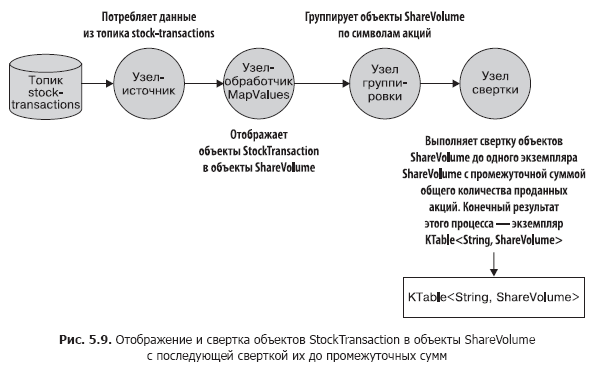
- Stvorite izvor temeljen na temi koji objavljuje neobrađene informacije o trgovini dionicama. Morat ćemo prikazati objekt tipa StockTransaction u objekt tipa ShareVolume. Naime, objekt StockTransaction sadrži metapodatke prodaje, dok su nam potrebni samo podaci o broju prodanih dionica.
- Grupirajte podatke ShareVolume po simbolima dionica. Nakon grupiranja po simbolima, možete smanjiti te podatke na međuzbroj volumena prodaje dionica. Vrijedi napomenuti da metoda KStream.groupBy vraća instancu tipa KGroupedStream. A da biste dobili instancu KTable, morate dalje pozvati metodu KGroupedStream.reduce.
Što je KGroupedStream sučelje?
Metode KStream.groupBy i KStream.groupByKey vraćaju instancu KGroupedStream. KGroupedStream je međurezultatska reprezentacija toka događaja nakon grupiranja po ključevima. Nije namijenjena izravnom radu s njom. Umjesto toga, KGroupedStream se koristi za operacije agregacije, čiji rezultat uvijek predstavlja KTable. Kako su rezultati operacija agregacije KTable i koriste pohranu stanja, moguće je da neće sve promjene rezultata biti poslane dalje kroz cjevovod.
Metoda KTable.groupBy vraća sličan KGroupedTable — međurezultatsku reprezentaciju toka ažuriranja, reorganiziranih po ključu.
Napravimo kratku pauzu i pogledajmo sliku 5.9, koja pokazuje što smo postigli. Ova topologija bi vam već trebala biti dobro poznata.
Pogledajmo sada kod za ovu topologiju (možete ga pronaći u datoteci src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (popis 5.2).
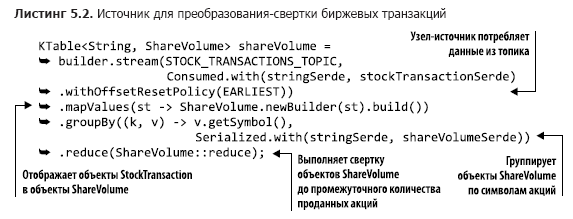
Prikazani kod odlikuje se sažetost i velikom količinom akcija provedenih u nekoliko redaka. U prvom parametru metode builder.stream možete primijetiti nešto novo za vas: vrijednost enumeriranog tipa AutoOffsetReset.EARLIEST (postoji također i LATEST), koja se postavlja pomoću metode Consumed.withOffsetResetPolicy. Ova enumeracija omogućuje da odredite strategiju ponovnog postavljanja offset-a za svaki KStream ili KTable, ona ima prioritet nad parametrom ponovnog postavljanja offset-a iz konfiguracije.
GroupByKey i GroupBy
U sučelju KStream postoje dvije metode za grupiranje zapisa: GroupByKey i GroupBy. Obje vraćaju KGroupedTable, pa se može postaviti pitanje: koja je razlika između njih i kada koristiti koju?
Metoda GroupByKey se primjenjuje kada su ključevi u KStream već popunjeni. A najvažnije, oznaka " zahtijeva ponovnu particionaciju" nikada nije postavljena.
Metoda GroupBy podrazumjeva da ste promijenili ključeve za grupiranje, tako da je oznaka ponovne particionacije postavljena na true. Izvršenje nakon metode GroupBy spojeva, agregacija itd. rezultirat će automatskom ponovnom particionacijom.
Zaključak: potrebno je iskoristiti GroupByKey umjesto GroupBy kad god je to moguće.
Što metode mapValues i groupBy rade — jasno je, pa pogledajmo metodu sum() (može se pronaći u datoteci src/main/java/bbejeck/model/ShareVolume.java) (listing 5.3).
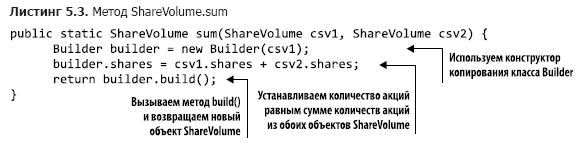
Metoda ShareVolume.sum vraća privremenu sumu volumena prodaje dionica, dok je rezultat cijelog niza izračuna objekt KTable. Sada razumijete koju ulogu igra KTable. Kada objekti ShareVolume stignu, u odgovarajućem objektu KTable se pohranjuje posljednje ažuriranje. Važno je ne zaboraviti da se sva ažuriranja odražavaju u prethodnom shareVolumeKTable, ali ne šalju se svi dalje.
Dalje, pomoću ovog KTable-a izvršavamo agregaciju (po broju prodanih dionica) kako bismo dobili pet kompanija s najvećim volumenom prodaje dionica u svakoj industriji. Naše radnje će biti slične onima u prvoj agregaciji.
- Izvršite još jednu operaciju groupBy za grupiranje pojedinačnih objekata ShareVolume prema industrijama.
- Počnite sa zbrajanjem objekata ShareVolume. Ovaj put objekt agregiranja predstavlja red s prioritetom fiksne veličine. U takvom redu fiksne veličine pohranjuju se samo pet kompanija s najvećim brojem prodanih dionica.
- Prikažite redove iz prethodne točke u string vrijednosti i vratite pet najprodavanijih prema broju dionica po industrijama.
- Zapišite rezultate u string formatu u temu.
Na slici 5.10 prikazan je graf topologije kretanja podataka. Kao što vidite, drugi ciklus obrade je prilično jednostavan.
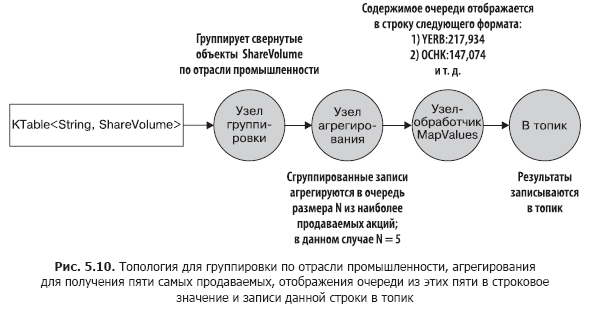
Sada, jasno shvativši strukturu ovog drugog ciklusa obrade, možete se obratiti njegovom izvoru (naći ćete ga u datoteci src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listing 5.4).
U ovom inicijalizatoru postoji varijabla fixedQueue. To je prilagođeni objekt — adapter za java.util.TreeSet, koji se koristi za praćenje N najvećih rezultata po opadajućem redoslijedu broja prodanih dionica.
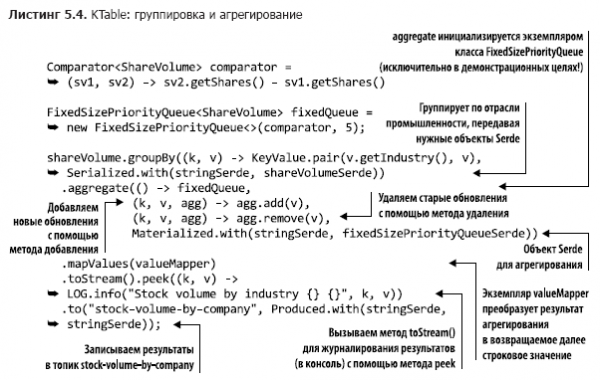
Već ste se susreli s pozivima groupBy i mapValues, pa se nećemo zadržavati na njima (pozivamo metodu KTable.toStream, jer se smatralo da je metoda KTable.print zastarjela). Međutim, još niste vidjeli KTable verziju metode aggregate(), tako da ćemo potrošiti malo vremena na njezino razmatranje.
Kao što se sjećate, KTable se razlikuje po tome što se zapisi s istim ključevima smatraju ažuriranjima. KTable zamjenjuje stari zapis novim. Agregacija se odvija na sličan način: agregiraju se najnoviji zapisi s istim ključem. Kada novi zapis dođe, dodaje se u instancu klase FixedSizePriorityQueue pomoću sumatora (drugi parametar u pozivu metode aggregate), ali ako već postoji drugi zapis s istim ključem, stari zapis se uklanja pomoću oduzimača (treći parametar u pozivu metode aggregate).
To sve znači da naš agregator, FixedSizePriorityQueue, ne agregira sve vrijednosti s istim ključem, već čuva klizni zbroj količina N najprodavanijih vrsta dionica. U svakom novom zapisu nalazi se ukupna količina prodanih dionica do sada. KTable će vam dati informacije o tome koje se dionice kojih kompanija trenutno najviše prodaju, a klizno agregiranje svake od ažuriranja nije potrebno.
Naučili smo raditi dvije važne stvari:
- grupirati vrijednosti u KTable prema zajedničkom ključu;
- provoditi nad tim grupiranim vrijednostima korisne operacije poput zbrajanja i agregacije.
Sposobnost izvođenja ovih operacija je važna za razumijevanje značenja podataka koji prolaze kroz aplikaciju Kafka Streams i otkrivanje koje informacije nose.
Ujedinili smo nekoliko ključnih pojmova koji su ranije raspravljani u ovoj knjizi. U poglavlju 4 govorili smo koliko je važno imati otpornu, lokalnu stanje za aplikacije za streaming. Prvi primjer iz ovog poglavlja pokazao je zašto je lokalno stanje od vitalnog značaja — omogućava praćenje informacija koje ste već vidjeli. Lokalan pristup pomaže u izbjegavanju mrežnih kašnjenja, čime aplikacija postaje učinkovitija i otpornija na greške.
Prilikom izvođenja bilo koje operacije preklapanja ili agregacije potrebno je odrediti naziv skladišta stanja. Operacije preklapanja i agregacije vraćaju instancu KTable, a KTable koristi skladište stanja za zamjenu starih rezultata novima. Kao što ste vidjeli, nije svaka ažuriranja poslana dalje kroz cijev, što je važno jer su operacije agregacije namijenjene dobivanju konačnih informacija. Ako se ne koristi lokalno stanje, KTable će slati dalje sve rezultate agregacije i preklapanja.
Sljedeće ćemo razmotriti izvođenje operacija kao što su agregacija unutar određenog vremenskog razdoblja — tzv. operacije prozora (windowing operations).
5.3.2. Operacije prozora
U prethodnom odjeljku upoznali smo se s "kliznim" preklapanjem i agregacijom. Aplikacija je neprekidno provodila preklapanje volumena prodaje dionica, nakon čega se agregirao pet najprodavanijih dionica na burzi.
Ponekad su ovakve neprekidne agregacije i preklapanja rezultata potrebne. A ponekad je potrebno izvršiti operacije samo za određeno vremensko razdoblje. Na primjer, izračunati koliko je burzovnih transakcija s dionicama određene kompanije izvršeno u posljednjih 10 minuta. Ili koliko je korisnika kliknulo na novu reklamnu baner tijekom posljednjih 15 minuta. Aplikacija može izvršavati takve operacije više puta, ali s rezultatima koji se odnose samo na određeno vremensko razdoblje (vremenska okna).
Brojanje burzovnih transakcija po kupcu
U sljedećem primjeru bavimo se praćenjem burzovnih transakcija za nekoliko trgovaca — bilo za velike organizacije ili za snalažljive financiste-samoće.
Postoje dva moguća razloga za ovo praćenje. Jedan od njih je potreba da se zna što kupuju/prodaju tržišni lideri. Ako ti veliki igrači i iskusan investitori vide prilike za sebe, ima smisla slijediti njihove strategije. Drugi razlog je želja da se primijete bilo kakvi znakovi nezakonitih transakcija koristeći povjerljive informacije. Za to će vam biti potrebno analizirati korelaciju velikih porasta prodaje s važnim priopćenjima za medije.
Takvo praćenje se sastoji od sljedećih faza:
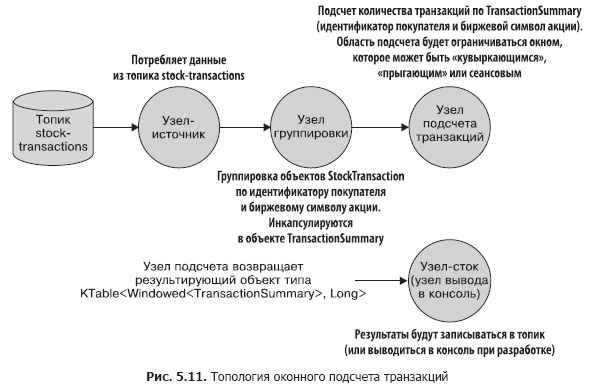
- izrada toka za čitanje iz topica stock-transactions;
- grupiranje ulaznih zapisa po identifikatoru kupca i simbolu dionice. Poziv metode groupBy vraća instancu klase KGroupedStream;
- vraćanje metodom KGroupedStream.windowedBy toka podataka, ograničenog vremenskim prozorom, što omogućuje obavljanje agregacije na prozoru. Ovisno o vrsti prozora, vraća se ili TimeWindowedKStream ili SessionWindowedKStream;
- brojanje transakcija za agregacijski operaciju. Prozorski tok podataka određuje hoće li se određeni zapis uzeti u obzir pri ovom brojanju;
- zapisivanje rezultata u topic ili ispisivanje na konzolu tijekom razvoja.
Topologija ove aplikacije je jednostavna, ali pregledna slika ne bi naškodila. Pogledajmo sl. 5.11.
Nakon toga ćemo razmotriti funkcionalnost prozorskih operacija i pripadajući kod.
Tipovi prozora
U Kafka Streams postoje tri vrste prozora:
- sezonski;
- „prevrćući“ (tumbling);
- klizni/„skakači“ (sliding/hopping).
Koji odabrati — ovisi o poslovnim zahtjevima. „Prevrćući“ i „skakači“ prozori su vremenski ograničeni, dok su ograničenja sezonskih prozora povezana s aktivnostima korisnika — trajanje sesije(-a) određuje se isključivo ponašanjem korisnika. Važno je ne zaboraviti da se svi tipovi prozora temelje na oznakama datuma/vremena zapisa, a ne na sistemskom vremenu.
Nakon toga ćemo implementirati našu topologiju za svaki od tipova prozora. Potpuni kod bit će naveden samo u prvom primjeru, dok za ostale tipove prozora ništa neće biti promijenjeno osim tipa prozorske operacije.
Sezonski prozori
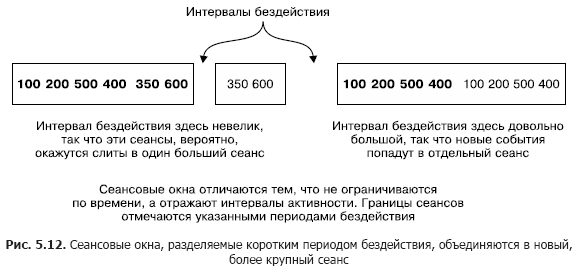
Prozori sesija se značajno razlikuju od svih ostalih tipova prozora. Oni su ograničeni ne toliko vremenom koliko aktivnošću korisnika (ili aktivnošću entiteta koji biste želeli pratiti). Prozori sesija se razdvajaju periodima neaktivnosti.
Slika 5.12 ilustrira pojam prozora sesija. Manja sesija će se spojiti s sesijom lijevo od nje. Sesija desno će biti odvojena, jer slijedi dug period neaktivnosti. Prozori sesija se temelje na aktivnostima korisnika, ali koriste oznake datuma/vremena iz zapisa za određivanje kojoj sesiji zapis pripada.
Korištenje prozora sesija za praćenje burzovnih transakcija
Iskoristit ćemo prozore sesija za zadržavanje informacija o burzovnim transakcijama. Implementacija prozora sesija prikazana je u popisu 5.5 (koji se može pronaći u datoteci src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
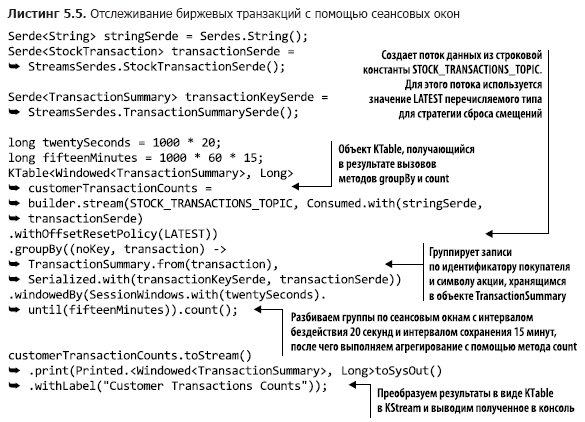
Većinu operacija ove topologije ste već susreli, tako da nema potrebe da ih ponovo razmatramo. No, ovdje postoje i neki novi elementi koje ćemo sada raspraviti.
Prilikom svake operacije groupBy obično se vrši neka operacija agregacije (agregacija, kompresija ili prebrojavanje). Može se provesti akumulativna agregacija s tekućim zbrojem, ili prozorska agregacija, pri čemu se uzimaju u obzir zapisi unutar određenog vremenskog prozora.
Kod iz popisa 5.5 broji broj transakcija unutar prozora sesija. Na slici 5.13 te se radnje analiziraju korak po korak.
Pozivom windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)) stvaramo prozor sesija s intervalom neaktivnosti od 20 sekundi i intervalom zadržavanja od 15 minuta. Interval neaktivnosti od 20 sekundi znači da će aplikacija uključiti svaki zapis koji dođe unutar 20 sekundi od završetka ili početka trenutne sesije u trenutnu (aktivnu) sesiju.
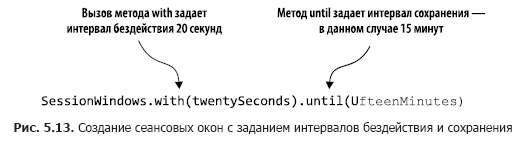
Dalje navodimo koju operaciju agregacije treba izvršiti u sesijskom prozoru — u ovom slučaju count. Ako ulazni zapis ispadne izvan granica intervala neaktivnosti (s bilo koje strane od oznake vremena), aplikacija stvara novu sesiju. Interval zadržavanja znači održavanje sesije određeno vrijeme i omogućava kašnjenje podataka koji izlaze iz razdoblja neaktivnosti sesije, ali se još uvijek mogu pridružiti. Osim toga, početak i kraj nove sesije koja nastaje spajanjem odgovaraju najranijoj i najkasnijoj oznaci vremena.
Razmotrite nekoliko zapisa iz metode count kako bismo vidjeli kako funkcionišu sesije (tab. 5.1).
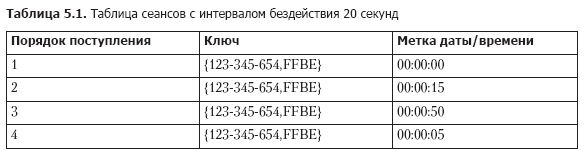
Kada stignu zapisi, tražimo već postojeće sesije sa istim ključem, koje završavaju manje od trenutne oznake vremena — interval neaktivnosti i koje počinju više od trenutne oznake vremena + interval neaktivnosti. Uzimajući to u obzir, četiri zapisa iz tab. 5.1 spajaju se u jednu sesiju na sljedeći način.
1. Prvo dolazi zapis 1, tako da je vrijeme početka jednako vremenu završetka i iznosi 00:00:00.
2. Zatim dolazi zapis 2, i tražimo sesije koje se završavaju najkasnije u 23:59:55 i počinju najkasnije u 00:00:35. Nalazimo zapis 1 i spajamo sesije 1 i 2. Uzimamo vrijeme početka sesije 1 (ranije) i vrijeme završetka sesije 2 (kasnije), tako da naša nova sesija počinje u 00:00:00 i završava u 00:00:15.
3. Dolazi zapis 3, tražimo sesije između 00:00:30 i 00:01:10 i ne nalazimo nijednu. Dodajemo drugu sesiju za ključ 123-345-654,FFBE, koja počinje i završava u 00:00:50.
4. Dolazi zapis 4, i tražimo sesije između 23:59:45 i 00:00:25. Ovaj put nalazimo obje sesije — 1 i 2. Sve tri sesije spajaju se u jednu, s vremenom početka 00:00:00 i vremenom završetka 00:00:15.
Iz iznetog u ovom poglavlju treba zapamtiti sljedeće važne nijanse:
- sesije nisu prozori fiksne veličine. Trajanje sesije određuje se aktivnošću unutar zadanog vremenskog okvira;
- oznake vremena u podacima određuju ulazi li događaj u postojeću sesiju ili u razdoblje neaktivnosti.
Dalje ćemo razgovarati o sljedećem tipu prozora — „prevrtajući” prozori.
„Prevrtajući” prozori
„Prevrnuta“ (tumbling) okna hvata događaje koji se javljaju unutar određenog vremenskog perioda. Zamislite da trebate zabilježiti sve burzovne transakcije neke tvrtke svake 20 sekundi, tako da prikupljate sve događaje unutar tog vremenskog razdoblja. Na kraju od 20-sekundnog intervala, okno se „prevrće“ i prelazi na novi 20-sekunda interval promatranja. Slika 5.14 ilustrira ovu situaciju.
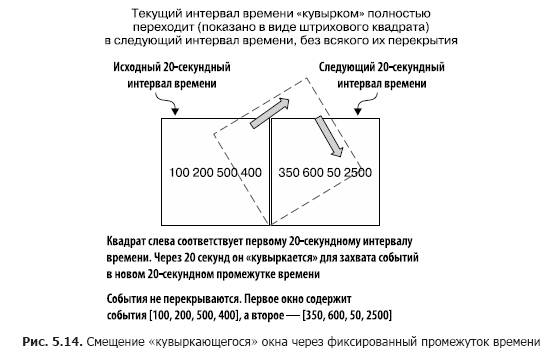
Kao što možete vidjeti, svi događaji koji su se dogodili u posljednjih 20 sekundi uključeni su u okno. Nakon tog vremenskog perioda stvara se novo okno.
U listingu 5.6 prikazan je kod koji demonstrira korištenje „prevrnutih“ okna za hvatanje burzovnih transakcija svake 20 sekundi (možete ga pronaći u datoteci src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
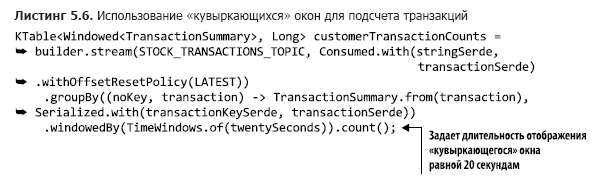
Zahvaljujući ovoj maloj promjeni poziva metode TimeWindows.of moguće je koristiti „prevrnuto“ okno. U ovom primjeru nema poziva metode until(), zbog čega će se koristiti zadani interval čuvanja od 24 sata.
Na kraju, vrijeme je da pređemo na posljednju vrstu okna — „skočna“ (hopping) okna.
Sklizna („skočna“) okna
Sklizna/„skočna“ (sliding/hopping) okna su slična „prevrnutim“ oknima, ali s malom razlikom. Sklizna okna ne čekaju završetak vremenskog intervala prije nego što stvore novo okno za obradu nedavnih događaja. Pokreću nove proračune nakon intervala čekanja, koji je manji od trajanja okna.
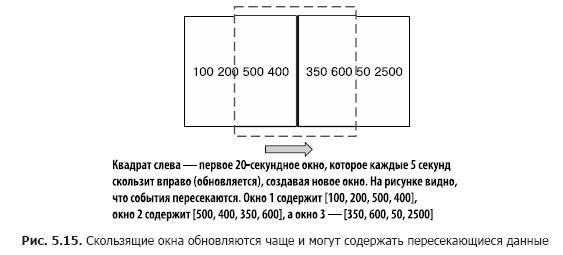
Za ilustraciju razlika između „prevrnutih“ i „skočnih“ okna, vratimo se primjeru s brojanjem burzovnih transakcija. Naš cilj ostaje brojanje transakcija, ali ne želimo čekati cijelo vremensko razdoblje prije nego što ažuriramo brojač. Umjesto toga, ažurirat ćemo brojač u kraćim vremenskim intervalima. Na primjer, i dalje ćemo brojati transakcije svake 20 sekundi, ali ćemo ažurirati brojač svake 5 sekundi, kao što je prikazano na slici 5.15. Na taj način imamo tri rezultatska okna s preklapajućim podacima.
U listingu 5.7 prikazan je kod za definiranje skliznih okna (možete ga pronaći u datoteci src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
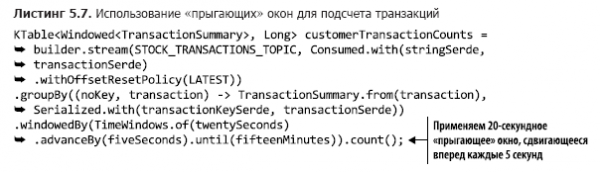
Window that is 'rolling' can be transformed into a 'jumping' one by adding a call to the advanceBy() method. In the example provided, the retention interval is 15 minutes.
In this section, you've seen how to limit aggregation results with time windows. Specifically, I would like you to remember the following three things from this section:
- the size of session windows is limited not by the time interval, but by user activity;
- 'Rolling' windows provide insight into events over a specified period of time;
- the duration of 'jumping' windows is fixed, but they are frequently updated and can contain overlapping entries across all windows.
Next, we will learn how to convert KTable back to KStream for joining.
5.3.3. Joining KStream and KTable objects
In chapter 4, we discussed joining two KStream objects. Now we need to learn how to join KTable and KStream. This may be necessary for the following simple reason. KStream is a stream of records, while KTable is a stream of record updates, but sometimes additional context may need to be added to the stream of records using updates from KTable.
Let's take the data on the number of stock transactions and join it with stock news relevant to the respective industries. Here’s what needs to be done to achieve this considering the existing code.
- Convert the KTable object with the data on the number of stock transactions into KStream, replacing the key with the key representing the industry corresponding to that stock symbol.
- Create a KTable object that reads data from the topic with stock news. This new KTable will be categorized by industries.
- Join the news updates with information about the number of stock transactions by industries.
Now let's see how to implement this action plan.
Converting KTable to KStream
To convert KTable to KStream, the following steps need to be taken.
- Call the KTable.toStream() method.
- Using the KStream.map method call, replace the key with the name of the industry, and then extract the TransactionSummary object from the Windowed instance.
We will link these operations in the following chain (the code can be found in the file src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.8).
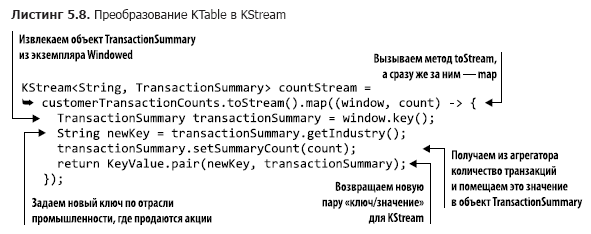
Budući da izvršavamo operaciju KStream.map, ponovno sekcioniranje za vraćeni primjerak KStream-a automatski se vrši prilikom njegove upotrebe u spajanju.
Završili smo proces transformacije, sada moramo stvoriti objekt KTable za čitanje burzovnih vijesti.
Stvaranje KTable za burzovne vijesti
Na sreću, za stvaranje objekta KTable dovoljna je samo jedna linija koda (ovaj kod možete pronaći u datoteci src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.9).
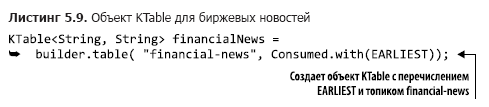
Treba napomenuti da nije potrebno navoditi nikakve Serde objekte, budući da se koriste stringovni Serde u postavkama. Također, zahvaljujući primjeni enumeracije EARLIEST, tablica se puni zapisima na samom početku.
Sada se možemo prebaciti na završni korak – spajanje.
Spajanje ažuriranja vijesti s podacima o broju transakcija
Stvaranje spajanja nije teško. Iskoristit ćemo lijevo spajanje slučaja kada u odgovarajućoj industriji nema burzovnih vijesti (potreban kod možete pronaći u datoteci src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.10).
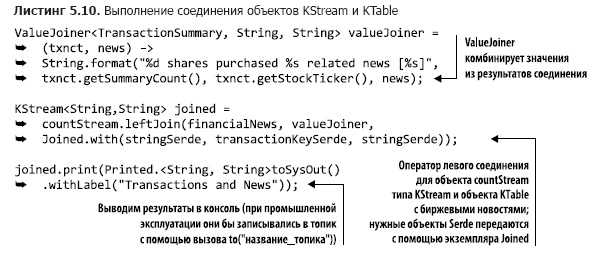
Ovaj operator leftJoin je prilično jednostavan. Za razliku od spajanja iz poglavlja 4, metoda JoinWindow se ne koristi, budući da pri izvedbi spajanja KStream-KTable postoji samo jedan zapis za svaki ključ u KTable. Ovo spajanje nije vremenski ograničeno: zapis ili postoji u KTable ili ne postoji. Glavna poruka: putem objekta KTable možete obogatiti KStream rjeđe ažuriranim referentnim podacima.
A sada ćemo razmotriti učinkovitiji način obogaćivanja događaja iz KStream-a.
5.3.4. Objekti GlobalKTable
Kao što ste shvatili, postoji potreba za obogaćivanjem tokova događaja ili dodavanjem konteksta. U poglavlju 4 ste vidjeli spajanje dvaju objekata KStream, a u prethodnom odjeljku – spajanje KStream-a i KTable-a. U svim tim slučajevima potrebno je ponovo sekcionirati tok podataka prilikom prebacivanja ključeva na novi tip ili vrijednost. Ponekad se ponovo sekcioniranje izvršava eksplicitno, a ponekad to Kafka Streams čini automatski. Ponovno sekcioniranje je potrebno jer su se ključevi promijenili i zapisi trebaju biti u novim sekcijama, inače spajanje neće biti moguće (to je raspravljano u poglavlju 4, u odjeljku „Ponovno sekcioniranje podataka“ pododjeljka 4.2.4).
Ponovno dijeljenje ima svoju cijenu
Ponovno dijeljenje zahtijeva troškove — dodatne troškove resursa za stvaranje privremenih tema, čuvanje dupliciranih podataka u još jednoj temi; također znači povećanje kašnjenja zbog pisanja i čitanja iz te teme. Štoviše, ako je potrebno izvršiti povezivanje po više aspekata ili dimenzija, potrebno je organizirati povezivanja u lancu, prikazati zapise s novim ključevima i ponovo provesti proces ponovnog dijeljenja.
Povezivanje s manjim skupovima podataka
U nekim slučajevima, količina referentnih podataka s kojima planiramo povezivanje je relativno mala, tako da se njihova potpuna kopija može smjestiti lokalno na svaki od čvorova. Za takve situacije u Kafka Streams predviđena je klasa GlobalKTable.
Instancije GlobalKTable su jedinstvene jer aplikacija replicira sve podatke na svaki od čvorova. A s obzirom da na svakom od čvorova postoje svi podaci, nije potrebno dijeliti tok događaja po ključu referentnih podataka kako bi bio dostupan svim sekcijama. Pomoću objekata GlobalKTable možemo također izvoditi bezključna povezivanja. Vratimo se jednom od prethodnih primjera kako bismo demonstrirali ovu mogućnost.
Povezivanje objekata KStream s objektima GlobalKTable
U pododjeljku 5.3.2 izveli smo vremensko agregiranje burzovnih transakcija po kupcima. Rezultati ovog agregiranja izgledali su otprilike ovako:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Iako su ti rezultati odgovarali postavljenoj cilju, bilo bi zgodnije kada bi se također ispisivao ime klijenta i puno ime kompanije. Kako bismo dodali ime kupca i naziv kompanije, mogli bismo izvesti uobičajena povezivanja, ali bi to zahtijevalo stvaranje dva prikaza ključeva i ponovno dijeljenje. Pomoću GlobalKTable možemo izbjeći troškove takvih operacija.
Za to ćemo iskoristiti objekt countStream iz popisa 5.11 (odgovarajući kod može se pronaći u datoteci src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), povezujući ga s dva objekta GlobalKTable.
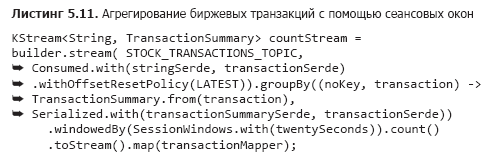
Već smo o tome razgovarali ranije, pa neću ponavljati. Međutim, istaknuo bih da je kod u funkciji toStream().map radi bolje čitljivosti apstrahiran u objekt-funkciju umjesto ugradbene lambda izraze.
Sljedeći korak je deklaracija dva primjerka GlobalKTable (prikazani kod možete pronaći u datoteci src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listanje 5.12).
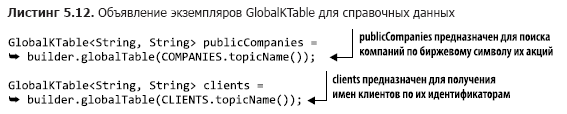
Obratite pažnju da su nazivi tema opisani pomoću enumeracijskih tipova.
Sada kada smo pripremili sve komponente, još je potrebno napisati kod za povezivanje (koji se može naći u datoteci src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listanje 5.13).
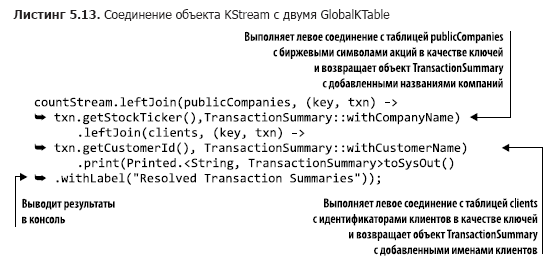
Iako ovaj kod sadrži dva povezivanja, organizirani su u obliku lanca, jer ni jedan od njihovih rezultata nije korišten odvojeno. Rezultati se ispisuju na kraju cijele operacije.
Kada pokrenete gornju operaciju povezivanja, dobit ćete rezultate sljedećeg tipa:
{customer='Barney, Smith' company="Exxon", transactions= 17}Suština se nije promijenila, ali ovi rezultati izgledaju razumljivije.
Ako računamo poglavlje 4, već ste vidjeli nekoliko tipova povezivanja u akciji. Oni su navedeni u tablici 5.2. Ova tablica odražava mogućnosti povezivanja relevantne za verziju 1.0.0 Kafka Streams; u budućim izdanjima, možda će se nešto promijeniti.
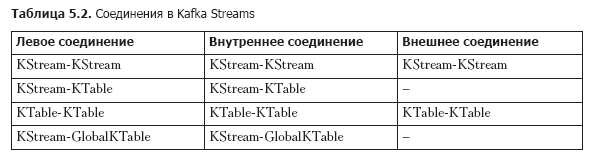
Zaključno, podsjetit ću na osnovno: možete povezivati tokove događaja (KStream) i tokove ažuriranja (KTable) pomoću lokalnog stanja. Osim toga, ako je veličina referentnih podataka malo, možete iskoristiti objekt GlobalKTable. GlobalKTable replicira sve sekcije na svaki čvor aplikacije Kafka Streams, osiguravajući time dostupnost svih podataka bez obzira na to kojoj sekciji pripada ključ.
Dalje ćemo vidjeti mogućnost Kafka Streams koja omogućuje praćenje promjena stanja bez konzumiranja podataka iz Kafka teme.
5.3.5. Stanje dostupno za upite
Već smo izvodili nekoliko operacija koje uključuju stanje i uvijek smo ispisivali rezultate na konzolu (za razvojne svrhe) ili ih snimali u temu (za industrijske svrhe). Prilikom snimanja rezultata u temu, potrebno je koristiti Kafka potrošača za njihovo pregledavanje.
Čitanje podataka iz ovih tema može se smatrati vrstom materializiranih prikaza (materialized views). Za naše potrebe može se koristiti definicija materializiranog prikaza iz "Wikipedije": „...fizički objekt baze podataka koji sadrži rezultate izvršenja upita. Na primjer, može biti lokalna kopija udaljenih podataka, ili podskup redaka i/ili stupaca tablice ili rezultata spajanja, ili sažeta tablica koja je dobijena agregiranjem“ (https://en.wikipedia.org/wiki/Materialized_view).
Kafka Streams također omogućuje izvršavanje interaktivnih upita (interactive queries) na skladištima stanja, što omogućuje izravno čitanje ovih materializiranih prikaza. Važno je napomenuti da upit na skladište stanja ima karakter operacije „samo za čitanje“. Zahvaljujući tome možete biti sigurni da nećete slučajno učiniti stanje nesuglasnim tijekom obrade podataka aplikacijom.
Mogućnost izravnih upita na skladištima stanja ima veliku važnost. To znači da se mogu stvarati aplikacije — informacijske ploče bez potrebe da se prvo podaci dobivaju od potrošača Kafke. Također povećava učinkovitost aplikacije, jer nije potrebno ponovo zapisivati podatke:
- zbog lokalnosti podataka, na njih se može brzo pristupiti;
- isključuje se dupliciranje podataka, budući da se oni ne zapisuju u vanjsko skladište.
Najvažnije što bih volio da zapamtite: možete izravno izvršavati upite na stanju iz aplikacije. Ne može se precijeniti mogućnosti koje vam to pruža. Umjesto da konzumirate podatke iz Kafke i pohranjujete zapise u bazu podataka za aplikaciju, možete izvršavati upite na skladištima stanja s istim rezultatom. Izravni upiti na skladištima stanja znače manji volumen koda (nedostatak potrošača) i manje softverskog rješenja (nedostatak potrebe za tablicom baze podataka za pohranu rezultata).
Obuhvatili smo značajan volumen informacija u ovom poglavlju, stoga ćemo na trenutak prekinuti našu raspravu o interaktivnim upitima na skladištima stanja. No, ne brinite: u poglavlju 9 stvorit ćemo jednostavnu aplikaciju — informacijski panel s interaktivnim upitima. Za demonstraciju interaktivnih upita i mogućnosti njihovog dodavanja u aplikacije Kafka Streams koristit ćemo neke od primjera iz ovog i prethodnog poglavlja.
Sažetak
- KStream objekti predstavljaju tokove događaja, slične upisima u bazu podataka. KTable objekti predstavljaju tokove ažuriranja, više su slični ažuriranjima u bazi podataka. Veličina KTable objekta ne raste, stari unosi se zamjenjuju novima.
- KTable objekti su nužni za operacije agregacije.
- Pomoću operacija prozora moguće je razdvojiti agregirane podatke prema vremenskim košaricama.
- Uz GlobalKTable objekte možete pristupiti referentnim podacima s bilo kojeg mjesta unutar aplikacije, bez obzira na podjelu po sekcijama.
- Moguće su međusobne veze između KStream, KTable i GlobalKTable objekata.
Do sada smo se fokusirali na izradu aplikacija Kafka Streams pomoću visokorazinskog DSL KStream. Iako visokorazinski pristup omogućava stvaranje urednih i sažetih programa, njegovo korištenje predstavlja određeni kompromis. Rad s DSL KStream znači povećanu sažetost koda na račun smanjenja kontrole. U sljedećem poglavlju razmotrit ćemo niskorazinski API čvorova-obraditelja i isprobati druge kompromise. Programi će biti duži nego što su bili do sada, ali ćemo imati mogućnost stvaranja gotovo bilo kojeg čvora-obraditelja koji nam može zatrebati.
→ Više detalja o knjizi možete pronaći na
→ Za Habržitelje popust od 25% putem kupona — Kafka Streams
→ Nakon plaćanja fizičke verzije knjige, elektronska knjiga se šalje na e-mail.
Izvor: habr.com
