

Željeli bismo opisati jedan zanimljiv mehanizam rada s konfiguracijom distribuiranog sustava. Konfiguracija je predstavljena izravno u kompiliranom jeziku (Scala) koristeći sigurne tipove. U ovom postu razrađen je primjer takve konfiguracije i razmotreni su različiti aspekti implementacije kompilirane konfiguracije u opći proces razvoja.
()
Uvod
Izgradnja pouzdanog distribuiranog sustava podrazumijeva da se na svim čvorovima koristi ispravna konfiguracija, usklađena s drugim čvorovima. Obično se koriste tehnologije DevOps (terraform, ansible ili nešto slično) za automatsko generiranje konfiguracijskih datoteka (često svojih za svaki čvor). Također bismo željeli biti sigurni da se na svim međusobno povezanim čvorovima koriste identični protokoli (uključujući istu verziju). U suprotnom, u našem distribuiranom sustavu će biti prisutna nekompatibilnost. U svijetu JVM-a jedna od posljedica takvog zahtjeva je potreba za korištenjem istih verzija biblioteka koje sadrže poruke protokola.
Što se tiče testiranja distribuiranog sustava? Naravno, pretpostavljamo da su za sve komponente osigurani unit testovi prije nego što pređemo na integracijsko testiranje. (Kako bismo mogli ekstrapolirati rezultate testiranja u runtime, također moramo osigurati identičan skup biblioteka u fazi testiranja i u runtime-u.)
Pri radu s integracijskim testovima često je jednostavnije posvuda koristiti jedinstveni classpath na svim čvorovima. Preostaje nam samo osigurati da se isti classpath koristi i u runtime-u. (Iako je sasvim moguće pokretati različite čvorove s različitim classpath-ima, to dovodi do kompliciranja cjelokupne konfiguracije i poteškoća s implementacijom i integracijskim testovima.) U okviru ovog posta polazimo od pretpostavke da će se na svim čvorovima koristiti isti classpath.
Konfiguracija se razvija zajedno s aplikacijom. Za identifikaciju različitih faza evolucije programa koristimo verzije. Očito je logično također identificirati i različite verzije konfiguracija. A samu konfiguraciju smjestiti u sustav kontrole verzija. Ako u produkciji postoji jedinstvena konfiguracija, možemo jednostavno koristiti broj verzije. Međutim, ako se koristi više instanci produkcije, trebat će nam nekoliko
grana konfiguracije i dodatna oznaka pored verzije (na primjer, naziv grane). Tako ćemo moći jednoznačno identificirati točnu konfiguraciju. Svaki identifikator konfiguracije jednoznačno odgovara određenoj kombinaciji distribuiranih čvorova, portova, vanjskih resursa, verzija biblioteka. U okviru ovog posta polazimo od pretpostavke da postoji samo jedna grana i možemo identificirati konfiguraciju na uobičajen način koristeći tri broja odvojena točkom (1.2.3).
U suvremenim okruženjima konfiguracijske datoteke ručno se kreiraju prilično rijetko. Često se generiraju tijekom implementacije i više se ne dotiču (da ). Postavlja se logično pitanje, zašto još uvijek koristimo tekstualni format za pohranu konfiguracije? Sasvim održiva alternativa izgleda mogućnost korištenja običnog koda za konfiguraciju i dobivanje prednosti kroz provjere tijekom kompajliranja.
U ovom postu istražujemo ideju predstavljanja konfiguracije unutar kompajliranog artefakta.
Kompajlirana konfiguracija
U ovom odjeljku razmatramo primjer statičke kompajrirane konfiguracije. Realiziraju se dvije jednostavne usluge — echo usluga i klijent echo usluge. Na temelju ovih dviju usluga konstruiraju se dvije varijante sustava. U jednoj varijanti obje usluge smještene su na jednom čvoru, u drugoj varijanti — na različitim čvorovima.
Obično distribuirani sustav sadrži više čvorova. Čvorovi se mogu identificirati pomoću vrijednosti nekog tipa NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ili
case class NodeId(hostName: String)ili čak
object Singleton
type NodeId = Singleton.type
Čvorovi izvršavaju različite uloge, na njima su pokrenute usluge i između njih mogu biti uspostavljene TCP/HTTP veze.
Za opis TCP veze potrebno nam je najmanje broj porta. Također bismo željeli odražavati protokol koji se podržava na tom portu kako bismo osigurali da i klijent i poslužitelj koriste isti protokol. Opišimo vezu koristeći ovu klasu:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])gdje Port — jednostavno cijeli broj Int uz naznaku raspona dopuštenih vrijednosti:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Precizirani tipovi
Pogledajte biblioteku i . Ukratko, biblioteka omogućava dodavanje ograničenja tipovima koja se provjeravaju u vrijeme kompilacije. U ovom slučaju dopuštene vrijednosti broja porta su cijeli 16-bitni brojevi. Za konfiguraciju koja se kompilira korištenje biblioteke refined nije obavezno, ali omogućava poboljšanje mogućnosti kompajlera u provjeri konfiguracije.
Za HTTP (REST) protokole osim broja porta može nam također zatrebati put do usluge:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantomski tipovi
Za identifikaciju protokola u vrijeme kompilacije koristimo parametar tipa koji se ne koristi unutar klase. Ova odluka je posljedica toga što u runtime-u ne koristimo instancu protokola, ali bismo željeli da kompajler provjeri kompatibilnost protokola. Zbog naznake protokola ne možemo proslijediti nepodobnu uslugu kao zavisnost.
Jedan od raširenih protokola je REST API s Json-serializacijom:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]gdje RequestMessage — tip zahtjeva, ResponseMessage — tip odgovora.
Naravno, moguće je koristiti i drugačije opise protokola koji osiguravaju potrebnu preciznost opisa.
Za potrebe ovog posta koristit ćemo pojednostavljenu verziju protokola:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Ovdje zahtjev predstavlja niz koji se dodaje url-u, a odgovor — vraćeni niz u tijelu HTTP odgovora.
Konfiguracija usluge opisuje se imenom usluge, portovima i zavisnostima. Ove elemente možemo predstaviti u Scali na nekoliko načina (npr., HList-ima, algebarskim tipovima podataka). Za potrebe ovog posta koristit ćemo Cake Pattern i predstavljati module pomoću trait‘ov. (Cake Pattern nije obavezan dio opisane metode. To je samo jedna od mogućih implementacija.)
Odnosi između servisa mogu se predstaviti kao metode koje vraćaju portove EndPoint‘a drugih čvorova:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Za kreiranje echo servisa dovoljno je samo broj porta i naznaka da taj port podržava echo protokol. Nismo morali navoditi konkretan port, budući da traits omogućuju deklaraciju metoda bez implementacije (apstraktni metodi). U tom slučaju, prilikom kreiranja konkretne konfiguracije, kompajler bi od nas zatražio da pružimo implementaciju apstraktnog metoda i navedemo broj porta. Budući da smo implementirali metodu, prilikom kreiranja konkretne konfiguracije ne moramo navoditi drugi port. Bit će korištena zadana vrijednost.
U konfiguraciji klijenta deklariramo ovisnost o echo servisu:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Ovisnost ima isti tip kao i izvozimo servis echoService. Konkretno, u echo klijentu zahtijevamo isti protokol. Stoga, prilikom povezivanja dva servisa možemo biti sigurni da će sve raditi ispravno.
Implementacija servisa
Za pokretanje i zaustavljanje servisa potrebna je funkcija. (Mogućnost zaustavljanja servisa je kritično važna za testiranje.) I ponovno, postoje različite varijante implementacije takve funkcije (na primjer, mogli bismo koristiti tipove klasa temeljenih na tipu konfiguracije). U svrhu ovog posta koristićemo Cake Pattern. Predstavićemo servis pomoću klase cats.Resource, budući da ta klasa već predviđa sredstva za sigurno i garantirano oslobađanje resursa u slučaju problema. Da bismo dobili resurs, moramo pružiti konfiguraciju i pripremljeni runtime kontekst. Funkcija za pokretanje servisa može izgledati ovako:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
gdje
Postavke— tip konfiguracije za ovu usluguAddressResolver— objekt vremena izvođenja koji omogućuje otkrivanje adresa drugih čvorova (vidi u nastavku)
i ostale tipove iz biblioteke cats:
F[_]— tip efekta (u jednostavnijem slučajuF[A]može biti jednostavno funkcija() => A. U ovom postu koristit ćemocats.IO.)Reader[A,B]— više-manje sinonim za funkcijuA => Bcats.Resource— resurs koji se može dobiti i osloboditiTajmer— tajmer (omogućuje uspavljivanje na određeno vrijeme i mjerenje vremenskih intervala)ContextShift— analogExecutionContextApplicative— klasa tipa efekta koja omogućava kombiniranje pojedinačnih efekata (gotovo monada). U složenijim aplikacijama, očito, bolje je koristitiMonad/ConcurrentEffect.
Korištenjem ovog potpisa funkcije možemo implementirati nekoliko usluga. Na primjer, uslugu koja ne radi ništa:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Vidi. , u kojem su implementirane druge usluge — ,
i .)
Čvor predstavlja objekt koji može pokrenuti nekoliko usluga (pokretanje lanca resursa osigurano je putem Cake Patterna):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Obratite pažnju da navodimo točan tip konfiguracije koji je potreban za ovaj čvor. Ako zaboravimo navesti neki od tipova konfiguracije koji su potrebni za pojedinu uslugu, dobit ćemo grešku pri kompilaciji. Također, nećemo moći pokrenuti čvor ako ne pružimo objekt koji ima odgovarajući tip sa svim potrebnim podacima.
Razlikovanje imena čvorova
Kako bismo se spojili na udaljeni čvor, potreban nam je stvarni IP-adresa. Sasvim je moguće da adresa postane poznata kasnije od ostalih dijelova konfiguracije. Stoga nam treba funkcija koja preslikava identifikator čvora u adresu:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Može se predložiti nekoliko načina za implementaciju takve funkcije:
- Ako nam adrese postanu poznate prije raspoređivanja, onda možemo generirati Scala-kod s
adresama i zatim pokrenuti izradu. Pri tome će se izvršiti kompilacija i testiranje.
U tom slučaju funkcija će biti poznata statički i može biti predstavljena u kodu u obliku prikazaMap[NodeId, NodeAddress]. - U nekim slučajevima, važeća adresa postaje poznata tek nakon pokretanja čvora.
U ovom slučaju možemo implementirati "uslugu otkrivanja" (discovery) koja se pokreće prije ostalih čvorova, a svi čvorovi će se registrirati u ovoj usluzi i tražiti adrese drugih čvorova. - Ako možemo izmijeniti
/etc/hosts, onda se mogu koristiti unaprijed definirana imena hostova (poputmy-project-main-nodeiecho-backend) i jednostavno povezivati ta imena
s IP adresama tijekom implementacije.
U okviru ovog posta nećemo detaljnije razmatrati te slučajeve. Za naš
igre primjer svi čvorovi će imati jednu IP adresu — 127.0.0.1.
Dalje ćemo razmotriti dvije varijante distribuiranog sustava:
- Smještaj svih usluga na jednom čvoru.
- I smještaj echo usluge i echo klijenta na različitim čvorovima.
Konfiguracija za :
Konfiguracija za jedan čvor
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikator jedinog čvora
  \/\/ konfiguracija servera
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Tip sigurna specifikacija porta usluge. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfiguracija klijenta

  \/** Koristit ćemo uslugu koju pruža isti host. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ konfiguracija kontrolera životnog ciklusa
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatnih 0.5 sekundi tako da bude 10 zahtjeva, a ne 9.
}
Objekt implementira konfiguraciju i za klijenta i za server. Također se koristi konfiguracija trajanja života, kako bi se nakon intervala lifetime prekinuo rad programa. (Ctrl-C također radi i ispravno oslobađa sve resurse.)
Isti skup traitova konfiguracije i implementacija može se koristiti za stvaranje sustava koji se sastoji od :
Konfiguracija za dva čvora
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! specifikacija ovisnosti
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatnih 0.5 sekundi tako da bude 10 zahtjeva, a ne 9.

    def testMessage: String = "dolly"
  }
Važno! Obratite pažnju na način povezivanja usluga. Navodimo uslugu koju implementira jedan čvor kao implementaciju metode zavisnosti drugog čvora. Tip zavisnosti proverava se od strane kompajlera, budući da sadrži tip protokola. Tokom izvršavanja, zavisnost će sadržati tačan identifikator ciljnog čvora. Ovim sistemom navodimo broj porta samo jednom i uvek garantujemo da se upućujemo na pravi port.
Implementacija dva čvora sistema
Za ovu konfiguraciju koristimo iste implementacije usluga bez izmena. Jedina razlika je u tome što sada imamo dva objekta koja implementiraju različite setove usluga:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Prvi čvor implementira server i zahteva samo serversku konfiguraciju. Drugi čvor implementira klijent i koristi drugu konfiguraciju. Takođe, oba čvora zahtevaju upravljanje životnim ciklusom. Serverski čvor radi neograničeno dugo, sve dok ne bude zaustavljen SIGTERMklijent čvor se zatvara nakon nekog vremena. Vidi. .
Ukupni proces razvoja
Hajde da vidimo kako ovaj pristup konfigurisanju utiče na ukupni proces razvoja.
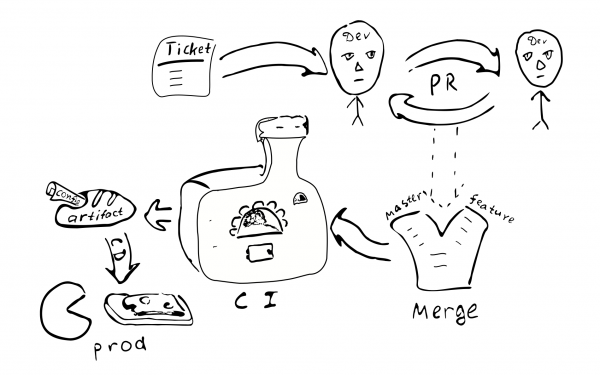
Konfiguracija će biti kompajlirana zajedno sa ostatkom koda i biće generisan artefakt (.jar). Očigledno, ima smisla staviti konfiguraciju u poseban artefakt. To je zato što možemo imati mnogo konfiguracija zasnovanih na istom kodu. Ponovo, može se generisati artefakt koji odgovara različitim granama konfiguracije. Zajedno sa konfiguracijom čuvaju se zavisnosti od specifičnih verzija biblioteka i te verzije se čuvaju zauvek, bez obzira kada odlučimo da implementiramo tu verziju konfiguracije.
Svaka promena konfiguracije postaje promena koda. Dakle, svaka takva
promena će biti obuhvaćena standardnim procesom obezbeđivanja kvaliteta:
Ulaznica u tracker grešaka -> PR -> pregled -> spajanje sa odgovarajućim granama ->
integracija -> implementacija
Glavne posledice uvođenja kompajlovane konfiguracije:
Konfiguracija će biti usklađena na svim čvorovima distribuiranog sustava. S obzirom na to da svi čvorovi primaju istu konfiguraciju iz jedinstvenog izvora.
Problematično je promijeniti konfiguraciju samo na jednom od čvorova. Stoga je „dezinhronizacija konfiguracije“ (configuration drift) malo vjerojatna.
Postaje teže unijeti male promjene u konfiguraciju.
Većina promjena konfiguracije bit će dio ukupnog razvojnog procesa i bit će podvrgnuta reviziji.
Treba li odvojeni repozitorij za pohranu produkcijske konfiguracije? Takva konfiguracija može sadržavati lozinke i druge tajne informacije čijem bismo pristupu željeli ograničiti. Iz toga proizlazi da je očigledno smisleno pohranjivati konačnu konfiguraciju u odvojenom repozitoriju. Može se podijeliti konfiguracija na dva dijela — jedan koji sadrži javno dostupne parametre konfiguracije i drugi koji sadrži parametre s ograničenim pristupom. To će većini programera omogućiti pristup zajedničkim parametrima. Takvu podjelu nije teško postići koristeći međužadnice koje sadrže zadane vrijednosti.
Moguće varijacije
Pokušajmo usporediti kompajlirane konfiguracije s nekim uobičajenim alternativama:
- Tekstualna datoteka na ciljnom stroju.
- Centralizirano skladište ključ-vrijednost (
etcd/zookeeper). - Komponente procesa koje se mogu rekonfigurirati/ponovno pokrenuti bez ponovnog pokretanja procesa.
- Pohranjivanje konfiguracije izvan artefakta i kontrole verzija.
Tekstualne datoteke pružaju značajnu fleksibilnost u pogledu malih promjena. Sustavni administrator može pristupiti udaljenom čvoru, unijeti promjene u odgovarajuće datoteke i ponovno pokrenuti servis. Za velike sustave, međutim, takva fleksibilnost može biti nepoželjna. Od izvršenih promjena ne ostaju tragovi u drugim sustavima. Nitko ne provodi reviziju promjena. Teško je utvrditi tko je točno izvršio promjene i iz kojeg razloga. Promjene se ne testiraju. Ako je sustav distribuiran, administrator može zaboraviti izvršiti odgovarajuću promjenu na drugim čvorovima.
(Također treba napomenuti da uporaba kompajlirane konfiguracije ne isključuje mogućnost korištenja tekstualnih datoteka u budućnosti. Bit će dovoljno dodati parser i validator koji daju isti tip kao izlaz) Postavke, i možemo koristiti tekstualne datoteke. Iz toga izravno slijedi da je složenost sustava s kompajliranom konfiguracijom malo manja od složenosti sustava koji koristi tekstualne datoteke, budući da su za tekstualne datoteke potrebni dodatni kodovi.)
Centralizirano skladište ključ-vrijednost je dobar mehanizam za distribuciju meta-parametara distribuirane aplikacije. Moramo se odrediti što su konfiguracijski parametri, a što su samo podaci. Neka imamo funkciju C => A => B, pri čemu su parametri C rijetko promjenjivi, a podaci A — često. U tom slučaju možemo reći da su C — konfiguracijski parametri, a A — podaci. Čini se da se konfiguracijski parametri razlikuju od podataka po tome što se u općem slučaju rjeđe mijenjaju od podataka. Također, podaci obično dolaze iz jednog izvora (od korisnika), a konfiguracijski parametri — iz drugog (od sistemskog administratora).
Ako rijetko promjenjivi parametri trebaju biti ažurirani bez ponovnog pokretanja programa, to često može dovesti do kompliciranja programa, jer ćemo morati na neki način dostavljati parametre, pohranjivati, parsirati i provjeravati, obrađivati neispravne vrijednosti. Stoga, s aspekta smanjenja složenosti programa, ima smisla smanjiti broj parametara koji se mogu mijenjati tijekom rada programa (ili potpuno ne podržavati takve parametre).
U ovom postu, razdvojit ćemo statičke i dinamičke parametre. Ako logika rada usluge zahtijeva promjenu parametara tijekom izvršavanja programa, takvi parametri nazivamo dinamičkim. U suprotnom, parametri su statički i mogu se konfigurirati pomoću kompajlirane konfiguracije. Za dinamičku rekonstrukciju možda će nam biti potreban mehanizam ponovnog pokretanja dijelova programa s novim parametrima, slično ponovnom pokretanju procesa operativnog sustava. (Smatramo da je poželjno izbjeći rekonstrukciju u stvarnom vremenu, jer time raste složenost sustava. Ako je moguće, bolje je koristiti standardne mogućnosti OS-a za ponovno pokretanje procesa.)
Jedan od važnih aspekata korištenja statičke konfiguracije koji navodi ljude na razmišljanje o dinamičkom rekonfiguriranju je vrijeme koje sustavu treba za ponovni pokretanje nakon ažuriranja konfiguracije (downtime). Uistinu, ako trebamo izvršiti promjene u statičkoj konfiguraciji, morat ćemo ponovno pokrenuti sustav kako bi nove vrijednosti stupile na snagu. Problematika downtimea ima različitu oštrinu za različite sustave. U nekim slučajevima, možemo planirati ponovno pokretanje u vrijeme kada je opterećenje minimalno. U slučaju da je potrebno osigurati neprekinutu uslugu, možemo implementirati . Kada trebamo ponovo pokrenuti sustav, pokrećemo paralelni primjerak tog sustava, prebacujemo ravnotežu opterećenja na njega i čekamo da stari konekcije završe. Nakon što su sve stare veze završene, isključujemo stari primjerak sustava.
Sada razmotrimo pitanje pohrane konfiguracije unutar artefakta ili izvan njega. Ako pohranjujemo konfiguraciju unutar artefakta, barem imamo mogućnost tijekom gradnje artefakta osigurati ispravnost konfiguracije. U slučaju da se konfiguracija nalazi izvan kontroliranog artefakta, teško je pratiti tko i zašto je izvršio promjene u toj datoteci. Koliko je to važno? Smatramo da je za mnoge proizvodne sustave važno imati stabilnu i visokokvalitetnu konfiguraciju.
Verzija artefakta omogućuje određivanje kada je stvoren, koje vrijednosti sadrži, koje su funkcije uključene/isključene, tko je odgovoran za bilo kakve promjene u konfiguraciji. Naravno, pohrana konfiguracije unutar artefakta zahtijeva određene napore, stoga je potrebno donijeti promišljenu odluku.
Argumenti za i protiv
Želio bih se osvrnuti na prednosti i nedostatke predložene tehnologije.
Prednosti
Ispod je popis osnovnih mogućnosti kompilirane konfiguracije distribuiranog sustava:
- Statistička provjera konfiguracije. Omogućuje sigurnost da je
konfiguracija ispravna. - Bogati jezik konfiguracije. Obično su drugi načini konfiguracije ograničeni na maksimalno zamjenu string varijabli. Korištenjem Scale postaje dostupna široka paleta mogućnosti jezika za poboljšanje konfiguracije. Na primjer, možemo koristiti
traitove za zadane vrijednosti, putem objekata grupirati parametre, možemo se pozivati na valove definirane jednom (DRY) u pokrivenom opsegu. Također možemo unutar konfiguracije instancirati bilo koje klase (Seq,Karta, korisničke klase). - DSL. U Scali postoji niz jezičnih mogućnosti koje olakšavaju izradu DSL-a. Možemo iskoristiti te mogućnosti i implementirati jezik konfiguracije koji bi bio pogodniji za ciljnu skupinu korisnika, tako da bi konfiguracija bila barem čitljiva stručnjacima iz predmetnog područja. Stručnjaci mogu, na primjer, sudjelovati u procesu pregleda konfiguracije.
- Integritet i sinhronizacija između čvorova. Jedna od prednosti pohrane konfiguracije cijelog distribuiranog sustava na jednoj točki je ta što se sve vrijednosti izjavljuju točno jednom, a zatim se ponovno koriste gdje god su potrebne. Korištenje fantomskih tipova za izjavivanje portova omogućava jamstvo da u svim ispravnim konfiguracijama sustava čvorovi koriste kompatibilne protokole. Postojanje eksplicitnih obaveznih ovisnosti između čvorova jamči da će svi servisi biti povezani međusobno.
- Visoka kvaliteta izmjena. Izmjene u konfiguraciji, koristeći zajednički proces razvoja, osiguravaju visoke standarde kvalitete i za konfiguraciju.
- Istovremeno ažuriranje konfiguracije. Automatsko implementiranje sustava nakon izmjena u konfiguraciji jamči da će svi čvorovi biti ažurirani.
- Pojednostavljenje aplikacije. Aplikacija ne zahtijeva parsiranje, provjeru konfiguracije i obradu neispravnih vrijednosti. Na taj način se smanjuje složenost aplikacije. (Neko dodatno kompliciranje konfiguracije, koje se može uočiti u našem primjeru, nije atribut kompajlirane konfiguracije, već svjesna odluka proizašla iz želje za većom tipnom sigurnošću.) Lako je vratiti se na uobičajenu konfiguraciju — jednostavno implementirati nedostajuće dijelove. Stoga se može, na primjer, početi s kompajliranom konfiguracijom, odlažući implementaciju dodatnih dijelova do trenutka kada je to stvarno potrebno.
- Verzionirana konfiguracija. Budući da promjene u konfiguraciji slijede uobičajeni put svih drugih promjena, na izlazu dobivamo artefakt s jedinstvenom verzijom. To nam omogućuje, na primjer, da se vratimo na prethodnu verziju konfiguracije ako je potrebno. Možemo čak iskoristiti konfiguraciju staru godinu dana i sustav će raditi točno istim načinom. Stabilna konfiguracija poboljšava predvidljivost i pouzdanost distribuiranog sustava. Budući da je konfiguracija fiksna u fazi kompajliranja, prilično je teško prevariti ju u produkciji.
- Modularnost. Predloženi okvir je modularan i moduli se mogu kombinirati u raznim varijantama za dobivanje različitih sustava. Konkretno, u jednoj varijanti može se konfigurirati sustav za pokretanje na jednom čvoru, a u drugoj — na više čvorova. Moguće je stvoriti nekoliko konfiguracija za produkcijske instance sustava.
- Testiranje. Zamjenom pojedinih servisa s mock-objektima, moguće je dobiti nekoliko verzija sustava pogodnih za testiranje.
- Integracijsko testiranje. Postojanje jedinstvene konfiguracije cijelog distribuiranog sustava omogućuje pokretanje svih komponenti u kontroliranom okruženju tijekom integracijskog testiranja. Lako je emulirati, na primjer, situaciju kada neki čvorovi postanu nedostupni.
Nedostaci i ograničenja
Kompilirana konfiguracija razlikuje se od drugih pristupa konfiguriranju i za neka aplikacije možda neće biti pogodna. U nastavku su navedeni neki nedostaci:
- Statička konfiguracija. Ponekad je potrebno brzo ispraviti konfiguraciju u produkciji, zaobilazeći sve zaštitne mehanizme. U okviru ovog pristupa to može biti teže. U svakom slučaju, kompilacija i automatsko implementiranje će se i dalje zahtijevati. To je istovremeno korisna karakteristika pristupa i nedostatak u nekim slučajevima.
- Generacija konfiguracije. U slučaju da se konfiguracijska datoteka generira automatskim alatom, mogu biti potrebni dodatni napori za integraciju skripte za izgradnju.
- Alati. Trenutno su alati i metode namijenjeni radu s konfiguracijom bazirani na tekstualnim datotekama. Nisu svi takvi alati/metode dostupni u slučaju kompilirane konfiguracije.
- Potrebna je promjena pogleda. Programeri i DevOps su navikli na tekstualne datoteke. Sama ideja kompilacije konfiguracije može biti pomalo iznenađujuća i neobična i izazvati odbijanje.
- Potreban je visokokvalitetan proces razvoja. Da bi se lako koristila kompilirana konfiguracija, potrebna je potpuna automatizacija procesa izgradnje i implementacije aplikacije (CI/CD). U suprotnom, bit će prilično nezgodno.
Obratimo pažnju i na neka ograničenja razmatranog primjera, koja nisu povezana s idejom kompilirane konfiguracije:
- Ako pružamo suvišne konfiguracijske informacije koje se ne koriste od strane čvora, kompilator nam neće pomoći otkriti odsutnost implementacije. Ovaj problem se može riješiti ako se odrekne Cake Patterna i koristi stroža tipa, na primjer,
HListili algebrijske tipove podataka (case class) za predstavljanje konfiguracije. - U datoteci konfiguracije postoje linije koje se ne odnose izravno na konfiguraciju: (
paket,uvoz, izjave objekata;override defza parametre koji imaju zadane vrijednosti. Djelomično se može izbjeći ako implementirate vlastiti DSL. Osim toga, drugi oblici konfiguracije (npr. XML) također nameću određena ograničenja na strukturu datoteke. - U okviru ovog posta ne razmatramo dinamičku rekonfiguraciju klastera sličnih čvorova.
Zaključak
U ovom postu razmatrali smo ideju predstavljanja konfiguracije u izvornoj kodu koristeći napredne mogućnosti sustava tipova Scala. Ovaj pristup može se koristiti u različitim aplikacijama kao zamjena za tradicionalne metode konfiguracije temeljene na xml- ili tekstualnim datotekama. Iako je naš primjer implementiran u Scali, iste ideje mogu se prenijeti na druge kompilirane jezike (kao što su Kotlin, C#, Swift, ...). Ovaj pristup može se isprobati u jednom od sljedećih projekata, a ako ne odgovara, prijeći na tekstualne datoteke dodajući nedostajuće detalje.
Naravno, kompilirana konfiguracija zahtijeva kvalitetan razvojni proces. U zamjenu se osigurava visoka kvaliteta i pouzdanost konfiguracija.
Razmatrani pristup može se proširiti:
- Možete koristiti makronaredbe za provedbu provjera tijekom kompilacije.
- Može se implementirati DSL za predstavljanje konfiguracije u obliku dostupnom krajnjim korisnicima.
- Može se implementirati dinamičko upravljanje resursima s automatskim prilagođavanjem konfiguracije. Na primjer, kada se promijeni broj čvorova u klasteru, potrebno je da (1) svaki čvor dobije malo drugačiju konfiguraciju; (2) menadžer klastera dobije informacije o novim čvorovima.
Zahvale
Želim zahvaliti Andreju Saksonovu, Pavlu Popovu i Antonu Nehaevu na konstruktivnoj kritici nacrta članka.
Izvor: habr.com
