

Bok, Habr! Pozivamo Data Engineere i stručnjake za Machine Learning na besplatnu demo lekciju . Također, objavljujemo članak Luca Monno — voditelja financijske analitike u CDP SpA.
Jedna od najkorisnijih i najjednostavnijih metoda mašinskog učenja je Ensemble Learning. Ensemble Learning je metoda koja stoji iza XGBoost, Bagginga, Random Foresta i mnogih drugih algoritama.
Na Towards Data Science ima mnogo sjajnih članaka, ali izabrao sam dvije priče ( i ), koje su mi se najviše svidjele. Pa zašto pisati još jedan članak o EL? Zato što želim da vam pokažem, kako to funkcioniše na jednostavnom primjeru, koji mi je dao razumijevanje da ovdje nema nikakve magije.
Kada sam prvi put vidio EL u akciji (u radu s nekoliko vrlo jednostavnih regresionih modela), nisam mogao vjerovati vlastitim očima i još uvijek se sjećam profesora koji me naučio ovoj metodi.
Imam dva različita modela (dva slaba algoritma za učenje) s R² vrijednostima out-of-sample R² jednakim 0,90 i 0,93. Prije nego što sam pogledao rezultate, mislio sam da ću dobiti R² negdje između dva izvorna vrijednosti. Drugim riječima, smatrao sam da se EL može koristiti kako bi model radio ne toliko loše kao najgori, ali ni toliko dobro kao najbolji model.
Na moje veliko iznenađenje, rezultati jednostavnog prosječenja predikcija dali su R² od 0,95.
Isprva sam počeo tražiti grešku, ali onda sam pomislio da ovdje može biti neka magija!
Što je Ensemble Learning
S EL se mogu spojiti predikcije dvaju ili više modela kako bi se dobio pouzdaniji i efikasniji model. Postoji mnogo metodologija za rad s ansamblima modela. Ovdje ću se dotaknuti dvije najkorisnije kako bih dao opći pregled.
Pomoću regresije možemo prosječiti performanse postojećih modela.
Pomoću klasifikacije možemo omogućiti modelima da biraju etikete. Etiketa koja je najčešće birana - ona će biti odabrana novim modelom.
Zašto EL djeluje bolje
Glavni razlog zbog kojeg EL bolje funkcionira je taj što svaka prognoza ima pogrešku (to znamo iz teorije vjerojatnosti), a kombiniranje dviju prognoza može pomoći u smanjivanju pogreške, a posljedično poboljšati performanse (RMSE, R² itd.).
Na sljedećem dijagramu prikazano je kako dva slaba algoritma rade s skupom podataka. Prvi algoritam ima veći nagib nego što je potrebno, dok je kod drugog gotovo nula (možda zbog prekomjerne regularizacije). Ali ensemble pokazuje mnogo bolje rezultate.
Ako pogledamo R², prvi i drugi algoritam za učenje imat će vrijednosti -0.01¹, 0.22, redom, dok će ensemble imati 0.73.
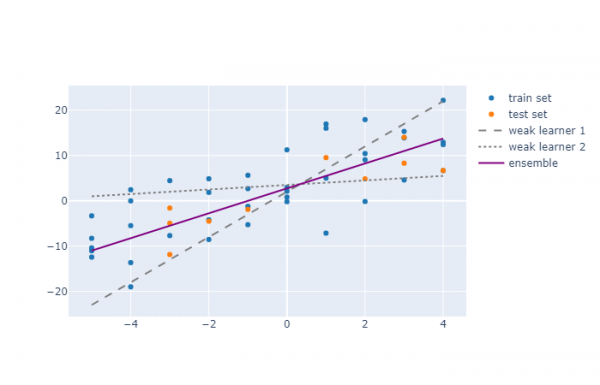
Postoji mnogo razloga zbog kojih algoritam može biti loš model čak i u tako osnovnom primjeru kao što je ovaj: možda ste odlučili koristiti regularizaciju kako biste izbjegli prekomjerno učenje, ili ste odlučili ne izostaviti neke anomalije, ili ste koristili polinomnu regresiju i odabrali pogrešan stepen (na primjer, koristili polinom drugog stepena dok je na testnim podacima vidljiva izražena asimetrija, za koju bi treći stepen bio bolji).
Kada EL bolje funkcionira
Pogledajmo dva algoritma za učenje koja rade s istim podacima.
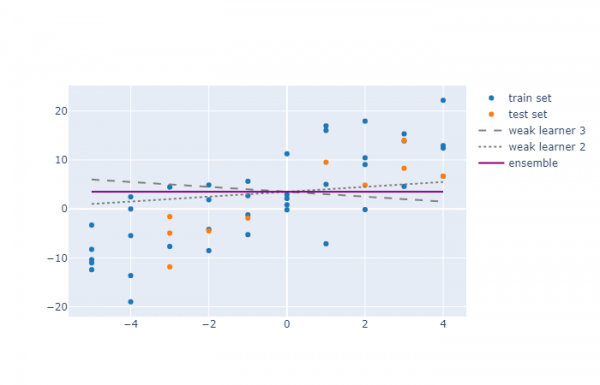
Ovde se može vidjeti da kombinacija dviju modela nije značajno poboljšala performanse. Izvorno su dva algoritma za učenje imala R² vrijednosti od -0,37 i 0,22, dok je za ensemble bila -0,04. Dakle, EL model je dobio prosječnu vrijednost pokazatelja.
Međutim, između ovih dvaju primjera postoji velika razlika: u prvom primjeru pogreške modela su bile negativno korelirale, a u drugom pozitivno (koeficijenti triju modela nisu bili procijenjeni, već su jednostavno odabrani od strane autora kao primjer.)
Stoga se Ensemble Learning može koristiti za poboljšanje ravnoteže pristranosti/varijance u bilo kojim slučajevima, ali kada pogreške modela nisu pozitivno korelirale, korištenje EL može dovesti do povećanja performansi.
Homogene i heterogene modele
Vrlo često se EL koristi na homogene modele (poput ovog primjera ili u slučajnom šumi), ali zapravo možete kombinirati različite modele (linijsku regresiju + neuronsku mrežu + XGBoost) s različitim skupovima objašnjavajućih varijabli. To će vjerojatno dovesti do nekoreliranih grešaka i povećanja performansi.
Usporedba s diverzifikacijom portfelja
EL djeluje analogno diverzifikaciji u teoriji portfelja, ali je za nas još bolje.
Pri diverzifikaciji pokušavate smanjiti disperziju vaših pokazatelja ulagajući u nekorelirane dionice. Dobro diverzificirani portfelj dionica će ostvarivati bolji pokazatelj od najgore pojedinačne dionice, ali nikada ne bolje od najbolje.
Citirajući Warrena Buffetta:
„Diverzifikacija je zaštita od neznanja, za onoga tko ne zna što radi, ona [diverzifikacija] ima vrlo malo smisla.”
U strojnog učenja, EL pomaže smanjiti disperziju vašeg modela, ali to može dovesti do stvaranja modela s ukupnim performansama boljim od najbolje izvorne modela.
Sumirajmo
Kombiniranje nekoliko modela u jedan je relativno jednostavna metoda koja može riješiti problem pristranosti disperzije i povećati performanse.
Ako imate dva ili više modela koja dobro funkcioniraju, ne birajte između njih: koristite ih sve (ali s oprezom)!
Zanima vas razvoj u ovom smjeru? Prijavite se za besplatnu Demo lekciju i sudjelujte u — Strojni inženjer u Mail.ru Grupi.
Izvor: habr.com
