

S bazom podataka Apache Cassandra i potrebom za njenim upravljanjem unutar infrastrukture temeljene na Kubernetesu susrećemo se redovito. U ovom materijalu podijelit ćemo svoje viđenje potrebnih koraka, kriterija i postojećih rješenja (uključujući pregled operatora) za migraciju Cassandre u K8s.
«Tko može upravljati ženom, može upravljati i državom»
Tko je zapravo Cassandra? To je distribuirani sustav pohrane, namijenjen upravljanju velikim količinama podataka, pružajući visoku dostupnost bez jedinstvene točke kvara. Projekt vjerojatno ne treba dug uvod, pa ću navesti samo glavne značajke Cassandre koje će biti relevantne za ovu konkretnu temu:
- Cassandra je napisana na Javi.
- Topologija Cassandre uključuje nekoliko razina:
- Čvor — jedan razmješteni primjerak Cassandre;
- Rack — skupina primjeraka Cassandre, povezanih po nekom kriteriju, unutar jednog podatkovnog centra;
- Podatkovni centar — skup svih skupina primjeraka Cassandre smještenih u jednom podatkovnom centru;
- Klaster — skup svih podatkovnih centara.
- Za identifikaciju čvora Cassandra koristi IP adresu.
- Za brzinu operacija pisanja i čitanja, dio podataka Cassandra pohranjuje u radnoj memoriji.
Sada — o potencijalnom preseljenju u Kubernetes.
Check-lista za prijenos
Govoreći o migraciji Cassandre u Kubernetes, nadamo se da će s preseljenjem upravljanje postati lakše. Što će za to biti potrebno i što će pomoći?
1. Skladište za podatke
Kao što je već navedeno, dio podataka Cassandra pohranjuje u radnoj memoriji — u Memtabli.No postoji i drugi dio podataka koji se pohranjuje na disk — u obliku SSTable.Ovim podacima pridružuje se entitet Commit Log — zapisi o svim transakcijama, koji se također pohranjuju na disk. Shema transakcija pisanja u Cassandri
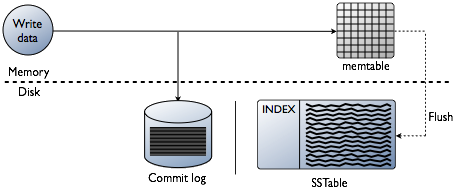
U Kubernetesu možemo koristiti PersistentVolume za pohranu podataka. Zahvaljujući razvijenim mehanizmima, rad s podacima u Kubernetesu postaje sve jednostavniji svake godine.
Svakom podu s Cassandrom dodijelit ćemo svoj PersistentVolume.
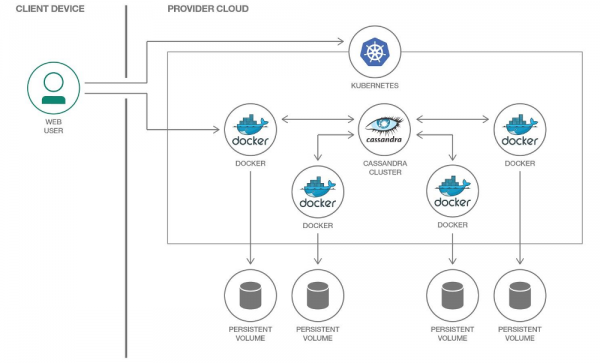
Каждому pod’у с Cassandra мы выделим свой PersistentVolume
Važno je napomenuti da Cassandra sama po sebi podrazumijeva replikaciju podataka, nudeći za to ugrađene mehanizme. Stoga, ako sastavljate Cassandra klaster od velikog broja čvorova, nije potrebno koristiti distribuirane sustave poput Ceph ili GlusterFS za pohranu podataka. U ovom slučaju logično je pohranjivati podatke na disku čvora pomoću ili montiranja hostPath.
Druga stvar je ako želite kreirati odvojeno okruženje za programere za svaku feature-granu. U tom slučaju, ispravan pristup bi bio podići jedan čvor Casseandre, a podatke pohranjivati u distribuiranom skladištu, tj. spomenuti Ceph i GlusterFS postat će vaša opcija. Na taj način, programer će biti siguran da neće izgubiti testne podatke čak i u slučaju gubitka jednog od čvorova Kubernetes klastera.
2. Monitoring
Praktički bezalternativni izbor za implementaciju monitoringa u Kubernetes je Prometheus (detaljno smo o tome govorili u ). Kako je stvar sa Cassandrom i eksportovima metrika za Prometheus? I, što je u nečemu čak i važnije, sa odgovarajućim dashboardima za Grafana?
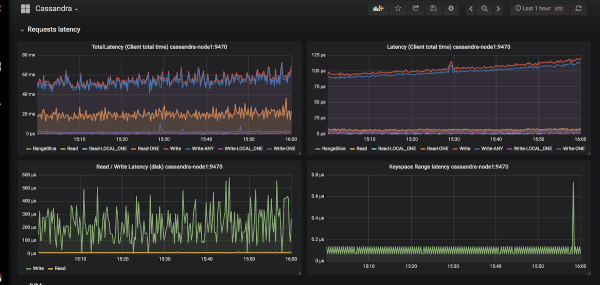
Primjer izgleda grafikona u Grafani za Cassandru
Postoje samo dva eksportera: i .
Odabrali smo prvi, zbog toga što:
- JMX Exporter raste i razvija se, dok Cassandra Exporter nije mogao dobiti potrebnu podršku zajednice. Cassandra Exporter još uvijek ne podržava većinu verzija Cassandre.
- Može se pokrenuti kao javaagent dodavanjem zastavice
-javaagent:<plugin-dir-name>\/cassandra-exporter.jar=--listen=:9180. - Za njega postoji , koji nije kompatibilan s Cassandra Exporter.
3. Odabir primitivan Kubernetes
Prema gorenavednoj strukturi klastera Cassandra, pokušajmo prevesti sve što je tamo opisano u terminologiju Kubernetes:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → pool od StatefulSets
- Cassandra Cluster → ???
Izgleda da nedostaje neka dodatna entiteta za upravljanje cijelim klasterom Casseandre odjednom. No ako nešto nedostaje, možemo to stvoriti! U Kubernetesu postoji mehanizam za definiranje vlastitih resursa — .
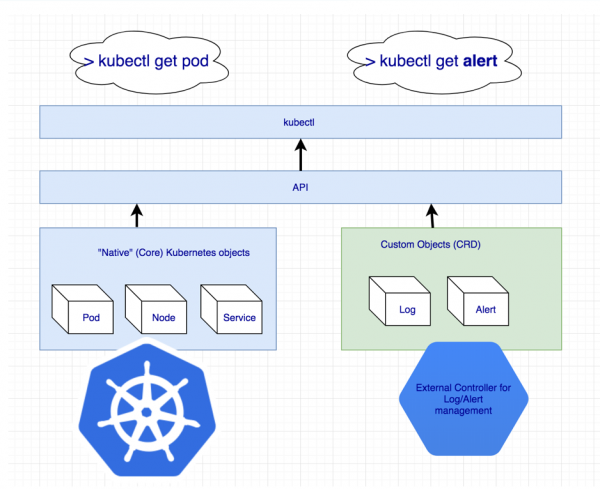
Objava dodatnih resursa za logove i obavijesti
No sam Custom Resource ne znači ništa: jer mu je potreban kontroler. Moguće je da ćemo morati zatražiti pomoć …
4. Identifikacija podova
U prethodnom stavku smo se složili da će jedan Cassandra čvor odgovarati jednom podu u Kubernetesu. Međutim, IP adrese podova će svaki put biti različite. A identifikacija čvora u Cassandri se vrši upravo na osnovu IP adrese... Ispada da nakon svakog brisanja poda, Cassandra klaster će dodavati novi čvor.
Postoji rešenje, i to ne jedno:
- Možemo pratiti identifikatore hostova (UUID, jedinstveno identifikujući instance Cassandre) ili IP adrese i sve to sačuvati u nekim strukturama/tablama. Ova metoda ima dva glavna nedostatka:
- Postoji rizik od uslova trke kada padnu dva čvora odjednom. Nakon ponovnog pokretanja, Cassandra čvorovi će istovremeno tražiti IP adresu iz tabele i konkurisati za isti resurs.
- Ako je Cassandra čvor izgubio svoje podatke, više ga ne možemo identifikovati.
- Drugo rešenje deluje kao mali trik, ali ipak: možemo kreirati Service sa ClusterIP za svaki Cassandra čvor. Problemi ove implementacije:
- Ako u Cassandra klasteru ima veoma mnogo čvorova, moraćemo da kreiramo veoma mnogo Service-a.
- Mogućnost ClusterIP se realizuje putem iptables. To može postati problem ako u Cassandra klasteru ima puno (1000... ili čak 100?) čvorova. Ipak, može rešiti ovaj problem.
- Treće rešenje je koristiti mrežu čvorova za Cassandra umesto posebne mreže podova pomoću uključivanja podešavanja
hostNetwork: true. Ova metoda postavlja određena ograničenja:- Za zamenu čvorova. Novi čvor treba da ima istu IP adresu kao prethodni (u oblacima kao što su AWS, GCP to je praktično nemoguće);
- Koristeći mrežu klasterskih čvorova, počinjemo da konkurišemo za mrežne resurse. Dakle, postavljanje više od jednog poda sa Cassandrom na jedan klaster čvor biće problematično.
5. Backupovi
Želimo da svakog planiramo da sačuvamo kompletnu verziju podataka jednog Cassandra čvora. Kubernetes pruža zgodnu mogućnost korišćenjem , ali tu nam Cassandra pravi prepreke.
Podsećam vas, deo podataka Cassandra čuva u memoriji. Da bismo napravili potpuni backup, potrebno je podatke iz memorije (Memtables) preneti na disk (SSTables). U tom trenutku Cassandra čvor prestaje da prima konekcije, potpuno isključujući se iz rada klastera.
Nakon toga se pravi backup (snapshot) i čuva se sastav (keyspace). I ovdje se otkriva da nam obična izrada sigurnosne kopije ne pomaže: potrebno je sačuvati identifikatore podataka za koje je odgovarao čvor Cassandra — to su posebni tokeni.
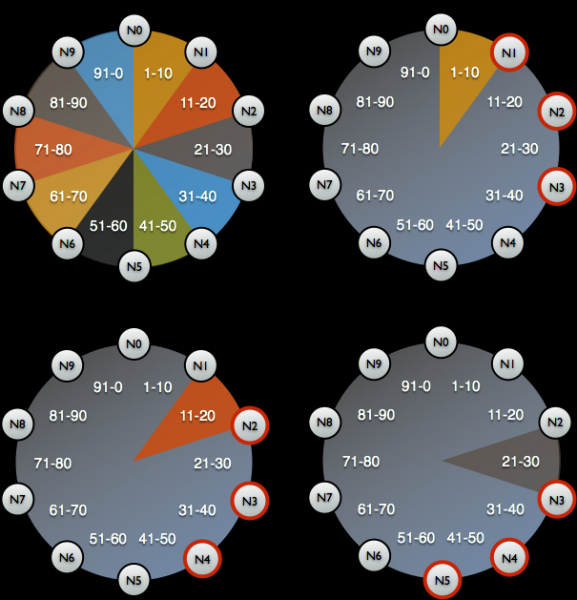
Distribucija tokena za identifikaciju podataka za koje su odgovorni čvorovi Cassandra
Primjer skripte za izradu sigurnosne kopije Cassandre s Google-a u Kubernetesu možete pronaći na . Jedina stvar koju skripta ne uzima u obzir je resetiranje podataka na čvoru prije izrade snapshot'a. Dakle, sigurnosna kopija se ne izvršava za trenutno stanje, već za stanje malo ranije. No, to pomaže da se čvor ne isključi, što se čini jako logičnim.
set -eu

if [[ -z "$1" ]]; then
  info "Molimo unesite keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Greška pri izradi snapshot-a"
  exit 1
fi

timestamp=$(echo "$result" | awk '"/Snapshot directory: /" { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Primjer bash skripte za izradu sigurnosne kopije s jednog čvora Cassandra
Spremna rješenja za Cassandu u Kubernetesu
Što se trenutno koristi za postavljanje Cassandre u Kubernetesu i što od toga najbolje odgovara zadanim zahtjevima?
1. Rješenja temeljena na StatefulSet ili Helm chartovima
Korištenje osnovnih funkcija StatefulSets za pokretanje klastera Cassandre je dobar izbor. Pomoću Helm chart-a i Go predložaka možete korisniku pružiti fleksibilno sučelje za postavljanje Cassandre.
Obično to funkcionira dobro… dok se ne dogodi nešto neočekivano — kao što je kvar čvora. Standardni alati Kubernetes-a jednostavno ne mogu uzeti u obzir sve navedene specifičnosti. Osim toga, ovaj pristup je vrlo ograničen u vezi s time koliko može biti proširen za složenije primjene: zamjene čvorova, sigurnosne kopije, oporavak, nadzor itd.
Predstavnici:
- ;
- .
Oba charta su podjednako dobra, ali su podložna gore opisanim problemima.
2. Rješenja temeljena na Kubernetes Operatoru
Ove opcije su zanimljivije jer pružaju široke mogućnosti za upravljanje klasterom. Za dizajn operatera Cassandre, kao i za bilo koju drugu bazu podataka, dobar obrazac izgleda kao Sidecar Controller CRD:
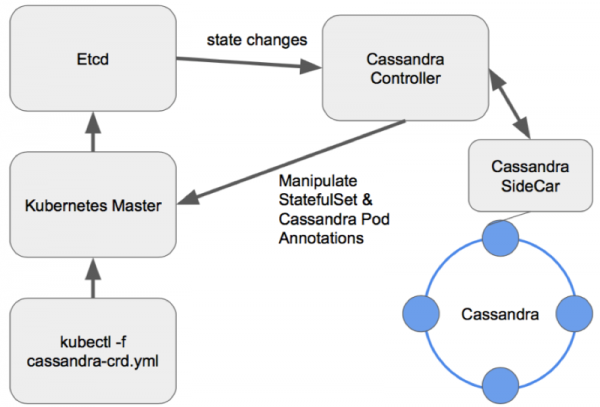
Shema upravljanja čvorovima u pravilno dizajniranom operateru Cassandre
Pogledajmo postojeće operatere.
1. Cassandra-operator od Instaclustr
- Stanje: Alpha
- Licenca: Apache 2.0
- Realizirano u: Javi
Ovo je zaista vrlo obećavajući i aktivno razvijajući projekt od kompanije koja nudi upravljane implementacije Cassandre. Kao što je ranije opisano, koristi sidecar-container koji prihvaća komande putem HTTP-a. Napisan je u Javi, stoga mu ponekad nedostaje naprednije funkcionalnosti biblioteke client-go. Također, operator ne podržava različite Rackove unutar jednog Data Centra.
Međutim, operator ima svoje prednosti, poput podrške za praćenje, visoko nivo upravljanja klasterom putem CRD-a i čak dokumentaciju za izradu sigurnosnih kopija.
2. Navigator od Jetstack
- Stanje: Alpha
- Licenca: Apache 2.0
- Realizirano u: Golangu
Operator namijenjen za implementaciju DB-as-a-Service. Trenutno podržava dvije baze podataka: Elasticsearch i Cassandru. Uključuje zanimljiva rešenja, kao što je kontrola pristupa bazi podataka putem RBAC-a (za to pokreće vlastiti navigator-apiserver). Interesantan projekt koji bi trebalo razmotriti, međutim, posljednji commit napravljen je prije godinu i pol, što očigledno smanjuje njegov potencijal.
3. Cassandra-operator od vgkowski
- Stanje: Alpha
- Licenca: Apache 2.0
- Realizirano u: Golangu
Nisu ga smatrali "ozbiljnim", jer je posljednji commit u repozitorij napravljen prije više od godinu dana. Razvoj operatora je napušten: posljednja verzija Kubernetes-a, koja se navodi kao podržana, je 1.9.
4. Cassandra-operator od Rook
- Stanje: Alpha
- Licenca: Apache 2.0
- Realizirano u: Golangu
Operator čiji se razvoj ne odvija tako brzo kao što bi to željeli. Ima promišljenu strukturu CRD-a za upravljanje klasterom, rješava problem identifikacije čvorova pomoću Servisa s ClusterIP-om (onaj 'hak')... ali zasad je to sve. Praćenje i sigurnosne kopije trenutno nisu dostupne (usput, za praćenje smo ). Zanimljiva je činjenica da se ovim operatorom može također implementirati ScyllaDB.
NB: Ovaj operator s malim doradama koristili smo u jednom od naših projekata. Tijekom cjelokupne eksploatacije (~4 mjeseca rada) nisu zabilježeni problemi u radu operatora.
5. CassKop od Orange
- Stanje: Alpha
- Licenca: Apache 2.0
- Realizirano u: Golangu
Najmlađi operator na listi: prvi commit napravljen je 23. svibnja 2019. godine. Već sada ima u svom arsenalu veliki broj funkcija iz naše liste, s kojima se može detaljnije upoznati u repozitoriju projekta. Operator je izgrađen na temelju popularnog operator-sdk-a. Podržava praćenje 'iz kutije'. Glavna razlika u odnosu na druge operatore je korištenje , implementiranog na Pythonu i korištenog za komunikaciju između nodova Cassandre.
Zaključci
Broj pristupa i mogućih opcija za migraciju Cassandre u Kubernetes govori sam za sebe: tema je vrlo zahtjevna.
U ovoj fazi, isprobavanje nečega od gore navedenog može biti na vlastiti rizik: nijedan od developera ne garantira 100%-tnu funkcionalnost svog rješenja u proizvodnom okruženju. No, već sada mnogi proizvodi izgledaju obećavajuće za korištenje u razvojnim okruženjima.
Mislim da će ubuduće ova žena na brodu biti dobrodošla!
P.S.
Pročitajte i na našem blogu:
- «»;
- «»;
- «»;
- «».
Izvor: habr.com
