

Želim podijeliti svoje prvo uspješno iskustvo u vraćanju pune funkcionalnosti baze podataka Postgres. S DBMS-om Postgres upoznao sam se prije šest mjeseci, prije tog iskustva nisam imao nikakvo iskustvo u administraciji baza podataka.
Radim kao polu-DevOps inženjer u velikoj IT tvrtki. Naša tvrtka se bavi razvojem softvera za visoko opterećene servise, a ja sam odgovoran za funkcionalnost, održavanje i implementaciju. Pred mene je postavljen standardni zadatak: ažurirati aplikaciju na jednom serveru. Aplikacija je napisana u Djangu, prilikom ažuriranja provode se migracije (promjene strukture baze podataka), a prije ovog procesa uzimamo puni dump baze podataka putem standardnog programa pg_dump, za svaki slučaj.
Tijekom uzimanja dumpa dogodila se nepredviđena greška (verzija Postgres – 9.5):
pg_dump: Uzimanje sadržaja tablice “ws_log_smevlog” nije uspjelo: PQgetResult() nije uspjelo.
pg_dump: Poruka o grešci sa servera: GREŠKA: nevaljana stranica u bloku 4123007 relacije base/16490/21396989
pg_dump: Komanda je bila: COPY public.ws_log_smevlog [...]
pg_dunp: [paralelni arhtver] radni proces neočekivano je umro
Greška «nevaljana stranica u bloku» ukazuje na probleme na razini datotečnog sustava, što nije dobro. Na raznim forumima predložili su da se napravi FULL VACUUM sa opcijom zero_damaged_pages za rješavanje ovog problema. Pa, probajmo…
Priprema za oporavak
PAŽNJA! Obavezno napravite sigurnosnu kopiju Postgresa prije bilo kakvog pokušaja oporavka baze podataka. Ako imate virtualnu mašinu, zaustavite bazu podataka i napravite snapshot. Ako nije moguće napraviti snapshot, zaustavite bazu i kopirajte sadržaj direktorija Postgres (uključujući wal-datoteke) na sigurno mjesto. Najvažnije u našem poslu je ne napraviti pogoršanje. Pročitajte .
Budući da je baza inače radila, ograničio sam se na običan dump baze podataka, ali sam isključio tablicu s oštećenim podacima (opcija -T, —exclude-table=TABLE u pg_dump).
Server je bio fizički, snapshot nije bilo moguće uzeti. Backup je napravljen, idemo dalje.
Provjera datotečnog sustava
Prije pokušaja vraćanja baze podataka potrebno je osigurati da je sve u redu s datotečnim sustavom. U slučaju grešaka, ispravite ih, jer u suprotnom možete samo pogoršati stanje.
U mom slučaju, datotečni sustav s bazom podataka bio je montiran u «/srv» i tip je bio ext4.
Zaustavljamo bazu podataka: systemctl stop postgresql@9.5-main.service provjeravamo je li datotečni sustav u upotrebi i možemo li ga odmontirati naredbom lsof:
lsof +D /srv
Trebalo je zaustaviti i redis bazu podataka jer je i ona bila u upotrebi «/srv». Zatim sam odmontirao /srv (umount).
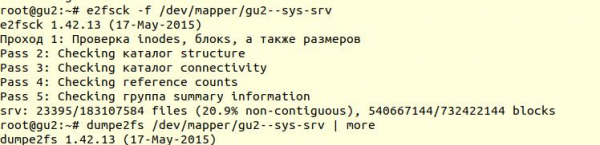
Provjera datotečnog sustava izvršena je uz pomoć alata e2fsck s ključem -f (Prisilna provjera čak i ako je datotečni sustav označen kao čist):
Nakon toga, uz pomoć alata dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) možemo se uvjeriti da je provjera doista izvršena:
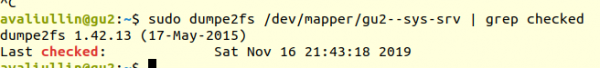
e2fsck kaže da nije pronađena nikakva problema na razini datotečnog sustava ext4, što znači da možemo nastaviti s pokušajima vraćanja baze podataka, odnosno vratiti se na vacuum full (naravno, potrebno je ponovno montirati datotečni sustav i pokrenuti bazu podataka).
Ako imate fizički server, svakako provjerite stanje diskova (putem smartctl -a /dev/XXX) ili RAID kontrolera, kako biste se uvjerili da problem nije na hardverskoj razini. U mom slučaju RAID se pokazao kao ‚hardverski‘, stoga sam zamolio lokalnog administratora da provjeri stanje RAID-a (server je bio nekoliko stotina kilometara od mene). Rekao je da nema grešaka, što znači da možemo započeti s vraćanjem.
Pokušaj 1: zero_damaged_pages
Priključujemo se bazi kroz psql s računom koji ima administratorska prava. Potrebni su nam upravo administratori, jer samo oni mogu mijenjati opciju zero_damaged_pages . U mom slučaju to je postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Opcija zero_damaged_pages potrebna je kako bi se zanemarile greške u čitanju (s web stranice postgrespro):
Kada se otkrije oštećeni predložak stranice, Postgres Pro obično prijavljuje pogrešku i prekida trenutnu transakciju. Ako je opcija zero_damaged_pages uključena, sustav umjesto toga izdaje upozorenje, poništava oštećenu stranicu u memoriji i nastavlja s obradom. Ovo ponašanje uništava podatke, budući da briše sve retke na oštećenoj stranici.
Uključujemo opciju i pokušavamo izvršiti full vacuum nad tablicom:
VACUUM FULL VERBOSE 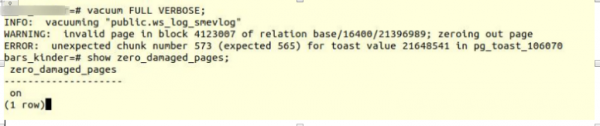
Nažalost, neuspjeh.
Nailazimo na sličnu grešku:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– mehanizam za pohranu ‚dugih podataka‘ u Postgresu, ako ne stanu na jednu stranicu (po defaultu 8kb).
Pokušaj 2: reindex
Prvi savjet s Googla nije pomogao. Nakon nekoliko minuta pretraživanja, našao sam drugi savjet – napraviti reindex oštećene tablice. Ovu sam preporuku vidio na mnogo mjesta, ali nije bila uvjerljiva. Napravimo reindeks:
reindeksiraj tablicu ws_log_smevlog 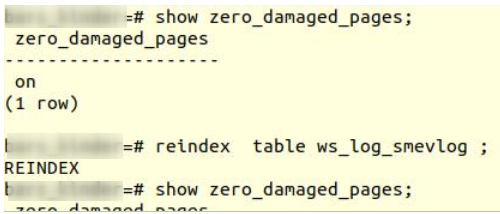
reindex završeno bez problema.
Međutim, to nije pomoglo, VACUUM FULL prenijelo je sličnu grešku. Budući da sam navikao na neuspjehe, nastavio sam tražiti savjete na internetu i naišao na prilično zanimljiv .
Pokušaj 3: SELECT, LIMIT, OFFSET
U prethodnom članku sugerirali su da se tablica pregleda redak po redak i uklone problematični podaci. Prvo je trebalo pregledati sve retke:
for ((i=0; i/dev/null || echo $i; doneU mom slučaju tablica je sadržavala 1 628 991 redaka! U teoriji, trebali smo se pobrinuti za , ali to je tema za posebnu raspravu. Bila je subota, pokrenuo sam ovu naredbu u tmuxu i otišao spavati:
for ((i=0; i/dev/null || echo $i; doneUjutro sam odlučio provjeriti kako stoje stvari. Na moje iznenađenje, otkrio sam da je za 20 sati skenirano samo 2% podataka! Nije mi se čekalo 50 dana. Još jedan potpuni neuspjeh.
Ali nisam se predavao. Počelo me zanimati zašto je skeniranje trajalo toliko dugo. Iz dokumentacije (opet na postgrespro) saznao sam:
OFFSET označava preskočiti određeni broj redaka prije nego što počne isporučivati retke.
Ako su navedeni i OFFSET i LIMIT, sustav prvo preskoči OFFSET redaka, a zatim počinje brojati retke za ograničenje LIMIT.Prilikom primjene LIMIT-a, važno je također koristiti klauzulu ORDER BY kako bi rezultantni redci bili isporučeni u određenom redoslijedu. Inače će se vraćati nepredictabilni podskupovi redaka.
Očigledno je da je gornja naredba bila pogrešna: prvo, nije bilo order by, rezultat bi mogao biti pogrešan. Drugo, Postgres je prvo trebao skenirati i preskočiti OFFSET-redaka, a s povećanjem OFFSET performanse bi opadale još više.
Pokušaj 4: napraviti dump u tekstualnom formatu
Nakon toga mi je pala na pamet, naizgled genijalna ideja: napraviti dump u tekstualnom formatu i analizirati posljednji zapisani redak.
Ali najprije, upoznajmo se sa strukturom tablice ws_log_smevlog:
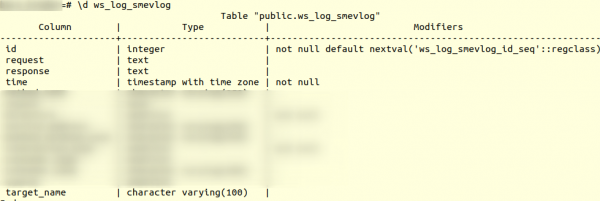
U našem slučaju imamo stupac "id", koji je sadržavao jedinstveni identifikator (brojač) retka. Plan je bio sljedeći:
- Započinjemo s radom na dumpu u tekstualnom formatu (u obliku sql-naredbi)
- U određenom trenutku vrijeme vađenja dumpa bi se prekinulo zbog greške, ali bi tekstualna datoteka svejedno bila sačuvana na disku
- Gledamo kraj tekstualne datoteke, tako nalazimo identifikator (id) posljednjeg uspješno izvađenog retka
Počeo sam s vađenjem dumpa u tekstualnom obliku:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpVađenje dumpa, kao što se i očekivalo, prekinulo se s istom greškom:
pg_dump: Poruka greške sa servera: ERROR: nevažeća stranica u bloku 4123007 baze relacija/16490/21396989 Zatim sam preko tail pregledao kraj dumpa (tail -5 ./my_dump.dump) otkrio da se dump prekinuo na retku s id 186 525. 'Znači, problem je u retku s id 186 526, on je oštećen, njega treba obrisati!' – pomislio sam. No, kad sam napravio upit u bazu podataka:
«select * from ws_log_smevlog where id=186529'' ispostavilo se da je s tim retkom sve u redu... Retci s indeksima 186 530 — 186 540 također su radili bez problema. Još jedna 'genijalna ideja' propala je. Kasnije sam shvatio zašto se to dogodilo: prilikom brisanja ili promjene podataka iz tablice oni se ne brišu fizički, već se označavaju kao 'mrtvi tupli', zatim dolazi autovacuum i označava te retke kao obrisane i dopušta ponovno korištenje tih redaka. Za razumijevanje, ako se podaci u tablici mijenjaju i uključen je autovacuum, tada se ne pohranjuju slijedeći redoslijed.
Pokušaj 5: SELECT, FROM, WHERE id=
Neuspjesi nas čine jačima. Nikad se ne treba predavati, treba ići do kraja i vjerovati u sebe i svoje sposobnosti. Zato sam odlučio probati još jednu opciju: jednostavno pregledati sve unose u bazi podataka jedan po jedan. Znajući strukturu moje tablice (vidi gornje), imamo polje id koje je jedinstveno (primarni ključ). U tablici imamo 1 628 991 retka i id idu po redu, što znači da ih možemo jednostavno pretraživati jedan po jedan:
for ((i=1; i/dev/null || echo $i; doneAko netko ne razumije, naredba radi na sljedeći način: pregledava redak po redak tablicu i šalje stdout u /dev/null, ali ako naredba SELECT ne uspije, ispisuje se tekst greške (stderr se šalje u konzolu) i ispisuje se redak koji sadrži grešku (zahvaljujući ||, koja označava da je s selectom došlo do problema (kod povratka naredbe nije 0)).
Imao sam sreće, imali smo indeksirane stupce po polju id:
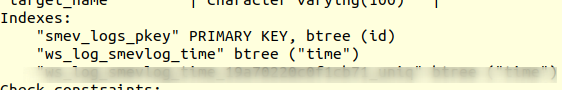
A to znači da pronalaženje retka s potrebnim id-om ne bi trebalo uzeti puno vremena. U teoriji bi trebalo funkcionirati. Pa, pokrećemo naredbu u tmux Idemo spavati.
Ujutro sam otkrio da je pregledano oko 90 000 zapisa, što čini nešto više od 5%. Izvrstan rezultat u usporedbi s prethodnom metodom (2%)! No, nije mi se čekalo 20 dana...
Pokušaj 6: SELECT, FROM, WHERE id >= and id <
Za klijenta je bio dodijeljen odličan server: dvoprocesorski Intel Xeon E5-2697 v2, u našem rasporedu bilo je čak 48 niti! Opterećenje na serveru bilo je umjereno, bez problema smo mogli povući oko 20 niti. RAM-a je također bilo dovoljno: čak 384 gigabajta!
Stoga je bilo potrebno paralelizirati tim:
for ((i=1; i/dev/null || echo $i; doneOvdje se mogla napisati lijepa i elegantna skripta, ali sam odabrao najbrži način paralelizacije: ručno podijeliti raspon 0-1628991 na intervale od 100 000 zapisa i pokrenuti odvojeno 16 komandi:
for ((i=N; i/dev/null || echo $i; doneAli to nije sve. Tehnički, povezivanje s bazom podataka također oduzima neko vrijeme i sistemske resurse. Povezivanje na 1 628 991 nije bila baš pametna ideja, slažete se? Stoga, hajde da prilikom jednog povezivanja izvučemo 1000 redaka umjesto jednog. Na kraju se komanda preoblikovala u ovo:
for ((i=N; i=$i and id/dev/null || echo $i; doneOtvorite 16 prozora u tmux sesiji i pokrenite komande:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Nakon dana dobio sam prve rezultate! Točnije (vrijednosti XXX i ZZZ nisu sačuvane):
ERROR:  nedostaje chunk broj 0 za toast vrijednost 37837571 u pg_toast_106070
829000
ERROR:  nedostaje chunk broj 0 za toast vrijednost XXX u pg_toast_106070
829000
ERROR:  nedostaje chunk broj 0 za toast vrijednost ZZZ u pg_toast_106070
146000
To znači da tri retka sadrže grešku. id prve i druge problematične stavke nalazile su se između 829 000 i 830 000, id treće - između 146 000 i 147 000. Sljedeće je bilo jednostavno pronaći točnu vrijednost id problematičnih stavki. Za to pregledavamo naš raspon s problematičnim zapisima korakom 1 i identificiramo id:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number 2 (expected 0) for toast value 37837843 in pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number ZZZ (expected 0) for toast value XXX in pg_toast_106070
146911
Sretnu završetak
Pronašli smo problematične retke. Pristupamo bazi preko psql-a i pokušavamo ih obrisati:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Na moje iznenađenje, zapisi su obrisani bez ikakvih problema čak i bez opcije zero_damaged_pages.
Nakon toga sam se povezao s bazom, napravio VACUUM FULL (mislim da to nije bilo nužno), i konačno uspješno napravio backup putem pg_dump. Backup je napravljen bez ikakvih pogrešaka! Problem je riješen na ovaj pomalo glup način. Radosti nije bilo kraja, nakon toliko neuspjeha pronađeno je rješenje!
Zahvale i zaključak
Ovo je moje prvo iskustvo vraćanja stvarne baze podataka Postgres. Ovo iskustvo ću dugo pamtiti.
Na kraju, želio bih zahvaliti kompaniji PostgresPro za prevedenu dokumentaciju na hrvatski jezik i za , koji su mi veoma pomogli tijekom analize problema.
Izvor: habr.com
