

O stvaranju sustava nadzora razmišljali smo u fazi formiranja proizvodnih timova. Postalo je jasno da naš posao - operativna podrška - ne pripada tim timovima.
Razlog leži u tome što su svi naši timovi izgrađeni oko pojedinih informacijskih sustava, mikroservisa i frontova, pa timovi ne vide opće stanje zdravlja cijelog sustava. Na primjer, mogu ne znati kako neki mali dio unutar dubokog backenda utječe na frontend. Njihov interes ograničen je na sustave s kojima je njihov sustav integriran. Ako tim i njegov servis A gotovo uopće nije povezan s servisom B, tada takav servis gotovo da je nevidljiv timu.
Naš tim, zauzvrat, radi sa sustavima koji su međusobno vrlo snažno integrirani: među njima postoje mnoge veze, to je vrlo velika infrastruktura. I od svih tih sustava (kojih imamo, uzgred rečeno, ogroman broj) ovisi funkcioniranje internetske trgovine.
Tako dolazimo do toga da naš odjel ne pripada nijednom timu, nego se nalazi malo izvan njih. U cijeloj ovoj priči naš zadatak je razumjeti cjelokupno kako funkcioniraju informacijski sustavi, njihovu funkcionalnost, integracije, softver, mrežu, hardver i kako su sve to povezano.
Platforma na kojoj funkcioniraju naše internetske trgovine izgleda ovako:
- front
- middle-office
- back-office
Koliko god željeli, ne može se dogoditi da svi sustavi rade besprijekorno i bez problema. Problem ponovno leži u broju sustava i integracija - s takvim brojem, neki incidenti su neizbježni, bez obzira na kvalitetu testiranja. To se događa kako unutar nekog pojedinačnog sustava, tako i u pogledu njihove integracije. Potrebno je pratiti stanje cijele platforme cjelovito, a ne samo neku njezinu pojedinačnu komponentu.
Idealno, nadzor nad stanjem cijele platforme treba automatizirati. I došli smo do monitora kao neizbježnog dijela ovog procesa. U početku je bio izgrađen samo za frontend, dok su vlastiti sustavi nadzora slojeva postojali i postoje kod mrežnih inženjera, administratora softvera i hardvera. Svi ti ljudi pratili su nadzor samo na svom nivou, nitko nije imao cjelokupno razumijevanje.
Na primjer, ako virtualna mašina otkaže, u većini slučajeva to zna samo administrator koji je odgovoran za hardver i virtualnu mašinu. Frontend tim u takvim slučajevima vidi samo da je aplikacija pala, ali nema podataka o padu virtualne mašine. Administrator može znati tko je naručitelj i otprilike imati predstavu o tome što se trenutno odvija na toj virtualnoj mašini, pod uvjetom da je riječ o nekom velikom projektu. Za male projekte, vjerojatno ne zna. U svakom slučaju, administrator se mora obratiti vlasniku i pitati što je bilo na toj mašini, što treba obnoviti i što promijeniti. A ako se dogodila neka ozbiljna kvar, počela bi utrka oko toga — jer nitko nije mogao vidjeti sustav u cjelini.
U konačnici, takve fragmentirane priče utječu na cijeli frontend, na korisnike i našu osnovnu poslovnu funkciju — internet prodaju. Budući da ne pripadamo timovima, nego se bavimo održavanjem svih ecommerce aplikacija unutar internet trgovine, preuzeli smo zadatak izrade cjelovitog sustava praćenja ecommerce platforme.
Struktura sustava i stog
Počeli smo tako što smo izdvojili nekoliko slojeva praćenja za naše sustave, unutar kojih ćemo morati prikupljati metrike. Sve to trebalo je spojiti, što smo i učinili u prvom koraku. Sada u tom koraku poboljšavamo što kvalitetnije prikupljanje metrika za sve naše slojeve kako bismo izgradili korelaciju i razumjeli kako sustavi utječu jedni na druge.
Nedostatak cjelovitog praćenja u početnim fazama pokretanja aplikacija (s obzirom na to da smo ga počeli graditi kada je većina sustava bila u eksploataciji) dovelo je do značajnog tehničkog duga u postavljanju praćenja cijele platforme. Nismo si mogli priuštiti da se fokusiramo na postavljanje praćenja samo jednog IS-a i detaljno raditi na praćenju za njega jer bi ostali sustavi neko vrijeme ostali bez praćenja. Da bismo riješili taj problem, odredili smo popis najpotrebnijih metrika za procjenu stanja informacijskog sustava po slojevima i počeli ga implementirati.
Stoga smo odlučili jesti slona po dijelovima.
Naš sustav se sastoji od:
- hardvera;
- operativnog sustava;
- softvera;
- UI dijelovi u aplikaciji za praćenje;
- poslovne metrike;
- aplikacije za integraciju;
- informacijske sigurnosti;
- mreže;
- balansiranjem prometa.
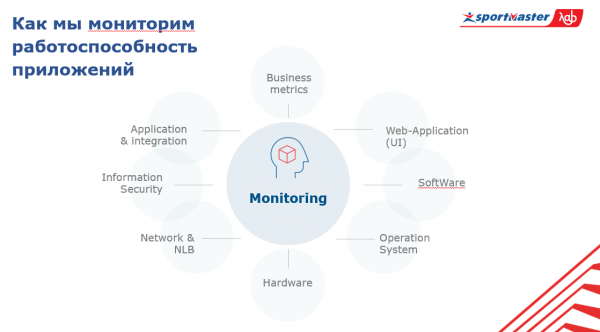
U središtu ovog sustava je samo praćenje. Da biste općenito razumjeli stanje cijelog sustava, morate znati što se događa s aplikacijama na svim tim razinama i kroz raznolikost aplikacija.
Dakle, o stogu.
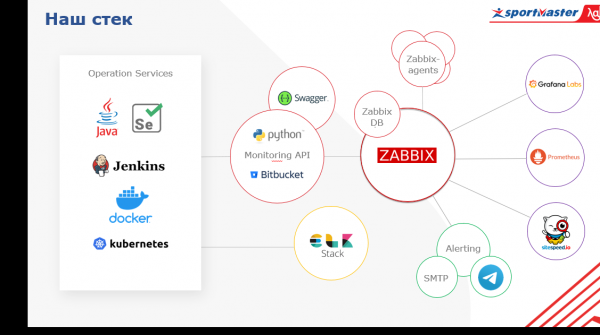
Koristimo softver s otvorenim izvorom. U središtu nam je Zabbix, koji koristimo prvenstveno kao sustav za upozorenja. Svi znaju da je idealan za praćenje infrastrukture. Što se ovdje podrazumijeva? Upravo one niskonivojske metrike koje ima svaka tvrtka koja ima svoje podatkovne centre (a Sportmaster ima svoje podatkovne centre) — temperatura servera, stanje memorije, RAID-a, metričke mrežnih uređaja.
Integrirali smo Zabbix s aplikacijama za razmjenu poruka, Telegram i Microsoft Teams, koje se aktivno koriste u timovima. Zabbix pokriva sloj stvarne mreže, hardvera i djelomično softvera, ali to nije panaceja. Te podatke obogaćujemo iz nekih drugih usluga. Na primjer, na razini hardverske opreme direktno se preko API-ja povezuju u našoj virtualizacijskoj vezi i povlačimo podatke.
Što još. Osim Zabbixa koristimo Prometheus, koji omogućuje praćenje metrika u aplikaciji dinamičkog okruženja. To jest, možemo dobivati metrike aplikacije putem HTTP endpointa i ne brinuti se o tome koje metrike učitati a koje ne. Na temelju tih podataka možemo razvijati analitičke upite.
Izvori podataka za ostale slojeve, kao što su poslovne metrike, dijelimo na tri dijela.
Prvo, to su vanjski poslovni sustavi, Google Analytics, prikupljamo metrike iz zapisnika. Od njih dobivamo podatke o aktivnim korisnicima, konverzijama i svemu ostalom povezanom s poslovanjem. Drugo, to je sustav UI praćenja. O tome treba detaljnije razgovarati.
Nekada smo počeli s ručnim testiranjem koje je preraslo u automatske testove funkcionalnosti i integracija. Od toga smo napravili praćenje, zadržavši samo osnovnu funkcionalnost i vezali se uz markere koji su maksimalno stabilni i ne mijenjaju se često tijekom vremena.
Nova struktura timova podrazumijeva da se cijela aktivnost vezana uz aplikacije centralizira na proizvodne timove, pa smo prestali s čistim testiranjem. Umjesto toga, od testova smo stvorili UI-monitoring, napisan u Javi, Seleniumu i Jenkinsu (koji se koristi kao sustav za pokretanje i generiranje izvještaja).
Imali smo puno testova, ali na kraju smo odlučili ići na glavnu cestu, visoko razinu metrike. Ako budemo imali puno specifičnih testova, bit će teško održavati ažurnost podataka. Svako sljedeće izdanje će značajno lomiti cijeli sustav, a mi ćemo se samo baviti njegovim popravljanjem. Stoga smo se usredotočili na temeljnije stvari koje se rijetko mijenjaju i nadziramo samo njih.
Konačno, treće, izvor podataka je centralizirani sustav logiranja. Za logove koristimo Elastic Stack, a zatim te podatke možemo preuzeti u naš sustav praćenja poslovnih metrika. Uz to, radi naš vlastiti Monitoring API servis, napisan u Pythonu, koji poziva bilo koje servise putem API-ja i povlači podatke u Zabbix.
Još jedan neizostavni atribut monitoringa je vizualizacija. Ona se kod nas gradi na temelju Grafane. Među drugim sustavima vizualizacije, izdvaja se po tome što se na nadzornoj ploči mogu vizualizirati metrike iz različitih izvora podataka. Možemo prikupiti visoko razine metrike internetskih trgovina, kao što su broj narudžbi realiziranih u posljednjem satu iz RDBMS-a, metrike izvedbe OS-a na kojem ta internetska trgovina radi iz Zabbixa, a metrike instanci te aplikacije iz Prometheusa. I sve će to biti na jednom nadzornoj ploči. Jasno i dostupno.
Napominjem o sigurnosti — trenutno dovršavamo sustav koji ćemo kasnije integrirati s globalnim sustavom monitoringa. Po mom mišljenju, glavni problemi s kojima se suočava e-trgovina u području informatičke sigurnosti odnose se na robote, skeneri i brute force napade. Na to se treba paziti, jer sve to može kritično utjecati na rad naših aplikacija, kao i na reputaciju u poslovnom smislu. S odabranim stakom uspješno pokrivamo te zadatke.
Još jedna važna stvar — razina aplikacija se prikuplja pomoću Prometheusa. I on je također integriran s Zabbixom. Osim toga, imamo sitespeed, uslugu koja nam omogućava da pratimo parametre poput brzine učitavanja naše stranice, uskih grla, renderiranja stranice, učitavanja skripti i slično, koja je također integrirana putem API-ja. Dakle, metrike se prikupljaju u Zabbixu, a alerte šaljemo iz tog sustava. Sve alerte trenutno se šalju putem glavnih kanala (za sada su to email i telegram, a nedavno smo dodali i MS Teams). U planu je unaprijediti alerting do razine gdje pametni botovi rade kao usluga i pružaju informacije o monitoringu svim zainteresiranim timovima proizvoda.
Za nas su važne metrike ne samo pojedinačnih informacijskih sustava, već i opće metrike cijele infrastrukture koju koriste aplikacije: klasteri fizičkih servera, na kojima rade virtualne mašine, balansatori opterećenja, Network Load Balancer-i, sama mreža, iskorištenje komunikacijskih kanala. Plus, metrike za naše vlastite podatkovne centre (imamo ih nekoliko i infrastruktura je prilično značajna).
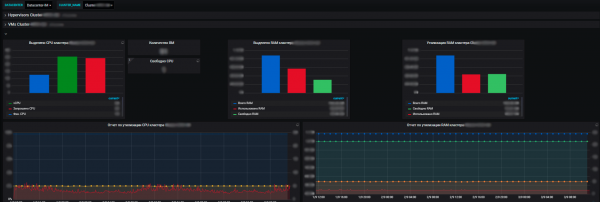
Prednosti našeg sustava monitoringa su u tome što nam omogućava da vidimo stanje funkcionalnosti svih sustava, možemo procijeniti njihov utjecaj jedni na druge i na opće resurse. A na kraju, to nam omogućuje planiranje resursa, što također spada u našu odgovornost. Upravljamo serverskim resursima — skupinom u okviru e-commerce, uvodimo i isključujemo novo opremu, kupujemo novo, provodimo reviziju iskorištenosti resursa i slično. Svake godine timovi planiraju nove projekte, razvijaju svoje sustave, a nama je važno osigurati im resurse.
I putem metrika vidimo trend potrošnje resursa našim informacijskim sustavima. Već na temelju njih možemo planirati. Na razini virtualizacije prikupljamo podatke i vidimo informacije o dostupnom broju resursa prema podatkovnim centrima. A unutar podatkovnog centra vidljiva je i iskorištenost, i stvarna raspodjela, potrošnja resursa. I to kako s standalone serverima, tako i s virtualnim mašinama i klasterima fizičkih servera, na kojima sve te virtualke aktivno rade.
Perspektive
Sada imamo gotovo jezgro sustava u cjelini, ali ostalo je još nekoliko aspekata na kojima treba raditi. Minimalno, to je sloj informacijske sigurnosti, ali također je važno doći do mreže, razviti alertering i riješiti pitanje korelacije. Imamo mnogo slojeva i sustava, a na svakom sloju postoje brojne metrike. To postaje matrjoška na razini matrjoške.
Naš cilj je na kraju napraviti ispravne alerte. Na primjer, ako dođe do problema s hardverskim dijelom, ponovo, s virtualnom mašinom, a tamo je bila važna aplikacija koja nije bila rezervirana. Saznat ćemo da je virtualna mašina umrla. Zatim će se alertirati poslovne metrike: korisnici su negdje nestali, konverzija je nestala, UI u sučelju nije dostupan, softver i servisi su također umrli.
U takvom rasporedu dobit ćemo spam od alertinga, a to se već ne uklapa u format ispravnog sustava nadzora. Postavlja se pitanje korelacije. Stoga, idealno, naš sustav nadzora trebao bi reći: „Ljudi, vaša fizička mašina je umrla, a zajedno s njom ova aplikacija i takve metrike“, pomoću jednog alertera umjesto da nas zasipava stotinama alertera. Treba obavijestiti o glavnom — o uzroku, što pomaže brzom rješavanju problema kroz njegovu lokalizaciju.
Naš sustav obavijesti i obrada alertera izgrađena je oko 24-satne službe za hitne slučajeve. Svi alerteri koje smatramo bitnima i koji su na našoj kontrolnoj listi se šalju tamo. Svaki alerter mora sadržavati opis: što se dogodilo, što to zapravo znači, na što utječe. I još link na nadzornu ploču i upute što učiniti u tom slučaju.
To je sve što se tiče zahtjeva za izgradnju alertinga. Dalje, situacija može ići u dva smjera — ili postoji problem koji treba riješiti, ili je došlo do kvara u sustavu nadzora. No, u svakom slučaju, treba ići i istražiti.
U prosjeku trenutno primamo oko stotinu alertera dnevno, uzimajući u obzir da korelacija alertera još nije ispravno postavljena. I ako je potrebno obaviti tehničke radove, a nešto prisilno isključimo, njihov broj naglo raste.
Osim praćenja sustava koje eksploatiramo i prikupljanja metrika koje smatramo važnima, sustav praćenja omogućuje prikupljanje podataka za produktne timove. Oni mogu utjecati na sastav metrika unutar informacijskih sustava koji se kod nas prate.
Naš kolega može doći i zamoliti nas da dodamo neku metriku koja će biti korisna i za nas i za tim. Ili, na primjer, timu možda nedostaju osnovne metrike koje imamo, a potrebne su im specifične. U Grafani kreiramo prostor za svaki tim i dodjeljujemo administratorska prava. Također, ako timu trebaju nadzorne ploče, a oni sami ne mogu/ne znaju to učiniti, pomažemo im.
Budući da nismo uključeni u proces stvaranja vrijednosti tima, njihovih izdanja i planiranja, postupno dolazimo do toga da su izdanja svih sustava besprijekorna i mogu se objavljivati dnevno, bez prethodnog usuglašavanja s nama. A nama je važno pratiti ta izdanja jer potencijalno mogu utjecati na rad aplikacije i nešto pokvariti, a to je kritično. Za upravljanje izdanjima koristimo Bamboo, odakle preko API-ja dobivamo podatke i možemo vidjeti koja su izdanja u kojim informacijskim sustavima objavljena i njihov status. I najvažnije — u koje vrijeme. Oznake o izdanjima postavljamo na glavne kritične metrike, što vizualno daje značajan uvid u slučaju problema.
Na taj način možemo vidjeti korelaciju između novih izdanja i nastalih problema. Osnovna ideja je razumjeti kako sustav radi na svim razinama, brzo lokalizirati problem i jednako brzo ga ispraviti. Često se pokazuje da više vremena zahtijeva ne rješenje problema, nego pronalaženje uzroka.
U ovom području se u budućnosti želimo fokusirati na proaktivnost. Idealno bi bilo unaprijed saznati za približavajući problem, a ne post festum, kako bismo se bavili njegovim sprečavanjem, a ne rješavanjem. Ponekad se događaju lažni alarmi sustava nadzora, kako zbog ljudske pogreške, tako i zbog promjena u aplikacijama. Radimo na tome, usavršavamo sustav i nastojimo upozoriti korisnike koji ga koriste zajedno s nama prije bilo kakvih manipulacija sustavom nadzora, ili provodimo te aktivnosti u tehničkom prozoru.
Dakle, sustav je pokrenut i uspješno radi od početka proljeća... i pokazuje prilično stvarnu dobit. Naravno, to nije njegova konačna verzija, još ćemo implementirati mnoštvo korisnih stvari. No, upravo sada, uz toliki broj integracija i aplikacija, bez automatizacije nadzora zaista se ne može.
Ako i vi nadzirete velike projekte s ozbiljnim brojem integracija — napišite u komentarima koju ste srebrnu kuglu pronašli za to.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish