

Povijest
Imamo automate za prodaju koje smo sami razvili. Unutra se nalazi Raspberry Pi i malo dodatne elektronike na odvojenoj ploči. Povezani su novčanik, aparati za novčanice, bankovni terminal… Sve upravlja program koji smo sami napisali. Cijela povijest rada se zapisuje u dnevnik na fleš memoriji (MicroSD), koja se zatim prenosi putem interneta (pomoću USB modema) na server, gdje se pohranjuje u bazu podataka. Informacije o prodaji se učitavaju u 1C, a takođe postoji jednostavni web interfejs za praćenje i slično.
Dakle, dnevnik je od suštinskog značaja — za evidenciju (tu su prihodi, prodaje itd.), praćenje (razne greške i druge nepredviđene okolnosti); to je, može se reći, sve informacije koje imamo o ovom aparatu.
Problem
Fleš memorije se pokazale kao veoma nepouzdani uređaji. Redovno se kvare sa zavidnom pravilnošću. To dovodi do zastoja automata, a takođe (ako iz nekog razloga dnevnik nije mogao da se prenese online) do gubitka podataka.
Ovo nije prvi put da koristimo fleš memorije, imali smo drugi projekat sa više od stotinu uređaja, gde je dnevnik bio pohranjen na USB fleš memorijama, tamo su takođe bile probleme sa pouzdanošću, ponekad je broj onih koji su se pokvarili u mesecu dostizao desetine. Pokušavali smo razne fleš memorije, uključujući brendirane sa SLC memorijom, a neki modeli su pouzdaniji od drugih, ali zamena fleš memorija nije drastično rešila problem.
Pažnja! Dugi tekst! Ako vas ne zanima „zašto“, a zanima vas samo „kako“, možete odmah ići članka.
Rešenje
Prvo što mi pada na pamet: odustati od MicroSD, staviti, na primer, SSD i učitati po njemu. Teoretski je to moguće, verovatno, ali relativno skupo i nije toliko pouzdano (dodaje se USB-SATA adapter; statistika otkaza i za jeftine SSD-ove takođe nije ohrabrujuća).
USB HDD takođe ne izgleda kao posebno privlačno rešenje.
Zato smo došli do ovakvog rešenja: ostaviti učitavanje sa MicroSD, ali koristiti ih u read-only režimu, a dnevnik rada (i druge informacije jedinstvene za određeni uređaj — serijski broj, kalibracije senzora itd.) čuvati negde drugde.
Tema read-only datotečnih sistema za Raspberry Pi je već detaljno istražena, neću se zadržavati na detaljima implementacije u ovom članku (ali ako bude interesa — možda ću napisati mini-članak na ovu temu). Jedna stvar koju želim napomenuti: kako iz osobnog iskustva, tako i iz recenzija onih koji su već implementirali, postoji dobitak u pouzdanosti. Da, potpuno uklanjanje kvarova nije moguće, no značajno smanjivanje njihove učestalosti je itekako realno. Također, kartice postaju standardizirane, što znatno olakšava zamjenu za tehničko osoblje.
Hardverski dio
Nije bilo posebnih dvojbi oko izbora tipa memorije — NOR Flash.
Argumenti:
- lako povezivanje (najčešće putem SPI sabirnice, za koju već imamo iskustva, tako da „hardverskih” problema ne bi trebalo biti);
- smiješna cijena;
- standardni radni protokol (implementacija već postoji u Linux kernelu, ako želite, možete koristiti treće strane, koje također postoje, ili čak napisati vlastitu, s obzirom da je sve jednostavno);
- pouzdanošću i resursom:
iz tipične tehničke dokumentacije: podaci se čuvaju 20 godina, 100000 brisanja za svaku jedinicu;
iz vanjskih izvora: izuzetno nizak BER, postulira se odsustvo potrebe za kodovima za ispravak grešaka. (u nekim radovima razmatra se ECC za NOR, ali obično se misli na MLC NOR, to se također događa).
Procijenimo zahtjeve za volumen i resurs.
Želim da se podaci jamčeno čuvaju nekoliko dana. To je potrebno kako bi se, u slučaju problema s vezom, povijest prodaje ne izgubila. Oslonit ćemo se na 5 dana, za to vrijeme (čak i uz dane vikenda i praznike) može se riješiti problem.
Trenutno svaki dan zabilježimo oko 100kb dnevnika (3-4 tisuće zapisa), međutim postepeno ta brojka raste — povećava se detaljnost, dodaju se novi sadržaji. Plus, ponekad se događaju iznenadni skokovi (neki senzor počne stvarati lažna očitavanja, na primjer). Izračunat ćemo na 10 tisuća zapisa po 100 bajta — megabajt dnevno.
Dakle, ukupno dolazimo do 5Mb čistih (dobro komprimiranih) podataka. K tome još (gruba procjena) 1Mb operativnih podataka.
To znači da nam treba čip od 8Mb ako ne koristimo kompresiju, ili 4Mb ako je koristimo. Ovo su sasvim realne brojke za ovu vrstu memorije.
Što se tiče resursa: ako planiramo da će se memorija u cijelosti prepisivati ne češće od svaka 5 dana, onda za 10 godina korištenja dobivamo manje od tisuću ciklusa prepisivanja.
Podsjećam, proizvođač jamči sto tisuća.
Nekoliko riječi o NOR vs NAND
Danas je naravno mnogo popularnija NAND memorija, no za ovaj projekt ne bih je koristio: NAND, za razliku od NOR, obavezno zahtijeva upotrebu kodova za ispravljanje grešaka, tablica neispravnih blokova itd., a i nogu na NAND čipovima obično ima mnogo više.
Kao nedostatke NOR-a možemo navesti:
- mali kapacitet (i, sukladno tome, visoku cijenu po megabajtu);
- niska brzina prijenosa (dost.djelomično zbog korištenja serijskog sučelja, obično SPI ili I2C);
- sporo brisanje (ovisno o veličini bloka, može trajati od dijelova sekunde do nekoliko sekundi).
Naizgled nema ništa kritično za nas, pa nastavljamo.
Ako vas zanimaju detalji, odabrali smo čip (međutim, to nije presudno, na tržištu ima mnoštvo analoga, kompatibilnih po pinoutu i sustavu komandi; čak i ako poželimo instalirati čip drugog proizvođača i/ili druge veličine, sve će raditi bez promjena u kodu).
Koristim ugrađeni Linuxov drajver, na Raspberry Pi-u, zahvaljujući podršci za device tree overlay, sve je vrlo jednostavno — potrebno je staviti u /boot/overlays kompajliran overlay i malo izmijeniti /boot/config.txt.
Primjer dts datoteke
Iskreno, nisam siguran da je napisano bez grešaka, ali radi.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
I još jedan redak u config.txt
dtoverlay=at25:spimaxfrequency=50000000Opišem samo kako se čip povezuje s Raspberry Pi-om. S jedne strane, nisam stručnjak za elektroniku, s druge strane — ovdje je sve banalno čak i za mene: čip ima samo 8 pinova, od kojih su nam potrebni zemlja, napajanje, SPI (CS, SI, SO, SCK); razine se podudaraju s onima na Raspberry Pi-u, nikakva dodatna oprema nije potrebna — samo spojite navedenih 6 kontakata.
Postavljanje zadatka
Kao obično, formulacija zadatka prolazi kroz nekoliko iteracija, čini mi se da je došlo vrijeme za još jednu. Dakle, zaustavimo se, okupljamo ono što je već napisano i razjasnimo preostale u sjeni.
Dakle, odlučili smo da će dnevnik biti pohranjen u SPI NOR Flash.
Što je NOR Flash za one koji ne znaju
Ovo je nevoljno energijska memorija, s kojom možemo izvoditi tri operacije:
- Čitanje:
Najobičnije čitanje: šaljemo adresu i čitamo onoliko bajtova koliko nam treba; - Pisanje:
Upis u NOR flash izgleda kao običan, ali ima jednu posebnost: moguće je samo mijenjati 1 u 0, ali ne obrnuto. Na primjer, ako smo u memorijskoj ćeliji imali 0x55, nakon što upišemo 0x0f, tamo će se već čuvati 0x05. (vidi tabelu malo niže); - Brisanje:
Naravno, trebamo znati napraviti i obrnutu operaciju — mijenjati 0 u 1, upravo za to postoji operacija brisanja. Za razliku od prve dvije, ona operira ne bajtovima, već blokovima (minimalni blok za brisanje u odabranom čipu je 4kB). Brisanje uništava cijeli blok u cjelini i to je jedini način da se promijeni 0 u 1. Stoga, pri radu s flash memorijom često se mora izravnavati struktura podataka na granici bloka za brisanje.
Upis u NOR flash:
Binarni podaci
Bilo je
01010101
Upisano
00001111
Postalo je
00000101
Sam dnevnik predstavlja sekvencu zapisa varijabilne duljine. Tipična duljina zapisa je oko 30 bajtova (iako ponekad dolazi do zapisa duljine nekoliko kilobajta). U ovom slučaju radimo s njima jednostavno kao s nizom bajtova, ali, ako je zanimljivo, unutar zapisa koristi se CBOR.
Osim dnevnika, trebamo pohraniti neku "podešavajuću" informaciju, kako ažuriranu, tako i ne: neki ID uređaja, kalibracije senzora, oznaku "uređaj privremeno isključen", itd.
Ove informacije predstavljaju skup zapisa ključ-vrijednost, također pohranjene u CBOR-u. Ove informacije nemamo puno (maksimalno nekoliko kilobajta), ažuriraju se rijetko.
U nastavku ćemo je zvati kontekst.
Ako se sjetimo odakle je počela ova priča, važno je osigurati pouzdanost pohrane podataka i, kada je to moguće, neprekidni rad čak i u slučaju hardverskih kvarova/povrede podataka.
Koje izvore problema možemo razmotriti?
- Isključivanje napajanja u trenutku operacija pisanja/brijanja. To spada u kategoriju "nema lijeka protiv sile".
Informacije iz stackexchangea: pri isključivanju napajanja u trenutku rada s flash-om, bilo da se radi o brisanju (postavljanje na 1), bilo da se radi o pisanju (postavljanje na 0) dovodi do neodređenog ponašanja: podaci mogu biti zapisani, djelomično zapisani (recimo, poslali smo 10 bajtova/80 bita, a uspjeli smo zapisati samo 45 bita), nije isključeno ni to da dio bitova bude u "međustanju" (čitanje može dati i 0 i 1); - Greške same flash memorije.
BER, iako vrlo mali, ne može biti jednak nuli; - Greške po sabirnici
Podaci koji se prenose putem SPI nisu zaštićeni i mogu doći do pojedinačnih bitnih grešaka, kao i grešaka sinkronizacije — gubitak ili umetanje bitova (što može uzrokovati masovna oštećenja podataka); - Ostale greške/prekidi
Greške u kodu, „bugovi“ Raspberry, uplitanje vanzemaljaca…
Definirao sam zahtjeve čija ispunjenja smatram nužnima za osiguranje pouzdanosti:
- zapisi moraju odmah biti pohranjeni u flash memoriju, odgođena pohrana nije opcija; - ako dođe do greške, ona treba biti otkrivena i obrađena što je prije moguće; - sustav bi trebao moći obnoviti rad nakon grešaka.
(primjer iz stvarnog života „kako ne bi trebalo biti“, s kojim se, mislim, svi susreli: nakon nužnog ponovnog pokretanja, „oštećen“ je datotečni sustav i operativni sustav se ne pokreće)
Ideje, pristupi, razmišljanja
Kada sam počeo razmišljati o ovom zadatku, kroz glavu su prolazile brojne ideje, na primjer:
- koristiti kompresiju podataka;
- koristiti pametne strukture podataka, na primjer, odvojeno pohraniti zaglavlja zapisa od samih zapisa, tako da bi, u slučaju greške u nekom zapisu, bez problema moglo pročitati ostale;
- koristiti bitne prozore za kontrolu dovršenosti zapisa prilikom gubitka napajanja;
- pohranjivati kontrolne zbrojeve za sve i svašta;
- koristiti neku vrstu kodiranja otporne na smetnje.
Dio ovih ideja je korišten, dok se od nekih odlučilo odustati. Idemo redom.
Kompresija podataka
Dogodovštine koje bilježimo u dnevniku su dovoljno slične i ponavljajuće („bacili novčić od 5 kuna“, „pritisnuli gumb za vraćanje kusura“, …). Stoga bi kompresija trebala biti dovoljno učinkovita.
Troškovi kompresije su neznatni (procesor je dovoljno snažan, čak i na prvom Pi imao je jedno jezgro s brzinom od 700MHz, na aktualnim modelima nekoliko jezgri s brzinom iznad gigaherca), brzina razmjene s pohranom nije visoka (nekoliko megabajta u sekundi), a veličina zapisa nije velika. Ukratko, ako kompresija i utječe na performanse, onda samo pozitivno (apsolutno nebitno, samo konstatiram). Plus, we don't have a real embedded system, but a regular Linux — so the implementation shouldn't require much effort (just link the library and use a few functions from it).
A piece of the log from a running device (1.7MB, 70 thousand entries) was taken and initially tested for compressibility using gzip, lz4, lzop, bzip2, xz, and zstd available on the computer.
- gzip, xz, and zstd showed similar results (40KB).
I was surprised that the trendy xz performed at the level of gzip or zstd here; - lzip with default settings yielded slightly worse results;
- lz4 and lzop showed not very good results (150KB);
- bzip2 surprisingly showed good results (18KB).
So, the data compresses very well.
Therefore, (if we don't find any fatal flaws) there will be compression! Simply because more data can fit on the same flash drive.
Let's consider the drawbacks.
The first problem: we already agreed that each entry must be immediately written to the flash. Usually, the compressor accumulates data from the input stream until it decides it's time to write to the output. However, we need to obtain a compressed block of data immediately and save it to non-volatile memory.
I see three possible ways:
- Compress each entry using dictionary compression instead of the algorithms discussed above.
This is a feasible option, but I don't like it. To ensure a reasonably decent level of compression, the dictionary must be tailored to specific data; any change will lead to a catastrophic drop in the compression ratio. Yes, the problem can be solved by creating a new version of the dictionary, but this will be a headache — we will need to store all versions of the dictionary; in each entry, we will need to specify which version of the dictionary it was compressed with… - Compress each entry using 'classical' algorithms, but independently of others.
The considered compression algorithms are not designed to work with entries of such size (dozens of bytes), the compression ratio will clearly be less than 1 (meaning an increase in data volume instead of compression); - Perform a FLUSH after each entry.
Many compression libraries have FLUSH support. This is a command (or parameter to the compression procedure) that, when received, causes the compressor to form a compressed stream such that it can restore svi the uncompressed data that has already been received. Such an analogysynchronizacijau datotečnim sustavima ilicommitu SQL-u.
Što je važno, sljedeće operacije kompresije moći će koristiti akumulirani rječnik, a razina kompresije neće trpjeti toliko kao u prethodnoj varijanti.
Mislim da je očito da sam odabrao treću opciju, zadržimo se na njoj detaljnije.
Pronađena o FLUSH-u u zlib-u.
Napravio sam test temeljen na članku, uzeo sam 70 tisuća zapisa iz dnevnika stvarnog uređaja, s veličinom stranice od 60KB (o veličini stranice ćemo se još vratiti) dobio sam:
Izvorni podaci
gzip kompresija -9 (bez FLUSH-a)
zlib s Z_PARTIAL_FLUSH
zlib s Z_SYNC_FLUSH
Obujam, KB
1692
40
352
604
Na prvi pogled, cijena koju donosi FLUSH može izgledati prevelika, no zapravo nemamo bogat izbor — ili ne komprimirati uopće, ili komprimirati (i to vrlo učinkovito) s FLUSH-om. Ne smijemo zaboraviti da imamo 70 tisuća zapisa, a višak koji donosi Z_PARTIAL_FLUSH iznosi samo 4-5 bajtova po zapisu. A omjer kompresije ispostavio se gotovo 5:1, što je više nego odličan rezultat.
Može se činiti iznenađujućim, ali zapravo je Z_SYNC_FLUSH učinkovitiji način izvođenja FLUSH-a.
U slučaju korištenja Z_SYNC_FLUSH, 4 posljednja bajta svake stavke uvijek će biti 0x00, 0x00, 0xff, 0xff. Ako nam je to poznato — ne trebamo ih spremati, tako da konačna veličina iznosi samo 324KB.
U članku na koji se pozivam, postoji objašnjenje:
Novi tip 0 blok s praznim sadržajem se dodaje.
Tip 0 blok s praznim sadržajem sastoji se od:
- trosmjernog zaglavlja bloka;
- 0 do 7 bitova jednakih nuli, za postizanje usklađenosti s bajtom;
- četiri bajta sekvence 00 00 FF FF.
Kako se lako može primijetiti, u posljednjem bloku prije ovih 4 bajta se nalaze od 3 do 10 nula bitova. Međutim, praksa je pokazala da je nula bitova zapravo najmanje 10.
Ispostavilo se da se tako kratki podatkovni blokovi obično (uvijek?) kodiraju pomoću bloka tipa 1 (fiksni blok), koji obavezno završava s 7 nula bitova, što nam daje 10-17 zagarantovanih nula bitova (a ostali će biti nulti s vjerojatnošću od oko 50%).
Dakle, na testnim podacima u 100% slučajeva ispred 0x00, 0x00, 0xff, 0xff dolazi jedan nulti bajt, a u više od jedne trećine slučajeva — dva nulti bajta. (možda je stvar u tome da koristim binarni CBOR, a pri korištenju tekstualnog JSON-a češće bi se pojavljivali blokovi tipa 2 — dinamički blok, što bi odgovaralo blokovima bez dodatnih nulti bajtova ispred 0x00, 0x00, 0xff, 0xff)..
Dakle, na dostupnim testnim podacima moguće je smjestiti se ispod 250KB komprimiranih podataka.
Možete još malo uštedjeti baveći se žongliranjem bitova: sada ignoriramo prisutnost više nultih bitova na kraju bloka, nekoliko bitova na početku bloka također se ne mijenja...
No, tada sam donio čvrstu odluku da stanem, inače bih tim tempom mogao doći do razvoja vlastitog arhivatora.
Dakle, od svojih testnih podataka dobio sam 3-4 bajta po zapisu, a omjer kompresije bio je veći od 6:1. Iskreno kažem: nisam se nadao takvom rezultatu, po mom mišljenju sve što je bolje od 2:1 — već je rezultat koji opravdava korištenje kompresije.
Sve je odlično, ali zlib (deflate) — ipak je arhaični zaslužni i pomalo staromodeni algoritam kompresije. Samo to što se kao rječnik koristi posljednjih 32Kb iz toka nekomprimirane podatke, danas izgleda čudno (to jest, ako je neki blok podataka vrlo sličan onome što je bilo u ulaznom toku prije 40Kb, on će započeti ponovo arhivirati, a ne će se referirati na prethodni unos). U modernim arhivatorima veličina rječnika se češće mjeri u megabajtima, a ne kilobajtima.
Dakle, nastavljamo naše mini-istraživanje arhivatora.
Sljedeći je bio isproban bzip2 (podsjećam, bez FLUSH-a pokazao je fantastičan stupanj kompresije, gotovo 100:1). Nažalost, s FLUSH-om pokazao se vrlo loše, veličina komprimiranih podataka bila je veća od nekomprimiranih.
Moja pretpostavka o uzrocima neuspjeha
Libbz2 nudi samo jednu opciju flush, koja, čini se, čisti rječnik (analog Z_FULL_FLUSH u zlib), o nekakvoj učinkovitosti kompresije nakon toga ne možemo govoriti.
I posljednji je isproban zstd. Ovisno o parametrima, komprimira ili na razini gzip-a, ali mnogo brže, ili bolje od gzip-a.
Nažalost, s FLUSH-om i on se nije pokazao "najbolje": veličina komprimiranih podataka iznosila je oko 700Kb.
Ja na stranici projekta na githubu, dobio sam odgovor da se može računati na do 10 bajta pomoćnih podataka po svakom bloku komprimiranih podataka, što je blizu dobivenih rezultata, ne možemo dostići deflate.
Na tome sam odlučio stati u eksperimentima s arhivatorima (podsjećam, xz, lzip, lzo, lz4 se nisu pokazali još u fazi testiranja bez FLUSH-a, a egzotičnije algoritme kompresije nisam razmatrao).
Vraćamo se problemima arhiviranja.
Druga (kako se kaže po redu, a ne po značenju) problema je da su komprimirani podaci jedinstveni tok u kojem se stalno upućuje na prethodne dijelove. Na taj način, ako dođe do oštećenja nekog dijela komprimiranih podataka, gubimo ne samo povezani blok nekomprimiranih podataka, već i sve sljedeće.
Postoji nekoliko pristupa rješavanju ovog problema:
- Spriječiti pojavu problema - dodati suvišnost u komprimirane podatke koja će omogućiti otkrivanje i ispravljanje grešaka; o tome ćemo razgovarati kasnije;
- Minimizirati posljedice u slučaju pojave problema
Već smo ranije spomenuli da se svaki blok podataka može komprimirati neovisno, čime bi problem nestao (oštećenje podataka jednog bloka dovelo bi do gubitka podataka samo tog bloka). Međutim, to je krajnji slučaj, u kojem bi kompresija podataka bila neučinkovita. S druge strane, koristit ćemo svih 4MB našeg čipa kao jedinstveni arhiv, što nam daje izvrsnu kompresiju, ali katastrofalne posljedice u slučaju oštećenja podataka.
Da, potreban je kompromis s obzirom na pouzdanost. No, potrebno je imati na umu da razvijamo format za pohranu podataka za energijski neovisnu memoriju s izuzetno niskim BER-om i deklariranim rokom trajanja podataka od 20 godina.
Tijekom eksperimenta otkrio sam da primjetnije gubitke razine kompresije počinju na blokovima komprimiranih podataka veličine manje od 10KB.
Ranije je spomenuto da korištena memorija ima stranicnu organizaciju, ne vidim razloga zašto ne bismo koristili sukladnost ‘jedna stranica - jedan blok komprimiranih podataka’.
Dakle, minimalna razumna veličina stranice jednaka je 16KB (s rezervom za pomoćne informacije). Međutim, tako mala veličina stranice nameće značajna ograničenja na maksimalnu veličinu zapisa.
Iako trenutno ne planiram zapise veće od jednog kilobajta u komprimiranom obliku, odlučio sam koristiti stranice veličine 32KB (ukupno 128 stranica po čipu).
Sažetak:
- Podatke pohranjujemo komprimirane pomoću zlib (deflate);
- Za svaki zapis postavljamo Z_SYNC_FLUSH;
- Kod svake komprimirane evidencije orezujemo završne bajtove (na primjer, 0x00, 0x00, 0xff, 0xff); u zaglavlju navodimo koliko bajtova smo orezali;
- Podaci se pohranjuju u stranicama od 32 KB; unutar stranice postoji jedinstveni tok komprimiranih podataka; svaka stranica započinje kompresiju iznova.
I, prije nego što završimo s kompresijom, želio bih skrenuti pažnju da imamo samo nekoliko bajtova komprimiranih podataka po zapisu, stoga je izuzetno važno ne povećavati pomoćne informacije, svaki bajt je ovdje važan.
Pohrana zaglavlja podataka
Budući da imamo zapise varijabilne duljine, trebamo nekako odrediti raspored/granice zapisa.
Poznajem tri pristupa:
- Svi zapisi se pohranjuju u kontinuiranom toku, prvo ide zaglavlje zapisa koje sadrži duljinu, a zatim sam zapis.
U ovoj varijanti i zaglavlja i podaci mogu imati varijabilnu duljinu.
U suštini, dobijamo jednosmjernu listu koja se često koristi; - Zaglavlja i sami zapisi pohranjuju se u odvojenim tokovima.
Koristeći zaglavlja fiksne duljine, osiguravamo da kvar jednog zaglavlja ne utječe na ostale.
Sličan pristup se koristi, na primjer, u mnogim datotečnim sustavima; - Zapisi se pohranjuju u kontinuiranom toku, granica zapisa određuje se nekim markerom (simbolom/sekvencijom simbola koji/kvaliteti su zabranjeni unutar blokova podataka). Ako se unutar zapisa naiđe na marker, zamjenjujemo ga s nekom sekvencijom (evidentiramo ga).
Sličan pristup se koristi, na primjer, u PPP protokolu.
Ilustrirat ću.
Opcija 1:
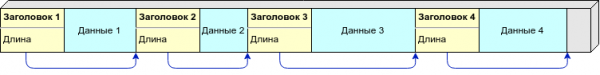
Ovdje je sve vrlo jednostavno: znajući duljinu zapisa, možemo izračunati adresu sljedećeg zaglavlja. Tako se krećemo po zaglavljima dok ne naiđemo na područje ispunjeno 0xff (slobodno područje) ili kraj stranice.
Opcija 2:
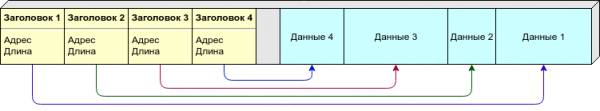
Zbog varijabilne duljine zapisa ne možemo unaprijed reći koliko će zapisa (a time i zaglavlja) biti potrebno na stranici. Možemo razdvojiti zaglavlja i same podatke po različitim stranicama, ali bliži mi se drugi pristup: i zaglavlja i podaci bit će smješteni na jednoj stranici, no zaglavlja (fiksne veličine) dolaze od vrha stranice, dok podatci (varijabilne duljine) dolaze s dna. Kada se „susretnu“ (neće biti dovoljno slobodnog prostora za novi zapis) — smatramo ovu stranicu ispunjenom.
Opcija 3:

Nema potrebe za čuvanjem dužine ili drugih informacija o lokaciji podataka u zaglavlju, dovoljni su oznake koje označavaju granice zapisa. Međutim, podaci se moraju obrađivati prilikom pisanja/čitati.
Kao oznaku bih koristio 0xff (koja je popunjena stranica nakon brisanja), tako da slobodan prostor definitivno neće biti interpretiran kao podaci.
Usporedna tablica:
Opcija 1
Opcija 2
Opcija 3
Otpornost na greške
—
+
+
Kompaktnost
+
—
+
Složenost implementacije
*
**
**
Opcija 1 ima fatalni nedostatak: kada je oštećen neki od zaglavlja, čitav niz koji slijedi se uništava. Ostale opcije omogućuju obnovu dijela podataka čak i pri masovnim oštećenjima.
No, ovdje je prikladno prisjetiti se da smo odlučili pohraniti podatke u komprimiranom obliku, tako da gubimo sve podatke na stranici nakon 'pokvarene' zapis, tako da iako u tablici stoji minus, ne uzimamo ga u obzir.
Kompaktnost:
- u prvoj opciji trebamo pohraniti samo dužinu u zaglavlju, ako koristimo cijele varijable dužine, u većini slučajeva možemo se ograničiti na jedan bajt;
- u drugoj opciji trebamo pohraniti početnu adresu i dužinu; zapis bi trebao imati stalnu veličinu, procjenjujem na 4 bajta po zapisu (dva bajta na pomak, i dva bajta na dužinu);
- trećoj opciji dovoljna je samo jedna oznaka za označavanje početka zapisa, plus sam zapis zbog eskapiranja će rasti za 1-2%. U cjelini, približna paritet s prvom opcijom.
Isprva sam razmatrao drugu opciju kao glavnu (čak sam i napisao implementaciju). Odustao sam od nje tek kada sam konačno odlučio koristiti kompresiju.
Možda ću nekad ipak koristiti sličnu opciju. Na primjer, ako ću se baviti pohranom podataka za brod koji putuje između Zemlje i Marsa — zahtjevi za pouzdanošću su sasvim drugačiji, svemirsko zračenje, ...
Što se tiče treće opcije: dao sam joj dvije zvjezdice zbog složenosti implementacije jednostavno zato što ne volim miješati se s eskapiranjem, promjenom dužine tijekom procesa i slično. Da, možda pristrano, ali kod moram pisati ja — zašto se tjerati da radim ono što ne volim.
Sažetak: Biramo opciju pohrane u obliku lanaca "glava s duljinom — podaci varijabilne duljine" zbog učinkovitosti i jednostavnosti implementacije.
Upotreba bitnih polja za kontrolu uspješnosti operacija pisanja.
Već se ne sjećam gdje sam vidio tu ideju, ali izgleda otprilike ovako:
Za svaki zapis izdvajamo nekoliko bitova za pohranu oznaka.
Kao što smo ranije rekli, nakon brisanja svi bitovi su ispunjeni 1, a možemo mijenjati 1 u 0, ali ne obrnuto. Dakle, za "oznaku nije postavljena" koristimo 1, za "oznaku postavljena" — 0.
Ovako može izgledati smještaj zapisa varijabilne duljine u flash:
- Postavljamo oznaku "zapis duljine je započeo";
- Zapisujemo duljinu;
- Postavljamo oznaku "zapis podataka je započeo";
- Zapisujemo podatke;
- Postavljamo oznaku "zapis je završen".
Osim toga, imat ćemo oznaku "došlo je do pogreške", ukupno 4 bitne oznake.
U tom slučaju imamo dva stabilna stanja "1111" — zapis nije započeo i "1000" — zapis je uspješno prošao; u slučaju neočekivanog prekida procesa pisanja dobit ćemo međustanja koja ćemo moći otkriti i obraditi kasnije.
Pristup je zanimljiv, ali štiti samo od iznenadnog isključivanja napajanja i sličnih kvarova, što je naravno važno, no to nije jedini (a ni glavni) uzrok mogućih kvarova.
Sažetak: Idemo dalje u potrazi za dobrom solucijom.
Kontrolne zbrojeve.
Kontrolne zbrojeve također omogućuju da budemo sigurni (s dovoljno vjerojatnošću) da čitamo upravo ono što je trebalo biti zapisano. I, za razliku od gore spomenutih bitnih polja, oni uvijek rade.
Ako razmotrimo popis potencijalnih izvora problema o kojima smo govorili ranije, kontrolna zbroj može prepoznati pogrešku neovisno o njenom podrijetlu. (osim, možda, zloćudnih vanzemaljaca — oni također mogu krivotvoriti kontrolnu zbroj)..
Dakle, ako je naš cilj provjeriti su cjeloviti, kontrolni zbroj je odlična ideja.
Odabir algoritma za izračun kontrolne zbroja nije izazivao pitanja — CRC. S jedne strane, matematička svojstva omogućuju 100% otkrivanje pogrešaka određenih tipova, a s druge strane, u slučajnim podacima ovaj algoritam obično pokazuje vjerojatnost kolizija neznatno veću od teorijskog limita.  . Iako to nije najbrži algoritam, niti uvijek minimalan po broju kolizija, ima jednu vrlo važnu osobinu: u testovima s kojima sam se susreo nisu se pojavili obrasci na kojima bi očigledno propao. Stabilnost je najvažnija kvaliteta u ovom slučaju.
Primjer opsežnog istraživanja: , (linkovi na narod.ru, izvinite).
Međutim, zadatak odabira kontrolne zbrojke nije završen, CRC je čitava obitelj kontrolnih zbrojki. Potrebno je odlučiti o dužini, a zatim odabrati polinom.
Odabir dužine kontrolne zbrojke nije tako jednostavno pitanje kako se isprva može činiti.
Ilustrirat ću:
Pretpostavimo da imamo vjerojatnost pogreške u svakom bajtu  i idealnu kontrolnu zbrojku, izračunajmo prosječan broj pogrešaka na milijun zapisa:
Podaci, bajt
Kontrolna zbrojka, bajt
Neotkrivene pogreške
Lažna otkrića pogrešaka
Ukupno pogrešnih aktivacija
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Činilo bi se da je sve jednostavno — odaberi dužinu kontrolne zbrojke prema dužini zaštićenih podataka s minimalnim pogrešnim aktivacijama — i to je to.
Međutim, s kratkim kontrolnim zbrojkama javlja se problem: iako dobro otkrivaju pojedinačne bitne pogreške, mogu s dovoljno velikom vjerojatnošću prihvatiti potpuno slučajne podatke kao ispravne. Na Habréu je već bila članak koji opisuje .
Stoga, kako bismo učinili slučajno podudaranje kontrolne zbrojke praktički nemogućim, trebamo koristiti kontrolne zbrojke dužine 32 bita i više (za duljine veće od 64 bita obično se koriste kriptografske hash funkcije).
Iako sam ranije rekao da trebamo štediti prostor svim silama, ipak ćemo koristiti kontrolnu zbrojku od 32 bita (16 bita je premalo, vjerojatnost kolizije veća od 0,01%; a 24 bita, kao što se kaže, ni tu ni tamo).
Ovdje bi se moglo postaviti pitanje: zar smo štedjeli svaki bajt prilikom odabira kompresije da bismo sada odrekli 4 bajta odjednom? nije li bolje bilo ne komprimirati i ne dodavati kontrolnu zbrojku? Naravno da nije, odsustvo kompresije ne znači, da nam provjera cjelovitosti nije potrebna.
O izboru polinoma nećemo izmišljati bicikl, već ćemo uzeti trenutno popularni CRC-32C.
Ovaj kod otkriva 6 bitnih grešaka u paketima do 22 bajta (verovatno najčešći slučaj za nas), 4 bitne greške u paketima do 655 bajta (takođe čest slučaj za nas), 2 ili bilo koji neparni broj bitnih grešaka u paketima bilo koje razumnе dužine.
Ako je nekome zanimljivo više detalja
o CRC-u.
na — verovatno glavnog stručnjaka za CRC na planeti.
U ima , koji pruža malo bolje parametre za relevantne dužine paketa, ali nisam smatrao razliku značajnom, a sebe dovoljno kompetentnim da odaberem prilagođeni kod umesto standardnog i dobro istraženog.
Takođe, s obzirom na to da su naši podaci kompresovani, postavlja se pitanje: da li računati kontrolnu sumu nad kompresovanim ili nekompresovanim podacima?
Argumenti „za“ računanje kontrolne sume nekompresovanih podataka:
- na kraju nam je potrebno da proverimo očuvanje podataka — to direktno i proveravamo (pri tom će biti proverene i moguće greške u implementaciji kompresije/dekompresije, oštećenja izazvana lošom memorijom itd.);
- algoritam deflate u zlib-u ima dovoljno zrelu implementaciju i ne bi trebalo da pada pri „krivim“ ulaznim podacima, više od toga, često je sposoban sam da otkrije greške u ulaznom toku, smanjujući ukupnu verovatnoću neotkrivanja greške (proveo sam test sa inverzovanjem jednog bita u kratkoj snimci, zlib je otkrio grešku otprilike u trećini slučajeva).
Argumenti „protiv“ računanja kontrolne sume nekompresovanih podataka:
- CRC je „prilagođen“ upravo za malo bitnih grešaka koje su karakteristične za flash memoriju (bitna greška u kompresovanom toku može prouzrokovati masovnu promenu izlaznog toka, na kojem, čisto teoretski, možemo „uhvatiti“ koliziju);
- nisam posebno srećan s idejom da šaljem dekompresoru potencijalno oštećene podatke, , kako će on reagovati.
U ovom projektu sam odlučio da odstupim od opšteprihvaćene prakse skladištenja kontrolne sume nekompresovanih podataka.
Sažetak: koristimo CRC-32C, kontrolnu sumu računamo od podataka u onom obliku u kojem se beleže u flash (posle kompresije).
Redundancija
Korištenje redundantnog kodiranja, naravno, ne može isključiti gubitak podataka, no može značajno (često za nekoliko redova) smanjiti vjerojatnost nepovratnog gubitka podataka.
Možemo koristiti različite vrste redundancije kako bismo ispravili greške.
Hammingovi kodovi mogu ispraviti pojedinačne greške na bitu, Reed-Solomon kodovi na razini simbola, više kopija podataka zajedno s kontrolnim zbrojevima ili kodiranje poput RAID-6 može pomoći u oporavku podataka čak i u slučaju masovnih oštećenja.
Isprva sam bio sklon širokom korištenju kodiranja otpornog na smetnje, no zatim sam shvatio da prvo trebamo imati predstavu o tome s kakvim greškama se želimo zaštititi, a potom odabrati kodiranje.
Ranije smo pričali o tome da greške treba otkriti što je brže moguće. U kojim trenucima se možemo susresti s greškama?
- Nepotpisi zapis (iz raznih razloga, iznenada se isključila struja, Raspberry se zamrzao, …)
Nažalost, u slučaju ovakve greške ostaje samo ignorirati neispravne zapise i smatrati podatke izgubljenima; - Greške pri zapisivanju (iz raznih razloga u flash memoriju je zapisano ono što nije smjelo)
Takve greške možemo odmah otkriti ako neposredno nakon zapisivanja napravimo kontrolno očitanje; - Iskrivljenje podataka u memoriji tijekom pohrane;
- Greške pri očitanju
Za ispravljanje je dovoljno, u slučaju neslaganja kontrolnog zbroja, nekoliko puta ponoviti očitanje.
Dakle, samo greške trećeg tipa (spontano propadanje podataka tijekom skladištenja) ne mogu se ispraviti bez kodiranja otpornog na smetnje. Čini mi se da su takve greške ipak iznimno malo vjerojatne.
Sažetak: odlučeno je odustati od redundantnog kodiranja, no, ako eksploatacija pokaže pogrešnost ove odluke, vratit će se na razmatranje pitanja (s već akumuliranom statistikom o kvarovima koja će omogućiti odabir optimalne vrste kodiranja).
Ostalo
Naravno, format članka ne dopušta obrazlaganje svake pojedinosti u formatu (ionako su mi već ponestali snage), stoga ću kratko proći kroz neke točke koje nisu prethodno spomenute.
- Odlučeno je napraviti sve stranice „ravnopravnima“
To znači da neće biti nekih posebnih stranica s metapodacima, odvojenim tokovima itd., umjesto toga jedinstveni tok koji prepisuje sve stranice redom.
To osigurava ravnomjernu potrošnju stranica, izbjegava jedinstvenu tačku kvara i jednostavno se sviđa; - Obavezno je predvidjeti verzioniranje formata.
Format bez broja verzije u zaglavlju je zlo!
Dovoljno je dodati u zaglavlje stranice polje s nekim Magic Number (potpisom) koje će ukazivati na korištenu verziju formata. (ne mislim da će ih u praksi biti više od desetak); - Koristiti za zapise (kojih ima jako puno) zaglavlje varijabilne dužine, trudeći se da većinu slučajeva učinimo njegovu dužinu 1 bajt;
- Za kodiranje dužine zaglavlja i dužine skraćene komprimirane datoteke koristiti binarne kodove varijabilne dužine.
Jako je pomoglo Huffmanovih kodova. Doslovno za nekoliko minuta uspjelo je odabrati potrebne kodove varijabilne dužine.
Opis formata za pohranu podataka
Redoslijed bajtova
Polja veličine većih od jednog bajta pohranjuju se u big-endian formatu (mrežni redoslijed bajtova), to jest 0x1234 se zapisuje kao 0x12, 0x34.
Podjela na stranice
Sva flash memorija podijeljena je na stranice jednake veličine.
Zadana veličina stranice je 32KB, ali ne više od 1/4 ukupne veličine čipa memorije (za čip od 4MB to daje 128 stranica).
Svaka stranica pohranjuje podatke neovisno od drugih (to jest podaci jedne stranice ne referenciraju podatke druge stranice).
Sve stranice su numerirane u prirodnom redu (po rastućim adresama), počinjući s brojem 0 (nulta stranica počinje s adresom 0, prva s 32KB, druga s 64KB itd.)
Čip memorije koristi se kao ciklički bafer (ring buffer), to jest prvo zapis ide u stranicu s brojem 0, zatim s brojem 1, …, kada napunimo posljednju stranicu, ciklus započinje iznova i zapis se nastavlja od nulte stranice.
Unutar stranice
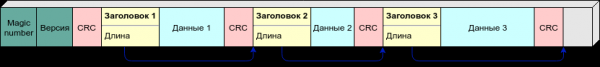
Na početku stranice pohranjuje se 4-bajtni zaglavlje stranice, zatim kontrolna suma zaglavlja (CRC-32C), a zatim se pohranjuju zapisi u formatu 'zaglavlje, podaci, kontrolna suma'.
Zaglavlje stranice (na dijagramu prljavo-zelene boje) sastoji se od:
- dvobajtno polje Magic Number (također signal verzije formata)
za trenutnu verziju formata smatra se kao0xed00 ⊕ broj stranice; - dvo-byte broj ‘Verzija stranice’ (broj ciklusa ponovnog zapisivanja memorije).
Zapisi na stranici čuvaju se u kompresiranom obliku (koristi se algoritam deflate). Svi zapisi na jednoj stranici komprimiraju se u jednom toku (koristi se zajednički rječnik), a na svakoj novoj stranici kompresija započinje iznova. Dakle, za dekompresiju bilo kojeg zapisa potrebni su svi prethodni zapisi s te stranice (i samo s te).
Svaki zapis će se komprimirati s oznakom Z_SYNC_FLUSH, pri čemu na kraju komprimiranog toka ostaje 4 bajta 0x00, 0x00, 0xff, 0xff, prethodnih, možda, još jednim ili dva nula bajta.
Tu sekvencu (dužine 4, 5 ili 6 bajtova) odbacujemo prilikom zapisivanja u flash memoriju.
Zaglavlje zapisa sastoji se od 1, 2 ili 3 bajta, koji sadrže:
- jedan bit (T), koji označava vrstu zapisa: 0 — kontekst, 1 — dnevnik;
- polje promjenljive dužine (S) od 1 do 7 bita, koje određuje dužinu zaglavlja i ‘rep’ koji treba dodati zapisu za raspakiranje;
- dužinu zapisa (L).
Tablica vrijednosti S:
S
Duljina zaglavlja, bajt
Odbacuje se prilikom zapisivanja, bajt
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Pokušao sam ilustrirati, ne znam koliko je to jasno:
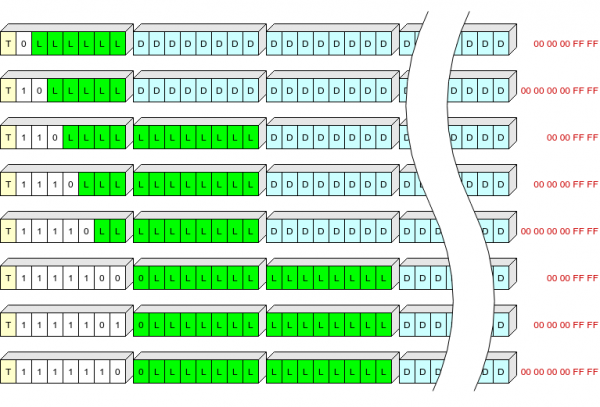
Žutim je označeno polje T, bijelim — polje S, zelenim L (dužina komprimiranih podataka u bajtima), plavim — komprimirani podaci, crvenim — završni bajtovi komprimiranih podataka, koji se ne upisuju u flash memoriju.
Tako ćemo moći zapisati zaglavlja zapisa najčešće dužine (do 63+5 bajtova u komprimiranom obliku) s jednim bajtom.
Iza svakog zapisa pohranjuje se kontrolna suma CRC-32C, koja kao inicijalnu vrijednost (init) koristi inverznu vrijednost prethodne kontrolne sume.
CRC ima svojstvo ‘produžetka’, djeluje (plus-minus inverzija bitova u procesu) takva formula:  .
Dakle, zapravo izračunavamo CRC svih prethodnih bajtova zaglavlja i podataka na ovoj stranici.
Odmah iza kontrolne sume nalazi se zaglavlje sljedećeg zapisa.
Zaglavlje je konstruirano tako da je prvi njegov bajt uvijek različit od 0x00 i 0xff (ako umjesto prvog bajta zaglavlja naiđemo na 0xff, to znači da je to zasad neiskorišteno područje; 0x00 signalizira grešku).
Primjeri algoritama
Čitanje iz flash memorije
Svako čitanje ide s provjerom kontrolne sume.
Ako kontrolna suma ne odgovara, čitanje se ponavlja nekoliko puta s nadom da će se konačno pročitati točni podaci.
(to ima smisla, Linux ne kešira čitanje iz NOR Flash, provjereno)
Zapisivanje u flash memoriju
Zapisujemo podatke.
Čitamo ih.
Ako pročitani podaci ne odgovaraju zapisanim, ispunjavamo područje nulama i signaliziramo grešku.
Priprema nove mikročip za rad
Za inicijalizaciju, u prvu (točnije, nultu) stranicu se zapisuje zaglavlje s verzijom 1.
Nakon toga, u tu stranicu se zapisuje inicijalni kontekst (sadrži UUID uređaja i zadane postavke).
Sve, flash memorija je spremna za rad.
Učitavanje uređaja
Pri učitavanju se čitaju prvih 8 bajtova svake stranice (zaglavlje + CRC), stranice s nepoznatim Magic Numberom ili neispravnim CRC se ignoriraju.
Iz "ispravnih" stranica biraju se stranice s maksimalnom verzijom, od njih se uzima stranica s najvećim brojem.
Čita se prvi zapis, provjerava se ispravnost CRC-a, prisutnost oznake "kontekst". Ako je sve u redu, ova stranica se smatra trenutnom. Ako nije, vraćamo se na prethodnu dok ne pronađemo "živu" stranicu.
Na pronađenoj stranici čitamo sve zapise, a one s oznakom "kontekst" primijenjujemo.
Spremamo zlib rječnik (bit će potreban za dodatno zapisivanje u ovu stranicu).
Sve, učitavanje je završeno, kontekst je obnovljen, možemo raditi.
Dodavanje zapisa u dnevnik
Stisnemo zapis s pravim rječnikom, označavajući Z_SYNC_FLUSH. Provjeravamo staje li kompresirani zapis na trenutnoj stranici.
Ako ne stane (ili ako su na stranici bile greške CRC), započinjemo novu stranicu (vidi dolje).
Zapisujemo zapis i CRC. Ako dođe do greške, započinjemo novu stranicu.
Nova stranica
Biramo slobodnu stranicu s minimalnim brojem (slobodnom smatramo stranicu s pogrešnom kontrolnom sumom u zaglavlju ili s verzijom manjom od trenutne). Ako takvih stranica nema, biramo stranicu s minimalnim brojem koja ima verziju jednaku trenutnoj.
Odabranom stranici postavljamo erase. Provjeravamo sadržaj s 0xff. Ako nešto nije u redu, uzimamo sljedeću slobodnu stranicu, itd.
Na izbrisanu stranicu zapisujemo zaglavlje, a prvim zapisom trenutno stanje konteksta, sljedećim — neupisani zapis dnevnika (ako ga ima).
Primjenjivost formata
Po mom mišljenju, ovo je dobar format za pohranu bilo kakvih više-manje kompresibilnih informacija (plain text, JSON, MessagePack, CBOR, možda protobuf) u NOR Flash.
Naravno, format je ''prilagođen'' za SLC NOR Flash.
Ne bi ga trebalo koristiti s medijima s visokim BER-om, kao što su NAND ili MLC NOR. (Postoji li uopće takva memorija na prodaji? Vidio sam spominjanje samo u radu o kodovima korekcije.).
Tim više, ne bi ga trebalo koristiti s uređajima koji imaju vlastiti FTL: USB flash, SD, MicroSD itd. (Za takvu memoriju sam napravio format s veličinom stranice od 512 bajtova, s potpisom na početku svake stranice i jedinstvenim brojevima zapisa — ponekad se iz ''kvareće'' flash memorije uspijevalo jednostavnim sekvencijalnim čitanjem obnoviti sve podatke.).
Ovisno o zadatcima, format se može koristiti bez promjena na flash uređajima od 128Kbit (16Kb) do 1Gbit (128Mb). Ako želite, može se koristiti i na čipovima veće kapacitete, samo je vjerojatno potrebno prilagoditi veličinu stranice. (Ali tu se već postavlja pitanje ekonomske isplativosti, cijena na NOR Flash velikog kapaciteta nije ohrabrujuća.).
Ako se nekome format učinio zanimljivim, i želi ga koristiti u otvorenom projektu — javite se, potrudit ću se naći vremena, urediti kod i staviti na github.
Zaključak
Kao što vidimo, na kraju se format pokazao jednostavnim. i čak dosadnim..
U članku je teško prikazati evoluciju svog stajališta, ali vjerujte: isprva sam želio stvoriti nešto složeno, neuništivo, sposobno preživjeti čak i nakon nuklearnog udara u neposrednoj blizini. Međutim, razum (nadam se) je na kraju pobijedio i prioriteti su se postupno pomaknuli na jednostavnost i kompaktnost.
Može li se dogoditi da sam pogriješio? Da, naravno. Sve je moguće, na primjer, da smo kupili seriju nekvalitetnih čipova. Ili iz nekog drugog razloga oprema neće ispuniti očekivanja u pogledu pouzdanosti.
Imam li plan za takav slučaj? Mislim da iz čitanja članka ne sumnjate da plan postoji. I to ne jedan.
Ako malo ozbiljnije, format je razvijen istovremeno kao radna varijanta i kao ''probna lopta''.
Trenutno sve radi normalno, doslovno u narednih nekoliko dana rješenje će biti implementirano. (otprilike) na stotinama uređaja, vidjet ćemo što će se događati u 'borbenoj' eksploataciji (nadam se da format omogućuje pouzdano otkrivanje grešaka; tako da ćemo moći prikupiti potpune statistike). Nakon nekoliko mjeseci moći ćemo donositi zaključke. (a ako ne budemo imali sreće — onda i ranije).
Ako se prilikom korištenja otkriju ozbiljni problemi i potrebna su poboljšanja, obavezno ću o tome napisati.
Literatura
Nisam želio sastavljati dugi dosadni popis korištenih radova, na kraju krajeva, Google svi imaju.
Ovdje sam odlučio ostaviti popis otkrića koja su mi se činila posebno zanimljivima, ali postupno su prebačena izravno u tekst članka, a u popisu je ostala samo jedna stavka:
- Alat od autora zlib. Zna prikazivati sadržaj arhiva deflate/zlib/gzip na razumljiv način. Ako se bavite unutarnjom strukturom formata deflate (ili gzip) — toplo preporučujem.
Izvor: habr.com
