

Neke tvrtke, uključujući našeg klijenta, razvijaju proizvod putem partnerske mreže. Na primjer, velika internetska trgovina integrirana je sa službom dostave — naručujete proizvod i uskoro dobivate broj za praćenje pošiljke. Drugi primjer je kada uz avionsku kartu kupujete osiguranje ili kartu za aerodromsku ekspresnu uslugu.
Za to se koristi jedan API koji treba dati partnerima putem API Gateway-a. Ovu zadaću smo i riješili. U ovom članku ćemo detaljno opisati.
Imamo: ekosustav i API portal s sučeljem, gdje su korisnici registrirani, dobivaju informacije itd. Trebamo stvoriti prikladan i pouzdan API Gateway. U procesu trebamo osigurati
- registraciju,
- kontrolu pristupa API-ju,
- monitoring korištenja završnog sustava od strane korisnika,
- praćenje poslovnih pokazatelja.
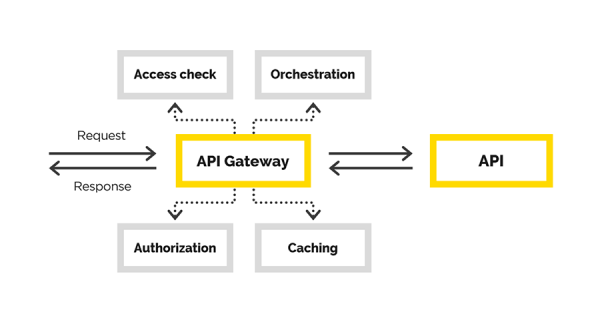
U članku ćemo govoriti o našem iskustvu stvaranja API Gateway-a, tijekom kojeg smo se suočili s sljedećim zadatcima:
- autentifikacija korisnika,
- autorizacija korisnika,
- modifikacija izvorne zahtjeva,
- proksiranje zahtjeva,
- postprocesiranje odgovora.
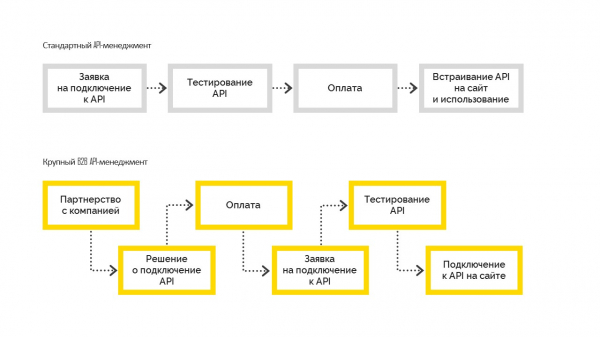
Postoje dva tipa API upravljanja:
1. Standardno, koje funkcionira na sljedeći način. Prije povezivanja korisnik testira mogućnosti, zatim plaća i integrira se na svoju stranicu. Najčešće ga koriste mala i srednja poduzeća.
2. Veliko B2B API upravljanje, kada tvrtka prvo donosi poslovnu odluku o povezivanju, postaje partner tvrtke s ugovornom obvezom, a zatim se povezuje na API. I tek nakon rješavanja svih formalnosti, kompanija dobiva probni pristup, prolazi testiranje i prelazi u proizvodnju. No, to nije moguće bez upravljačke odluke o povezivanju.
Naše rješenje
U ovom dijelu govorit ćemo o stvaranju API Gateway-a.
Krajnji korisnici stvorenog API Gateway-a su partneri našeg klijenta. Za svakog od njih već imamo potrebne ugovore. Morat ćemo samo proširiti funkcionalnost, označavajući dodijeljeni pristup gateway-u. Odsud, potreban je kontrolirani proces povezivanja i upravljanja.
Naravno, moglo se uzeti neko rješenje koje već postoji za rješavanje zadatka upravljanja API-jem i stvaranja API Gateway-a posebno. Na primjer, to bi moglo biti. Nije nam odgovarao, jer smo već imali API portal i ogromnu ekosustav izgrađenu oko njega. Svi su korisnici već bili registrirani, znali su gdje i kako mogu dobiti potrebne informacije. U API portalu već su postojala potrebna sučelja, samo nam je bio potreban API Gateway. Na tome smo se zapravo i fokusirali.
Ono što nazivamo API Gateway — svojevrsni je proxy. Ponovno smo imali izbor — mogli smo napisati svoj proxy ili izabrati nešto već gotovog. U ovom slučaju odlučili smo se za drugu opciju i izabrali kombinaciju nginx+Lua. Zašto? Trebali smo pouzdan, testiran softver koji podržava skalabilnost. Nismo željeli nakon implementacije provjeravati i ispravnost poslovne logike i ispravnost rada proxyja.
Svaki web server ima cjelinu za obradu zahtjeva. U slučaju nginx-a izgleda ovako:
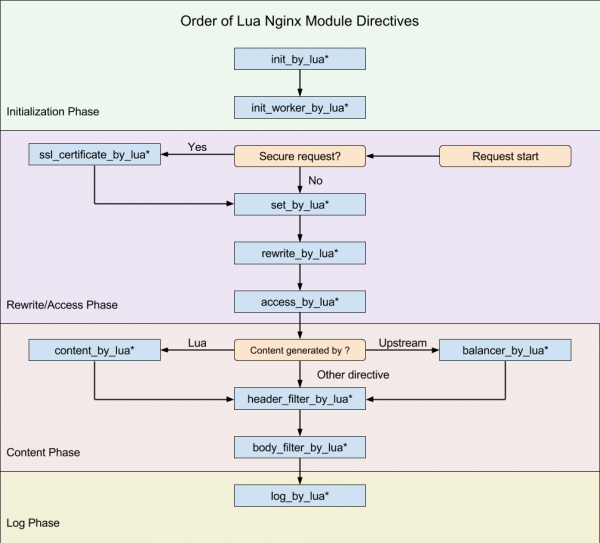
(shema iz )
Naš cilj bio je ugraditi se u ovu cjelinu u trenutku kada možemo modificirati izvorni zahtjev.
Želimo stvoriti transparentni proxy, tako da funkcionalno zahtjev ostane onakvim kakvim je i stigao. Samo kontroliramo pristup konačnom API-ju, pomažemo zahtjevu da dođe do njega. U slučaju da je zahtjev bio neispravan, greška bi trebala biti prikazana od strane konačnog API-ja, a ne od nas. Jedini razlog zašto možemo odbiti zahtjev je nedostatak pristupa klijenta.
Za nginx već postoji na . Lua je skriptni jezik, vrlo je lagan i jednostavan za učenje. Tako smo potrebnu logiku implementirali putem Lua.
Konfiguracija nginx-a (analogija rute aplikacije), gdje se izvršava sav posao, je prilično jasna. Ovdje je zanimljiva posljednja direktiva — post_action.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
Pogledajmo što se događa u ovoj konfiguraciji:
more_clear_input_headers — čisti vrijednost navedenih nakon direktive headera.
lua_need_request_body — regulira treba li pročitati izvorno tijelo zahtjeva prije nego što se izvrše direktive rewrite/access/access_by_lua ili ne. Prema zadanim postavkama nginx ne čita tijelo zahtjeva klijenta, a ako trebate pristupiti istome, ova direktiva mora imati vrijednost on.
rewrite_by_lua_file — put do skripte gdje je opisana logika za modifikaciju zahtjeva
access_by_lua_file — put do skripte gdje je opisana logika koja provjerava dostupnost resursa.
proxy_pass — url na koji će zahtjev biti proksiran.
body_filter_by_lua_file — put do skripte gdje je opisana logika za filtriranje zahtjeva prije vraćanja klijentu.
I, na kraju, post_action — službeno nedokumentirana direktiva pomoću koje se mogu izvoditi dodatne radnje nakon što je odgovor poslan klijentu.
Sljedeće ćemo opisati redoslijedom kako smo rješavali svoje zadatke.
Autorizacija/ autentifikacija i modifikacija zahtjeva
Autorizacija
Autorizaciju i autentifikaciju izgradili smo pomoću pristupa putem certifikata. Imamo korijenski certifikat. Svakom novom klijentu naručitelja generira se njegov osobni certifikat, s kojim može pristupiti API-ju. Ovaj certifikat se konfigurira u sekciji server podešavanja nginx-a.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
Modifikacija
Može se postaviti pošteno pitanje: što učiniti s certificiranim klijentom ako iznenada poželimo isključiti ga iz sustava? Ne možemo ponovno izdavati certifikate za sve ostale klijente.
Tako smo polako došli do sljedeće zadaće — modifikacija izvornog zahtjeva. Izvorni zahtjev klijenta, u načelu, nije valjan za konačni sustav. Jedan od zadataka je dodati nedostajuće dijelove u zahtjev kako bi ga učinili valjanim. Problem je u tome što nedostajući podaci variraju za svakog klijenta. Znamo da klijent dolazi k nama s certifikatom iz kojeg možemo uzeti otisak i izvući potrebne podatke klijenta iz baze.
Ako u nekom trenutku bude potrebno isključiti klijenta iz našeg servisa, njegovi podaci će nestati iz baze i neće moći ništa raditi.
Rad s podacima klijenta
Trebalo nam je osigurati visoku dostupnost rješenja, posebno u načinu na koji dobivamo podatke klijenta. Težina leži u tome što je izvor tih podataka — vanjska usluga koja ne jamči neprekidno i dovoljno visoko radno brzinu.
Zbog toga smo trebali osigurati visoku dostupnost podataka klijenata. Kao alat odabrali smo , koji nam pruža:
- brzi pristup podacima,
- mogućnost organiziranja klastera od više čvorova s repliciranim podacima na različitim čvorovima.
Odabrali smo najjednostavniju strategiju isporuke podataka u predmemoriju:
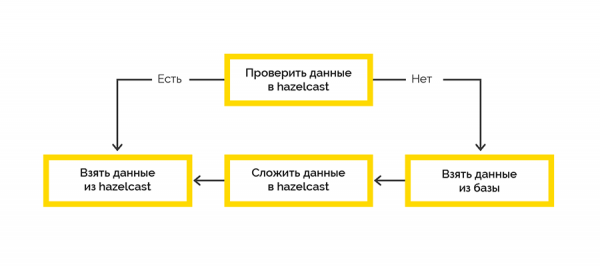
Rad s krajnjim sustavom odvija se unutar sesija i postoji ograničenje na maksimalni broj. Ako klijent ne zatvori sesiju, to ćemo morati učiniti mi.
Podaci o otvorenoj sesiji dolaze iz krajnjeg sustava i prvotno se obrađuju na strani Lua. Odlučili smo koristiti Hazelcast za pohranu ovih podataka uz pomoć posla napisanog na .NET-u. Zatim s određenom periodičnošću provjeravamo status otvorenih sesija i zatvaramo iste koje su istekle.
Pristup Hazelcastu i iz Lua i iz .NET
Na Lua nema klijenata za rad s Hazelcastom, ali Hazelcast ima REST API koji smo odlučili iskoristiti. Za .NET imamo , preko kojeg smo planirali dobiti pristup podacima Hazelcast na strani .NET-a. No, to nije bilo tako jednostavno.
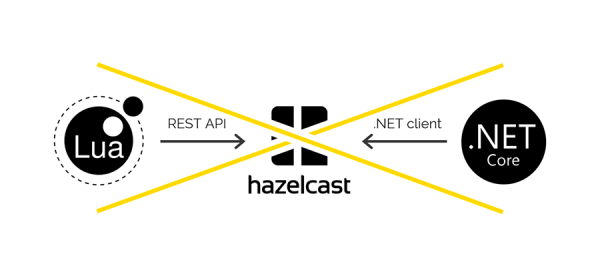
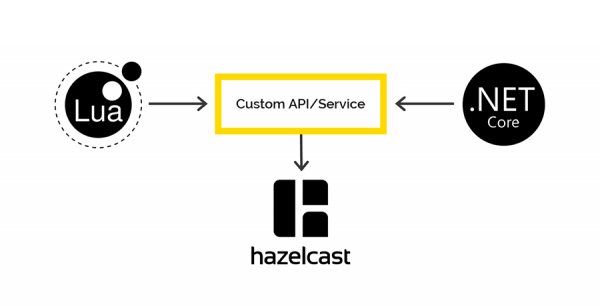
Pri pohrani podataka putem REST-a i njihovom dohvaćanju putem .NET klijenta koriste se različiti serijalizatori/deserijalizatori. Stoga nije moguće pohraniti podatke putem REST-a, a zatim ih dohvatiti putem .NET klijenta i obrnuto.
Ako će biti zainteresiranih, detaljnije ćemo o ovom problemu pisati u posebnom članku. Spoiler — na shemici.
Zapisivanje i praćenje
Naš korporativni standard za zapisivanje putem .NET-a je Serilog, svi logovi na kraju odlaze u Elasticsearch, a njihovu analizu obavljamo putem Kibane. Nešto slično smo htjeli postići i u ovom slučaju. Jedini alat za rad s Elasticom na Lua, koji je pronađen, slomio se već prilikom prvog require. I koristili smo Fluentd.
— open source rješenje za osiguranje jedinstvenog sloja zapisivanja aplikacije. Omogućava prikupljanje logova s različitih slojeva aplikacije, a zatim njihovo preusmjeravanje u jedinstveni izvor.
API Gateway radi u K8S, stoga smo odlučili dodati kontejner s fluentd-om u isti pod, kako bismo zapisivali logove u postojeći otvoreni tcp port fluentd-a.
Također smo istraživali kako će se fluentd ponašati ako ne bude imao vezu s Elasticsearchom. Tijekom dva dana u gateway su neprekidno dolazili zahtjevi, a u fluentd su se slali logovi, ali je fluentd-ov IP bio blokiran od strane Elastic-a. Nakon uspostavljanja veze, fluentd je odlično prenio apsolutno sve logove u Elastic.
Zaključak
Odabrani pristup implementaciji omogućio nam je da dostavimo stvarno funkcionalan proizvod u produkcijsko okruženje za samo 2.5 mjeseca.
Ako se ikada upustite u slične projekte, preporučujemo da prvo jasno shvatite koju svrhu želite postići i koje resurse već imate na raspolaganju. Budite oprezni s poteškoćama integracije s postojećim sustavima upravljanja API-jem.
Razumite što točno planirate razvijati — samo poslovnu logiku obrade zahtjeva ili, kao što je to bio naš slučaj, cjelokupni proxy. Ne zaboravite, sve što izradite mora naknadno biti temeljito testirano.
Izvor: habr.com
