

Predgovor
Korisnici, programeri i administratori MS SQL Server baze podataka često se suočavaju s problemima performansi baze podataka ili same baze podataka, stoga je praćenje MS SQL Server-a vrlo važno.
Ovaj članak je dopuna članku u kojem će se razmotriti neki aspekti praćenja MS SQL Server-a, posebno: kako brzo odrediti koji resursi nedostaju, kao i preporuke za podešavanje tragova.
Za rad sljedećih skripti potrebno je stvoriti shemu inf u željenoj bazi podataka na sljedeći način:
Kreiranje sheme inf
use ;
go
create schema inf;
Metoda za otkrivanje nedostatka radne memorije
Prvi pokazatelj nedostatka radne memorije je situacija kada instanca MS SQL Servera koristi svu dodijeljenu RAM.
Stoga ćemo stvoriti sljedeće prikazivanje inf.vRAM:
Kreiranje prikazivanja inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						--koliko slobodne RAM na serveru u MB
		 , a.[RAM_Avail_Percent]					--procenat slobodne RAM na serveru
		 , a.[Server_physical_memory_Mb]				--koliko ukupno RAM na serveru u MB
		 , a.[SQL_server_committed_target_Mb]			--koliko ukupno RAM je dodijeljeno MS SQL Serveru u MB
		 , a.[SQL_server_physical_memory_in_use_Mb] 		--koliko ukupno RAM koristi MS SQL Server u ovom trenutku u MB
		 , a.[SQL_RAM_Avail_Percent]				--procenat slobodne RAM za MS SQL Server u odnosu na ukupno dodijeljenu RAM za MS SQL Server
		 , a.[StateMemorySQL]						--ima li dovoljno RAM za MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent]				--procenat rezervisane RAM za MS SQL Server u odnosu na ukupnu RAM servera
		 --ima li dovoljno RAM za server
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Upozorenje' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Opasnost' else 'Normalno' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Upozorenje' else 'Normalno' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Tada možete odrediti da instanca MS SQL Server koristi svu njemu dodijeljenu memoriju sljedećim upitom:
select SQL_server_physical_memory_in_use_Mb, SQL_server_committed_target_Mb
from [inf].[vRAM];
Ako je vrijednost SQL_server_physical_memory_in_use_Mb stalno manja od SQL_server_committed_target_Mb, potrebno je provjeriti statistiku čekanja.
Za određivanje nedostatka operativne memorije preko statistike čekanja, stvorit ćemo prikaz inf.vWaits:
Izrada prikaza inf.vWaits
KREIRAJ pogled [inf].[vWaits] kao
S [Waits] KAO
    (ODABERI
        [wait_type], --ime tipa čekanja
        [wait_time_ms] / 1000.0 AS [WaitS], --Ukupno vrijeme čekanja za ovaj tip u milisekundama. Ovo vrijeme uključuje signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS], --Ukupno vrijeme čekanja za ovaj tip u milisekundama bez signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS], --Razlika između vremena signalizacije čekajuće niti i vremena početka njenog izvršenja
        [waiting_tasks_count] AS [WaitCount], --Broj čekanja za ovaj tip. Ovaj broj se povećava svake puta kada započne čekanje
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        REDNI BROJ() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    IZ sys.dm_os_wait_stats
    GDJE [waiting_tasks_count] > 0
		i [wait_type] NE U (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress kao (
	ODABERI
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S], --Ukupno vrijeme čekanja za ovaj tip u milisekundama. Ovo vrijeme uključuje signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S], --Ukupno vrijeme čekanja za ovaj tip u milisekundama bez signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S], --Razlika između vremena signalizacije čekajuće niti i vremena početka njenog izvršenja
	    [W1].[WaitCount] AS [WaitCount], --Broj čekanja za ovaj tip. Ovaj broj se povećava svake puta kada započne čekanje
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	IZ [Waits] AS [W1]
	UNUTAR SPOJITE [Waits] AS [W2]
	    NA [W2].[RowNum] <= [W1].[RowNum]
	GRUPIŠI PO [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	IMAJUĆI SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- prag postotka
)
ODABERI [WaitType]
      ,MAKS ([Wait_S]) kao [Wait_S]
      ,MAKS ([Resource_S]) kao [Resource_S]
      ,MAKS ([Signal_S]) kao [Signal_S]
      ,MAKS ([WaitCount]) kao [WaitCount]
      ,MAKS ([Percentage]) kao [Percentage]
      ,MAKS ([AvgWait_S]) kao [AvgWait_S]
      ,MAKS ([AvgRes_S]) kao [AvgRes_S]
      ,MAKS ([AvgSig_S]) kao [AvgSig_S]
  IZ ress
  grupiši po [WaitType];
U ovom slučaju, nedostatak RAM-a može se odrediti sljedećim upitom:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Ovdje treba obratiti pažnju na pokazatelje Percentage i AvgWait_S. Ako su oni značajni u svojoj ukupnosti, postoji velika vjerojatnost da MS SQL Serveru nedostaje RAM-a. Značajne vrijednosti određuju se individualno za svaki sustav. Međutim, можно započeti s sljedećim pokazateljom: Percentage>=1 i AvgWait_S>=0.005.
Za prikaz pokazatelja u sustavu nadzora (na primjer, Zabbix) možete stvoriti sljedeća dva upita:
- koliko u postotcima zauzimaju tipovi čekanja prema RAM-u (zbroj svih takvih tipova čekanja):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - koliko u milisekundama zauzimaju tipovi čekanja prema RAM-u (maksimalna vrijednost iz svih srednjih kašnjenja po svim takvim tipovima čekanja):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
           'PAGEIOLATCH_XX',
           'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Na temelju dinamike dobivenih vrijednosti za ova dva pokazatelja, može se zaključiti je li RAM dovoljan za instancu MS SQL Servera.
Metoda otkrivanja prekomjernog opterećenja na CPU
Za otkrivanje nedostatka procesorskog vremena, dovoljno je iskoristiti sistemsku predstavu sys.dm_os_schedulers. Ovdje, ako je pokazatelj runnable_tasks_count konstantno veći od 1, postoji velika vjerojatnost da instanci MS SQL Servera nedostaje jezgri.
Za prikaz pokazatelja u sustavu nadzora (na primjer, Zabbix) možete stvoriti sljedeći upit:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id<255;
Na temelju dinamike dobivenih vrijednosti za ovaj pokazatelj, može se zaključiti je li procesorsko vrijeme (broj jezgri CPU) dovoljno za instancu MS SQL Servera.
Međutim, važno je imati na umu da same upite mogu zatražiti više tokova odjednom. Ponekad optimizator ne može pravilno procijeniti složenost samog upita. Tada se upitu može dodijeliti previše tokova koji trenutno ne mogu biti obrađeni. To također izaziva tip čekanja povezan s nedostatkom procesorskog vremena i povećanjem reda čekanja na planere koji koriste određena CPU jezgra, tj. pokazatelj runnable_tasks_count će u takvim uvjetima rasti.
U tom slučaju, prije nego što povećate broj CPU jezgara, važno je pravilno konfigurirati svojstva paralelizma samog MS SQL Server instance, a od verzije 2016. ispravno postaviti svojstva paralelizma za potrebne baze podataka:
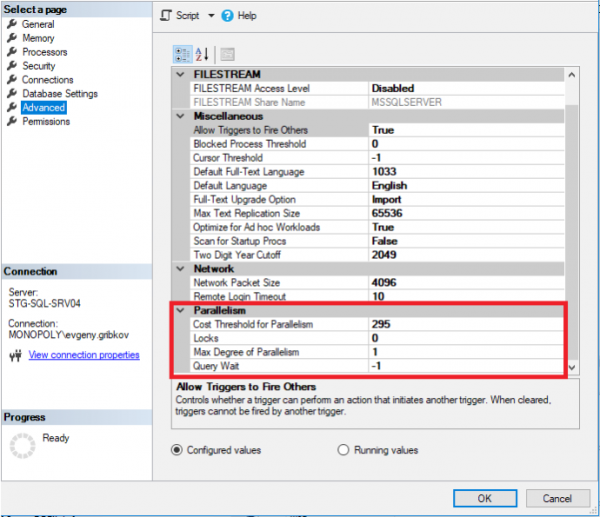
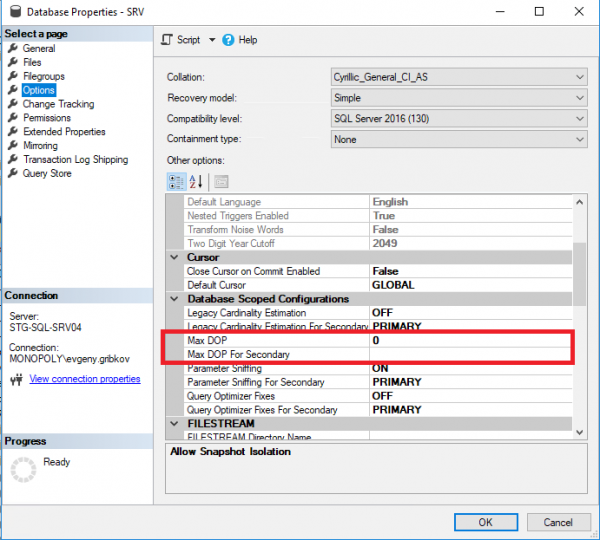
Ovdje je važno obratiti pažnju na sljedeće parametre:
- Max Degree of Parallelism - postavlja maksimalni broj tokova koji se mogu dodijeliti svakom upitu (po defaultu postavljeno na 0 - ograničenje postavlja samo operativni sustav i verzija MS SQL Server-a)
- Cost Threshold for Parallelism - procijenjena cijena paralelizma (po defaultu postavljeno na 5)
- Max DOP - postavlja maksimalni broj tokova koji se mogu dodijeliti svakom upitu na razini baze podataka (no ne više od vrijednosti svojstva „Max Degree of Parallelism”) (po defaultu postavljeno na 0 - ograničenje postavlja samo operativni sustav i verzija MS SQL Server-a, kao i ograničenje prema svojstvu „Max Degree of Parallelism” cijele instance MS SQL Server-a)
Ovdje nije moguće dati jednako dobar recept za sve slučajeve, tj. potrebno je analizirati teške upite.
Na temelju vlastitog iskustva, preporučujem sljedeći algoritam postupaka za OLTP sustave za podešavanje svojstava paralelizma:
- prvo onemogućiti paralelizam postavljanjem Max Degree of Parallelism na 1 na razini cijele instance
- analizirati najteže upite i odabrati optimalan broj tokova za njih
- postaviti Max Degree of Parallelism na odabranu optimalnu količinu tokova iz točke 2, kao i za konkretne baze podataka postaviti Max DOP vrijednost dobivenu iz točke 2 za svaku bazu podataka
- analizirati najteže upite i utvrditi negativan učinak višestrukog ašenje. Ako postoji, povećati Cost Threshold for Parallelism.
Za sustave poput 1C, Microsoft CRM i Microsoft NAV, u većini slučajeva odgovara onemogućavanje višestrukog ašenja.
Također, ako je postavljena Standardna verzija, u većini slučajeva bit će dovoljan zabraniti višedretvenost zbog toga što je ova verzija ograničena po broju CPU jezgri.
Opisani algoritam nije prikladan za OLAP sustave.
Na temelju vlastitog iskustva, preporučujem sljedeći redoslijed radnji za OLAP sustave za podešavanje svojstava paralelizma:
- analizirati najteže upite i odabrati optimalan broj tokova za njih
- postaviti Max Degree of Parallelism na optimalan broj niti, dobiven iz točke 1, a također za konkretne baze podataka postaviti Max DOP vrednost koju smo dobili iz točke 1 za svaku bazu podataka
- analizirati najteže upite i uočiti negativne efekte od ograničavanja paralelizma. Ako postoje, treba smanjiti vrijednost Cost Threshold for Parallelism ili ponoviti korake 1-2 ovog algoritma
Dakle, za OLTP sustave prelazimo od jedne niti ka višedretvenosti, a za OLAP sustave obrnuto – prelazimo od višedretvenosti ka jednoj niti. Na taj način možemo odabrati optimalne postavke paralelizma kako za specifičnu bazu podataka, tako i za cijeli MS SQL Server.
Također je važno razumjeti da se postavke svojstava paralelizma s vremenom trebaju mijenjati, na temelju rezultata praćenja performansi MS SQL Servera.
Preporuke za podešavanje tragova
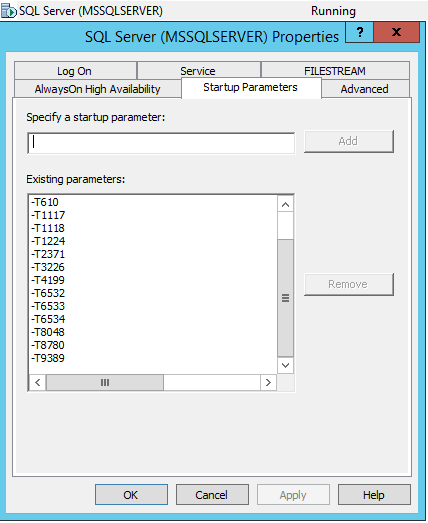
Na temelju vlastitog iskustva i iskustva mojih kolega, za optimalan rad preporučujem postavljanje sljedećih tragova na razini pokretanja usluge MS SQL Server za verzije 2008-2016:
- 610 — Smanjenje evidentiranja umetanja u indeksirane tablice. Može pomoći s umetanjima u tablice s velikim brojem zapisa i brojnim transakcijama, kada su česta duga čekanja WRITELOG zbog promjena u indeksima
- 1117 — Ako datoteka u datotečnom skupu zadovoljava uvjete praga automatskog povećanja, sve datoteke u tom datotečnom skupu se povećavaju
- 1118 — Prisiljava sve objekte da se nalaze u različitim ekstentima (zabranjujući miješane ekstente), što minimalizira potrebu za skeniranjem SGAM stranice, koja se koristi za praćenje miješanih ekstenta
- 1224 — Onemogućava povećanje zaključavanja na temelju broja zaključavanja. Međutim, previše aktivna upotreba memorije može uključiti povećanje zaključavanja
- 2371 — Mijenja prag fiksirane automatske ažurirane statistike na prag dinamičke automatske ažurirane statistike. Važno za ažuriranje planova upita vezanih uz velike tablice, gdje pogrešno određivanje broja zapisa dovodi do pogrešnih planova izvršenja.
- 3226 — Potiskuje poruke o uspješnom izvršavanju sigurnosnog kopiranja u dnevniku grešaka.
- 4199 — Uključuje promjene u optimizatoru upita, objavljene u kumulativnim paketima ažuriranja i paketima ažuriranja SQL Servera.
- 6532-6534 — Uključuje poboljšanje performansi operacija upita s prostornim tipovima podataka.
- 8048 — Pretvara objekte memorije, podijeljene prema NUMA, u one podijeljene prema CPU-u.
- 8780 — Uključuje dodatno vrijeme za sastavljanje plana upita. Neki upiti bez ove oznake mogu biti odbijeni, jer nemaju plan upita (vrlo rijetka greška).
- 8780 — 9389 — Uključuje dodatni dinamički privremeni dodijeljeni memorijski bafer za operatore paketnog režima, što omogućuje operatoru paketnog režima da zatraži dodatnu memoriju i izbjegne prijenos podataka u tempdb, ako je dodatna memorija dostupna.
Također, do verzije 2016 korisno je uključiti oznaku praćenja 2301, koja uključuje optimizaciju proširene podrške za donošenje odluka i tako pomaže u izboru ispravnijih planova upita. Međutim, od verzije 2016 često ima negativan utjecaj na ukupno trajanje izvršenja upita.
Također, za sustave s vrlo mnogo indeksa (npr. za baze podataka 1C), preporučujem uključivanje oznake praćenja 2330, koja isključuje prikupljanje podataka o korištenju indeksa, što u cjelini pozitivno utječe na sustav.
Više informacija o oznakama praćenja možete saznati.
U vezi s gornjom vezom važno je također uzeti u obzir verzije i gradnje MS SQL Servera, jer su za novije verzije neke oznake praćenja uključene prema zadanim postavkama ili ne daju nikakvog učinka.
Uključivanje i isključivanje oznake praćenja može se izvršiti pomoću naredbi DBCC TRACEON i DBCC TRACEOFF.
Stanje oznaka praćenja može se dobiti pomoću naredbe DBCC TRACESTATUS:
Da bi se zastavice za praćenje uključile u automatsko pokretanje usluge MS SQL Server, potrebno je otvoriti SQL Server Configuration Manager i dodati te zastavice putem -T u svojstvima usluge.
Zaključci
Ovaj članak razmatra neke aspekte praćenja MS SQL Servera koji omogućuju brzo otkrivanje nedostatka RAM-a i slobodnog CPU vremena, kao i niz drugih manje očitih problema. Razmotreni su najčešće korišteni zastavice za praćenje.
Izvori:
»
»
»
»
»
»
»
Izvor: habr.com
