

Odmah ću objasniti naziv članka. Prvotno se planiralo dati dobar, pouzdan savjet o ubrzavanju korištenja refleksije na jednostavnom, ali realističnom primjeru, međutim tokom benchmarkinga se pokazalo da refleksija ne radi tako sporo kao što sam mislio, a LINQ radi sporije nego što sam sanjao u košmarima. Na kraju se ispostavilo da sam napravio još jednu grešku u mjerenjima… Detalji ove životne priče ispod i u komentarima. Budući da je primjer prilično svakodnevni i izveden u principu kako se obično radi u poduzećima, dobila se prilično zanimljiva, čini mi se, demonstracija života: utjecaj na brzinu rada glavnog predmeta članka nije bio primjetan zbog vanjske logike: Moq, Autofac, EF Core i druge
Započeo sam rad pod dojmom ovog članka:
Kao što se vidi, autor predlaže korištenje kompajliranih delegata umjesto izravnog pozivanja metoda tipova refleksije kao odličan način za značajno ubrzanje rada aplikacije. Naravno, tu je i IL emisija, ali bih želio izbjeći to, jer je to najradnija metoda za izvršenje zadatka koja nosi rizik od grešaka.
Uzimajući u obzir da sam uvijek imao slično mišljenje o brzini refleksije, nisam namjeravao posebno dovoditi u pitanje autorove zaključke.
Često se susrećem s naivnom upotrebom refleksije u poduzećima. Uzme se tip. Uzme se informacija o svojstvu. Poziva se metoda SetValue, i svi su zadovoljni. Vrijednost je stigla u ciljno polje, svi su sretni. Ljudi su prilično pametni — seniori i tim lideri — pišu svoje ekstenzije na object, oslanjajući se na tako naivnu implementaciju „univerzalnih“ mappera jednog tipa u drugi. Suština obično izgleda ovako: uzmemo sva polja, uzmemo sva svojstva, iteriramo kroz njih: pri podudaranju imena članova tipa izvedemo SetValue. Povremeno uhvatimo iznimke kada ne pronađemo neko svojstvo kod jednog od tipova, ali i tu postoji izlaz koji poboljšava performanse. Try/catch.
Vidjela sam kako ljudi reinventiraju parsere i mappere, bez da su potpuno naoružani informacijama o tome kako rade bicikli koje su izmislili prije njih. Vidjela sam kako ljudi skrivaju svoje naivne implementacije iza strategija, iza sučelja, iza injekcija, kao da će to opravdati kasniju kaotičnu situaciju. Od takvih implementacija sam se okrenula. Naime, stvarnu propuštenu izvedbu nisam mjerila, i kad god je to bilo moguće, jednostavno sam mijenjala implementaciju na 'optimalniju', kad su se pojavile mogućnosti. Stoga su me prva mjerenja o kojima je riječ u nastavku ozbiljno zbunila.
Mislim da su se mnogi od vas, čitajući Rihtera ili druge ideologe, susreli s pravednom tvrdnjom da refleksija u kodu - fenomen je koji vrlo negativno utječe na performanse aplikacije.
Poziv refleksije prisiljava CLR da pretražuje skupove tražeći potrebni, vuče njihove metapodatke, analizira ih itd. Osim toga, refleksija tijekom pretraživanja sekvenci dovodi do dodjele velikih količina RAM-a. Trošimo memoriju, CLR izvlači GC i nastaju zastoji. Ovo bi trebalo biti iznimno sporo, vjerujte na riječ. Ogromne količine memorije suvremenih produkcijskih poslužitelja ili oblaka ne spašavaju od visokih latencija obrade. U stvarnosti, što više memorije imate, veća je vjerojatnost da ćete PRIMJETITI kako radi GC. Refleksija - to je u teoriji suvišna crvena krpa za njega.
Ipak, svi koristimo i IoC kontejnere i data mapper-e, čiji principi rada također temelje se na refleksiji, no pitanja o njihovoj izvedbi obično se ne javljaju. Ne, ne zato što je injekcijsko umanjenje i apstrahiranje od modela vanjskog ograničenog konteksta toliko potrebna stvar da moramo žrtvovati performanse u svakom slučaju. Sve je jednostavnije - to doista ne utječe značajno na izvedbu.
Stvar je u tome što najrasprostranjeniji okviri koji se temelje na tehnologiji refleksije koriste razne trikove za optimalniji rad s njom. Obično je to cache. Obično - to su Expressions i delegati kompilirani iz stabla izraza. Isti automapper drži ispod sebe konkurentni rječnik koji usklađuje tipove s funkcijama koje mogu jedni druge konvertirati već bez pozivanja refleksije.
Kako se to postiže? U suštini, to se ne razlikuje od logike koju sama platforma koristi za generiranje JIT koda. Pri prvom pozivu metode, ona se kompilira (i, da, ovaj proces nije brz), a prilikom sljedećih poziva upravljanje se prebacuje na već kompiliranu metodu, i ovdje neće biti značajnog pada performansi.
U našem slučaju također možemo iskoristiti JIT kompilaciju, a zatim koristiti kompilirano ponašanje s istim performansama kao i njegovi AOT analogi. Izrazi će nam ovdje pomoći.
Način na koji se to može sažeti u načelu je sljedeći:
Trebalo bi keširati konačni rezultat rada refleksije u obliku delegata koji sadrži kompiliranu funkciju. Također ima smisla keširati sve potrebne objekte sa informacijama o tipovima u zadržanim van objektnim poljima vašeg tipa – radnika.
Ima logike u tome. Zdrav razum nam govori da ako nešto može biti kompajlirano i keširano, treba to učiniti.
Potreban je napomenuti da keširanje u radu s refleksijom ima svoje prednosti, čak i ako se ne koriste predložene metode kompilacije izraza. U stvari, ovdje ću ponoviti teze autora članka na koji se pozivam iznad.
Sada o kodu. Pogledajmo primjer koji se temelji na mojim nedavnim bolovima koje sam morao podnijeti u ozbiljnom produkcijskom okruženju ozbiljne kreditne institucije. Sve entitete su izmišljeni, kako nitko ne bi pogodio.
Postoji neka entitet. Nazovimo je Kontakt. Postoje pisma sa standardiziranim tekstom, iz kojih parser i hidratator stvaraju te iste kontakte. Pismo je stiglo, pročitali smo ga, razbili na parove ključ-vrijednost, stvorili kontakt, sačuvali u bazi podataka.
To je elementarno. Recimo da Kontakt ima svojstva Ime, Godine i kontakt telefon. Ovi podaci se šalju u pismu. Također, poslovanje želi da podrška može brzo dodavati nove ključeve za mapiranje svojstava entiteta na parove u tijelu pisma. U slučaju da je netko pogriješio u predlošku ili ako će biti potrebno hitno pokrenuti mapiranje od novog partnera do izdavanja, prilagođavajući se novom formatu. Tada ćemo novu korelaciju mapiranja moći dodati kao jeftini datum-fiks. Dakle, primjer iz života.
Izrađujemo, kreiramo testove. Radi.
Neću izvoditi kod: izvorni kod je postao obiman, a dostupan je na GitHubu putem veze na kraju članka. Možete ga preuzeti, izmijeniti do neprepoznatljivosti i izmjeriti kako bi to utjecalo u vašem slučaju. Izložit ću samo kod dvaju obrazaca koji razlikuju brzi hidratant od sporog hidratanta.
Logika je sljedeća: obrazac metode prima parove formirane osnovnom logikom parsera. Razina LINQ predstavlja parser i osnovnu logiku hidratanta, koja vrši zahtjev prema kontekstu baze podataka i povezuje ključeve s parovima iz parsera (za ove funkcije postoji kod bez LINQ-a za usporedbu). Zatim se parovi predaju glavnoj metodi hidratacije i vrijednosti par postavljaju u odgovarajuće osobine entiteta.
„Brzi“ (Prefiks Fast u benchmarkima):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Kao što vidimo, koristi se statička kolekcija sa setterima svojstava – kompajliranim lambda izrazima koji pozivaju setter entiteta. Kreirani su sljedećim kodom:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
Uglavnom je jasno. Prolazimo kroz svojstva, stvaramo delegate koji pozivaju settere i čuvamo ih. Zatim ih pozivamo kada je potrebno.
„Spori“ (Prefiks Slow u benchmarkima):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Ovdje odmah prolazimo kroz svojstva i direktno pozivamo SetValue.
Za ilustraciju i kao referencu, implementirao sam naivnu metodu koja izravno upisuje vrijednosti njihovih parova korelacije u polja entiteta. Prefiks – Manual.
Sada uzimamo BenchmarkDotNet i istražujemo performanse. I iznenada… (spoiler — ovo nije ispravan rezultat, detalji — u nastavku)
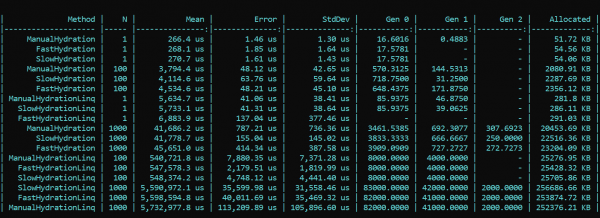
Što ovdje vidimo? Metode, koje ponosno nose prefiks Fast, gotovo u svim prolazima ispadaju sporije od metoda s prefiksom Slow. To vrijedi i za alokaciju i za brzinu rada. S druge strane, lijepa i elegantna implementacija mapiranja uz korištenje svugdje gdje je moguće predviđenih LINQ metoda, naprotiv, drastično umanjuje performanse. Razlika je ogromna. Tendencija se ne mijenja s različitim brojem prolaza. Razlika je samo u razmjerima. S LINQ je 4 — 200 puta sporije, a i količina otpada veća otprilike u sličnim razmjerima.
AŽURIRANO
Nisam mogao vjerovati svojim očima, ali što je važnije, ni mojim očima, ni mom kodu nije povjerovao naš kolega — . Ponovno provjeravajući moje rješenje, briljantno je otkrio i ukazao na pogrešku koju sam zbog niza promjena u implementaciji od početne do završne verzije propustio. Nakon ispravke pronađenog bug-a u postavkama Moq, svi rezultati su se postavili na svoje mjesto. Prema rezultatima ponovnog testiranja, osnovna tendencija se ne mijenja — LINQ i dalje snažno utječe na performanse više nego refleksija. Međutim, ugodno je da rad s kompilacijom Expression-a nije uzaludan, a rezultat se vidi i u alokaciji i u vremenu izvođenja. Prvo pokretanje, kada se inicijaliziraju statička polja, logično je sporije za „brzu” metodu, ali kasnije se situacija mijenja.
Evo rezultata ponovnog testiranja:
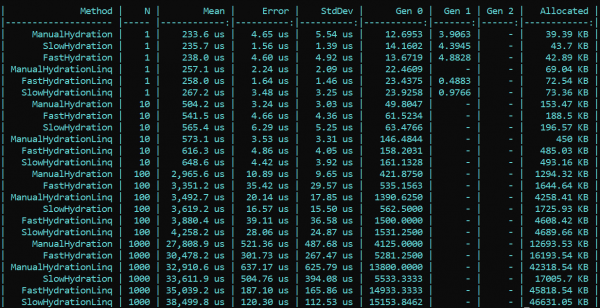
Zaključak: pri korištenju refleksije u poduzeću nije potrebna posebno rafinirana rješenja — LINQ će znatno smanjiti performanse. Ipak, u metodama s visokim opterećenjem koje zahtijevaju optimizaciju, možete zadržati refleksiju u obliku inicijalizatora i kompajlera delegata, koji će kasnije osigurati „brzu” logiku. Tako možete zadržati i fleksibilnost refleksije i brzinu rada aplikacije.
Kod s benchmarkom dostupan je ovdje. Svi zainteresirani mogu provjeriti moje riječi:
PS: kod u testovima koristi IoC, a u benchmarkovima – eksplicitnu konstrukciju. Naime, u konačnoj implementaciji uklonio sam sve čimbenike koji bi mogli utjecati na performanse i iskriviti rezultate.
PPS: Hvala korisniku na otkrivanju moje greške u postavkama Moq, koja je utjecala na prve mjerenja. Ako netko od čitatelja ima dovoljno karme, molim vas da mu date lajk. Čovjek se zaustavio, čovjek je pročitao, čovjek je provjerio i ukazao na grešku. Smatram da to zaslužuje poštovanje i simpatiju.
PPPS: hvala onom pomnom čitatelju koji se zamjerio stilu i formatu. Zalažem se za dosljednost i udobnost. Diplomatija izlaganja ostavlja mnogo željenog, ali sam uzeo kritiku u obzir. Molim vas da se pripremite.
Izvor: habr.com
