

Do nedavnog vremena, u Odnoklassnicima se oko 50 TB podataka, obrađenih u stvarnom vremenu, čuvalo u SQL Serveru. Za tako veliku količinu osigurati brzi, pouzdani i otporni na greške DC pristup koristeći SQL DB, praktički je nemoguće. Obično se u takvim slučajevima koristi jedno od NoSQL skladišta, ali nije sve moguće prenijeti u NoSQL: neka entiteta zahtijevaju ACID transakcijske garancije.
To nas je dovelo do korištenja NewSQL skladišta, tj. DB koja pruža otpornost na greške, skalabilnost i brzinu NoSQL sustava, dok istovremeno zadržava klasične ACID garancije. Brojevi industrijskih sustava ovog novog tipa su mali, stoga smo takav sustav implementirali sami i pokrenuli ga u produkciju.
Kako to funkcionira i što smo postigli — čitaj dalje.
Danas mjesečna publika „Odnoklassnika” iznosi više od 70 milijuna jedinstvenih posjetitelja. Mi najvećih društvenih mreža na svijetu, i među dvadeset web stranica na kojima korisnici provode najviše vremena. Infrastruktura „OK” obrađuje vrlo visoke opterećenja: više od milijun HTTP zahtjeva/s na frontovima. Dijelovi server farmi u broju od preko 8000 su smješteni blizu jedni drugima - u četiri moskovska data centra, što omogućava mrežnu latenciju manju od 1 ms između njih.
Koristimo Cassandru od 2010. godine, počevši od verzije 0.6. Danas u upotrebi imamo nekoliko desetina klastera. Najbrži klaster obrađuje više od 4 milijuna operacija u sekundi, a najveći pohranjuje 260 TB.
Međutim, sve to su obični NoSQL klasteri, koji se koriste za pohranu podataka. Mi smo željeli zamijeniti glavnu konzistentnu pohranu, Microsoft SQL Server, koji se koristio od samog početka „Odnoklassnika”. Pohrana se sastojala od više od 300 SQL Server Standard Edition mašina, na kojima je bilo 50 TB podataka — poslovnih entiteta. Ovi podaci se modificiraju u okviru ACID transakcija i zahtijevaju .
Za distribuciju podataka po nodama SQL Server koristili smo i vertikalno i horizontalno (sharding). Povijesno smo koristili jednostavnu shemu sharding podataka: svakoj entitetu je dodijeljen token — funkcija od ID entiteta. Entiteti s istim tokenom su smješteni na jedan SQL poslužitelj. Odnos tipa master-detail je realiziran tako da tokeni glavnog i potomaka zapisa uvijek odgovaraju i nalaze se na jednom poslužitelju. U društvenoj mreži gotovo svi unosi se generiraju u ime korisnika — to znači da su svi podaci korisnika unutar jedne funkcionalne podsustave pohranjeni na jednom poslužitelju. Drugim riječima, u poslovnim transakcijama gotovo uvijek su sudjelovale tablice jednog SQL poslužitelja, što je omogućilo osiguravanje dosljednosti podataka pomoću lokalnih ACID transakcija, bez potrebe za korištenjem distribuiranih ACID transakcija.
Zahvaljujući sharding-u i zbog ubrzanja rada SQL-a:
- Ne koristimo strane ključne uvjete, budući da se pri sharding-u ID entiteta može nalaziti na drugom poslužitelju.
- Ne koristimo pohranjene procedure i okidače zbog dodatnog opterećenja na CPU-u DBMS-a.
- Ne koristimo JOIN-ove zbog svega navedenog i niza slučajnih čitanja s diska.
- Izvan transakcije, kako bismo smanjili međusobna zaključavanja, koristimo razinu izolacije Read Uncommitted.
- Izvršavamo samo kratke transakcije (u prosjeku kraće od 100 ms).
- Ne koristimo višeredne UPDATE i DELETE zbog velikog broja međusobnih zaključavanja — ažuriramo samo po jedan zapis.
- Upiti uvijek izvršavamo samo po indeksima — upit s planom potpunog pregleda tablice za nas znači preopterećenje baze podataka i njen kvar.
Ovi koraci su omogućili da iz SQL poslužitelja izdvojimo gotovo maksimum performansi. Međutim, problemi su postajali sve veći. Pogledajmo ih.
Problemi sa SQL-om
- Budući da smo koristili vlastiti sharding, dodavanje novih shardova obavljali su administratori ručno. Sve to vrijeme, skalabilne replike podataka nisu obrađivale upite.
- Kako se broj zapisa u tablici povećava, brzina umetanja i izmjene opada, a prilikom dodavanja indeksa postojećoj tablici brzina se drastično smanjuje, stvaranje i ponovno stvaranje indeksa odvija se uz vrijeme nedostupnosti.
- Postojanje malog broja Windows poslužitelja za SQL Server u produkciji otežava upravljanje infrastrukturom.
Ali glavni problem —
Otpornost na greške
Klasični SQL server ima lošu otpornost na kvarove. Pretpostavimo da imate samo jedan server baze podataka i on otkazuje svake tri godine. U to vreme sajt ne radi 20 minuta, što je prihvatljivo. Ako imate 64 servera, sajt ne radi jednom svake tri nedelje. A ako imate 200 servera, sajt ne radi svake nedelje. To je problem.
Šta se može učiniti za povećanje otpornosti SQL servera? Wikipedia nam predlaže da izgradimo : gde u slučaju kvara bilo kog od komponenti postoji duplikat.
To zahteva park skupog hardvera: brojna duplikacija, optička vlakna, skladišta zajedničkog pristupa, a uključivanje rezervi funkcioniše nepouzdano: oko 10% uključivanja završava otkazom rezervne čvora zajedno s osnovnim čvorom.
Ali glavni nedostatak takvog visoko dostupnog klastera je nulta dostupnost u slučaju kvara data centra u kojem se nalazi. 'Odnoklassniki' ima četiri data centra, i moramo obezbediti rad u slučaju potpunog kvara jednog od njih.
Za to bismo mogli primeniti replikaciju, ugrađenu u SQL Server. Ovo rešenje je značajno skuplje zbog troškova softvera i pati od dobro poznatih problema sa replikacijom — nepredvidivih kašnjenja transakcija pri sinhronoj replikaciji i kašnjenja u primeni replikacija (i, kao posledica, izgubljenih modifikacija) pri asinkronoj. Pretpostavljeni činimo ovu opciju potpuno neprihvatljivom za nas.
Svi ovi problemi zahtevali su radikalno rešenje i započeli smo detaljnu analizu. Ovde se moramo upoznati s onim što SQL Server uglavnom radi — transakcijama.
Jednostavna transakcija
Razmotrimo najjednostavniju, s gledišta aplikativnog SQL programera, transakciju: dodavanje fotografije u album. Albumi i fotografije se čuvaju u različitim tabelama. Album ima brojač javnih fotografija. Tako se transakcija deli na sledeće korake:
- Zaključavamo album prema ključevi.
- Kreiramo zapis u tabeli fotografija.
- Ako fotografija ima javni status, povećavamo u albumu brojač javnih fotografija, ažuriramo zapis i potvrđujemo transakciju.
Ili u obliku pseudokoda:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vidimo da je najčešći scenarij poslovne transakcije - čitanje podataka iz baze podataka u memoriju aplikacijskog poslužitelja, izmjena nečega i spremanje novih vrijednosti nazad u bazu podataka. Obično u takvoj transakciji ažuriramo nekoliko entiteta, nekoliko tablica.
Pritom može doći do konkurentnog modificiranja istih podataka iz drugog sustava. Na primjer, Antispam može smatrati da je korisnik sumnjiv i stoga sve fotografije korisnika više ne bi trebale biti javne, trebaju se poslati na moderaciju, a to znači promjenu photo.status na neku drugu vrijednost i preokret odgovarajućih brojača. Očigledno je da ako se ova operacija odvija bez jamstva atomarne primjene i izolacije konkurentnih modifikacija, kao u , rezultat neće biti ono što je potrebno - ili će broj fotografija prikazivati netočnu vrijednost, ili neće sve fotografije biti poslane na moderaciju.
Sličnog koda, koji manipulira različitim poslovnim entitetima unutar jedne transakcije, napisano je jako mnogo otkad postoje Odnoklassniki. Prema iskustvu migracija na NoSQL s znamo da najveće poteškoće (i vremenski troškovi) izaziva potreba za razvojem koda usmjerenog na održavanje dosljednosti podataka. Stoga je glavni zahtjev za novo skladište bio osiguranje pravičnih ACID transakcija za poslovnu logiku.
Drugi, ne manje važni zahtjevi su bili:
- U slučaju pada podatkovnog centra, trebali bi biti dostupni i čitanje i zapis u novo skladište.
- Održavanje trenutne brzine razvoja. To jest, pri radu s novim skladištem, količina koda trebala bi biti približno ista, ne bi se trebale pojaviti potrebe za dodatnim pisanjem u skladište, razvojem algoritama za rješavanje sukoba, održavanje sekundarnih indeksa i slično.
- Brzina rada novog skladišta trebala bi biti dovoljno visoka, i pri čitanju podataka i pri obradi transakcija, što učinkovito znači da akademski stroga, univerzalna, ali spora rješenja, poput .
- Automatsko skaliranje u stvarnom vremenu.
- Korištenje običnih jeftinih servera, bez potrebe za kupovinom egzotičnih komponenti.
- Mogućnost razvoja skladišta od strane programerskog tima. Drugim riječima, prioritet su imali vlastiti ili rješenja zasnovana na otvorenom kodu, poželjno na Javi.
Rješenja, rješenja
Analizirajući moguća rješenja, došli smo do dva moguća izbora arhitekture:
Prvi — uzeti bilo koji SQL server i implementirati potrebnu otpornost na greške, mehanizam skaliranja, klaster otpornosti na greške, rješavanje konflikata i distribuirane, pouzdane i brze ACID-transakcije. Ovu opciju smo ocijenili kao prilično složenu i radno intenzivnu.
Druga opcija — uzeti spremno NoSQL skladište s implementiranim skaliranjem, klasterom otpornim na greške, rješavanjem konflikata i sami implementirati transakcije i SQL. Na prvi pogled, čak i zadatak implementacije SQL-a, da ne govorimo o ACID transakcijama, izgleda kao problem za godine. No kasnije smo shvatili da skup mogućnosti SQL-a koji koristimo u praksi, daleko odstupa od ANSI SQL-a koliko i daleko od ANSI SQL-a. Kada smo se dodatno osvrnuli na CQL, shvatili smo da je dovoljno blizu onome što nam treba.
Cassandra i CQL
Dakle, što je to Cassandra zanimljiva, koje mogućnosti ima?
Prvo, ovdje možete stvarati tablice s podrškom za različite tipove podataka, možete izvršavati SELECT ili UPDATE po primarnom ključu.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Za osiguranje konzistentnosti podataka replikacija, Cassandra koristi . U najjednostavnijem slučaju, to znači da se prilikom postavljanja tri replike istog reda na različitim čvorovima klastera zapis smatra uspješnim ako većina čvorova (tj. dva od tri) potvrdi uspješnost te operacije pisanja. Podaci reda smatraju se dosljednima ako su prilikom čitanja većina čvorova bila upitana i potvrdila ih. Tako se, u prisutnosti tri replike, jamči puna i trenutna dosljednost podataka u slučaju kvara jednog čvora. Ovaj pristup omogućio nam je da implementiramo još pouzdaniju shemu: uvijek slati zahtjeve na sve tri replike, čekajući odgovor od dva najbrža. Odgovor treće replike koja kasni u tom slučaju se odbacuje. Čvor koji kasni s odgovorom može imati ozbiljnih problema — usporavanje, prikupljanje smeća u JVM-u, oslobađanje direktne memorije u Linux kernelu, kvar hardvera, prekid veze. Međutim, ovo nikako ne utječe na operacije klijenta i podatke.
Pristup kada se obraćamo trima čvorovima, a dobivamo odgovor od dvaju, naziva se : zahtjev prema suvišnim replikama šalje se još prije nego što 'otpadne'.
Još jedna od prednosti Cassandre je Batchlog — mehanizam koji jamči ili potpuno primjenjivanje ili potpuno neprimjenjivanje paketa promjena koje ste unijeli. To nam omogućuje da rješavamo A u ACID-u — atomarnost iz kutije.
Najbliže transakcijama u Cassandri su tzv. '' Ali su daleko od 'pravih' ACID transakcija: zapravo, to je mogućnost da se izvrši na podacima samo jednog zapisa, koristeći konsenzus prema teškom protokolu Paxos. Stoga je brzina takvih transakcija niska.
Što nam nedostaje u Cassandri
Dakle, trebali smo implementirati prave ACID transakcije u Cassandri. Uz njihovu pomoć mogli bismo lako realizirati dvije druge korisne mogućnosti klasičnih DBMS-a: dosljedne brze indekse, što bi nam omogućilo izvođenje upita podataka ne samo prema primarnom ključu i obični generator monotone autoinkrementalnih ID.
C*One
Tako je nastala nova DBMS C*One, koja se sastoji od tri vrste poslužiteljskih čvorova:
- Skladišta — (gotovo) standardni poslužitelji Cassandre, odgovorni za pohranu podataka na lokalnim diskovima. Kako raste opterećenje i volumen podataka, njihovu količinu можна lako povećati na desetke i stotine.
- Koordinatori transakcija - osiguravaju izvršenje transakcija.
- Klijenti - serveri aplikacija koji provode poslovne operacije i pokreću transakcije. Takvih klijenata može biti na hiljade.
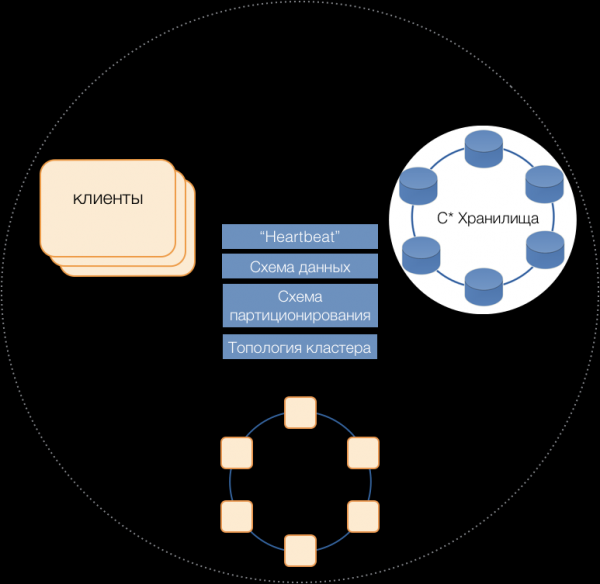
Serveri svih tipova su deo zajedničkog klastera, koriste unutrašnji protokol poruka Cassandra za komunikaciju jedni s drugima i za razmenu klasterskih informacija. Pomoću Heartbeat serveri saznaju o međusobnim kvarovima, održavaju jedinstvenu šemu podataka - tabele, njihovu strukturu i replikaciju; šemu particioniranja, topologiju klastera itd.
Klijenti
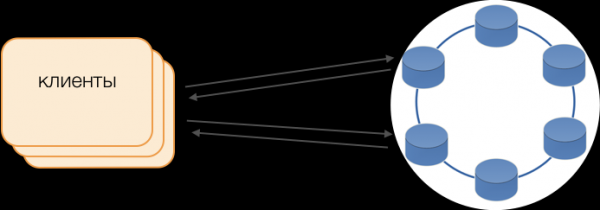
Umesto standardnih drajvera koristi se režim Fat Client. Ova nod ne skladišti podatke, ali može delovati kao koordinator izvršenja zahteva, tj. Klijent sam izvršava funkciju koordinatora svojih zahteva: ispituje replike skladišta i rešava konflikte. Ovo je ne samo pouzdanije i brže od standardnog drajvera, koji zahteva komunikaciju s udaljenim koordinatorom, već i omogućava upravljanje prenosa zahteva. U okviru otvorene transakcije na klijentu, zahtevi se šalju u skladišta. Ako je klijent otvorio transakciju, tada se svi zahtevi u okviru transakcije usmeravaju ka koordinatoru transakcija.
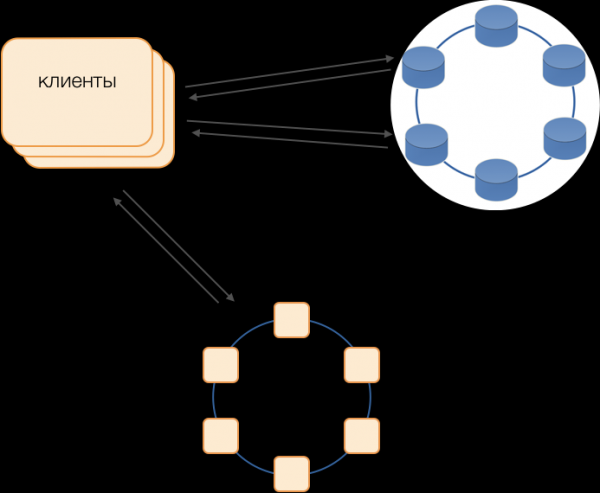
Koordinator transakcija C*One
Koordinator - ono što smo implementirali za C*One od nule. On je odgovoran za upravljanje transakcijama, zaključavanjima i redosledom primene transakcija.
Za svaku obrađivanu transakciju koordinator generiše vremensku oznaku: svaka sledeća je veća od prethodne transakcije. Pošto je u Cassandri sistem rešavanja konflikata zasnovan na vremenskim oznakama (od dve konfliktne evidencije, aktuelna je ona sa kasnijom vremenskom oznakom), konflikt će biti uvek rešen u korist sledeće transakcije. Na taj način smo implementirali — jeftin način rešavanja konflikata u distribuiranom sistemu.
Zaključavanja
Da bismo osigurali izolaciju, odlučili smo se koristiti najjednostavniji način - pesimistička zaključavanja po primarnom ključu evidencije. Drugim rečima, u transakciji, evidencija mora prvo biti zaključana, zatim pročitana, modifikovana i sačuvana. Tek nakon uspešnog komitovanja, evidencija se može otključati kako bi konkurentske transakcije mogle da je koriste.
Implementacija takve blokade jednostavna je u nerazdijeljenoj sredini. U distribuiranom sustavu postoje dva glavna puta: ili implementirati distribuiranu blokadu na klasteru, ili raspodijeliti transakcije tako da transakcije koje uključuju jedan zapis uvijek obrađuje isti koordinator.
Budući da su u našem slučaju podaci već raspoređeni po grupama lokalnih transakcija u SQL-u, odlučeno je da se koordinatorima dodijele grupe lokalnih transakcija: jedan koordinator obrađuje sve transakcije s tokenom od 0 do 9, drugi - s tokenom od 10 do 19, i tako dalje. Kao rezultat toga, svaka od instanci koordinatora postaje master grupe transakcija.
Tada se blokade mogu implementirati kao obični HashMap u memoriji koordinatora.
Kvarovi koordinatora
Budući da jedan koordinator isključivo obrađuje grupu transakcija, vrlo je važno brzo utvrditi njegov kvar kako bi ponovni pokušaj izvršenja transakcije stao u vremensko ograničenje. Kako bi to bilo brzo i pouzdano, primijenili smo protokol potpune povezane kvorumske heartbeat-a:
U svakom data centru nalaze se najmanje dvije čvora koordinatora. Povremeno svaki koordinator šalje heartbeat poruku ostalim koordinatorima i obavještava ih o svom radu, kao i o tome od kojih koordinatora u klasteru je posljednji put primio heartbeat poruke.
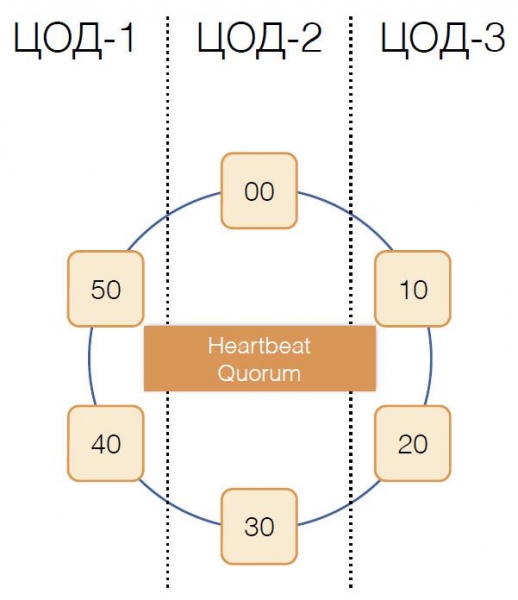
Primajući slične informacije od ostalih u njihovim heartbeat porukama, svaki koordinator odlučuje koji su čvorovi klastera funkcionalni, a koji nisu, prema principu kvoruma: ako je čvor X od većine čvorova u klasteru primio informacije o normalnom primanju poruka s čvora Y, to znači da Y radi. I obrnuto, čim većina prijavi gubitak poruka s čvora Y, to znači da je Y otkazao. Zanimljivo je da ako kvorum obavijesti čvor X da više ne prima poruke s njega, onda će se sam čvor X smatrati otkazanim.
Heartbeat poruke se šalju s velikom učestalošću, oko 20 puta u sekundi, s periodom od 50 ms. U Javi je teško jamčiti odgovor aplikacije unutar 50 ms zbog sličnih trajanja pauza uzrokovanih sakupljačem otpada. Uspjeli smo postići takvo vrijeme odgovora koristeći sakupljač otpada G1, koji omogućava definiranje cilja za trajanje GC pauza. Međutim, ponekad, vrlo rijetko, pauze sakupljača premašuju 50 ms, što može dovesti do lažnog otkrivanja kvara. Kako bismo to izbjegli, koordinator ne prijavljuje kvar udaljenog čvora nakon gubitka prvog heartbeat poruka, već samo ako ih izgubi više zaredom. Tako smo uspjeli postići otkrivanje kvara čvora koordinatora za 200 ms.
Ali nije dovoljno brzo shvatiti koji čvor je prestao funkcionirati. Potrebno je nešto poduzeti.
Sigurnosna kopija
Klasična shema pretpostavlja pokretanje izbora novog vođe u slučaju kvara, preko jednog od algoritama. Međutim, takvi algoritmi imaju dobro poznate probleme s konvergencijom u vremenu i trajanjem samog procesa izbora. Takve dodatne latencije uspjeli smo izbjeći kroz shemu zamjene koordinatora u potpuno povezanoj mreži:
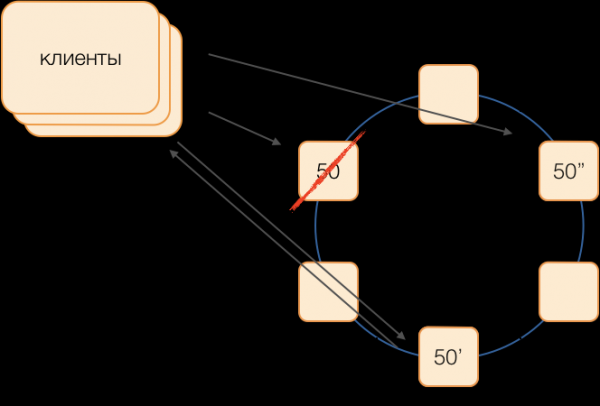
Pretpostavimo da želimo izvršiti transakciju u grupi 50. Unaprijed definiramo shemu zamjene, tj. koji će čvorovi izvršavati transakcije grupe 50 u slučaju kvara glavnog koordinatora. Naš cilj je zadržati operabilnost sustava u slučaju kvara datacentra. Definiramo da će prvi rezervni čvor biti iz drugog datacentra, a drugi rezervni iz trećeg. Ova shema se bira jednom i ne mijenja se sve dok se topologija klastera ne promijeni, tj. sve dok se ne pridruže novi čvorovi (što se vrlo rijetko događa). Redoslijed odabira novog aktivnog vođe u slučaju kvara starog bit će uvijek takav: aktivni vođa postat će prvi rezervni čvor, a ako je i on prestao funkcionirati – drugi rezervni.
Ova shema je pouzdanija od univerzalnog algoritma, jer za aktivaciju novog vođe dovoljno je utvrditi činjenicu kvara starog.
No kako klijenti mogu saznati koji od majstora trenutno radi? U 50 ms nije moguće poslati informacije tisućama klijenata. Moguće je da klijent pošalje zahtjev za otvaranje transakcije, još ne znajući da taj majstor više ne funkcioniše, i da će zahtjev zablokirati na vremenskom isteku. Da bi se to izbjeglo, klijenti spekulativno šalju zahtjev za otvaranje transakcije direktno majstoru grupe i oba njegova rezervna majstora, ali će odgovoriti samo onaj koji je aktivni majstor u tom trenutku. Svu daljnju komunikaciju u okviru transakcije klijent će izvoditi samo s aktivnim majstorom.
Rezervni majstori zaprimljene zahtjeve za ne svoje transakcije stavljaju u rednerazorenih transakcija, gdje ostaju neko vrijeme. Ako aktivni majstor umre, novi majstor obrađuje zahtjeve za otvaranje transakcija iz svog reda i odgovara klijentu. Ako je klijent već uspeo otvoriti transakciju sa starim majstorom, drugi odgovor se ignorira (i, očigledno, takva transakcija se neće završiti i klijent će je ponoviti).
Kako funkcioniše transakcija
Pretpostavimo da je klijent poslao koordinatoru zahtjev za otvaranje transakcije za određenu entitet s određenim primarnim ključem. Koordinator blokira tu entitet i stavlja je u tabelu blokada u memoriji. Ako je potrebno, koordinator čita tu entitet iz skladišta i sprema dobivene podatke u stanje transakcije u memoriji koordinatora.
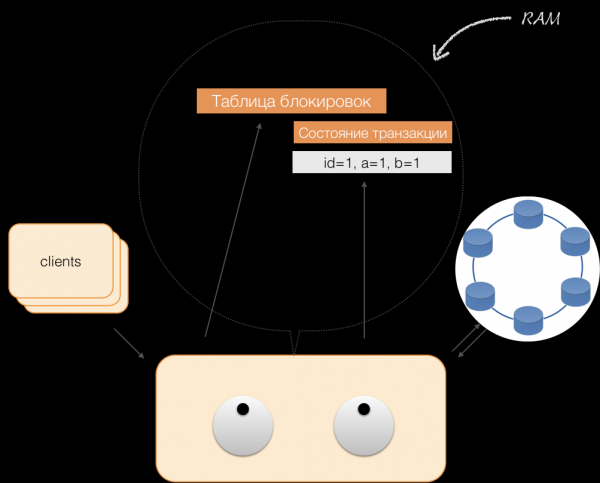
Kada klijent želi promijeniti podatke u transakciji, šalje koordinatoru zahtjev za modifikaciju entiteta, a on stavlja nove podatke u tabelu stanja transakcija u memoriji. Na tome zapis završava — zapis u skladište se ne vrši.
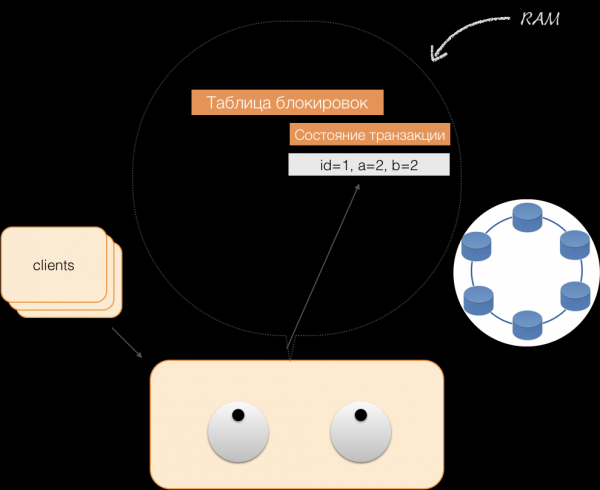
Kada klijent traži u okviru aktivne transakcije vlastite izmijenjene podatke, koordinator postupa ovako:
- ako ID već postoji u transakciji, podaci se uzimaju iz memorije;
- ako ID u memoriji ne postoji, nedostajući podaci se čitaju iz nod-skladišta, spajaju s već postojećima u memoriji, i rezultat se vraća klijentu.
Tako klijent može pročitati vlastite promjene, dok drugi klijenti te promjene ne vide, jer se čuvaju samo u memoriji koordinatora, a u nodovima Cassandre ih još nema.
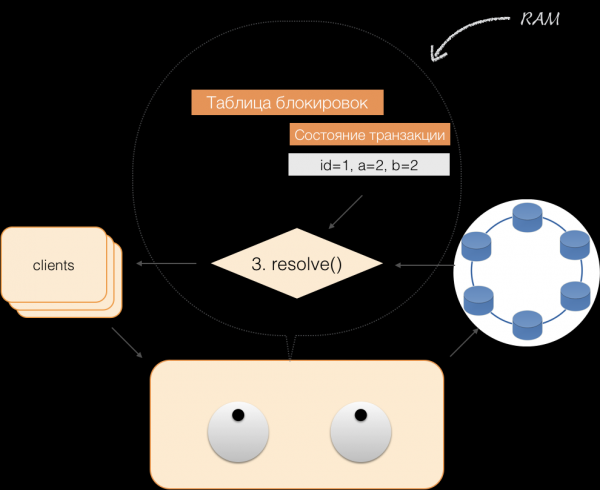
Kada klijent pošalje commit, stanje koje je bilo u memoriji usluge pohranjuje koordinator u logged batch, a već u obliku logged batch šalje se u spremišta Cassandra. Spremišta čine sve potrebno da bi se ovaj paket atomarno (potpuno) primijenio i vraćaju odgovor koordinatoru, koji oslobađa blokade i potvrđuje uspješnost transakcije klijentu.
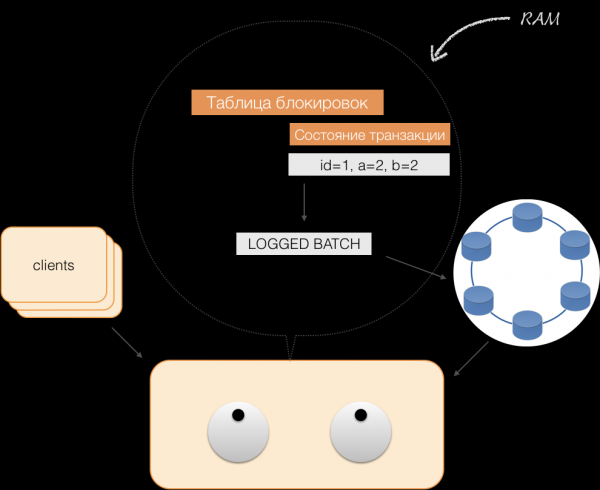
A za povratak, koordinatoru je dovoljno samo osloboditi memoriju zauzetu stanjem transakcije.
Kao rezultat goreopisane dorade, ostvarili smo principe ACID:
- Atomarnost. To je jamstvo da nijedna transakcija neće biti djelomično zabilježena u sustavu, bit će ili izvršene sve njezine podoperacije ili nijedna. Ovaj princip kod nas se poštuje zahvaljujući logged batch-u u Cassandri.
- Konsistentnost. Svaka uspješna transakcija po definiciji bilježi samo dopuštene rezultate. Ako nakon otvaranja transakcije i izvršavanja dijela operacija dođe do otkrića da je rezultat nedopušten, izvršit će se povratak.
- Izoliranost. Tijekom izvršavanja transakcije, paralelne transakcije ne bi trebale utjecati na njezin rezultat. Konkurentske transakcije su izolirane pomoću pesimističkih blokada na koordinatoru. Za čitanja izvan transakcije poštuje se načelo izoliranosti na razini Read Committed.
- Otpornost. Bez obzira na probleme na donjim razinama — isključenje sustava, kvar opreme — promjene izvršene uspješno završenom transakcijom moraju ostati pohranjene nakon obnavljanja rada.
Čitanje prema indeksima
Uzmimo jednostavnu tablicu:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Ona ima ID (primarni ključ), vlasnika i datum promjene. Potrebno je napraviti vrlo jednostavan upit — izabrati podatke prema vlasniku s datumom promjene "u posljednja 24 sata".
SELECT *
WHERE owner=?
AND modified>?
Kako bi takav upit brzo djelovao, u klasičnom SQL DBMS-u potrebno je izgraditi indeks po kolonama (owner, modified). Takvo nešto možemo napraviti dovoljno lako, jer sada imamo jamstva ACID!
Indeksi u C*One
Postoji izvorna tablica s fotografijama, u kojoj je ID zapisa primarni ključ.
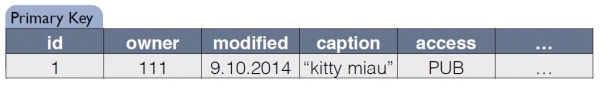
Za indeks C*One se stvara nova tabela koja je kopija izvorne. Ključ se poklapa s indeksnim izrazom, a uključuje i primarni ključ zapisa iz izvorne tabele:
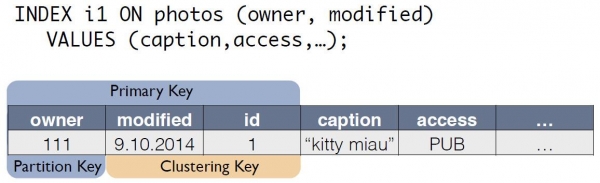
Sada se upit "vlasniku u posljednjih 24 sata" može prepisati kao select iz druge tabele:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Dosljednost podataka izvorne tabele photos i indeksne i1 automatski održava koordinator. Na temelju same sheme podataka, pri prijemu promjene, koordinator generira i pamti promjenu ne samo glavne tabele, već i promjene kopija. Nema dodatnih radnji s tabelom indeksa, logovi se ne čitaju, blokade se ne koriste. Drugim riječima, dodavanje indeksa gotovo da ne troši resurse i praktički ne utječe na brzinu izvršenja modifikacija.
Pomoću ACID-a uspjeli smo implementirati indekse "kao u SQL-u". Oni imaju dosljednost, mogu se skalirati, brzo rade, mogu biti složeni i integrirani u jezik upita CQL. Za podršku indeksima nije potrebno mijenjati aplikacijski kod. Sve je jednostavno, kao u SQL-u. I što je najvažnije, indeksi ne utječu na brzinu izvršenja modifikacija izvorne tabele transakcija.
Što smo postigli
Razvili smo C*One prije tri godine i lansirali u industrijsku primjenu.
Što smo na kraju dobili? Procijenimo to na primjeru podsustava obrade i pohrane fotografija, jednog od najvažnijih tipova podataka u društvenoj mreži. Riječ je o svim vrstama metainformacija, a ne samo o samim fotografijama. Trenutno u "Odnoklassnicima" ima oko 20 milijardi takvih zapisa, sustav obrađuje 80 tisuća upita za čitanje u sekundi, do 8 tisuća ACID transakcija u sekundi, vezano uz modifikaciju podataka.
Kada smo koristili SQL s replication factor = 1 (ali u RAID 10), metainformacija fotografija pohranjena je na visoko dostupnom klasteru od 32 mašine s Microsoft SQL Serverom (plus 11 rezervnih). Također je bilo dodijeljeno 10 servera za pohranu rezervnih kopija. Ukupno 50 skupih mašina. Istovremeno, sustav je radio pod nominalnim opterećenjem, bez rezerve.
Nakon migracije na novi sustav dobili smo faktor replikacije = 3 — po kopiji u svakom podatkovnom centru. Sustav se sastoji od 63 nodova Cassandra skladišta i 6 koordinacijskih mašina, ukupno 69 servera. Ove mašine su međutim znatno jeftinije, njihova ukupna cijena iznosi oko 30 % cijene sustava na SQL-u. Pri tome je opterećenje na razini od 30 %.
S implementacijom C*One smanjene su i latencije: u SQL-u operacija pisanja trajala je oko 4,5 ms. U C*One — oko 1,6 ms. Trajanje transakcije u prosjeku je manje od 40 ms, commit se izvršava za 2 ms, trajanje čitanja i pisanja — u prosjeku 2 ms. 99. percentil iznosi samo 3-3,1 ms, broj timeouta smanjen je 100 puta — sve zahvaljujući širokoj primjeni spekulacija.
Do sada je iz uporabe izbačen veći dio nodova SQL Servera, novi proizvodi se razvijaju samo korištenjem C*One. Prilagodili smo C*One za rad u našem oblaku. , što je omogućilo brže postavljanje novih klastera, pojednostavilo konfiguraciju i automatiziralo održavanje. Bez izvorne koda, to bi bilo znatno složenije i zahtjevnije.
Trenutno radimo na prijelazu drugih naših skladišta u oblak — ali to je već sasvim druga priča.
Izvor: habr.com
