

Kada se suočavate s proizvodom koji se razvija više od deset godina, nije iznenađujuće naići na zastarjele tehnologije. No, što ako za šest mjeseci trebate održavati opterećenje deset puta veće, a cijena pada raste stotinama puta? U tom slučaju trebat će vam vrhunski Highload inženjer. Ali, zbog nedostatka takvog stručnjaka, problem je povjeren meni. U prvom dijelu članka ću opisati kako smo migrirali s Redis-a na Redis-klaster, a u drugom dijelu ću dati savjete kako započeti korištenje klastera i na što obratiti pažnju tijekom eksploatacije.
Izbor tehnologije
Je li tako loš odvojeni Redis (standalone redis) u konfiguraciji 1 majstor i N robova? Zašto ga nazivam zastarjelom tehnologijom?
Ne, Redis nije tako loš… Međutim, postoji nekoliko nedostataka koje ne možemo ignorirati.
Prvo, Redis ne podržava mehanizme za oporavak od pada majstora. Za rješavanje ovog problema koristili smo konfiguraciju s automatskim prebacivanjem VIP-ova na novog majstora, promjenom uloge jednog od robova i prebacivanjem ostalih. Ovaj mehanizam je funkcionirao, ali ga nije bilo moguće nazvati pouzdanim rješenjem. Prvo, događali su se lažni alarmi, a drugo, bio je jednokratno rješenje, i nakon aktivacije zahtijevao je ručne radnje za ponovo pokretanje.
Drugo, postojanje samo jednog majstora dovodilo je do problema s šardiranjem. Morali smo kreirati nekoliko neovisnih klastera "1 majstor i N robova", a zatim ručno raspodijeliti baze po tim strojevima i nadati se da neće doći do situacije da jedna od baza naraste toliko da je treba premjestiti na zasebni instance.
Koje su opcije?
- Najskuplje i najbogatije rješenje je Redis-Enterprise. To je kutijsko rješenje s punom tehničkom podrškom. Iako izgleda idealno s tehničkog stajališta, nije nam odgovaralo iz ideoloških razloga.
- Redis-klaster. Iz kutije dolazi s podrškom za automatsko prebacivanje majstora i šardiranje. Sučelje se gotovo ne razlikuje od uobičajene verzije. Izgleda obećavajuće, o potencijalnim problemima ćemo razgovarati kasnije.
- Tarantool, Memcache, Aerospike i drugi. Svi ti alati rade otprilike isto. No, svaki ima svoje nedostatke. Odluka je bila ne staviti sva jaja u jednu košaru. Memcache i Tarantool koristimo za druge zadatke, i, unaprijed ću reći, na našoj praksi bilo je više problema s njima.
Specifičnost korištenja
Pogledajmo koje smo zadatke povijesno rješavali s Redisom i koju funkcionalnost smo koristili:
- Keširanje prije zahtjeva za udaljenim uslugama poput 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Keširanje prije MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Glavno spremište za uslugu rada s sesijama i koordinatama vozača | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Kao što vidite, nema tu nikakve visoke matematike. U čemu je onda složenost? Hajde da rastavimo svaki metod posebno.
Metoda
Opis
Karakteristike Redis-clustera
Rešenje
GET SET
Zapisati/pročitati ključ
MGET MSET
Zapisati/pročitati više ključeva
Ključevi će biti raspoređeni na različitim čvorovima. Gotove biblioteke znaju raditi Multi-operacije samo unutar jednog čvora
Zamijeniti MGET s pipeline-om od N GET operacija
SELECT DB
Odabrati bazu s kojom ćemo raditi
Ne podržava više baza podataka
Sve staviti u jednu bazu. Dodati prefikse ključeva
SCAN
Proći kroz sve ključeve u bazi
Budući da imamo jednu bazu, prolazak kroz sve ključeve u klasteru je previše skupo
Održavati invarijant unutar jednog ključa i raditi HSCAN po tom ključu. Ili potpuno odustati
GEO
Operacije rada s geo-ključem
Geo-ključ se ne dijeli
KEY BY PATTERN
Pretraživanje ključa po obrascu
Budući da imamo jednu bazu, tražit ćemo po svim ključevima u klasteru. Previše skupo
Odustati ili održavati invarijant, kao i u slučaju SCAN-a
Redis vs Redis-cluster
Što gubimo, a što dobivamo prelaskom na klaster?
- Nedostaci: gubimo funkcionalnost više baza.
- Ako želimo pohraniti logički nepovezane podatke u jednom klasteru, morat ćemo koristiti prefikse kao workaround.
- Gubimo sve operacije 'po bazi', kao što su SCAN, DBSIZE, CLEAR DB itd.
- Multi-operacije su postale znatno složenije za implementaciju, jer može biti potrebno obratiti se više čvorovima.
- Prednosti:
- Otpornost na kvarove u obliku nužnog prebacivanja glavnog čvora.
- Shardiranje na strani Redisa.
- Premještanje podataka između čvorova atomarno i bez zastoja.
- Dodavanje i preusmjeravanje resursa i opterećenja bez zastoja.
Zaključio bih da, ako vam nije potreban visok nivo otpornosti na kvarove, premještanje na klaster nije isplativo, jer to može biti složen zadatak. No, ako birate između odvojene verzije i klastera, klaster je bolji izbor, jer nije ništa lošiji i dodatno će vam olakšati dio briga.
Priprema za premještanje
Počnimo s zahtjevima za premještanje:
- Mora biti neprimjetno. Potpuno zaustavljanje usluge na 5 minuta nam ne odgovara.
- Mora biti što sigurnije i postepeno. Želimo imati određenu kontrolu nad situacijom. Ne želimo sve prebaciti odjednom i moliti se za povratak.
- Minimalni gubici podataka prilikom premještanja. Razumijemo da će biti vrlo teško premjestiti sve odjednom, stoga dopuštamo određenu nesinhronizaciju između podataka u običnom i klasterskom Redis-u.
Održavanje klastera
Prije samog premještanja treba razmisliti o tome možemo li održavati klaster:
- Grafikon. Koristimo Prometheus i Grafanu za grafike opterećenja procesora, zauzete memorije, broja klijenata, broja GET, SET, AUTH operacija i slično.
- Stručnost. Zamislite da će sutra biti odgovornost za ogroman klaster. Ako se pokvari, nitko osim vas ga ne može popraviti. Ako počne usporavati — svi će se obratiti vama. Ako treba dodati resurse ili preraspodijeliti opterećenje — ponovo k vama. Da ne biste osijedili u 25. godini, poželjno je unaprijed razmotriti ove slučajeve i provjeriti kako će tehnologija reagirati na određene akcije. O tome ćemo više razgovarati u odjeljku "Stručnost".
- Monitoring i obavještavanje. Kada klaster prestane raditi, želimo saznati prvi. Ovdje smo se ograničili na obavijest da sve čvorove vraćaju jednake informacije o stanju klastera (da, to može biti različito). Ostale probleme je brže prepoznati putem obavijesti klijentskih usluga Redis-a.
Premještanje
Kako ćemo se preseliti:
- Prvo, potrebno je pripremiti biblioteku za rad s klasterom. Kao osnovu za verziju na Gо uzeli smo go-redis i malo je prilagodili. Implementirali smo Multi-metode putem pipeline-a, a također smo malo izmijenili pravila ponavljanja zahtjeva. S verzijom za PHP bilo je više problema, ali na kraju smo se odlučili za php-redis. Nedavno su uveli podršku za klaster, a po našem mišljenju, to izgleda dobro.
- Sljedeće, potrebno je postaviti sam klaster. To se doslovno radi u dvije naredbe na temelju konfiguracijske datoteke. Detaljnije ćemo raspraviti postavke u nastavku.
- Za postupni prijelaz koristimo dry-mode. Budući da imamo dvije verzije biblioteke s identičnim sučeljem (jedna za uobičajenu verziju, druga za klaster), ništa ne sprečava izradu omota koji će raditi s zasebnom verzijom i paralelno duplicirati sve zahtjeve u klaster, uspoređivati odgovore i zapisivati razlike u logove (u našem slučaju u NewRelic). Tako, čak i ako se klaster verzija pokvari prilikom implementacije, naš produkcijski sustav to neće pogođeno.
- Implementacijom klastera u dry- modu, možemo mirno promatrati grafikon razlika u odgovorima. Ako postotak grešaka sporo, ali sigurno ide prema nekoj maloj konstanti, znači da je sve u redu. Zašto razlike i dalje postoje? Zato što zapis u zasebnoj verziji dolazi malo ranije nego u klasteru, i zbog mikrokašnjenja podaci se mogu razlikovati. Preostaje samo pogledati logove razlika, ako su svi oni objašnjeni neatomarnošću zapisa, onda možemo ići dalje.
- Sada možemo prebaciti dry-mode u suprotnu stranu. Pisat ćemo i čitati iz klastera, a duplicirat ćemo u zasebnu verziju. Zašto? U sljedećem tjednu želimo pratiti rad klastera. Ako se ispostavi da postoje problemi pod vrhunskim opterećenjem ili ako nešto nismo uzeli u obzir, uvijek imamo mogućnost povratka na stari kod i aktualne podatke zahvaljujući dry-mode.
- Preostaje isključiti dry-mode i demontirati zasebnu verziju.
Stručnost
Prvo ćemo ukratko opisati strukturu klastera.
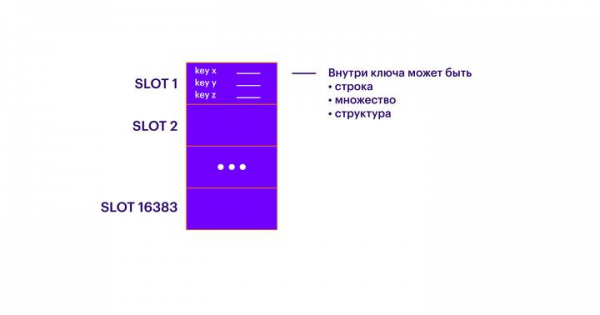
Prvo, Redis je key-value skladište. Kao ključevi koriste se proizvoljne string vrijednosti. Kao vrijednosti mogu se koristiti brojevi, stringovi i složene strukture. Posljednjih je bezbroj, ali za razumijevanje opće strukture nije važno.
Sljedeća razina apstrakcije nakon ključeva su slotovi (SLOTS). Svaki ključ pripada jednom od 16 383 slota. Unutar svakog slota može biti neograničen broj ključeva. Tako da se svi ključevi raspoređuju u 16 383 nepreklapajuće skupine.
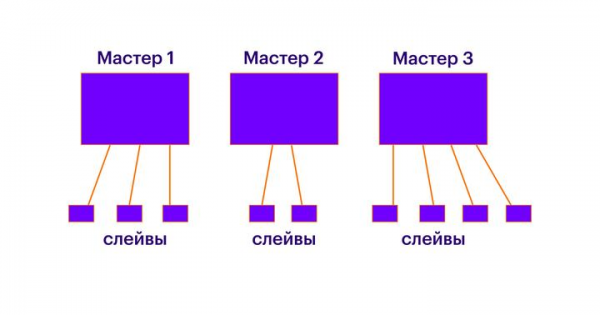
Nadalje, u klasteru treba biti N master-nodova. Svaka nod se može smatrati zasebnom instancom Redisa koja zna sve o ostalim nodovima unutar klastera. Svaki master-nod sadrži određeni broj slotova. Svaki slot pripada samo jednom master-nodu. Sve slotove treba rasporediti između nodova. Ako neki slotovi nisu raspoređeni, ključevi koji se pohranjuju u njima neće biti dostupni. Svaki master-nod je najbolje pokrenuti na zasebnoj logičkoj ili fizičkoj mašini. Također, treba imati na umu da svaki nod radi samo na jednoj jezgri, a ako želite pokrenuti više instanci Redisa na jednoj logičkoj mašini, pobrinite se da će raditi na različitim jezgrama (to nismo testirali, ali teorijski bi sve trebalo funkcionirati). U suštini, master-nodovi omogućuju uobičajeno sharding, a veći broj master-nodova omogućuje skaliranje zahtjeva za pisanjem i čitanjem.
Nakon što su svi ključevi raspoređeni po slotovima, a slotovi raspoređeni po master-nodovima, svakoj master-nodu možete dodati proizvoljan broj slave-nodova. Unutar svake takve poveznice "master-slave" radit će uobičajena replikacija. Slaves su potrebni za skaliranje zahtjeva za čitanjem i za prebacivanje u slučaju kvara mastera.
Sada ćemo razgovarati o operacijama koje bi bilo dobro znati izvoditi.
Sustavu ćemo se obraćati putem Redis-CLI. Budući da Redis nema jedinstvenu točku ulaza, sljedeće operacije mogu se izvoditi na bilo kojem od nodova. U svakom stavku posebno naglašavam mogućnost izvođenja operacije pod opterećenjem.
- Prvo i najvažnije što nam treba: operacija cluster nodes. Ona vraća stanje klastera, prikazuje popis nodova, njihove uloge, raspodjelu slotova itd. Dodatne informacije možete dobiti pomoću cluster info i cluster slots.
- Bilo bi dobro imati mogućnost dodavanja i uklanjanja nodova. Za to postoje operacije cluster meet i cluster forget. Imajte na umu da se cluster forget mora primijeniti na SVAKI nod, kako na master, tako i na replike. A cluster meet dovoljno je pozvati samo na jednom nodu. Ova razlika može zbuniti, pa je bolje saznati o njoj prije nego što pokrenete klaster u rad. Dodavanje nodova sigurno se vrši u radu i ne utječe na rad klastera (što je logično). Međutim, ako namjeravate ukloniti nod iz klastera, trebate se uvjeriti da na njemu više nema slotova (inače riskirate gubitak pristupa svim ključevima na tom nodu). Također, nemojte uklanjati master koji ima slave, inače će se provesti nepotrebno glasanje za novog mastera. Ako više nema slotova na nodovima, to je mali problem, ali zašto bismo se suočavali s dodatnim izborima ako prvo možemo ukloniti slave.
- Ako je potrebno prisilno zamijeniti master i slave, odgovarajuća komanda je cluster failover. Kada je pozivate u radu, morate biti svjesni da će master biti nedostupan tijekom izvođenja operacije. Obično se prebacivanje događa za manje od sekunde, ali nije atomarno. Možete očekivati da će dio zahtjeva prema masteru u to vrijeme završiti greškom.
- Prije nego što uklonite čvor iz klastera, ne bi smjelo ostati slotova na njemu. Preporučuje se preraspodjela putem naredbe cluster reshard. Slotovi će biti premješteni s jednog majstora na drugi. Cijela operacija može potrajati nekoliko minuta, ovisno o količini podataka koja se premješta, međutim, proces prijenosa je siguran i ne utječe na rad klastera. Tako, svi podaci mogu se premjestiti s jednog čvora na drugi tijekom opterećenja, bez brige o njihovoj dostupnosti. No, postoje i nijanse. Prvo, prijenos podataka povezan je s određenim opterećenjem na prijemnom i šaljivom čvoru. Ako je prijemni čvor već jako opterećen procesorom, ne biste ga trebali dodatno opterećivati primanjem novih podataka. Drugo, čim na majstoru-šaljivcu ne ostane nijedan slot, svi njegovi sljedbenici odmah će preći na majstora na koji su ti slotovi premješteni. I problem je u tome što će svi ti sljedbenici željeti odmah sinhronizirati podatke. I još ćete imati sreće ako to bude djelomična, a ne potpuna sinhronizacija. Uzmite to u obzir i kombinirajte operacije prijenosa slotova i isključivanja/premještanja sljedbenika. Ili se nadajte da imate dovoljno prostora za manevriranje.
- Što učiniti ako prilikom prijenosa otkrijete da ste negdje izgubili slotove? Nadam se da vas ovaj problem neće zadesiti, ali ako to bude potrebno, postoji operacija cluster fix. Ona će na neki način raspodijeliti slotove po čvorovima nasumično. Preporučujem da provjerite njen rad nakon što prethodno uklonite čvor s raspodijeljenim slotovima iz klastera. Budući da podaci u neraspodijeljenim slotovima i inače nisu dostupni, prekasno je brinuti se o problemima s dostupnošću tih slotova. S druge strane, operacija neće utjecati na raspodijeljene slotove.
- Još jedna korisna operacija je monitor. Ona omogućava u stvarnom vremenu vidjeti cijeli popis upita koji idu prema čvoru. Štoviše, po njoj se može napraviti grep i saznati postoji li potreban promet.
Također vrijedi spomenuti postupak prebacivanja glavnog čvora. Ukratko, postoji, i po mom mišljenju, djeluje odlično. Međutim, ne treba misliti da će Redis odmah prebaciti klijente i da oni neće primijetiti gubitak ako izvučete utikač iz utičnice na mašini s glavnim čvorom. Na mom iskustvu, prebacivanje traje nekoliko sekundi. Tijekom tog perioda, dio podataka neće biti dostupan: otkriva se nedostupnost glavnog čvora, čvorovi glasaju za novog, replikanti se prebacuju, podaci se sinkroniziraju. Najbolji način da se uvjerite sami da shema radi je provesti lokalne vježbe. Pokrenite klaster na svom laptopu, dajte minimalno opterećenje, simulirajte pad (npr. blokiranjem portova), procijenite brzinu prebacivanja. Po mom mišljenju, samo igrajući se ovako jedan do dva dana, možete biti sigurni u rad tehnologije. Ili se nadati da softver koji koristi pola interneta sigurno funkcionira.
Konfiguracija
Često, konfiguracija je prvo što je potrebno za početak rada s alatom. A kada sve proradi, ne želi se dirati konfiguracija. Potrebna su određena ulaganja da se natjerate da se vratite postavkama i pažljivo ih pregledate. U mom sjećanju imali smo barem dva ozbiljna problema zbog nepažnje prema konfiguraciji. Obratite posebnu pozornost na sljedeće točke:
- timeout 0
Vrijeme nakon kojeg se zatvaraju neaktivne veze (u sekundama). 0 — ne zatvaraju se.
Nisu sve naše biblioteke ispravno zatvarale veze. Isključivši ovu postavku, rizikujemo da naletimo na limit broja klijenata. S druge strane, ako postoji takav problem, automatsko prekidanje izgubljenih veza će ga prikriti, i možda nećemo primijetiti. Osim toga, ne treba aktivirati ovu postavku kada koristimo persist- veze. - Save x y & appendonly yes
Spremanje RDB snimke.
Probleme RDB/AOF detaljno ćemo raspraviti u nastavku. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Ako je uključeno, prilikom kvara RDB snimke, glavni čvor prestaje primati zahtjeve za promjenom. Ako se veza s glavnim čvorom izgubi, replikant može nastaviti odgovarati na zahtjeve (yes). Ili će prestati odgovarati (no).
Nismo zadovoljni situacijom u kojoj Redis postaje bundeva. - repl-ping-slave-period 5
Nakon ovog vremenskog razdoblja počet ćemo brinuti se da je majstor pokvaren i da je vrijeme za postupak prebacivanja.
Trebalo bi ručno pronaći ravnotežu između lažnih alarma i pokretanja prebacivanja. U našoj praksi to je 5 sekundi. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Toliko podataka možemo pohraniti u bafer za isključenu repliku. Ako bafer završi, morat ćemo se potpuno sinkronizirati.
Praksa sugerira da je bolje postaviti veću vrijednost. Razloga zbog kojih replika može početi kasniti je mnogo. Ako kasni, vjerojatno vaš majstor već teško podnosi opterećenje, a potpuna sinkronizacija bit će posljednja kap. - maxclients 10000
Maksimalni broj istovremenih klijenata.
Prema našem iskustvu, bolje je postaviti veću vrijednost. Redis se odlično nosi sa 10 tisuća veza. Samo se pobrinite da sustav ima dovoljno soketa. - maxmemory-policy volatile-ttl
Pravila prema kojima se ključevi brišu pri dostizanju limita dostupne memorije.
Bitno je ne samo samo pravilo, već i razumijevanje kako će se to odvijati. Redis zaslužuje pohvalu za sposobnost normalnog rada kada se dostigne limit memorije.
Problemi RDB i AOF
Iako sam Redis pohranjuje sve informacije u radnoj memoriji, također postoji mehanizam za pohranu podataka na disk. Preciznije, tri mehanizma:
- RDB-snapshot — potpuni preslik svih podataka. Postavlja se putem konfiguracije SAVE X Y i čita kao "Spremi potpuni snimak svih podataka svake X sekundi, ako je promijenjeno barem Y ključeva."
- Append-only file — popis operacija u redoslijedu njihova izvršenja. Dodaje nove operacije u datoteku svake X sekundi ili svake Y operacija.
- RDB i AOF — kombinacija dvaju prethodnih.
Sve metode imaju svoje prednosti i nedostatke, neću ih sve nabrajati, samo ću se osvrnuti na očite, po mom mišljenju, aspekte.
Prvo, za pohranu RDB-snimka potrebno je pozvati FORK. Ako podataka ima puno, to može obustaviti cijeli Redis na razdoblje od nekoliko milisekundi do sekunde. Osim toga, sustav mora osloboditi memoriju za takav snimak, što dovodi do potrebe za održavanjem dvostrukog kapaciteta radne memorije na logičkoj mašini: ako je za Redis dodijeljeno 8 GB, na virtualnoj mašini s njim mora biti dostupno 16.
Drugo, postoje problemi s djelomičnom sinkronizacijom. U AOF načinu rada, prilikom ponovnog povezivanja slava, može se dogoditi potpuna sinkronizacija umjesto djelomične. Zašto se to događa, nisam uspio razumjeti. No, treba to imati na umu.
Ove dvije točke već izazivaju razmišljanje o tome koliko su nam ti podaci na disku stvarno potrebni, ako su već duplirani kroz slave. Gubitak podataka može se dogoditi samo kada svi slavi prestanu raditi, a to je problem razine „požar u DC-u“. Kao kompromis, možemo predložiti da se podaci čuvaju samo na slavima, ali u tom slučaju treba osigurati da ti slavi nikada ne postanu glavni tijekom oporavka u slučaju kvara (za to postoji postavka prioriteta slava u njihovoj konfiguraciji). U svakom pojedinom slučaju razmišljamo o tome treba li čuvati podatke na disku, i najčešće odgovaramo „ne“.
Zaključak
Na kraju, nadam se da sam uspio dati općenitu predstavu o radu redis-clustera onima koji o njemu nisu ništa čuli, a također sam skrenuo pažnju na neke nejasne aspekte za one koji ga već dugo koriste.
Hvala vam na vremenu i, kao i obično, komentari na temu su dobrodošli.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish