

Još jedan korisnik želi na tvrdi disk snimiti novi komad podataka, ali mu nedostaje slobodnog prostora za to. Ništa ne želi ni brisati, jer je "sve jako važno i potrebno". Što da radimo s tim?
Ova se problematika ne javlja samo kod njega. Na našim tvrdim diskovima leže terabajti informacija, a taj broj neprestano raste. No koliko su one jedinstvene? Na kraju krajeva, svi su to datoteke koje su samo skupovi bitova određene dužine, i upravo nova se ne razlikuje mnogo od onih koje već čuvamo.
Sasvim je jasno da tražiti već pohranjene komade informacija na tvrdom disku nije baš efikasno. S druge strane, ako je razlika mala, može se malo i prilagoditi...
TL;DR — drugi pokušaj objašnjavanja čudnog metoda optimizacije podataka pomoću JPEG datoteka, sada u razumljivijem obliku.
O bitovima i razlici
Ako uzmemo dva potpuno nasumična komada podataka, u njima se u srednjem slučaju poklapa polovina sadržanih bitova. Uistinu, među mogućim kombinacijama za svaki par ('00, 01, 10, 11') točno polovina ima poklapanja, ovdje je to jednostavno.
Međutim, ako jednostavno uzmemo dvije datoteke i prilagodimo jednu drugoj, izgubit ćemo jednu od njih. Ako budemo čuvali promjene, samo ćemo ponovo izumiti , koje i bez nas savršeno postoji, iako se obično ne koristi u ovakvim svrha. Možemo pokušati ugraditi manji niz u veći, ali čak i tako rizikujemo gubitak kritičnih segmenata podataka pri nepromišljenoj primjeni sa svime.
Između čega i čega možemo razliku smanjivati? Dakle, datoteka koju korisnik snima je samo niz bitova, s kojim sami ne možemo ništa učiniti. Stoga, jednostavno moramo pronaći na tvrdom disku one bitove koje možemo mijenjati bez potrebe da čuvamo razliku, kako bismo mogli preživjeti njihov gubitak bez ozbiljnih posljedica. Osim toga, ima smisla mijenjati ne samo samu datoteku na FS-u, nego i neku manje osjetljivu informaciju unutar nje. No, koju i kako?
Metode prilagodbe
Pomoć dolazi iz datoteka komprimiranih s gubicima. Svi ti jpeg, mp3 i slični formati, iako su komprimirani s gubicima, sadrže mnoštvo bitova dostupnih za sigurno izmjene. Mogu se koristiti napredne tehnike koje neprimjetno modificiraju njihove komponente na različitim dijelovima kodiranja. Čekajte. Napredne tehnike… neprimjetna modifikacija… jedan bit u drugi… to je gotovo što !
Uistinu, ugrađivanje jedne informacije u drugu zapravo podsjeća na njene metode. Također impresionira neprimjetnost izvršenih promjena za ljudske organe osjeta. Evo gdje se putevi razdvajaju — tako je u tajnosti: naš zadatak svodi se na dodavanje dodatnih informacija korisniku na njegov tvrdi disk, što mu samo može škoditi. Još će zaboraviti.
Stoga, iako ih možemo koristiti, potrebno je provesti neke modifikacije. O tome ću govoriti i prikazati na primjeru jedne od postojećih metoda i popularnog formata datoteka.
O šakalima
Ako ćemo komprimirati, onda najkomprimiranije na svijetu. Govorimo, naravno, o JPEG datotekama. Osim toga, postoji tona alata i postojećih metoda za ugrijavanje podataka u njih, a one su najpopularniji grafički format na ovoj planeti.
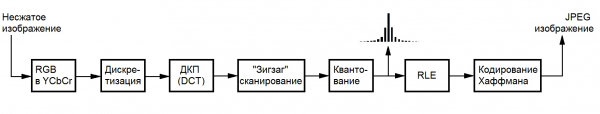
Ipak, da se ne bavimo psećim odvodima, potrebno je ograničiti svoje polje djelovanja na datotekama ovog formata. Nitko ne voli jednobojne kvadrate koji nastaju zbog pretjerane kompresije, stoga se treba ograničiti na rad s već komprimiranom datotekom, izbjegavajući ponovnu kodiranje. Konkretno — s cijelim koeficijentima koji ostaju nakon operacija odgovornih za gubitak podataka — DCT i kvantizaciju, što je savršeno prikazano na shemi kodiranja (hvala viki nacionalne biblioteke im. Baumana):
Postoji mnogo mogućih metoda optimizacije jpeg datoteka. Postoji optimizacija bez gubitaka (jpegtran), postoji optimizacija „“, koje zapravo još neke unose, ali nas to ne zanima. Uostalom, ako je korisnik spreman ugrijati jednu informaciju u drugu radi povećanja slobodnog prostora na disku, tada je svoje slike ili davno optimizirao, ili to uopće ne želi raditi zbog straha od gubitka kvalitete.
F5
Takvim uvjetima odgovara cjelokupna obitelj algoritama s kojom se možete upoznati . Najnapredniji od njih je algoritam autorstvom Andreasa Westfelda, koji radi s koeficijentima komponente svjetline, budući da je ljudsko oko najmanje osjetljivo na njene promjene. Štoviše, koristi metodu umetanja koja se temelji na kodiranju matrice, što omogućava da se izvrši manje promjena prilikom umetanja iste količine informacija, što je veća veličina korištenog kontejnera.
Sama promjena se svodi na smanjenje apsolutne vrijednosti koeficijenata za jedinicu u određenim uvjetima (tj. ne uvijek), što omogućava korištenje F5 za optimizaciju pohrane podataka na tvrdom disku. Riječ je o tome da će koeficijent nakon takve promjene vjerojatno zauzimati manje bitova nakon Huffmanovog kodiranja zbog statističke raspodjele vrijednosti u JPEG-u, a novi nulti će donijeti dobitak pri kodiranju putem RLE-a.
Potrebne modifikacije svode se na uklanjanje dijela koji se odnosi na tajnost (lozinka permutacija), što omogućava uštedu resursa i vremena izvršavanja, i dodavanje mehanizma rada s više datoteka umjesto jedne po jedno. Detaljniji opis procesa promjene vjerojatno neće zanimati čitatelja, stoga prelazimo na opis implementacije.
Visoke tehnologije
Da bih demonstrirao radnog pristupa, implementirao sam metodu u čistom C-u i izvršio niz optimizacija kako brzine izvršavanja, tako i memorije (ne možete ni zamisliti koliko te slike teže bez kompresije, čak i do DCT-a). Cross-platformnost je postignuta korištenjem kombinacije biblioteka , i , za što im hvala. Sve se to sastavlja uz pomoć ‘make», pa se korisnicima Windowsa preporučuje da instaliraju neki Cygwin ili se sami bave Visual Studiom i bibliotekama.
Implementacija je dostupna u obliku konzolne aplikacije i biblioteke. Detaljnije o korištenju potonje zainteresirani mogu pročitati u README-u u repozitoriju na GitHubu, čiju ću vezu priložiti na kraju posta.
Kako koristiti?
Pažljivo. Slike korištene za pakiranje biraju se pretraživanjem po regularnom izrazu u zadanom korijenskom direktoriju. Nakon završetka, datoteke se mogu premjestiti, preimenovati i kopirati po želji unutar njega, mijenjati datotečne i operacijske sustave itd. Ipak, treba biti iznimno oprezan i nikako ne mijenjati neposredni sadržaj. Gubitak samo jednog bita može uzrokovati nemogućnost vraćanja informacija.
Nakon završetka rada, alat ostavlja poseban arhivski datoteku, koja sadrži sve potrebne informacije za raspakiravanje, uključujući podatke o korištenim slikama. Ona sama po sebi ima otprilike nekoliko kilobajta i ne utječe značajno na zauzet prostor na disku.
Moguće je analizirati mogući kapacitet pomoću zastavice ‘-a’: ‘./f5ar -a [direktorij pretraživanja] [Perl-kompatibilni regularni izraz]’. Pakiranje se vrši naredbom ‘./f5ar -p [direktorij pretraživanja] [Perl-kompatibilni regularni izraz] [pakirani datoteka] [ime arhiva]’, dok se raspakiravanje vrši pomoću ‘./f5ar -u [arhivska datoteka] [ime vraćene datoteke]’.
Demonstracija rada
Kako bih pokazao učinkovitost metode, preuzeo sam kolekciju od 225 potpuno besplatnih slika pasa s servisa i pronašao u dokumentima veliki pdf od 45 metara drugog sveska Knuth.
Sekvenca je prilično jednostavna:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Čitam kompresijsku datoteku... u redu
Inicijaliziram arhiv... u redu
Analiziram kapacitet biblioteke... završeno za 17.0s
Otkrivena zagarantirana kapacitet od 48439359 bajta
Otkrivena moguća kapaciteta do 102618787 bajta
Kompresiram... završeno za 39.4s
Spremam arhiv... u redu

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Inicijaliziram arhiv... u redu
Čitam arhivsku datoteku... u redu
Punim arhiv datotekama... završeno za 1.4s
Dekompresiram... završeno za 21.0s
Pišem izvučene podatke... u redu

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Snimke zaslona za ljubitelje
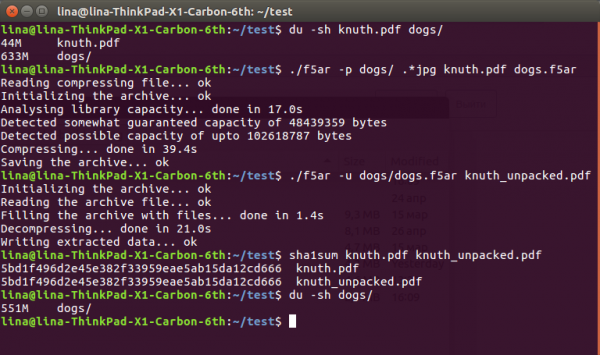
Raspakirana datoteka se još uvijek može i treba čitati:
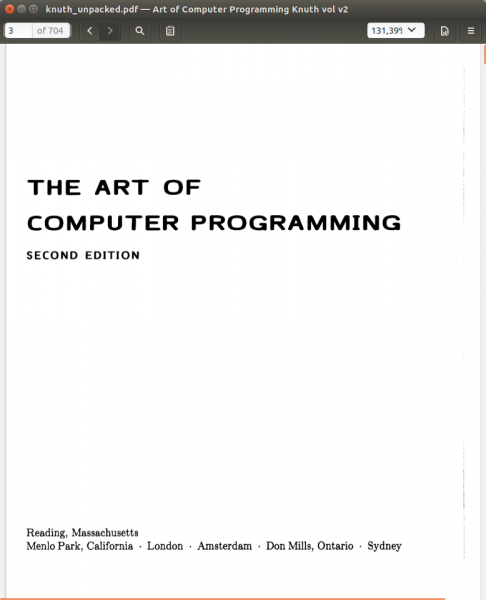
Kao što se može vidjeti, s izvornim 633 + 36 == 669 megabajta podataka na tvrdom disku došli smo do ugodnijih 551. Takva radikalna razlika objašnjava se smanjenjem vrijednosti koeficijenata koji utječu na njihovo kasnije gubitno komprimiranje: smanjenje jednog samo za jedinicu može lagano "odsjeći" nekoliko bajtova iz konačne datoteke. Ipak, to su i dalje gubici podataka, iako izuzetno mali, s kojima će se morati pomiriti.
Srećom, za oko su potpuno neprimjetni. Pod razdjelnicom (pošto habrastorage ne može upravljati velikim datotekama) čitatelj može procijeniti razliku i njihovu intenzitet, izračunatu oduzimanjem promijenjene komponente od originalne: , , (što je boja manje intenzivna, to je manja razlika u bloku).
Umjesto zaključka
Gledajući sve ove složenosti, kupnja tvrdog diska ili prijenos svega u oblak može se činiti daleko jednostavnijim rješenjem problema. Iako sada živimo u tako divnom vremenu, nema nikakvih jamstava da ćemo sutra moći pristupiti internetu i prenijeti sve svoje suvišne podatke. Ili otići u trgovinu i kupiti još jedan tvrdi disk od tisuću terabajta. A korištenje onog što već imamo kod kuće uvijek je opcija.
->
Izvor: habr.com
