

Proces ažuriranja za vaš Kubernetes klaster
U nekom trenutku korištenja Kubernetes klastera pojavljuje se potreba za ažuriranjem aktivnih nodova. To može uključivati ažuriranja paketa, ažuriranje jezgre ili implementaciju novih slika virtualnih strojeva. U terminologiji Kubernetes to se naziva .
Ova objava je dio ciklusa od 4 objave:
- Ova objava.
- Ispravno gašenje podova u Kubernetes klasteru
- Odloženo gašenje poda prilikom njegovog brisanja
- Kako izbjeći zastoj u radu Kubernetes klastera pomoću PodDisruptionBudgets
(napomena prevođača: prijevode preostalih članaka ciklusa očekujte uskoro)
U ovom članku opisat ćemo sve alate koje Kubernetes pruža za postizanje nultog vremena zastoja za aktivne nodove u vašem klasteru.
Definiranje problema
U početku ćemo koristiti naive pristup, definirati probleme i procijeniti potencijalne rizike tog pristupa, te akumulirati znanja za rješavanje svakog od problema na koje ćemo naići tijekom cijelog ciklusa. Kao rezultat, dobit ćemo konfiguraciju koja koristi lifecycle hooks, readiness probes i Pod disruption budgets za postizanje našeg nultog vremena zastoja.
Da bismo započeli naš put, uzmimo konkretan primjer. Recimo da imamo Kubernetes klaster s dva noda, u kojem se pokreće aplikacija s dva poda, koja se nalazi iza Service:
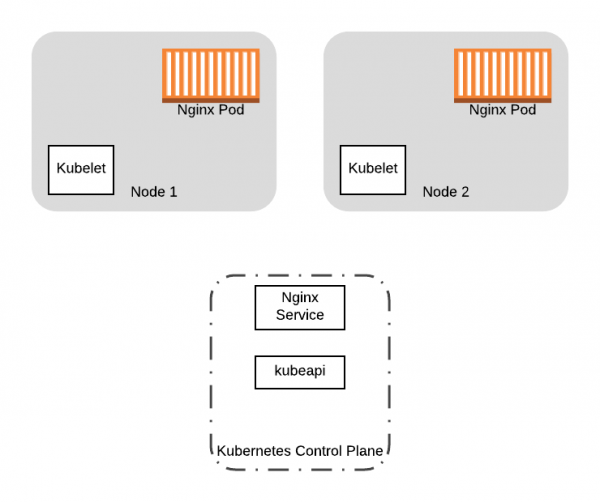
Započnimo s dva poda s Nginx i Service pokrenuta na naših dvaju nodovima Kubernetes klastera.
Želimo ažurirati verziju jezgre dvaju radnih nodova u našem klasteru. Kako bismo to učinili? Jednostavno rješenje bi bilo pokrenuti nove nodove s ažuriranom konfiguracijom, a zatim isključiti stare nodove, istodobno pokrećući nove. Iako će to funkcionirati, bit će nekoliko problema s takvim pristupom:
- Kada isključite stare nodove, podovi koji se na njima izvode također će biti isključeni. Što ako se podovi trebaju očistiti za pravilno isključivanje? Sustav virtualizacije koji koristite možda neće pričekati završetak procesa čišćenja.
- Što ako isključite sve nodove istodobno? Dobit ćete značajan zastoj dok se podovi preseljavaju na nove nodove.
Trebamo način ispravne migracije podova sa starih čvorova, uz osiguranje da nijedan od naših radnih procesa nije pokrenut dok vršimo promjene na čvoru. Ili kada radimo potpunu zamjenu klastera, kao u primjeru (tj. zamjenjujemo slike VM), želimo prenijeti aktivne aplikacije sa starih čvorova na nove. U oba slučaja želimo spriječiti planiranje novih podova na starim čvorovima, a zatim iseliti sve pokrenute podove s njih. Kako bismo postigli te ciljeve, možemo koristiti naredbu kubectl drain.
Preusmjeravanje svih podova s čvora
Operacija drain omogućava preusmjeravanje svih podova s čvora. Tijekom izvršavanja drain čvor se označava kao unschedulable (oznaka NoSchedule). To sprječava pojavu novih podova na njemu. Zatim drain počinje iseljavati podove s čvora, završava rad kontejnera koji su trenutno pokrenuti na čvoru slanjem signala TERM kontejnerima u podu.
Iako kubectl drain odličan je za iseljavanje podova, no postoje još dva faktora koji mogu uzrokovati neuspjeh prilikom izvršavanja operacije drain:
- Vaša aplikacija mora biti u mogućnosti ispravno završiti kada primi
TERMsignal. Kada se podovi iseljavaju, Kubernetes šalje signalTERMkontejnerima i čeka da se zaustave određeno vrijeme, nakon čega, ako se nisu zaustavili, silom ih zatvara. U svakom slučaju, ako vaš kontejner ne reagira na signal ispravno, još uvijek možete isključiti podove neispravno, ako su u tim trenucima aktivni (npr. ako se izvodi transakcija u BDP-u). - Gubite sve podove koji sadrže vašu aplikaciju. Ona može biti nedostupna u trenutku pokretanja novih kontejnera na novim čvorovima ili, ako su vaši podovi raspoređeni bez kontrolera, možda se neće ponovno pokrenuti uopće.
Izbjegavanje zastoja
Kako bismo minimalizirali vrijeme zastoja od voluntary disruption, kao što je operacija drain za čvor, Kubernetes nudi sljedeće opcije za upravljanje neuspjesima:
U ostalim dijelovima ciklusa koristit ćemo ove funkcije Kubernetes-a za ublažavanje posljedica migracije podova. Kako bismo lakše pratili osnovnu misao, koristit ćemo naš prethodni primjer s slijedećom konfiguracijom resursa:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Ova konfiguracija je minimalni primjer Deployment, koji upravlja podovima nginx u klasteru. Nadalje, konfiguracija opisuje resurs Service, koji se može koristiti za pristup podovima nginx u klasteru.
Tijekom čitavog ciklusa ćemo iterativno proširivati ovu konfiguraciju, tako da će na kraju obuhvatiti sve mogućnosti koje Kubernetes nudi za smanjenje vremena zastoja.
Kako biste dobili potpuno implementiranu i testiranu verziju nadogradnji Kubernetes klastera za nulti vrijeme zastoja na AWS-u i drugim resursima, posjetite .
Također pročitajte druge članke na našem blogu:
Izvor: habr.com
