

Kako povećati broj upita na bazi podataka deset puta bez preseljenja na jači server i zadržati funkcionalnost sistema? Objasniću kako smo se borili protiv opadanja performansi naše baze podataka, kako smo optimizovali SQL upite da služe što većem broju korisnika, a da ne povećamo troškove računarskih resursa.
Razvijam servis za upravljanje poslovnim procesima u građevinskim kompanijama. Sa nama radi oko 3.000 kompanija. Više od 10.000 ljudi svakodnevno koristi naš sistem od 4 do 10 sati. Rešava razne zadatke planiranja, obaveštavanja, upozoravanja, validacije… Koristimo PostgreSQL 9.6. U bazi podataka imamo oko 300 tabela i svakodnevno se izvrši do 200 miliona upita (10.000 različitih). U proseku imamo 3.000 do 4.000 upita u sekundi, a u najsnažnijim trenucima više od 10.000 upita po sekundi. Veliki deo upita su OLAP. Dodavanja, modifikacije i brisanja su znatno manja, što znači da je OLTP opterećenje relativno malo. Sve ove brojke sam naveo kako biste mogli proceniti razmeru našeg projekta i razumeti koliko našu iskustvo može biti korisno za vas.
Prva slika. Lirska
Kada smo započeli razvoj, nismo mnogo razmišljali o tome kakvo opterećenje će biti na bazi podataka i šta ćemo raditi ukoliko server prestane da izdrži. Tokom projektovanja baze podataka pratili smo opšte preporuke i trudili se da ne napravimo greške, ali nismo išli dalje od općih saveta poput "ne koristite obrazac nismo išli. Projektovali smo prema principima normalizacije izbegavajući suvišnost podataka i nismo se brinuli o ubrzanju određenih upita. Kada su prvi korisnici došli, suočili smo se s problemom performansi. Kao i obično, nismo bili apsolutno spremni za to. Prvi problemi su bili jednostavni. Uglavnom se sve rešavalo dodavanjem novog indeksa. Međutim, došao je trenutak kada su jednostavne nadogradnje prestale da funkcionišu. Svjesni da nam nedostaje iskustva i da nam je sve teže razumeti uzrok problema, angažovali smo stručnjake koji su nam pomogli da pravilno konfigurišemo server, povežemo monitoring i pokazali nam gde da gledamo za dobijanje .
Druga slika. Statistička
Dakle, imamo oko 10 tisuća različitih zahtjeva koji se izvršavaju na našoj bazi podataka svakodnevno. Od tih 10 tisuća, postoje 'monstri' koji se izvršavaju 2-3 milijuna puta s prosječnim vremenom izvršenja od 0.1-0.3 ms, te zahtjevi koji imaju prosječno vreme izvršenja od 30 sekundi, a pozivaju se 100 puta dnevno.
Optimizirati svih 10 tisuća zahtjeva nije bilo moguće, pa smo odlučili istražiti kuda usmjeriti napore kako bismo pravilno povećali performanse baze podataka. Nakon nekoliko iteracija, počeli smo dijeliti zahtjeve prema vrstama.
TOP zahtjevi
To su najteži zahtjevi koji zauzimaju najviše vremena (ukupno vrijeme). To su zahtjevi koji se ili vrlo često pozivaju ili zahtjevi koji se upravo vrlo dugo izvršavaju (dugi i česti zahtjevi su optimizirani još u prvim iteracijama borbe za brzinu). Na kraju, server troši najviše vremena na njihovo izvršavanje. Važno je odvojiti top zahtjeve prema ukupnom vremenu izvršenja i zasebno prema IO vremenu. Načini optimizacije takvih zahtjeva su malo drugačiji.
Uobičajena praksa svih kompanija je rad s TOP zahtjevima. Ima ih malo i optimizacija čak i jednog zahtjeva može osloboditi 5-10% resursa. Međutim, kako projekt 'odrasta', optimizacija TOP zahtjeva postaje sve složeniji zadatak. Svi jednostavni načini su već isprobani, a najteži zahtjev troši 'samo' 3-5% resursa. Ako TOP zahtjevi ukupno zauzimaju manje od 30-40% vremena, vjerojatno ste već uložili napore kako bi radili brzo i došlo je vrijeme za prelazak na optimizaciju zahtjeva iz sljedeće grupe.
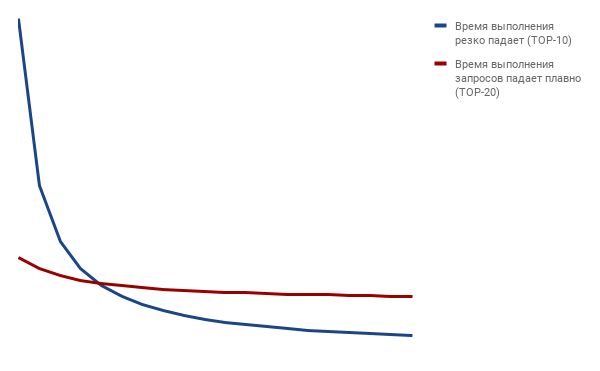
Preostaje odgovoriti na pitanje koliko gornjih zahtjeva uključiti u ovu grupu. Obično uzimam ne manje od 10, ali ne više od 20. Pokušavam osigurati da se vrijeme prvog i posljednjeg u TOP grupi razlikuje ne više od 10 puta. To jest, ako se vrijeme izvršenja zahtjeva naglo smanjuje sa 1. mjesta na 10., uzimam TOP-10, ako je pad postupan, povećavam veličinu grupe na 15 ili 20.
Srednjaci (medium)
To su svi zahtjevi koji dolaze odmah nakon TOP-a, osim posljednjih 5-10%. Obično u optimizaciji upravo tih zahtjeva leži mogućnost značajnog povećanja performansi servera. Ovi zahtjevi mogu 'zauzimati' do 80%. Ali čak i ako njihov udio premaši 50%, tada je pravo vrijeme da im se posveti pažnja.
Rep (tail)
Kao što je rečeno, ovi upiti dolaze na kraju i oduzimaju 5-10% vremena. Možete ih zaboraviti samo ako ne koristite automatske alate za analizu upita, tada njihova optimizacija takođe može biti povoljnija.
Kako procijeniti svaku grupu?
Koristim SQL upit koji pomaže u toj procjeni za PostgreSQL (siguran sam da se može napisati sličan upit za mnoge druge DBMS).
SQL upit za procjenu veličine TOP-MEDIUM-TAIL grupa.
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail) AS sum_tail
FROM
(
  SELECT CASE WHEN rn  20 AND rn  800              THEN tt_percent ELSE 0 END AS time_tail
  FROM (
    SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query,
    ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn
    FROM pg_stat_statements
    ORDER BY total_time DESC
  ) AS t
)
AS ts
Rezultat upita - tri kolone, svaka od njih sadrži postotak vremena koje se troši na obradu upita iz te grupe. Unutra upita postoje dva broja (u mom slučaju to su 20 i 800), koji odvajaju upite jedne grupe od druge.
Ovako otprilike izgleda odnos između postotaka upita u trenutku početka optimizacije i sada.
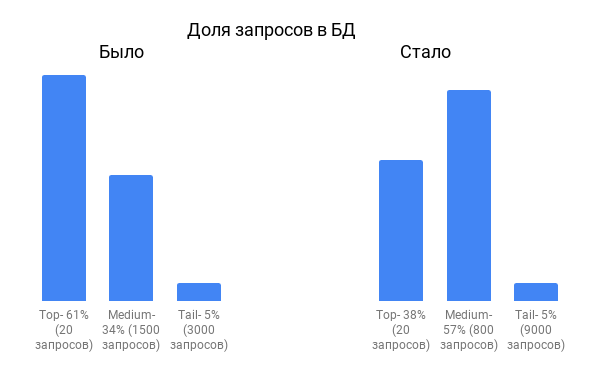
Iz dijagrama se vidi da je udio TOP upita naglo smanjen, a udio "srednjaka" se povećao.
Isprva su u TOP upite ulazili očigledni propusti. S vremenom su dječje bolesti nestale, udio TOP upita se smanjivao, a bilo je potrebno uložiti sve više truda da se ubrzaju teški upiti.
Da bismo dobili tekst upita, koristimo ovakav upit.
SELECT * FROM (
  SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query
  FROM pg_stat_statements
  ORDER BY total_time DESC
) AS T
WHERE
rn  20 AND rn  800  -- TAIL
Evo popisa najčešće korištenih tehnika koje su nam pomagale da ubrzamo TOP upite:
- Redizajn sistema, na primjer, prerada logike obavijesti pomoću message brokera umjesto periodičnih upita ka bazi podataka.
- Dodavanje ili promjena indeksa.
- Prepisivanje ORM upita u čisti SQL.
- Prepisivanje logike lazy učitavanja podataka.
- Keširanje kroz denormalizaciju podataka. Na primjer, imamo vezu između tabela Dostava -> Račun -> Upit -> Zahtjev. Svaka dostava je povezana s zahtjevom kroz druge tabele. Da ne bismo povezivali sve tabele u svakom upitu, duplicirali smo vezu na zahtjev u tabeli Dostava.
- Keširanje statičkih tablica sa referencama i rijetko promjenjivih tablica u memoriji programa.
Ponekad su promjene zahtijevale značajan redizajn, ali su pružale 5-10% olakšanja sustava i bile su opravdane. Vremenom je učinkovitost postajala sve manja, a redizajn je postajao sve ozbiljniji.
Tada smo obratili pažnju na drugu grupu zahtjeva – grupu srednjaka. U njoj je bilo znatno više zahtjeva, a činilo se da će analiza cijele grupe oduzeti jako puno vremena. Međutim, većina zahtjeva bila je vrlo jednostavna za optimizaciju, a mnogi problemi ponavljali su se deset puta u raznim varijacijama. Ovo su primjeri nekih tipičnih optimizacija koje smo primijenili na desetinama sličnih zahtjeva, a svaka grupa optimiziranih zahtjeva smanjila je opterećenje Baze podataka za 3-5%.
- Umjesto provjere postojanja zapisa pomoću COUNT-a i cjelovitog skeniranja tablice počeli smo koristiti EXISTS.
- Oslobodili smo se DISTINCT-a (nema općeg recepta, ali ga nekad lako možemo eliminirati i ubrzati upit 10-100 puta).
Na primjer, umjesto upita za odabir svih vozača iz velike tablice dostava (DELIVERY)
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
napravili smo upit iz relativno male tablice PERSON.
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
Naizgled, koristili smo koreliranu podupit, ali ona donosi ubrzanje više od 10 puta.
- U mnogim slučajevima smo uopće odustali od COUNT-a i
- umjesto
UPPER(s) LIKE JOHN%koristimo
s ILIKE “John%”
Svaki konkretan upit uspijevali smo ubrzati ponekad 3-1000 puta. Usprkos impresionirajućim pokazateljima, na početku se činilo da nema smisla optimizirati upit koji se izvršava 10 ms, ulazi u 300. po redu najtežih upita i u ukupnom vremenu opterećenja na Bazi podataka zauzima stotinke postotka. No primjenom istog recepta na grupu sličnih upita, uspjeli smo povratiti nekoliko postotaka. Kako bismo uštedjeli vrijeme na ručnom pregledu svih stotina upita, napisali smo nekoliko jednostavnih skripti koje su uz pomoć regularnih izraza nalazile slične upite. Na kraju, automatsko pretraživanje grupa upita omogućilo nam je dodatno poboljšanje naše učinkovitosti uz minimalne napore.
Na kraju, radimo već tri godine na istom hardveru. Prosječno opterećenje je oko 30%, a u špicama doseže do 70%. Broj zahtjeva i korisnika povećao se otprilike 10 puta. A sve to zahvaljujući stalnom monitoringu tih grupa zahtjeva TOP-MEDIUM. Čim se pojavi novi zahtjev u grupi TOP, odmah ga analiziramo i pokušavamo ubrzati. Grupu MEDIUM pregledavamo jednom tjedno pomoću skripti za analizu zahtjeva. Ako pronađemo nove zahtjeve za koje znamo kako optimizirati, brzo ih mijenjamo. Ponekad pronalazimo nove metode optimizacije koje možemo odmah primijeniti na nekoliko zahtjeva.
Prema našim prognozama, trenutni server će izdržati povećanje broja korisnika još 3-5 puta. Ipak, imamo još jedan adut u rukavu - još uvijek nismo prebacili SELECT zahtjeve na mirror, kao što se preporučuje. No, to činimo svjesno jer želimo prvo iscrpiti mogućnosti 'pametne' optimizacije prije nego što angažiramo 'tešku artiljeriju'.
Kritički pogled na urađeni posao može sugerirati korištenje vertikalnog skaliranja. Kupiti moćniji server umjesto gubljenja vremena stručnjaka. Server ne bi trebao koštati puno, pogotovo jer naši limiti vertikalnog skaliranja još nisu iscrpljeni. Međutim, broj zahtjeva je porastao samo 10 puta. Tijekom nekoliko godina, funkcionalnost sustava se povećala i sada imamo više vrsta zahtjeva. Ona funkcionalnost koja je bila, zahvaljujući keširanju, sada se izvršava s manjim brojem zahtjeva, a oni su učinkovitiji. To znači da možemo sigurno pomnožiti još s 5 kako bismo dobili stvarni koeficijent ubrzanja. Dakle, prema najskromnijim proračunima, možemo reći da je ubrzanje bilo 50 i više puta. Vertikalno povećanje servera 50 puta bi bilo skuplje. Pogotovo uzimajući u obzir da jednom izvršena optimizacija radi cijelo vrijeme, a račun za iznajmljeni server dolazi svaki mjesec.
Izvor: habr.com
