

Što može natjerati tako veliku kompaniju kao što je Lamoda, koja ima uspostavljen proces i desetke međusobno povezanih servisa, da bitno promijeni pristup? Motivacija može biti potpuno različita: od zakonodavne do urođene sklonosti programera prema eksperimentiranju.
No, to ne znači da se ne može računati na dodatnu korist. O čemu točno možete profitirati ako uvedete events-driven API na Kafki, objasnit će Sergej Zaika (). O promašenim pokušajima i zanimljivim otkrićima također će biti riječi – eksperimenti se ne mogu obaviti bez njih.
Izjava o odricanju: Ovaj članak temelji se na materijalima meetupa koji je Sergej održao u studenom 2018. godine na HighLoad++. Iskustvo Lamode u radu s Kafkom privuklo je slušatelje ne manje od drugih predavanja iz rasporeda. Smatramo da je to odličan primjer toga da uvijek možete i trebate pronaći istomišljenike, a organizatori HighLoad++ i dalje će se truditi stvoriti povoljnu atmosferu za to.
O procesu
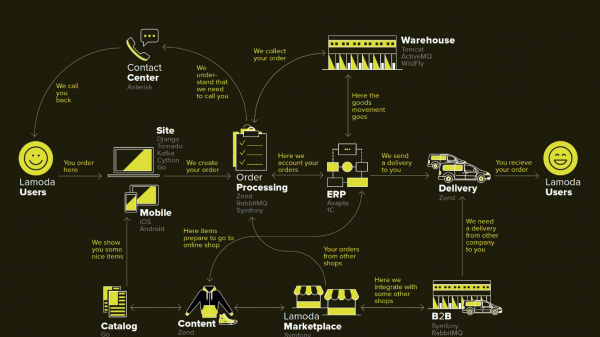
Lamoda je velika e-commerce platforma koja ima svoj kontakt-centar, službu dostave (i mnoštvo partnera), foto-studio, ogromno skladište, a sve to radi na vlastitom softveru. Postoji desetke načina plaćanja, b2b partneri koji mogu koristiti dio ili sve te usluge i žele znati aktuelne informacije o svojim proizvodima. Osim toga, Lamoda radi u tri zemlje osim Rusije, a poslovanje tamo je malo drugačije. Ukratko, postoji vjerovatno više od stotinu načina za konfiguriranje novog narudžbe koja se mora obraditi na specifičan način. Sve to radi uz pomoć desetaka servisa koji međusobno komuniciraju ponekad na nejasan način. Tu je i središnji sustav čija je glavna odgovornost status narudžbi. Mi ga nazivamo BOB, ja radim s njim.
Refund Tool with events-driven API
Izraz events-driven je prilično korišten, malo ćemo kasnije detaljnije definirati što to podrazumijeva. Započet ćemo s kontekstom u kojem smo odlučili isprobati pristup events-driven API-ju u Kafki.
U svakoj trgovini, osim narudžbi za koje kupci plaćaju, postoje trenuci kada se od trgovine traži povrat novca, jer proizvod nije odgovarao kupcu. Ovaj relativno kratak proces uključuje potvrdu informacija, ako je to potrebno, i vraćanje novca.
No, povrat se zakomplicirao zbog promjene zakonodavstva, pa smo morali implementirati zasebnu mikroservis za to.
Naša motivacija:
- Zakon FZ-54 — ukratko, zakon zahtijeva prijavu svake novčane transakcije poreznoj upravi, bilo da se radi o povratu ili uplati, unutar prilično kratkog SLA-a od nekoliko minuta. Kao e-commerce, provodimo prilično mnogo transakcija. Tehnički, to znači novu odgovornost (a time i nov servis) i prilagodbe u svim relevantnim sustavima.
- BOB split — unutarnji projekt tvrtke za oslobađanje BOB-a od velikog broja vanjskih odgovornosti i smanjenje njegove složenosti.
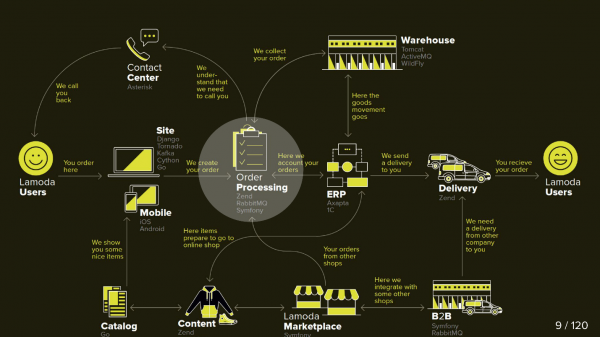
Na ovoj shemi prikazane su glavne sustave Lamoda. Trenutno većina njih više nalikuje konstelaciji od 5-10 mikroservisa oko smanjujuće monolitne strukture. Polako se povećavaju, ali nastojimo ih smanjiti jer je zastrašujuće rasporediti odvojen dio u sredini — ne smijemo dopustiti da padne. Sve razmjene (strelice) moramo rezervirati i pripremiti se za to da bilo koja od njih može biti nedostupna.
U BOB-u također postoji prilično mnogo razmjena: sustavi plaćanja, dostave, obavijesti itd.
Tehnički, BOB je:
- ~150k linija koda + ~100k linija testova;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 odlaznih integracija;
- 4 zemlje s vlastitom poslovnom logikom.
Raspoređivanje BOB-a skupo je i bolno, količina koda i zadataka koje on rješava takva je da nitko ne može shvatiti sve u cjelini. Uglavnom, ima mnogo razloga za njegovo pojednostavljenje.
Proces povrata
U procesu su prvotno uključena dva sustava: BOB i Payment. Sada se dodaju još dva:
- Fiscalization Service, koji će preuzeti probleme s fiskalizacijom i komunikaciju s vanjskim servisima.
- Refund Tool, u koji se jednostavno iznose nove razmjene, kako se ne bi preopteretio BOB.
Sada proces izgledaju ovako:
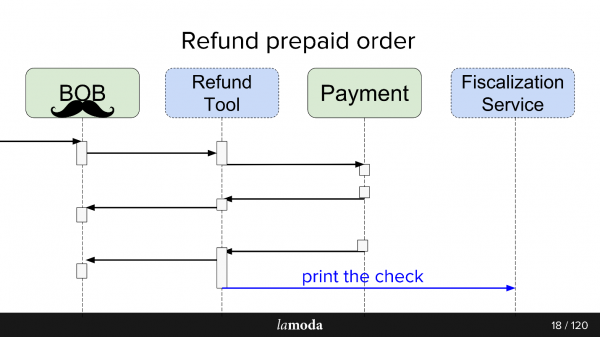
- BOB prima zahtjev za povrat novca.
- BOB o tome obavještava Refund Tool.
- Refund Tool govori Payment-u: 'Vrati novac.'
- Payment vraća novac.
- Refund Tool i BOB sinkroniziraju međusobne statuse, jer im je to trenutno potrebno. Još uvijek nismo spremni potpuno se prebaciti na Refund Tool, jer u BOB-u postoji UI, izvještaji za računovodstvo i općenito mnogo podataka koje nije lako prenijeti. Moramo sjediti na dva stolca.
- Odlazi zahtjev za fiskalizaciju.
Na kraju smo stvorili neku vrstu event-busa na temelju Kafke, na kojoj se sve temelji. Hura, sada imamo jedinstvenu točku kvara (sarcastično).
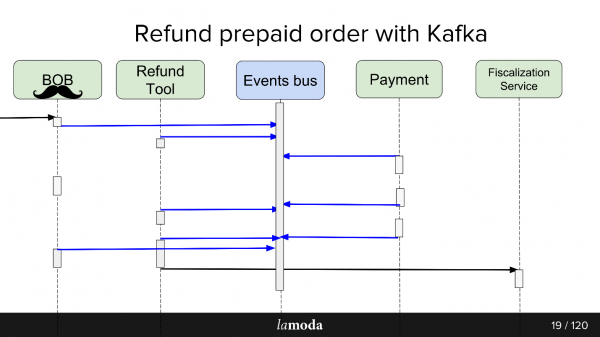
Prednosti i nedostaci su prilično očiti. Napravili smo bus, što znači da svi servisi ovise o njemu. To pojednostavljuje projektiranje, ali unosi jedinstvenu točku kvara u sustav. Ako Kafka padne, proces će stati.
Što je events-driven API
Dobar odgovor na ovo pitanje možete pronaći u izvještaju Martina Fowlersa (GOTO 2017) .
Ukratko, što smo napravili:
- Obavili smo sve asinkrone razmjene putem events storage. Umjesto da obavještavamo svakog zainteresiranog korisnika putem mreže o promjeni statusa, zapisujemo u centralizirano skladište događaj o promjeni stanja, a zainteresirani korisnici čitaju sve što se pojavljuje odatle.
- Događaj (event) u ovom slučaju je obavijest (notifications) o tome da se nešto negdje promijenilo. Na primjer, promijenio se status narudžbe. Korisnik kojem su važni neki pridruženi podaci k promjeni statusa koji nisu uključeni u obavijest, može sam provjeriti njihovo stanje.
- Maksimalna opcija je potpuni event sourcing, state transfer, pri čemu događaj sadrži sve informacije potrebne za obradu: odakle i u koji status su prešli, kako su se podaci promijenili i sl. Pitanje je samo opravdanost i količina informacija koje si možete priuštiti pohraniti.
U okviru pokretanja Refund Tool koristili smo treću opciju. To je pojednostavilo obradu događaja, budući da nije bilo potrebno prikupljati detaljne informacije, plus je isključilo scenarij kada svaka nova događaj uzrokuje val dodatnih get-zahtjeva od potrošača.
Servis Refund Tool nije opterećen, stoga je Kafka tu više probna nego potreba. Ne mislim da bi, da je servis za povrat sredstava postao highload projekt, poslovanje bilo zadovoljno.
Async exchange AS IS
Za asinkrone razmjene, PHP odjel obično koristi RabbitMQ. Prikupili smo podatke za zahtjev, stavili ih u red, a konzumator iste usluge ih je pročitao i poslao (ili nije poslao). Za API Lamoda aktivno koristi Swagger. Projektiramo API, opisujemo ga u Swaggeru, generiramo klijentski i serverski kod. Također koristimo malo prošireni JSON RPC 2.0.
Negdje se koriste esb-busi, netko koristi activeMQ, ali, u cjelini, RabbitMQ — standard.
Async exchange TO BE
Kada projektiramo razmjenu putem events-bus, uočava se analogija. Na sličan način opisujemo buduću razmjenu podataka kroz opise strukture event-a. Format yaml, programsku generaciju morali smo napraviti sami, generator prema specifikaciji stvara DTO i podučava klijente i servere kako s njima raditi. Generacija ide na dva jezika — golang i php. To omogućava da biblioteke budu usklađene. Generator je napisan u golangu, zbog čega nosi ime gogi.
Event-sourcing na Kafka je tipična stvar. Postoji rješenje iz glavne enterprise verzije Kafka Confluent, postoji , rješenje naših 'braće' iz domene Zalando. Naša motivacija da krenemo s vanilla Kafka je da ostavimo rješenje besplatnim, dok konačno ne odlučimo hoćemo li ga koristiti posvuda, a također da zadržimo prostora za manevre i dorade: želimo podršku za naš JSON RPC 2.0, generatore za dva jezika i vidjet ćemo što još.
Ironično je da čak i u tako sretnom slučaju, kada postoji otprilike sličan posao kao Zalando, koji je napravio otprilike slično rješenje, ne možemo ga učinkovito koristiti.
Arhitektonski je na pokretanju obrazac ovakav: čitamo direktno iz Kafka, ali zapisujemo samo putem events-bus. Za čitanje u Kafka postoji mnogo gotovog: brokeri, balansirnici i više-manje je spreman za horizontalno skaliranje, to smo htjeli zadržati. Zapis, međutim, željeli smo obaviti preko jednog Gateway-a, odnosno Events-busa, i to je razlog zašto.
Events-bus
Ili autobus događaja. To je jednostavno stateless http gateway koji preuzima nekoliko važnih uloga:
- Validacija produkcije provjeravamo da li događaji odgovaraju našoj specifikaciji.
- Master-sustav za događaje, dakle, to je glavni i jedini sustav u kompaniji koji odgovara na pitanje koji događaji s kojim strukturama smatraju valjanima. U validaciju ulaze samo tipovi podataka i enums za strogu specifikaciju sadržaja.
- Hash-funkcija za sharding — struktura poruka Kafka je key-value i na temelju hasha od key-a izračunava se gdje to staviti.
Zašto
Radimo u velikoj kompaniji s uhodanim procesom. Zašto mijenjati nešto? Ovo je eksperiment, i računate na nekoliko koristi.
1:n+1 razmjene (jedan prema mnogima)
S Kafka je vrlo jednostavno povezati nove potrošače na API.
Pretpostavimo da imate direktorij koji treba održavati ažurnim u nekoliko sustava odjednom (uključujući bilo koje nove). Prije smo izumili bundle koji je implementirao set-API, a glavnom sustavu smo javili adrese potrošača. Sada glavni sustav šalje ažuriranja u topic, a svi koji su zainteresirani ih čitaju. Pojavio se novi sustav – prijavili smo ga na topic. Da, također bundle, ali jednostavniji.
U slučaju refund-tool, koji je zapravo komadić BOB-a, praktično nam je da ih održavamo sinkroniziranima putem Kafke. Payment govori da su novci vraćeni: BOB, RT o tome saznaju, mijenjaju svoje statuse, a Fiscalization Service je obaviješten i izdao je račun.
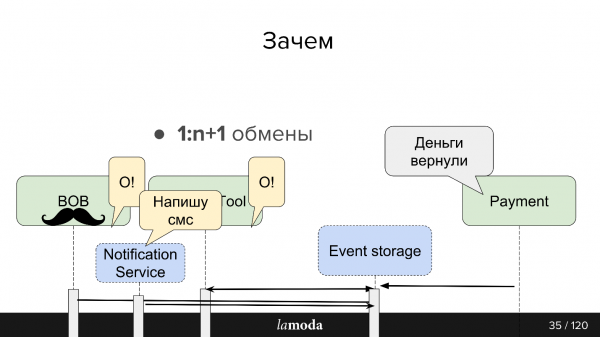
Planiramo uspostaviti jedinstvenu Notifications Service koja bi obavještavala klijente o novostima vezanima uz njihove narudžbe/ povratke. Trenutno je ta odgovornost raspodijeljena među sustavima. Bit će nam dovoljno naučiti Notifications Service da iz Kafke izdvaja relevantne informacije i reagira na njih (i isključiti ta obavještenja u ostalim sustavima). Nema potrebe za novim izravnim razmjenama.
Data-driven
Informacije između sustava postaju transparentne – bez obzira na to kakav 'krvavi enterprise' imate ili koliko debeo bio vaš backlog. U Lamodi postoji odjel Data Analytics koji prikuplja podatke iz sustava i dovodi ih u ponovno upotrebljiv oblik, kako za biznis, tako i za inteligentne sustave. Kafka omogućava brzo pružanje velikih količina podataka i održavanje tog informacijskog toka aktualnim.
Replication log
Poruke ne nestaju nakon čitanja, kao u RabbitMQ. Kada event sadrži dovoljno informacija za obradu, imamo povijest posljednjih promjena objekta i, po želji, mogućnost da te promjene primijenimo.
Rok čuvanja replication loga ovisi o intenzitetu unosa u ovaj topic, Kafka omogućava fleksibilno postavljanje granica za vrijeme čuvanja i po volumenu podataka. Za intenzivne topice važno je da svi potrošači stižu čitati informacije prije nego što nestanu, čak i u slučaju kratkotrajne neispravnosti. Obično je moguće čuvati podatke za jedinice dana, što je sasvim dovoljna za podršku.
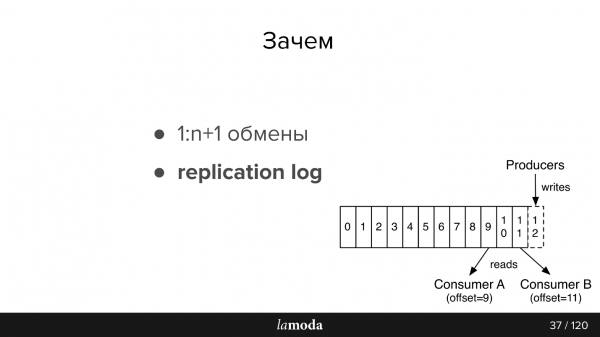
Dalje slijedi malo prepričavanje dokumentacije, za one koji nisu upoznati s Kafkom (slika je također iz dokumentacije)
U AMQP postoje redovi: pišemo poruke u red za konzumer. Obično jedan red obrađuje jedan sustav s istom poslovnom logikom. Ako treba obavijestiti nekoliko sustava, aplikaciju se može naučiti da piše u više redova ili se može postaviti exchange s fanout mehanizmom koji ih sam klonira.
U Kafka postoji slična apstrakcija topic, u koju pišete poruke, ali one ne nestaju nakon čitanja. Po defaultu, pri povezivanju na Kafka, dobivamo sve poruke, a postoji mogućnost da zadržite mjesto na kojem ste stali. Dakle, čitate sekvencijalno, ne morate označiti poruku kao pročitanu, ali možete zadržati id s kojeg ćete potom nastaviti čitanje. Id na kojem ste stali nazivamo offset (pomak), a mehanizam je commit offset.
Prema tome, može se realizirati različita logika. Na primjer, naš BOB postoji u 4 instance za različite zemlje - Lamoda postoji u Rusiji, Kazahstanu, Ukrajini, Bjelorusiji. Budući da se isporučuju odvojeno, oni imaju malo svoje konfiguracije i svoju poslovnu logiku. U poruci označavamo kojoj zemlji pripada. Svaki konzumer BOB u svakoj zemlji čita s različitim groupId, i, ako poruka nije vezana za njega, propušta je, tj. odmah komitira offset +1. Ako isti topic čita naš Payment Service, onda to radi s odvojenom grupom, pa se offseti ne preklapaju.
Zahtjevi za događajima:
- Potpunost podataka. Željeli bismo da u događaju bude dovoljno podataka za njegovu obradu.
- Cjelovitost. Delegiramo Events-bus provjeru da je događaj konzistentan i da ga može obraditi.
- Redoslijed je važan. U slučaju povrata, prisiljeni smo raditi s poviješću. S notifikacijama redoslijed nije važan, ako su to homogene notifikacije, email će biti isti neovisno o tome koji je narudžba stigla prva. U slučaju povrata postoji jasan proces, ako promijenimo redoslijed, nastat će iznimke, refund se neće stvoriti ili obraditi - dospjet ćemo u drugi status.
- Usaglašenost. Imamo skladište, i sada umjesto API-a kreiramo događaje. Trebamo način da brzo i jeftino proslijedimo informacije o novim događajima i promjenama u postojećima našim servisima. To se postiže zajedničkom specifikacijom u zasebnom git repozitoriju i generatorima koda. Zato su klijenti i serveri u različitim servisima usklađeni.
Kafka u Lamodi
Imamo tri instalacije Kafke:
- Zapisi;
- R&D;
- Events-bus.
Danas govorimo samo o posljednjem stavku. U events-bus imamo ne tako velike instalacije — 3 brokera (servera) i ukupno 27 tema. Obično, jedna tema je jedan proces. No, to je suptilna točka, i sada ćemo je dotaknuti.
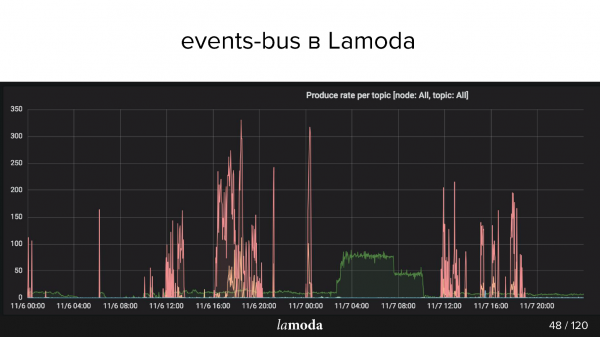
Gore je grafikon rps. Proces povrata označen je tirkiznom linijom (da, da, onom koja leži na osi X), a ružičastom — proces ažuriranja sadržaja.
Katalog Lamode sadrži milijune proizvoda, a podaci se neprekidno ažuriraju. Neke kolekcije izlaze iz mode, dok se nove lansiraju, u katalogu neprekidno se pojavljuju novi modeli. Pokušavamo predvidjeti što će biti zanimljivo našim klijentima sutra, stoga neprekidno nabavljamo nove stvari, fotografiramo ih i ažuriramo izloge.
Ružičasti vrhovi su ažuriranja proizvoda, što znači promjene u proizvodima. Vidljivo je da su dečki fotografirali, fotografirali, a onda bam! — učitali su hrpu događaja.
Upotreba Lamoda događaja
Izgrađenu arhitekturu koristimo za takve operacije:
- Praćenje statusa povrata: poziv na akciju i praćenje statusa svih uključenih sustava. Plaćanja, statusi, fiskalizacija, obavijesti. Ovdje smo isprobali pristup, napravili alate, prikupili sve bugove, napisali dokumentaciju i ispričali kolegama kako to koristiti.
- Ažuriranje kartica proizvoda: konfiguracija, meta-podaci, karakteristike. Čita jedan sustav (koji prikazuje), a pišu nekoliko.
- Email, push i sms: narudžba je prikupljena, narudžba je stigla, povratak prihvaćen itd., mnogo ih je.
- Zalihe, ažuriranje skladišta — kvantitativno ažuriranje naziva, samo brojevi: prijem na skladište, povrat. Potrebno je da svi sustavi povezani s rezervacijom proizvoda operiraju maksimalno ažuriranim podacima. Trenutno je sustav ažuriranja zaliha prilično složen, Kafka će ga pojednostaviti.
- Analiza podataka (R&D odjel), ML alati, analiza, statistika. Želimo da informacije budu transparentne - za to Kafka dobro odgovara.
Sada dolazi zanimljiviji dio o pogreškama i zanimljivim otkrićima koja su se dogodila u posljednjih pola godine.
Problemi dizajna
Recimo da želimo napraviti novu stvar - na primjer, prevesti cijeli proces dostave na Kafka. Trenutno se dio procesa provodi u Order Processing u BOB-u. Iza prijenosa narudžbe u dostavnu službu, premještanja u međuskladište i ostalog stoji statusni model. Postoji cijeli monolit, čak i dva, plus hrpa API-ja posvećenih dostavi. Oni znaju puno više o dostavi.
Čini se da su to slična područja, ali statuse za Order Processing u BOB-u i za sustav dostave se razlikuju. Na primjer, neke dostavne službe ne šalju međustatuse, nego samo konačne: 'isporučeno' ili 'izgubljeno'. Druge, naprotiv, vrlo detaljno izvještavaju o kretanju proizvoda. Svi imaju svoje vlastite pravila validacije: za nekoga je validna email adresa, pa će je obraditi; za druge nije validna, ali narudžba će se svejedno obraditi, jer postoji broj telefona za kontakt, a neki će reći da takvu narudžbu nećemo uopće obrađivati.
Tok podataka
U slučaju s Kafka postavlja se pitanje organizacije protoka podataka. Ovaj zadatak povezan je s izborom strategije po nekoliko točaka, proći ćemo kroz sve njih.
U jedan topic ili u različite?
Imamo specifikaciju događaja. U BOB-u pišemo da treba isporučiti određenu narudžbu, i navodimo: broj narudžbe, njen sadržaj, neke SKU i barkodove itd. Kada roba stigne u skladište, dostava može primiti statuse, timestamps i sve što je potrebno. No, dalje želimo u BOB-u primati ažuriranja o tim podacima. Pojavljuje se povratni proces dobivanja podataka iz dostave. Je li to isti događaj? Ili je to zasebna razmjena koja zaslužuje zasebni topic?
Vjerojatno će biti vrlo slični, i iskušenje da se napravi jedan topic nije bez osnove, jer zaseban topic donosi zasebne potrošače, zasebne konfiguracije, zasebnu generaciju svega toga. No, to nije isključeno.
Novo polje ili novi događaj?
No, ako koristimo iste događaje, javlja se drugi problem. Na primjer, ne mogu sve dostavne sustave generirati takav DTO koji može generirati BOB. Šaljemo im id, a oni ga ne čuvaju, jer im nije potreban, a s gledišta pokretanja procesa event-busa ovo polje je obavezno.
Ako postavimo pravilo za event-bus da je ovo polje obavezno, moramo u BOB ili u obradi početnog događaja postaviti dodatna pravila validacije. Validacija počinje da se širi po servisu - to nije baš praktično.
Još jedan problem je primamljivost inkrementalnog razvoja. Govore nam da je potrebno nešto dodati u događaj i, možda, ako dobro razmislimo, to je trebalo biti poseban događaj. No, u našoj shemi, poseban događaj je poseban topic. Poseban topic je cijeli taj proces koji sam opisao ranije. Razvijatelj biva primamljiv da jednostavno doda još jedno polje u JSON shemu i regenerira.
U slučaju refunds, tako smo za pola godine došli do događanja događaja. Imali smo jedno meta-događanje koje se zove refund update, u kojem je bilo polje type, koje opisuje o čemu se zapravo radi u ovom updateu. Iz toga smo imali "prekrasne" switcheve s validatorima koji su govorili kako treba validirati ovaj događaj s tim type.
Verzioniranje događaja
Za validaciju poruka u Kafka može se koristiti , ali to je trebalo odmah ugraditi i koristiti Confluent. U našem slučaju s verzioniranjem trebamo biti oprezni. Neće uvijek biti moguće pročitati poruke iz replication loga, jer je model "otišao". Uglavnom, pokušavamo graditi verzije tako da model bude unazad kompatibilan: na primjer, privremeno učiniti polje neobaveznim. Ako su razlike prevelike, počinjemo pisati u novi topic, a klijente prebacujemo kada pročitaju stari.
Jamstvo redoslijeda čitanja particija
Topici unutar Kafke su podijeljeni na particije. To nije jako važno dok projektiramo entitete i izmjene, ali je važno kada odlučujemo kako konzumirati i skalirati.
Uobičajeno pišete u Kafka jedan topic. Po zadanim postavkama koristi se jedan partition, i sve poruke tog topica dolaze u njega. A konzumatori odgovarajuće redom čitaju te poruke. Pretpostavimo da sada treba proširiti sustav tako da poruke čitaju dva različita konzumera. Ako, na primjer, šaljete SMS, možete reći Kafki da napravi dodatni partition, i Kafka će početi raspoređivati poruke na dva dijela – polovicu ovamo, polovicu onamo.
Kako Kafka dijeli? Svaka poruka ima tijelo (u kojem pohranjujemo JSON) i ključ. Na taj ključ može se primijeniti hash funkcija koja će odrediti u koji partition će poruka ući.
U našem slučaju s refundacijama to je važno; ako uzmemo dva partitiona, postoji mogućnost da paralelni konzumator obradi drugo događanje prije prvog i to bi moglo stvoriti probleme. Hash funkcija jamči da će poruke s istim ključem završiti u istom partitionu.
Događaji vs. naredbe
To je još jedan problem s kojim smo se susreli. Događaj je neka vrsta dešavanja: kažemo da se nešto negdje dogodilo (something_happened), na primjer, stavka je otkazana ili je došlo do refundacije. Ako netko sluša te događaje, tada će na osnovu "stavka je otkazana" biti stvoren entitet refundacije, dok će "došlo do refundacije" biti zabilježeno negdje u postavkama.
Ali obično, kada projektirate događaje, ne želite ih pisati uzalud - oslanjate se na to da će ih netko čitati. Velika je kušnja napisati ne something_happened (item_canceled, refund_refunded), već something_should_be_done. Na primjer, stavka je spremna za povrat.
S jedne strane, to sugerira kako će se događaj koristiti. S druge strane, to mnogo manje nalikuje na normalno ime događaja. Osim toga, ovdje je već blizu do naredbe do_something. No, nemate jamstvo da je taj događaj netko pročitao; a ako je pročitao, je li to učinio uspješno; a ako je to učinio uspješno, je li nešto učinio, i je li to nešto prošlo uspješno. U trenutku kada događaj postane do_something, potrebna je povratna informacija, i to je problem.
U asinkronoj razmjeni u RabbitMQ, kada pročitate poruku, otišli ste na http, imate odgovor - barem da je poruka prihvaćena. Kada zapisujete u Kafku, postoji poruka da ste zapisali u Kafku, ali o tome kako je obrađena, ne znate ništa.
Stoga smo u našem slučaju morali uvesti povratni događaj i postaviti nadgledanje da bi se osiguralo da, ako se dogodi određeni broj događaja, unutar određenog vremenskog perioda bi se trebalo dogoditi toliko povratnih događaja. Ako to ne prođe, izgleda da nešto nije u redu. Na primjer, ako smo poslali događaj „item_ready_to_refund“, očekujemo da se refundacija aktivira, kupcu se vrate novci, a nama se dogoditi događaj „money_refunded“. No, to nije sigurno, stoga je potrebno nadgledanje.
Detalji
Postoji prilično očit problem: ako čitate iz topic-a sljedećim redom, a imate neku lošu poruku, consumer se sruši i dalje ne možete nastaviti. Trebate zaustaviti sve consumere, potvrditi offset dalje kako biste mogli nastaviti s čitanjem.
O tome smo znali, uzeli smo to u obzir, a svejedno se to dogodilo. Dogodilo se to jer je događaj bio valjan s gledišta events-busa, događaj je bio valjan s gledišta validatora aplikacije, ali nije bio valjan s gledišta PostgreSQL-a, jer smo imali u jednom sustavu MySQL s UNSIGNED INT, a u novom sustavu bio je PostgreSQL samo s INT. Njegova veličina je malo manja, i Id se nije mogao smjestiti. Symfony je umro s iznimkom. Naravno, uhvatili smo iznimku jer smo to predvidjeli i planirali smo potvrditi taj offset, ali prije toga smo htjeli inkrementirati brojač problema, budući da je poruka neuspješno obrađena. Brojači u ovom projektu također se nalaze u bazi, a Symfony je već zatvorio komunikaciju s bazom, i druga iznimka je ubila cijeli proces bez šanse za potvrdu offseta.
Neko vrijeme je servis ležao – srećom, s Kafka to nije tako strašno, jer poruke ostaju. Kada se rad ponovno uspostavi, može ih se pročitati. To je praktično.
Kafka ima mogućnost putem alata postaviti proizvoljni offset. No, da biste to učinili, morate zaustaviti sve consumere – u našem slučaju pripremiti poseban release u kojem neće biti consumera, redeployments. Tada se u Kafki putem alata može pomaknuti offset, i poruka će proći.
Drugi detalj – replication log vs rdkafka.so — vezano uz specifičnosti našeg projekta. Mi koristimo PHP, a u PHP-u, kao pravilo, sve biblioteke komuniciraju s Kafka putem repozitorija rdkafka.so, a dalje ide neka vrsta omotnika. Možda su to naši osobni problemi, ali ispostavilo se da jednostavno pročitati deo onoga što je već pročitano nije tako lako. Uglavnom, bilo je programskih problema.
Vraćajući se na osobitosti rada s partitions, direktno u dokumentaciji piše consumers >= topic partitions. Ali saznao sam o tome mnogo kasnije nego što bih želeo. Ako želite skalirati i imati dva konzumer, trebate barem dva partitions. To jest, ako imate jedan partition u kojem je skupljeno 20 tisuća poruka, i napravili ste novi, broj poruka neće se izjednačiti brzo. Stoga, da biste imali dva paralelna konzumer, morate se pozabaviti partitions.
Monitoring
Mislim, prema tome kako nadgledamo, bit će još jasnije koje probleme imamo u postojećem pristupu.
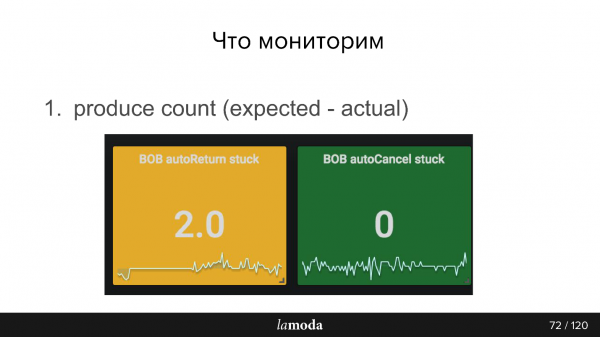
Na primjer, brojimo koliko je proizvoda u bazi nedavno promenilo status, i u skladu s tim bi se po tim promenama trebali dogoditi događaji, i šaljemo taj broj u naš sustav za nadgledanje. Zatim iz Kafke primamo drugi broj, koliko je zapravo događaja zabilježeno. Očito, razlika između ta dva broja uvijek treba biti nula.
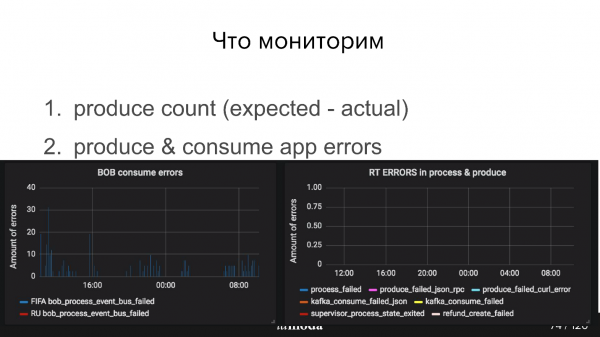
Osim toga, potrebno je nadgledati kako stoji producent, da li je events-bus primio poruke, i kako stoji konzumer. Na primjer, na grafikonu ispod, Refund Tool je u dobrom stanju, dok kod BOB-a očigledno postoje neki problemi (plavi vrhovi).
Već sam spomenuo consumer-group lag. Grubo rečeno, to je broj nepročitanih poruka. Uglavnom, naši konzumeri rade brzo, tako da je lag obično 0, ali ponekad može biti kratkotrajan vrh. Kafka to podržava iz kutije, ali treba postaviti neki interval.
Postoji projekt , koji će vam pružiti više informacija o Kafki. On jednostavno putem API-a za consumer-group pruža status, kako ide toj grupi. Osim OK i Failed, tu su i upozorenja, i možete saznati da vaši konzumeri ne uspevaju pratiti tempo produkcije — nemaju vremena da pročitaju ono što se piše. Sustav je prilično pametan, lako je koristiti.
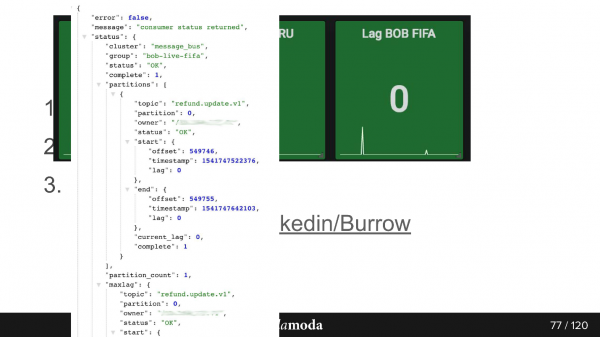
Ovako izgleda odgovor putem API-a. Ovdje je grupa bob-live-fifa, partition refund.update.v1, status OK, lag 0 — posljednji krajni offset je takav.
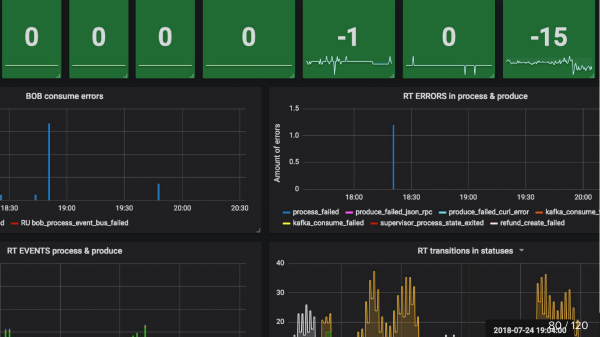
Monitoring updated_at SLA (zaključan) Već sam spomenuo. Na primjer, proizvod je prešao u status da je spreman za povrat. Postavljamo Cron koji govori da ako u 5 minuta ta stavka ne pređe u refund (novac vraćamo putem platnih sustava vrlo brzo), onda nešto zasigurno nije u redu, i to je definitivno slučaj za podršku. Stoga jednostavno uzimamo Cron koji čita takve stvari, i ako ih ima više od 0, šalje upozorenje.
Ukratko, korištenje događaja je praktično kada:
- informacija treba više sustavima;
- rezultat obrade nije važan;
- ima malo događaja ili su događaji mali.
Naizgled, članak ima vrlo specifičnu temu - asinkroni API na Kafki, ali u vezi s tim odmah bih preporučio mnogo toga.
Prvo, sljedeće ne treba čekati do studenog, već u travnju će biti njegova verzija u St. Petersburgu, a u lipnju ćemo razgovarati o visokim opterećenjima u Novosibirsku.
Drugo, autor izlaganja Sergej Zaika je član Programskog odbora naše nove konferencije o upravljanju znanjem. Konferencija je jednodnevna, održat će se 26. travnja, ali program će biti vrlo bogat.
A također će u svibnju biti i (s DevOpsConf u sastavu) - tamo se još može predložiti vlastita tema, ispričati svoje iskustvo i požaliti se na svoje nakupljene neugodnosti.
Izvor: habr.com
