

Uvod
 „Treba trčati svim snagama samo da bismo ostali na istom mestu,
a da bismo stigli negde, treba trčati barem dvostruko brže!“
(c) Alisa u Zemlji Čuda
Nedavno su me zamolili da održim predavanje analitičarima naših kompanija o dizajnu modela podataka, jer dugo godina provodimo na projektima (ponekad i po nekoliko godina) i tako propuštamo da primetimo šta se događa u svetu IT tehnologija. U našoj kompaniji (tako je ispalo) u mnogim projektima se ne koriste NoSQL baze podataka (bar za sada), tako da sam u svom predavanju posebno posvetio pažnju njima kroz primer HBase i pokušao prilagoditi sadržaj onima koji nikada nisu radili s njima. Konkretno, ilustrovao sam neke aspekte dizajna modela podataka koristeći primer koji sam pročitao . Analizirajući primere, upoređivao sam nekoliko rešenja za isti problem kako bih bolje prenio osnovne ideje slušateljima.
Nedavno, „iz dosade“, postavio sam pitanje (dugi praznici u maju u režimu karantene pogoduju tome), koliko će se teorijske pretpostavke poklapati s praksom? U stvarnosti, tako je i proizašla ideja za ovaj članak. Programer koji se već neko vreme bavi NoSQL-om možda neće saznati ništa novo iz njega (i stoga može odmah preskočiti polovinu članka). Ali za analitičare, koji još nisu radili intenzivno s NoSQL-om, mislim da će im biti korisno za sticanje osnovnih saznanja o karakteristikama dizajna modela podataka za HBase.
Analiza primera
Po mom mišljenju, prije nego što počnemo koristiti NoSQL baze podataka, potrebno je dobro razmisliti i procijeniti "za" i "protiv". Često se zadatak može riješiti i na tradicionalnim relacijskim DBMS-ima. Stoga je bolje ne koristiti NoSQL bez značajnog razloga. Ako se ipak donese odluka o korištenju NoSQL baze podataka, treba uzeti u obzir da se pristupi dizajnu ovdje malo razlikuju. Osobito neki od njih mogu biti nesvakidašnji onima koji su do sada radili samo s relacijskim DBMS-ima (prema mojim zapažanjima). Tako, u "relacijskom" svijetu obično počinjemo od modeliranja predmetnog područja, a zatim, ako je potrebno, provodimo denormalizaciju modela. U NoSQL-u, međutim, odmah moramo uzeti u obzir predviđene scenarije rada s podacima i izvorno denormalizirati podatke. Osim toga, postoje i druge razlike o kojima će biti riječi u nastavku.
Razmotrimo sljedeći "sintetički" zadatak, s kojim ćemo se kasnije baviti:
Potrebno je dizajnirati strukturu za pohranu popisa prijatelja korisnika neke abstraktne socijalne mreže. Radi pojednostavljenja, pretpostavit ćemo da su svi odnosi usmjereni (kao na Instagramu, a ne na LinkedInu). Struktura bi trebala omogućiti učinkovito:
- Odgovarati na pitanje, čita li korisnik A korisnika B (predložak čitanja)
- Omogućiti dodavanje/uklanjanje odnosa u slučaju pretplate/odabira korisnika A od korisnika B (predložak promjene podataka)
Naravno, postoji mnogo opcija za rješavanje zadatka. U običnoj relacijskoj bazi podataka vjerojatno bismo jednostavno napravili tablicu odnosa (moguće tipiziranu, ako, na primjer, treba pohranjivati korisničku grupu: obitelj, posao itd., u koju spada ovaj "prijatelj"), a za optimizaciju brzine pristupa dodali bismo indekse/parcijoniranje. Vjerojatno bi konačna tablica izgledala otprilike ovako:
user_id
friend_id
Vasja
Petja
Vasja
Olja
ovdje i dalje za veću preglednost i bolje razumijevanje umjesto ID-a ću navesti imena
U slučaju HBase-a znamo da:
- učinkovito pretraživanje, koje ne dovodi do puni pregled tablice, moguće je isključivo prema ključi
- Upravo zato pisanje uobičajenih SQL upita za ovakve baze je loša ideja; tehnički, naravno, možete iz Impale poslati SQL upit sa spojnicama i drugom logikom u HBase, ali koliko će to biti efikasno…
Zato moramo koristiti ID korisnika kao ključ. A prva pomisao o tome "gdje i kako pohraniti ID prijatelja?" može biti ideja o pohrani u stupcima. Ova najočiglednija i 'naivna' opcija izgledat će otprilike ovako (nazovimo je Opcija 1 (default), kako bismo se na njenu osnovu mogli dalje referirati):
RowKey
Stupci
Vasja
1: Petar
2: Olinka
3: Dasha
Petja
1: Maša
2: Vasa
Ovdje svaka redak odgovara jednom korisniku mreže. Stupci imaju imena: 1, 2, … — prema broju prijatelja, a u stupcima se čuvaju ID-ovi prijatelja. Važno je napomenuti da će svaka redak imati različit broj stupaca. U primjeru na gornjoj slici jedan redak ima tri stupca (1, 2 i 3), dok drugi ima samo dva (1 i 2) – ovdje smo iskoristili dva svojstva HBase-a koja ne postoje u relacijskim DB-ovima:
- mogućnost dinamičkog mijenjanja sastava stupaca (dodavanjem prijatelja dodajemo stupac, brisanjem prijatelja brišemo stupac)
- različiti sastav stupaca može biti kod različitih redaka
Provjerimo našu strukturu u odnosu na zahtjeve zadatka:
- Čitanje podataka: da bismo shvatili je li Vasa pretplaćen na Olinku, morat ćemo pročitati cijeli redak po ključu RowKey = 'Vasa' i prolaziti kroz vrijednosti stupaca dok ne 'susretne' Olinku. Ili proći kroz vrijednosti svih stupaca, 'ne susresti' Olinku i vratiti odgovor False;
- Promjena podataka: dodavanje prijatelja: za sličan zadatak također ćemo morati pročitati cijeli redak po ključu RowKey = 'Vasa', kako bismo izračunali ukupan broj njegovih prijatelja. Ovaj ukupan broj prijatelja nam je potreban kako bismo odredili broj stupca u koji treba zapisati ID novog prijatelja.
- Promjena podataka: brisanje prijatelja:
- Moramo pročitati cijeli redak po ključu RowKey = 'Vasa' i pregledati stupce kako bismo pronašli onaj u kojem se nalazi izbrisani prijatelj;
- Nakon brisanja prijatelja, trebamo 'pomaknuti' sve podatke za jedan stupac kako bismo izbjegli 'rascjep' u njihovu numeraciji.
Sada procijenimo koliko će podaci algoritmi koje ćemo morati implementirati na strani 'uvjetne aplikacije' biti produktivni, koristeći Označit ćemo veličinu naše hipotetske društvene mreže kao n. Tada maksimalan broj prijatelja jednog korisnika može biti (n-1). Ovu (-1) možemo zanemariti za naše potrebe, jer u okviru korištenja O-simbolike nije bitna.
- Čitanje podataka: potrebno je očitati cijeli redak i pregledati u granicama sve njegove stupce. Stoga će gornja procjena troškova biti otprilike O(n)
- Promjena podataka: dodavanje prijatelja: za određivanje broja prijatelja potrebno je pregledati sve stupce retka, nakon čega se umetne novi stupac => O(n)
- Promjena podataka: brisanje prijatelja:
- Slično dodavanju - potrebno je u granicama pregledati sve stupce => O(n)
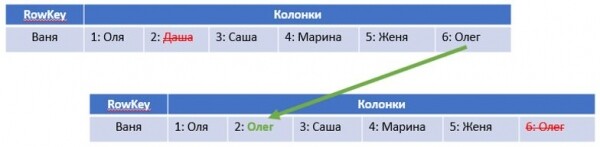
- Nakon brisanja stupaca moramo ih "pomaknuti". Ako to ostvarujemo "doslovno", u granicama će biti potrebno još do (n-1) operacija. No, ovdje i dalje u praktičnom dijelu primijenit ćemo drugi pristup, koji će provesti "pseudo-pomičenje" za fiksni broj operacija - to jest, trošit će konstantno vrijeme neovisno o n. Ovo konstantno vrijeme (točnije, O(2)) u usporedbi s O(n) može se zanemariti. Pristup je ilustriran na slici ispod: jednostavno kopiramo podatke iz "zadnjeg" stupca u onaj iz kojeg treba ukloniti podatke, nakon čega brišemo zadnji stupac:

Dakle, u svim scenarijima dobili smo asimptotsku računalnu složenost O(n).
Vjerojatno ste već primijetili da gotovo uvijek moramo očitati cijeli redak iz baze, i to u dva od tri slučaja samo da bismo pregledali sve stupce i izračunali ukupni broj prijatelja. Stoga, kao pokušaj optimizacije, možemo dodati stupac "count", u kojem će se čuvati ukupni broj prijatelja svakog korisnika mreže. U tom slučaju ne moramo očitati cijeli redak za izračun ukupnog broja prijatelja, već samo jedan stupac "count". Najvažnije je ne zaboraviti ažurirati "count" prilikom manipulacije podacima. Time dobivamo poboljšani Opcija 2 (count):
RowKey
Stupci
Vasja
1: Petar
2: Olinka
3: Dasha
count: 3
Petja
1: Maša
2: Vasa
count: 2
U usporedbi s prvom opcijom:
- Čitanje podataka: za dobivanje odgovora na pitanje "Čita li Vasja Olju?" ništa se nije promijenilo => O(n)
- Promjena podataka: dodavanje prijatelja: P pojednostavili smo umetanje novog prijatelja, jer sada ne moramo pretraživati cijeli redak i prolaziti kroz njegove stupce, nego možemo dobiti samo vrijednost stupca „count“ i tako odmah odrediti broj stupca za umetanje novog prijatelja. To smanjuje računalnu složenost na O(1)
- Promjena podataka: brisanje prijatelja: Prilikom brisanja prijatelja možemo također iskoristiti ovaj stupac kako bismo smanjili broj ulazno-izlaznih operacija prilikom „pomicanja“ podataka lijevo za jednu ćeliju. Međutim, potreba za pretraživanjem stupaca kako bismo pronašli onaj koji treba ukloniti još uvijek ostaje, stoga => O(n)
- S druge strane, sada moramo svaki put ažurirati i stupac „count“ prilikom ažuriranja podataka, ali to traje konstantno vrijeme koje se može zanemariti u okviru O-notacije
Sveukupno, opcija 2 se čini malo optimiziranijom, ali to je više „evolucija umjesto revolucije“. Za provođenje „revolucije“ bit će nam potrebna Opcija 3 (col).
Okrenimo sve „natrag na glavu“: postavimo ime stupca kao identifikator korisnika! Ono što će biti zapisano u samom stupcu – za nas više nije važno, neka bude broj 1 (općenito, iz korisnog se može čuvati, na primjer, grupa „obitelj/prijatelji/itd.“). Ovaj pristup može iznenaditi nepripremljenog „prolaznika“, koji do sada nije imao iskustva s NoSQL bazama podataka, ali upravo on omogućuje korištenje potencijala HBase u ovom zadatku mnogo učinkovitije:
RowKey
Stupci
Vasja
Petar: 1
Ola: 1
Daša: 1
Petja
Maša: 1
Vanja: 1
Ovdje dobivamo nekoliko prednosti. Da bismo ih razumjeli, analizirajmo novu strukturu i procijenimo računalnu složenost:
- Čitanje podataka: da bismo odgovorili na pitanje je li Vanja pretplaćen na Olu, dovoljno je pročitati jedan stupac „Ola“: ako postoji, odgovor je True, ako ne – False => O(1)
- Promjena podataka: dodavanje prijatelja: Dodavanje prijatelja: dovoljno je samo dodati novi stupac „ID prijatelja“ => O(1)
- Promjena podataka: brisanje prijatelja: dovoljno je samo ukloniti stupac „ID prijatelja“ => O(1)
Kako vidimo, značajna prednost ovog modela pohrane je ta što u svim potrebnim scenarijima radimo samo s jednim stupcem, izbjegavajući pretraživanje cijelog retka iz baze i pogotovo prolazak kroz sve stupce tog retka. Na tome bismo mogli stati, ali…
Možete se osvrnuti i otići još malo dalje na putu optimizacije performansi i smanjenja operacija ulaza-izlaza prilikom pristupa bazi. Što ako bismo punu informaciju o vezi čuvali direktno u ključnoj stringu? To jest, da ključ bude sastavljen, poput userID.friendID? U tom slučaju, ne bismo uopće morali čitati kolone stringa (Opcija 4 (row)):
RowKey
Stupci
Vasja.Petja
Petar: 1
Vasja.Olga
Ola: 1
Vasja.Daša
Daša: 1
Petja.Maša
Maša: 1
Petja.Vasja
Vanja: 1
Očigledno je da će procjena svih scenarija manipulacije podacima u ovoj strukturi, kao i u prethodnoj opciji, biti O(1). Razlika u odnosu na opciju 3 će biti isključivo u efikasnosti operacija ulaza-izlaza u Bazi podataka.
I na kraju, 'mašna'. Lako je primijetiti da u opciji 4 naš ključ stringa ima promjenjivu dužinu, što možda može utjecati na performanse (ovdje se sjećamo da HBase pohranjuje podatke kao skup bajtova i da su stringovi u tablicama sortirani prema ključu). Osim toga, imamo razdjelnik koji se u nekim scenarijima možda treba obraditi. Da bismo isključili ovaj utjecaj, možemo koristiti heševe od userID i friendID, a budući da će oba heša imati konstantnu dužinu, možemo ih jednostavno konkatirati bez razdjelnika. Tada će podaci u tablici izgledati ovako (Opcija 5 (hash)):
RowKey
Stupci
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petar: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Ola: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Daša: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Maša: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vanja: 1
Očigledno je da će algoritamska složenost rada s ovom strukturom u razmatranim scenarijima biti ista kao i kod opcije 4 – dakle O(1).
U konačnici, sažet ćemo sve naše procjene računske složenosti u jednu tablicu:
Dodavanje prijatelja
Provjera prijatelja
Brisanje prijatelja
Opcija 1 (default)
O(n)
O(n)
O(n)
Opcija 2 (count)
O(1)
O(n)
O(n)
Opcija 3 (column)
O(1)
O(1)
O(1)
Opcija 4 (row)
O(1)
O(1)
O(1)
Opcija 5 (hash)
O(1)
O(1)
O(1)
Kao što se može vidjeti, opcije 3-5 izgledaju najpoželjnije i teoretski osiguravaju izvršenje svih potrebnih scenarija obrade podataka u konstantnom vremenu. U uvjetima našeg zadatka ne postoji eksplicitni zahtjev za dobivanje popisa svih prijatelja korisnika, no u stvarnom projektnom radu, kao dobri analitičari, bilo bi dobro "predvidjeti" da bi se takav zadatak mogao pojaviti i "pripremiti" se za njega. Stoga su moje simpatije na strani opcije 3. No, sasvim je moguće da je u stvarnom projektu taj zahtjev već riješen s drugim sredstvima, pa bez cjelokupnog pregleda svih zadataka bolje je ne donositi konačne zaključke.
Priprema eksperimenta
Željeli bismo praktično provjeriti iznesene teoretske rasprave – to je i bio cilj koji se pojavio tijekom dugog vikenda. Za to je potrebno procijeniti brzinu rada našeg "uvjetnog aplikacija" u svim opisanim scenarijima korištenja baze, kao i rast tog vremena s rastom veličine društvene mreže (n). Ciljna varijabla koja nas zanima i koju ćemo mjeriti tijekom eksperimenta je vrijeme koje je potrebno "uvjetnoj aplikaciji" za izvršavanje jedne "poslovne operacije". Pod "poslovnom operacijom" razumijemo jednu od sljedećih:
- Dodavanje jednog novog prijatelja
- Provjera je li korisnik A prijatelj korisnika B
- Brisanje jednog prijatelja
Stoga, uzimajući u obzir zahtjeve navedene u prvotnoj formulaciji, scenarij provjere izgleda ovako:
- Zapisivanje podataka. Generirati nasumičnu izvoru mrežu veličine n. Kako bismo se više približili "stvarnom svijetu", broj prijatelja svakog korisnika bit će također nasumična veličina. Mjeriti vrijeme koje je potrebno našem "uvjetnom aplikaciji" da zapiše sve generirane podatke u HBase. Zatim dobiveno vrijeme podijeliti s ukupnim brojem dodanih prijatelja – na taj način ćemo dobiti prosječno vrijeme za jednu "poslovnu operaciju".
- Čitanje podataka. Za svakog korisnika sastaviti popis "ličnosti" za koje treba saznati je li korisnik na njih prijavljen ili ne. Duljina popisa = otprilike broj prijatelja korisnika, pri čemu bi za polovicu provjerenih prijatelja odgovor trebao biti "Da", a za drugu polovicu – "Ne". Provjera se provodi tako da se odgovori "Da" i "Ne" smjenjuju (tj. u svakom drugom slučaju morat ćemo pretraživati sve kolone reda za varijante 1 i 2). Ukupno vrijeme provjere zatim se dijeli s brojem provjerenih prijatelja radi dobivanja prosječnog vremena provjere jednog subjekta.
- Brisanje podataka. Ukloniti sve prijatelje korisnika. Pri tome redoslijed brisanja – nasumičan (tj. "promiješati" izvorni popis korišten za upis podataka). Ukupno vrijeme provjere zatim se dijeli s brojem uklonjenih prijatelja radi dobivanja prosječnog vremena za jednu provjeru.
Scenariji se moraju provesti za svaku od 5 opcija modela podataka i za različite veličine društvene mreže kako bi se vidjelo kako se vrijeme mijenja s njenim rastom. Unutar jednog n veze u mreži, popis korisnika za provjeru trebao bi biti, naravno, isti za svih 5 opcija.
Za bolje razumijevanje, u nastavku navodim primjer generiranih podataka za n= 5. Napisan "generator" daje tri rječnika ID-eva kao izlaz:
- prvi – za umetanje
- drugi – za provjeru
- treći – za brisanje
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # ukupno 15 prijatelja

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # ukupno 18 provjerenih subjekata

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # ukupno 15 prijatelja
Kao što se može primijetiti, svi ID-evi veći od 10 000 u rječniku za provjeru su upravo oni koji će dati odgovor False. Umetanje, provjera i brisanje "prijatelja" provode se točno u redoslijedu navedenom u rječniku.
Eksperiment je proveden na prijenosnom računalu s operativnim sustavom Windows 10, gdje je u jednom Docker kontejneru pokrenuta baza podataka HBase, a u drugom – Python s Jupyter Notebookom. Dockeru su dodijeljena 2 CPU jezgre i 2 GB RAM-a. Sva logika, kao i emulacije rada "uvjetne aplikacije", i "vezivanje" za generiranje testnih podataka i mjerenje vremena napisane su na Pythonu. Za rad s HBase korištena je biblioteka , za izračunavanje heš vrijednosti (MD5) za varijantu 5 — hashlib
Uzimajući u obzir računalnu snagu određenog prijenosnog računala, eksperimentalno je odabran pokretanje za n = 10, 30, …. 170 – kada je ukupno vrijeme trajanja cijelog ciklusa testiranja (svi scenariji za sve varijante za sve n) još uvijek bilo više-manje razmjerno razumljivo i stalo u vrijeme jedne čajne pauze (u prosjeku 15 minuta).
Ovdje treba napomenuti da u ovom eksperimentu prvenstveno ne ocjenjujemo apsolutne brojke performansi. Čak i relativno usporedba dva različita varijante može biti prilično netočna. Trenutačno nas zanima upravo karakter promjene vremena u ovisnosti o n, jer s obzirom na navedenu konfiguraciju „testne platforme“ dobivanje vremenskih procjena „očistiti“ od utjecaja slučajnih i drugih faktora je vrlo teško (a ni taj zadatak nije postavljen).
Rezultat eksperimenta
Prvi test – kako se mijenja vrijeme potrebno za ispunjavanje popisa prijatelja. Rezultat – u grafikonu ispod.
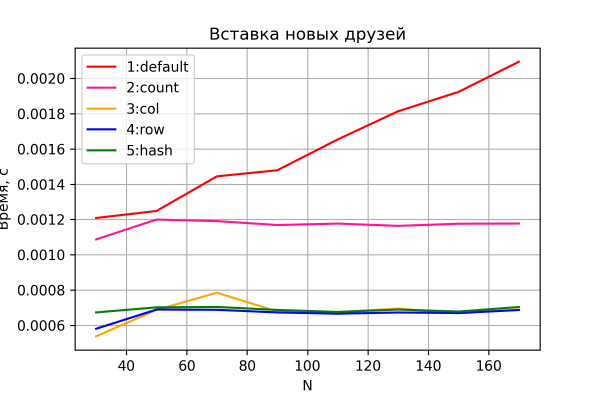
Varijante 3-5 očekivano pokazuju praktički konstantno vrijeme „poslovne operacije“, koje ne ovisi o rastu veličine mreže i neprimjetne razlike u performansama.
Varijanta 2 također pokazuje konstantne, ali nešto lošije performanse, pri čemu je praktički točno 2 puta lošija u odnosu na varijante 3-5. To ne može ne obradovati, jer se odnosi na teoriju – u ovoj varijanti broj ulazno-izlaznih operacija u/iz HBase je zapravo 2 puta veći. To može poslužiti kao neizravni dokaz da naš testni sustav u načelu daje dobru točnost.
Varijanta 1 također se očekivano pokazuje kao najsporija i pokazuje linearni rast vremena, potrebnog za dodavanje jednog prijatelja, u odnosu na veličinu mreže.
Pogledajmo sada rezultate drugog testa.
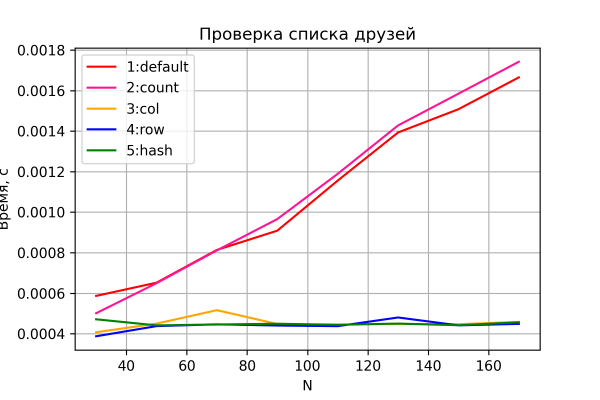
Opcije 3-5 ponovno se ponašaju očekivano – konstantno vrijeme, neovisno o veličini mreže. Opcije 1 i 2 pokazuju linearni porast vremena s povećanjem veličine mreže i slične performanse. Štoviše, opcija 2 se pokazuje malo sporijom – očito zbog potrebe za čitanjem i obradom dodatne kolone "count", što postaje uočljivije s povećanjem n. Ipak, suzdržat ću se od ikakvih zaključaka, jer je točnost ovog usporedbe relativno niska. Osim toga, odnosi ovih opcija (koja opcija, 1 ili 2, je brža) su se mijenjali od pokretanja do pokretanja (uz zadržavanje karaktera zavisnosti i "idući rame uz rame").
I posljednji grafikon – rezultat testiranja brisanja.
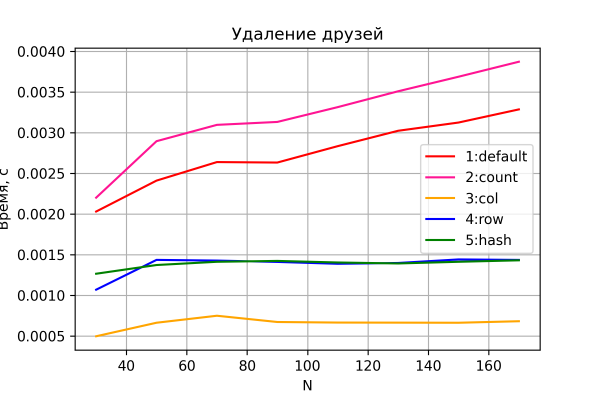
Evo opet bez iznenađenja. Opcije 3-5 izvršavaju brisanje za konstantno vrijeme.
Štoviše, što je zanimljivo, opcije 4 i 5, za razliku od prethodnih scenarija, pokazuju primjetno nešto slabije performanse u odnosu na opciju 3. Očito je da je operacija brisanja reda - skuplja nego operacija brisanja kolone, što je u cjelini logično.
Opcije 1 i 2, očekivano, pokazuju linearni porast vremena. Pri tome je opcija 2 dosljedno sporija od opcije 1 - zbog dodatne ulazno-izlazne operacije za "održavanje" kolone count.
Opći zaključci eksperimenta:
- Opcije 3-5 pokazuju veću učinkovitost, jer koriste prednosti HBase; pri čemu se njihova performansa razlikuje jedna u odnosu na drugu za konstantu i ne ovisi o veličini mreže.
- Razlika između opcija 4 i 5 nije zabilježena. No to ne znači da se opcija 5 ne bi trebala koristiti. Sasvim je moguće da korišteni scenarij eksperimenta uzimajući u obzir TTX testne platforme nije dopustio njeno otkrivanje.
- Karakter rasta vremena potrebnog za izvršavanje "poslovnih operacija" s podacima u cjelini je potvrdio ranije dobivene teorijske pretpostavke za sve opcije.
Epilog
Provedene grube eksperimente ne treba smatrati apsolutnom istinom. Postoji mnogo čimbenika koji nisu uzeti u obzir i koji su iskrivili rezultate (ti su fluktuacije posebno vidljive na grafikonima pri maloj veličini mreže). Na primjer, brzina rada thrift-a, koji se koristi u happybase-u, obujam i način implementacije logike koja je napisana na Pythonu (ne mogu tvrditi da je kod napisan optimalno i da je efikasno iskorištavao mogućnosti svih komponenti), moguće osobitosti keširanja HBase-a, pozadinska aktivnost Windows 10 na mom laptopu i slično. U načelu se može smatrati da su sve teoretske teze eksperimentalno pokazale svoju održivost. Ili, barem, nije bilo moguće opovrgnuti ih na takav „sudarski“ način.
Na kraju — preporuke svima koji tek počinju dizajnirati modele podataka u HBase-u: apstrahirajte se od prethodnog iskustva rada s relacijskim bazama i zapamtite „zapovijedi“:
- Pri dizajniranju, polazimo od zadatka i obrazaca manipulacije podacima, a ne od modela predmetne oblasti
- Efikasan pristup (bez full table scan) – samo po ključu
- Denormalizacija
- Različiti redovi mogu sadržavati različite kolone
- Dinamički sastav kolona
Izvor: habr.com
