

Prije nekoliko godina, Kubernetes u službenom GitHub blogu. Od tada je postao standardna tehnologija za implementaciju usluga. Sada Kubernetes upravlja značajnim dijelom internih i javnih servisa. Kako su naši klasteri rasli, a zahtjevi za performansama postali stroži, počeli smo primjećivati da u nekim uslugama na Kubernetesu povremeno dolazi do latencija koja se ne može objasniti opterećenjem samog aplikacije.
U suštini, u aplikacijama se događa neka vrst nasumične mrežne latencije od 100 ms i više, što dovodi do timeout-a ili ponovljenih pokušaja. Očekivalo se da će usluge moći odgovoriti na zahtjeve mnogo brže od 100 ms. No, to je nemoguće ako samo povezivanje uzima toliko vremena. Pojedinačno smo primijetili vrlo brze zahtjeve prema MySQL-u, koji bi trebali trajati milisekunde, i MySQL je zaista ispunjavao u milisekundama, ali s gledišta aplikacije koja šalje zahtjev, odgovor je trajao 100 ms ili više.
Odmah je postalo jasno da problem nastaje samo pri povezivanju s Kubernetes čvorom, čak i kada poziv dolazi izvana iz Kubernetes-a. Najlakše je reproducirati problem u testu , koji se pokreće s bilo kojeg internog hosta, testira Kubernetes uslugu na određenoj luci, i povremeno bilježi velike latencije. U ovom članku ćemo razmotriti kako smo uspjeli pratiti uzrok ovog problema.
Smanjujemo suvišnu složenost u lancu do kvara
Reprodukcijom istog primjera, željeli smo suziti fokus problema i ukloniti suvišne slojeve složenosti. Prvobitno je bilo previše elemenata u toku između Vegeta i podova na Kubernetesu. Da bismo otkrili dublji mrežni problem, potrebno je isključiti neke od njih.
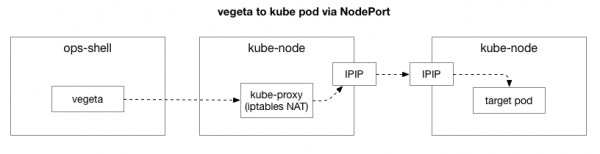
Klijent (Vegeta) uspostavlja TCP vezu s bilo kojim čvorom u klasteru. Kubernetes radi kao overlay mreža (iznad postojeće mreže data centra), koja koristi , odnosno enkapsulira IP pakete overlay mreže unutar IP paketa data centra. Pri povezivanju na prvi čvor dolazi do prevođenja mrežnih adresa (NAT) s praćenjem stanja za pretvorbu IP adrese i porta čvora Kubernetes u IP adresu i port u preklopnoj mreži (konkretno, pod-a s aplikacijom). Za primljene pakete izvršava se obrnuti slijed radnji. Ovo je složen sustav s velikim brojem stanja i mnogim elementima koji se neprestano ažuriraju i mijenjaju tijekom raspoređivanja i premještanja usluga.
Alat tcpdump u testu Vegeta daje kašnjenje tijekom TCP rukovanja (između SYN i SYN-ACK). Da bismo eliminirali ovu suvišnu složenost, možemo koristiti hping3 za jednostavne «pingove» paketa SYN. Provjeravamo postoji li kašnjenje u odgovarajućem paketu, a zatim pomažemo povezivanju. Možemo filtrirati podatke, uključujući samo pakete duže od 100 ms, i dobiti jednostavniju varijantu reproduciranja problema nego potpuni test mrežnog nivoa 7 u Vegeti. Ovo su «pingovi» čvora Kubernetes koristeći TCP SYN/SYN-ACK na «portu čvora» usluge (30927) s intervalom od 10 ms, filtrirani prema najsporijim odgovorima:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Odmah možemo primijetiti prvih nekoliko opažanja. Po rednim brojevima i vremenskim oznakama vidljivo je da ovo nisu jednokratni zastoji. Kašnjenje se često nakuplja i na kraju se obrađuje.
Dalje želimo saznati koji dijelovi mogu biti uključeni u pojavu zastoja. Možda su to neka od stotina pravila iptables u NAT-u? Ili možda neki problemi s tuneliranjem IPIP u mreži? Jedan od načina da to provjerimo je da ispitamo svaki korak sustava, isključujući ga. Što će se dogoditi ako uklonimo NAT i logiku vatrozida, ostavljajući samo dio IPIP:
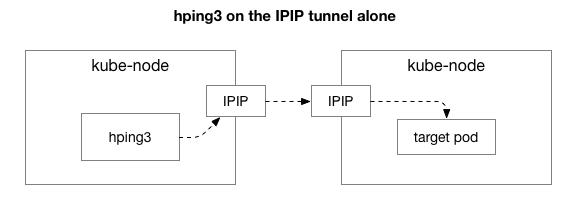
Srećom, Linux omogućava lako pristupanje izravno preklopnom sloju IP-a, ako računalo pripada istoj mreži:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Prema rezultatima, problem još uvijek postoji! To isključuje iptables i NAT. Dakle, problem je u TCP-u? Pogledajmo kako ide običan ICMP ping:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Rezultati pokazuju da problem nije nestao. Možda je to IPIP tunel? Pojednostavimo test još jednom:
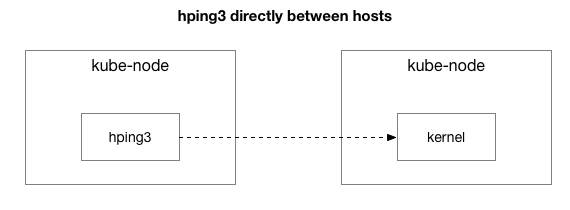
Da li se svi paketi šalju između ova dva hosta?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Pojednostavili smo situaciju na dva čvora Kubernetes koja međusobno šalju bilo koji paket, čak i ICMP ping. I dalje vide kašnjenje, ako je ciljna host 'loša' (neki su gori od drugih).
Sada posljednje pitanje: zašto kašnjenje nastaje samo na serverima kube-node? I jesu li oni pošiljatelji ili primatelji? Srećom, to se također prilično lako može otkriti slanjem paketa s hosta van Kubernetes-a, ali s istim 'poznatim lošim' primateljem. Kao što vidimo, problem nije nestao:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Zatim ćemo izvršiti iste zahtjeve od prethodnog izvora kube-node do vanjskog hosta (što isključuje izvorni host, budući da ping uključuje i RX i TX):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping statistika ---
 22352 paketa poslana, 22350 paketa primljena, 1% gubitak paketa
 round-trip min/avg/max = 0.2/7.6/1010.6 ms
Istražujući zastoje paketa, dobili smo dodatne informacije. Konkretno, pošiljatelj (dolje) vidi ovo vrijeme isključenja, dok primatelj (gore) ne vidi — vidi stupac Delta (u sekundama):
Osim toga, ako pogledamo razliku u redoslijedu TCP i ICMP paketa (po rednim brojevima) s strane primatelja, ICMP paketi uvijek dolaze u istom redoslijedu u kojem su poslani, ali s različitim vremenima. U isto vrijeme, TCP paketi se ponekad izmjenjuju, a neki od njih zapnu. Konkretno, ako ispitamo SYN pakete, s strane pošiljatelja oni dolaze u redoslijedu, ali s strane primatelja ne.
Postoji suptilna razlika u tome kako modernih poslužitelja (kao u našem podatkovnom centru) obrađuju pakete koji sadrže TCP ili ICMP. Kada paket stigne, mrežni adapter 'hashira ga prema vezi', što znači da pokušava podijeliti veze u redove i poslati svaki red prema zasebnom procesorskom jezgru. Za TCP, ovaj hash uključuje izvorni i odredišni IP adresa i port. Drugim riječima, svaka veza se hashira (moguće) različito. Za ICMP se hashiraju samo IP adrese, budući da portovi ne postoje.
Još jedno novo zapažanje: tijekom ovog perioda vidimo ICMP kašnjenja u svim komunikacijama između dva domaćina, dok TCP nema. To nam govori da je uzrok vjerojatno povezan s hashiranjem RX redova: gotovo sigurno, zagušenje nastaje u obradi RX paketa, a ne u slanju odgovora.
To isključuje slanje paketa kao mogući uzrok. Sada znamo da je problem u obradi paketa na strani primanja na nekim kube-node poslužiteljima.
Bavljenja obradom paketa u Linux jezgru
Da bismo razumjeli zašto problem nastaje kod primatelja na nekim kube-node poslužiteljima, pogledajmo kako Linux jezgro obrađuje pakete.
Vraćajući se na najjednostavniju tradicionalnu implementaciju, mrežna kartica prima paket i šalje Linux jezgru, da je tu paket koji treba obraditi. Jezgro zaustavlja drugi rad, prebacuje kontekst na rukovatelja prekida, obrađuje paket, a zatim se vraća trenutnim zadacima.
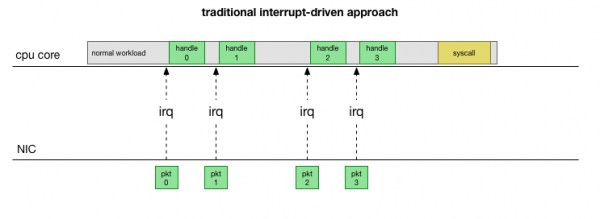
Ovo prebacivanje konteksta odvija se sporo: možda je kašnjenje bilo neprimjetno na 10-megabitnim mrežnim karticama 90-ih godina, ali na modernim 10G karticama s maksimalnim propusnim opterećenjem od 15 milijuna paketa u sekundi, svako jezgro malog osmerojezgrene poslužitelja može se prekinuti milijune puta u sekundi.
Kako se ne bi stalno bavio obradom prekida, prije mnogo godina u Linux je dodan : mrežni API kojeg koriste sve moderne upravljačke programe za poboljšanje performansi pri visokim brzinama. Pri niskim brzinama jezgro još uvijek prima prekide s mrežne kartice na stari način. Kada stigne dovoljna količina paketa koja premašuje prag, jezgro onemogućava prekide i umjesto toga počinje ispitivati mrežni adapter i preuzimati pakete u serijama. Obrada se vrši u softirq, to jest u nakon sistemskih poziva i hardverskih prekida, kada je jezgro (za razliku od korisničkog prostora) već pokrenuto.
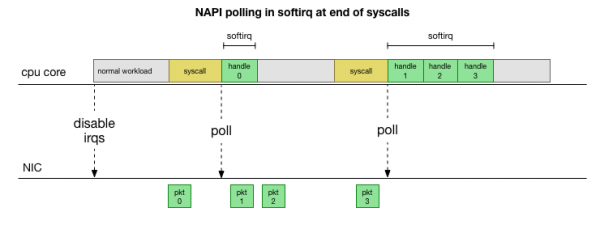
Ovo je mnogo brže, ali izaziva drugi problem. Ako je paketa previše, cijelo vrijeme odlazi na obradu paketa s mrežne kartice, a procesi korisničkog prostora ne stignu zapravo isprazniti te redove (čitanje iz TCP veza itd.). Na kraju se redovi pune i počinjemo odbacivati pakete. Pokušavajući pronaći ravnotežu, jezgro postavlja budžet za maksimalan broj paketa koji se obrađuju u kontekstu softirq. Kada se taj budžet premaši, budi se zaseban proces ksoftirqd (vidjet ćete jedan od njih u ps za svako jezgro), koji obrađuje te softirq izvan uobičajenog puta syscall/prekid. Ovaj proces se planira standardnim procesom planiranja koji pokušava pravedno raspodijeliti resurse.
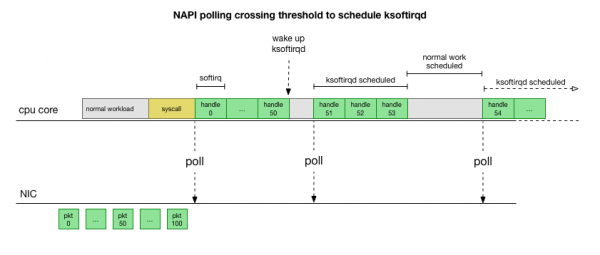
Istražujući kako jezgro obrađuje pakete, može se primijetiti da postoji određena vjerojatnost pojave zagušenja. Ako pozivi softirq dolaze rjeđe, paketima će možda trebati neko vrijeme za čekanje obrade u RX redu na mrežnoj kartici. Možda se to događa zbog neke zadaće koja blokira jezgru procesora, ili nešto drugo ometa jezgro da pokrene softirq.
Sužavamo obradu na jezgru ili metodu
Zastoje softirq su trenutno samo pretpostavka. Međutim, to ima smisla, i znamo da primijetimo nešto vrlo slično. Sljedeći korak je potvrditi ovu teoriju. Ako se potvrdi, potrebno je pronaći uzrok zastoja.
Vratimo se našim sporim paketima:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Kao što je ranije raspravljeno, ovi ICMP paketi se hasiraju u red NIC RX i obrađuju jednim CPU jezgrom. Ako želimo razumjeti kako Linux radi, korisno je znati gdje (na kojem CPU jezgru) i kako (softirq, ksoftirqd) se ovi paketi obrađuju, kako bismo pratili proces.
Sada je došlo vrijeme za korištenje alata koji omogućuju praćenje rada Linux kernel-a u stvarnom vremenu. Ovdje smo koristili . Ovaj skup alata omogućava pisanje malih programa u C koji presreću proizvoljne funkcije u kernel-u i baferiraju događaje u Python program korisničkog prostora, koji ih može obraditi i vratiti vam rezultat. Hooks za proizvoljne funkcije u kernel-u su kompleksna stvar, ali je alat dizajniran za maksimalnu sigurnost i namijenjen je praćenju takvih problema u produkciji koji je teško reproducirati u testnom ili razvoju okruženju.
Plan je jednostavan: znamo da kernel obrađuje ove ICMP pingove, tako da ćemo postaviti hook na kernel funkciju , koja prihvaća dolazni ICMP paket „echo request“ i inicira slanje ICMP odgovora „echo response“. Možemo identificirati paket prema povećanju broja icmp_seq, što pokazuje hping3 gore.
Kod izgleda složenom, ali nije tako strašna kao što izgleda. Funkcija icmp_echo prenaša struct sk_buff *skb: to je paket s „echo request“ zahtjevom. Možemo ga pratiti, izvući sekvencu echo.sequence (koja se podudara s icmp_seq iz hping3 gore), i poslati je u korisnički prostor. Također je korisno zabilježiti trenutno ime procesa/identifikator. Ispod su prikazani rezultati koje vidimo neposredno tijekom obrade paketa od strane kernel-a:
TGID    PID     NAZIV PROCESA    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Ovdje treba primijetiti da u kontekstu softirq procesi koji su napravili sistemske pozive, prikazat će se kao „procesi“, iako zapravo kernel sigurno obrađuje pakete u okviru jezgre.
S ovim alatom možemo postaviti vezu između određenih procesa i određenih paketa koji pokazuju kašnjenje u hping3. Izrađujemo jednostavno grep na ovom snimanju za određene vrijednosti icmp_seq. Paketi koji odgovaraju gore navedenim vrijednostima icmp_seq označeni su zajedno s njihovim RTT, koji smo promatrali ranije (u zagradama su navedene očekivane vrijednosti RTT za pakete koje smo filtrirali zbog RTT vrijednosti manjih od 50 ms):
TGID    PID     NAZIV PROCESA    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Rezultati nam govore o nekoliko stvari. Prvo, svi ti paketi obrađuje kontekst ksoftirqd/11. To znači da su za ovaj konkretni par mašina ICMP paketi heširani na jezgru 11 na strani primatelja. Također vidimo da prilikom svakog zastoja postoje paketi koji se obrađuju u kontekstu sistemskog poziva cadvisor. Zatim ksoftirqd preuzima zadatak i obrađuje nagomilanu čekajuću listu: točno onaj broj paketa koji se akumulirao nakon cadvisor.
Činjenica da neposredno prije toga uvijek radi cadvisor, implicira njegovu umiješanost u problem. Ironično, svrha je „analizirati korištenje resursa i karakteristike performansi pokrenutih kontejnera“, a ne izazvati ovaj problem s performansama.
Kao i s drugim aspektima rada s kontejnerima, ovo je sve iznimno napredan alat, od kojeg se mogu očekivati problemi s performansama u nekim nepredviđenim okolnostima.
Što točno radi cadvisor, što usporava red paketa?
Sada imamo prilično dobar uvid u to kako se dogodio kvar, koji proces ga uzrokuje i na kojem CPU-u. Vidimo da zbog teške blokade Linux jezgra ne uspijeva pravovremeno zakazati. ksoftirqd. I vidimo da se paketi obrađuju u kontekstu cadvisor. Logično je pretpostaviti da cadvisor pokreće spor syscall, nakon čega se obrađuju svi akumulirani paketi:
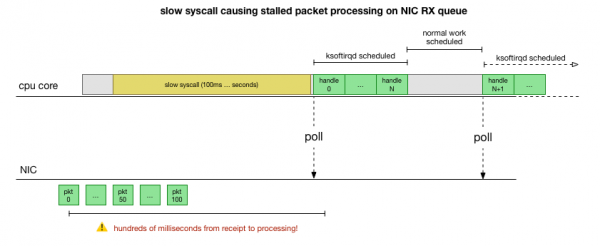
To je teorija, ali kako je provjeriti? Ono što možemo učiniti je pratiti rad jezgre CPU-a tijekom cijelog ovog procesa, pronaći trenutak kada se prekoračuje proračun za broj paketa i poziva ksoftirqd, a zatim vidjeti malo ranije — što je točno radilo na jezgrenom CPU-u neposredno prije tog trenutka. To je poput rendgenskog snimka CPU-a svakih nekoliko milisekundi. Izgledaće otprilike ovako:
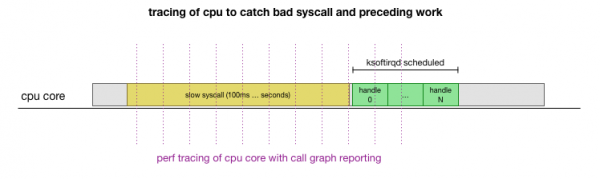
Pogodno je što sve to možemo učiniti postojećim alatima. Na primjer, provjerava navedenu jezgru CPU-a s određenom periodičnošću i može generirati grafikon poziva radnog sustava, uključujući korisnički prostor i Linux jezgru. Možemo uzeti ovu snimku i obraditi je s malim fork programa od Brendana Gregga, koji čuva redoslijed praćenja stoga. Možemo pohranjivati jednolinijske tragove stoga svake 1 ms, a zatim istaknuti i pohraniti uzorak za 100 milisekundi prije nego što u trag dođe ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Evo rezultata:
(stotine tragova koji izgledaju slično)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Ovdje ima mnogo informacija, ali najvažnije je da smo našli obrazac "cadvisor prije ksoftirqd", koji smo već vidjeli u ICMP tracera. Što to znači?
Svaka linija predstavlja praćenje CPU-a u određenom trenutku. Svaki poziv prema dolje u stogu u liniji odvojen je točkom sa zarezom. U sredini redaka vidimo pozvani syscall: read(): .... ;do_syscall_64;sys_read; .... Tako cadvisor troši puno vremena na sistemski poziv read(), koji se odnosi na funkcije mem_cgroup_* (gornji dio stoga poziva/kraj linije).
U praćenju poziva neugodno je vidjeti što se točno čita, stoga ćemo pokrenuti strace i vidjeti što radi cadvisor, te pronaći sistemske pozive duže od 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Kao što se moglo očekivati, ovdje vidimo spore pozive read(). Iz sadržaja operacija čitanja i konteksta mem_cgroup vidljivo je da se ovi pozivi read() odnose na datoteku memory.stat, koja prikazuje korištenje memorije i ograničenja cgroup (tehnologija izolacije resursa u Dockeru). Alat cadvisor upituje ovu datoteku kako bi dobio informacije o korištenju resursa za kontejnere. Provjerimo, radi li nešto neočekivano kernel ili cadvisor:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Sada možemo reproducirati grešku i razumijemo da se Linux kernel suočava s patologijom.
Zašto je operacija čitanja tako spora?
U ovoj fazi daleko je lakše pronaći poruke drugih korisnika o sličnim problemima. Kako se ispostavilo, u cadvisor trackeru je o ovoj grešci izviješteno kao o , jednostavno nitko nije primijetio da se kašnjenje također slučajno odražava u mrežnom stogu. Doista je primijećeno da cadvisor troši više procesorskog vremena nego što se očekivalo, ali tome nije pridana velika pažnja, jer naše servere imaju mnogo procesorskih resursa, tako da se problem nije temeljito istraživao.
Problem je u tome što kontrolne grupe (cgroups) uzimaju u obzir korištenje memorije unutar prostora imena (kontejner). Kada svi procesi u ovoj cgroup završe, Docker oslobađa kontrolnu grupu memorije. Međutim, 'memorija' nije samo memorija procesa. Iako se sama memorija procesa više ne koristi, ispostavlja se da kernel dodjeljuje još i keširan sadržaj, poput dentrija i inodeova (metapodataka direktorija i datoteka), koji se keširaju u memory cgroup. Iz opisa problema:
cgroups-zombiji: kontrolne grupe koje nemaju procese i uklonjene su, ali za koje je još uvijek dodijeljena memorija (u mom slučaju, iz dentry predmemorije, ali se također može dodijeliti iz stranica keša ili tmpfs).
Provjera svih stranica u predmemoriji od strane kernela prilikom oslobađanja cgroup može biti vrlo spora, stoga se odabire lijen proces: pričekati dok se te stranice ponovo ne zatraže, a tek tada, kada je memorija stvarno potrebna, konačno očistiti cgroup. Do tada se cgroup i dalje uzima u obzir prilikom prikupljanja statistike.
S obzirom na performanse, žrtvovali su memoriju za brzinu: ubrzavajući početno čišćenje smanjenjem cacheirane memorije. To je u redu. Kada jezgra koristi posljednji dio cacheirane memorije, cgroup se na kraju čisti, tako da se to ne može nazvati "curenjem". Nažalost, specifična implementacija mehanizma pretraživanja memory.stat u ovoj verziji jezgre (4.9), u kombinaciji s ogromnim količinama memorije na našim serverima, rezultira time da je potrebno puno više vremena za obnavljanje posljednjih cacheiranih podataka i čišćenje cgroup zombija.
Ispostavilo se da je na nekim našim čvorovima bilo toliko cgroup zombija da su čitanje i kašnjenja prelazili sekundu.
Jedan od načina za zaobilaženje problema s cadvisorom je odmah osloboditi cache-e dentries/inodes kroz cijeli sustav, što ubrzo uklanja kašnjenje u čitanju, kao i mrežno kašnjenje na hostu, budući da uklanjanje cache-a uključuje cacheirane stranice cgroup zombija, a one se također oslobađaju. To nije rješenje, ali potvrđuje uzrok problema.
Pokazalo se da su u novijim verzijama jezgre (4.19+) poboljšane performanse poziva memory.stat, tako da prelazak na ovu jezgru uklanja problem. U isto vrijeme, imali smo alate za otkrivanje problematičnih čvorova u Kubernetes klasterima, njihovo elegantno pročišćenje i ponovno pokretanje. Pretražili smo sve klastere, pronašli čvorove s dovoljno visokim kašnjenjima i ponovo ih pokrenuli. To nam je dalo vremena za ažuriranje OS-a na ostalim serverima.
Zaključno
Budući da je ova greška zaustavljala obradu redova NIC RX na stotine milisekundi, istovremeno je izazivala veliku kašnjenje na kratkim vezama i kašnjenje usred veze, na primjer, između MySQL zahtjeva i odgovornih paketa.
Razumijevanje i podrška performansama najosnovnijih sustava, kao što je Kubernetes, od ključne je važnosti za pouzdanost i brzinu svih usluga na njima. Sva pokrenuta rješenja profitiraju od poboljšanja performansi Kubernetes-a.
Izvor: habr.com
