

Prije tri godine Viktor Taranovski i Aleksej Milovidov iz Yandexa na pozornici HighLoad++ , govorili su o tome koliko je ClickHouse dobar i kako ne usporava. A na susjednoj pozornici bio je Aleksandar Zajtsev s o preseljenju na ClickHouse drugu analitičku DBMS i sa zaključkom da ClickHouse, naravno, je dobar, ali nije baš udoban. Kada je 2016. godine kompanija LifeStreet, u kojoj je tada radio Aleksandar, prebacivala višepetabajtni analitički sustav na ClickHouse, bila je to uzbudljiva 'cesta od žutih opeka', puna nepoznatih opasnosti — ClickHouse tada je ličilo na minsko polje.
Tri godine kasnije ClickHouse je postalo mnogo bolje — u to vreme Aleksandar je osnovao kompaniju Altinity, koja ne samo da pomaže u prelasku na ClickHouse desetinama projekata, već i unapređuje sam proizvod zajedno s kolegama iz Yandexa. Sada ClickHouse još nije bezbrižna šetnja, ali više nije ni minsko polje.
Aleksandar se bavi distribuisanim sistemima od 2003. godine, razvijao je velike projekte na MySQL, Oracle i Vertica. Na prošloj HighLoad++ 2019 Aleksandar, jedan od pionira korišćenja ClickHouse, rekao je kakav je danas ovaj DBMS. Upoznaćemo se s osnovnim karakteristikama ClickHouse: čime se razlikuje od drugih sistema i u kojim je slučajevima efikasnije koristiti ga. Na primerima ćemo razmotriti sveže i proverene prakse izgrađene na ClickHouse.
Retrospektiva: šta je bilo pre 3 godine
Prije tri godine prenosili smo kompaniju LifeStreet na ClickHouse s druge analitičke baze podataka, i migracija analitike oglasne mreže izgledala je ovako:
- Jun 2016. U OpenSource pojavio se ClickHouse i započeli naš projekat;
- Avgust. Proof Of Concept: velika oglasna mreža, infrastruktura i 200-300 terabajta podataka;
- Oktobar. Prvi podaci u produkciji;
- Decembar. Puna proizvodna opterećenja — 10-50 milijardi događaja dnevno.
- Jun 2017. Uspešan prijenos korisnika na ClickHouse, 2,5 petabajta podataka na klasteru sa 60 servera.
Tokom migracije je raslo razumevanje da ClickHouse — to je dobar sistem s kojim je prijatno raditi, ali je to interni projekat kompanije Yandex. Stoga postoje pojedinosti: Yandex će prvo raditi s vlastitim internim korisnicima, a tek potom — s zajednicom i potrebama vanjskih korisnika, a ClickHouse tada nije dostizao nivo entiteta u mnogim funkcionalnim oblastima. Tako smo u martu 2017. godine osnovali kompaniju Altinity kako bismo to omogućili. ClickHouse čak brže i lakše ne samo za Yandex, već i za druge korisnike. A sada mi:
- Podučavamo i pomažemo u izgradnji rješenja na ClickHouse tako da klijenti ne dobiju probleme i da rješenje na kraju funkcioniše;
- Osiguravamo podršku 24/7 ClickHouse-instalacija;
- Razvijamo vlastite ekosustavne projekte;
- Aktivno doprinosimo samom ClickHouse, odgovarajući na zahtjeve korisnika koji žele vidjeti određene funkcionalnosti.
I naravno, pomažemo s preseljenjem na ClickHouse s MySQL, Vertica, Oracle, Greenplum, Redshift i druge sustave. Sudjelovali smo u raznim preseljenjima i svi su bili uspješni.
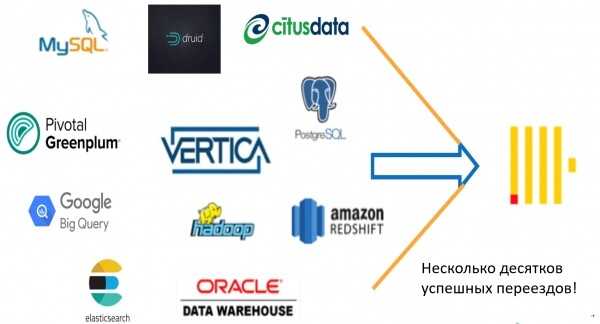
Zašto se uopće seliti na ClickHouse
Ne usporava! To je glavni razlog. ClickHouse — vrlo brza baza podataka za različite scenarije:
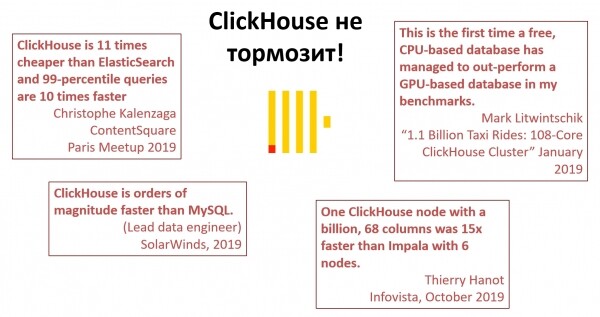
Slučajne citate ljudi koji dugo rade s ClickHouse.
Skalabilnost. Na nekoj drugoj bazi podataka može se postići dobra izvedba na jednom stroju, ali ClickHouse može se skalirati ne samo vertikalno, već i horizontalno, jednostavnim dodavanjem poslužitelja. Sve ne funkcioniše baš onako glatko kako bi željeli, ali funkcioniše. Može se povećati sustav zajedno s rastom poslovanja. Važno je da nismo ograničeni rješenjem sada i uvijek ima potencijala za razvoj.
Prijenosivost. Nema vezivanja za nešto posebno. Na primjer, s Amazon Redshift teško je preseliti se negdje. A ClickHouse može se instalirati na laptop, poslužitelj, postaviti u oblak, otići u Kubernetes — nema ograničenja u korištenju infrastrukture. To je zgodno za sve i to je velika prednost kojom se ne mogu pohvaliti mnoge druge slične baze podataka.
Fleksibilnost. ClickHouse ne zaustavlja se na nečemu jednom, kao što je Yandex.Metrica, već se razvija i koristi u sve većem broju različitih projekata i industrija. Može se proširivati dodavanjem novih mogućnosti za rješavanje novih zadataka. Na primjer, smatra se da je pohranjivanje logova u bazi podataka — loša praksa, pa su za to izmislili Elasticsearch. Ali, zahvaljujući fleksibilnosti ClickHouse, u njemu se također mogu pohranjivati logovi, a često je to čak i bolje nego u Elasticsearch — u ClickHouse za to je potrebna 10 puta manja oprema.
Besplatno Open Source. Nije potrebno ništa plaćati. Nije potrebno dogovarati dozvolu za postavljanje sustava na laptop ili poslužitelj. Nema skrivenih naknada. Pri tome, nijedna druga Open Source tehnologija baza podataka ne može konkurirati u brzini s ClickHouse. MySQL, MariaDB, Greenplum — svi su oni puno sporiji.
Zajednica, poticaj i fun. U ClickHouse odlična zajednica: meetupi, chatovi i Aleksej Milovidov, koji nas sve motivira svojom energijom i optimizmom.
Preseljenje na ClickHouse
Da biste prešli na ClickHouse nešto drugo, trebaju vam samo tri stvari:
- Razumjeti ograničenja ClickHouse i zašto on nije prikladan.
- Iskoristiti prednosti tehnologije i njene najjače strane.
- Eksperimentirati. Čak i razumijevajući kako to funkcionira, ClickHouse, nije uvijek moguće predvidjeti kada će biti brži, kada sporiji, kada bolji, a kada lošiji. Stoga isprobajte.
Problem migracije
Postoji samo jedno „ali“: ako se selite s ClickHouse nečega drugog, obično nešto ne ide kako treba. Navikli smo na određene prakse i stvari koje rade u našoj omiljenoj bazi podataka. Na primjer, svatko tko radi s SQL-baza podataka smatra obaveznim set funkcija:
- transakcije;
- ograničenja;
- dosljednost;
- indeksi;
- UPDATE/DELETE;
- NULL vrijednosti;;
- milisekunde;
- automatske konverzije tipova;
- višestruki join-ovi;
- slobodne particije;
- sredstva za upravljanje klasterom.
Set je obavezan, ali prije tri godine u ClickHouse nije bilo niti jedne od tih funkcija! Sada je manje od polovice neprovedenog: transakcije, ograničenja, dosljednost, milisekunde i konverzija tipova.
I najvažnije - u ClickHouse neke standardne prakse i pristupi ne rade ili rade drugačije nego što smo navikli. Sve što se pojavljuje u ClickHouse, odgovara „ClickHouse način“, tj. funkcije se razlikuju od drugih baza podataka. Na primjer:
- Indeksi ne biraju, već propuštaju.
- UPDATE/DELETE nisu sinkronizirani, već asinkronizirani.
- Višestruki join-ovi postoje, ali nema planera upita. Kako se tada izvršavaju, ljudima iz svijeta baza podataka nije baš jasno.
Scenariji ClickHouse
Godine 1960. američki matematičar mađarskog podrijetla Wigner E. P. napisao je članak „The unreasonable effectiveness of mathematics in the natural sciences“ o tome kako svijet oko nas iz nekog razloga dobro opisuje matematičke zakone. Matematika - apstraktna znanost, a fizički zakoni, izraženi u matematičkom obliku, nisu trivijalni, i Wigner E. P. naglasio je da je to vrlo čudno.
S mog gledišta, ClickHouse — isto je tako čudno. Preformulirajući Wigner-a, može se reći ovako: zapanjujuća je neobjašnjiva učinkovitost ClickHouse u najrazličitijim analitičkim aplikacijama!
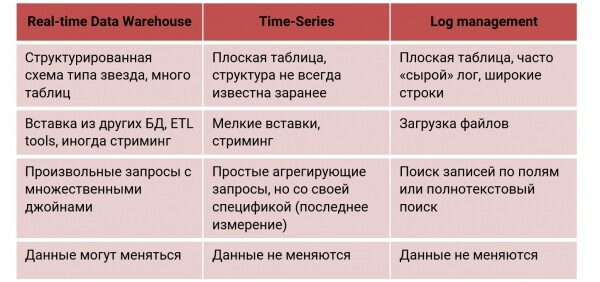
Na primjer, uzmimo Real-Time Data Warehouse, u koji se podaci učitavaju praktično neprekidno. Želimo primati zahtjeve s kašnjenjem od jedne sekunde. Molimo vas — koristimo ClickHouse, jer je za ovaj scenarij i razvijen. ClickHouse to se koristi ne samo u webu, već i u marketinškoj i financijskoj analitici, AdTech, kao i u Fraud detection. U Real-time Data Warehouse koristi se složena strukturirana shema tipa 'zvijezda' ili 'snježna pahulja', s više tablica JOIN (ponekad višestrukim), a podaci se obično pohranjuju i mijenjaju u nekim sustavima.
Uzmimo drugi scenarij — Time Series: praćenje uređaja, mreža, statistika korištenja, internet stvari. Ovdje se susrećemo s vremenski poretkom prilično jednostavnih događaja. ClickHouse to nije prvotno bilo zamišljeno, ali se pokazalo dobrim, pa ga velike tvrtke koriste ClickHouse kao skladište za informaciju o praćenju. Kako bismo istražili odgovara li ClickHouse za time-series, napravili smo benchmark temeljen na pristupu i rezultatima InfluxDB i TimescaleDB — specijaliziranim time-series baza podataka. , što ClickHouse, čak i bez optimizacije za takve zadatke, pobjeđuje i na stranoj terenu:
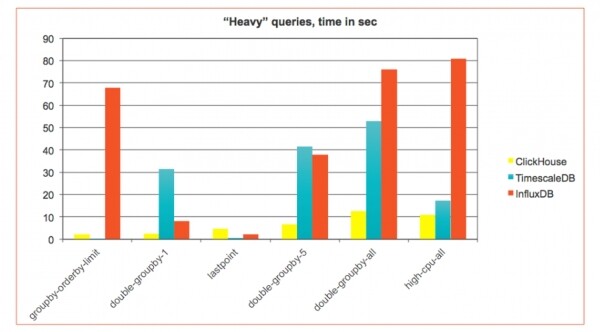
U time-series obično se koristi uska tablica — nekoliko malih kolona. Od praćenja može dolaziti jako mnogo podataka, — milijuni unosa u sekundi, — i obično dolaze u malim unosima (real-time streaming). Stoga je potrebno drugo scenarij unosa, a sami zahtjevi — sa svojom specifičnošću.
Log Management. Prikupljanje logova u DB — obično nije dobro, ali u ClickHouse to se može raditi s nekim komentarima, kao što je opisano iznad. Mnoge tvrtke koriste ClickHouse upravo za to. U tom slučaju koristi se ravna široka tablica, gdje pohranjujemo logove u cijelosti (na primjer, u obliku JSON), ili ih dijelimo na dijelove. Podaci se obično učitavaju u velikim serijama (datotekama), a pretražujemo po nekom polju.
Za svaku od ovih funkcija obično se koriste specijalizirane DB. ClickHouse jedan može to sve raditi i to tako dobro da ih nadmašuje po performansama. Pogledajmo sada detaljno time-series scenarij, i kako pravilno 'pripremiti' ClickHouse za ovaj scenarij.
Time-Series
U ovom trenutku to je glavni scenarij za koji ClickHouse se smatra standardnim rješenjem. Time-series — je skup vremenski uređenih događaja koji predstavljaju promjene nekog procesa tijekom vremena. Na primjer, to može biti učestalost otkucaja srca tijekom dana ili broj procesa u sustavu. Sve što daje vremenske tickove s nekim mjerenjima – to je time-series:
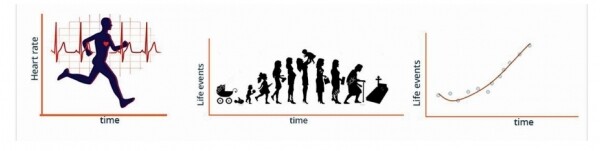
Najviše takvih događaja dolazi iz nadzora. To može biti ne samo nadzor weba, već i stvarnih uređaja: automobila, industrijskih sustava, IoT, proizvodnje ili autonomnih taksija, u čijem prtljažniku Yandex već sada stavlja ClickHouse-poslužitelj.
Na primjer, postoje kompanije koje prikupljaju podatke s brodova. Svakih nekoliko sekundi senzori s kontejnerskog broda šalju stotine različitih mjerenja. Inženjeri ih proučavaju, grade modele i pokušavaju razumjeti koliko učinkovito se koristi brod, jer kontejnerski brod ne smije stajati ni sekunde. Bilo kakvo stajanje — to je gubitak novca, stoga je važno predvidjeti rutu tako da su zaustavljanja minimalna.
Trenutno se bilježi rast specijaliziranih BD-ova koji mjere time-series. Na web stranici DB-Engines na neki način rangiraju različite baze podataka, a one se mogu pregledati prema tipovima:
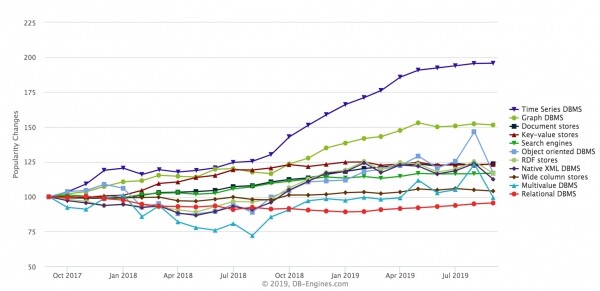
Najbrže rastuća vrsta — time-series. Također rastu grafičke BDs, ali time-series rastu brže posljednjih nekoliko godina. Tipični predstavnici BDs ove obitelji su InfluxDB, Prometheus, KDB, TimescaleDB (izgrađena na PostgreSQL), rješenja od Amazon. ClickHouse ovdje također može biti korišten, i koristi se. Navest ću nekoliko javnih primjera.
Jedan od pionira — kompanija CloudFlare (CDN-providera). Oni nadziru svoje CDN preko ClickHouse (DNS-zahtjeve, HTTP-zahtjeve) s ogromnim opterećenjem — 6 milijuna događaja u sekundi. Sve ide kroz Kafka, šalje se u ClickHouse, koji pruža mogućnost u stvarnom vremenu vidjeti nadzorne ploče događaja u sustavu.
Comcast — jedan od lidera telekomunikacija u SAD-u: internet, digitalna televizija, telefonija. Oni su stvorili sličan sustav upravljanja CDN u okviru Open Source projekta Apache Traffic Control za rad s njihovim ogromnim podacima. ClickHouse koristi se kao backend za analitiku.
Percona ugradili su ClickHouse unutar svog PMM, kako bi pohranili nadzor različitih MySQL.
Specifični zahtjevi
Za time-series baze podataka postoje specifični zahtjevi.
- Brzo umetanje s mnogih agenata. Moramo jako brzo umetnuti podatke iz mnogih tokova. ClickHouse dobro to radi, jer su svi njegovi unosi neblokirajući. Bilo koji insert — to je nova datoteka na disku, a male umetke je moguće pohraniti na različite načine. U ClickHouse bolje je umetati podatke u većim paketima, a ne po jednoj liniji.
- Fleksibilna shema. U time-series obično ne znamo strukturu podataka do kraja. Moguće je izgraditi sustav nadzora za određenu aplikaciju, ali tada ga je teško koristiti za drugu aplikaciju. Za to je potrebna fleksibilnija shema. ClickHouse, omogućava to, čak i unatoč tome što je to strogo tipizirana baza.
- Učinkovito pohranjivanje i ‘zaboravljanje’ podataka. Obično u time-series ogromnoj količini podataka, stoga ih treba pohranjivati maksimalno učinkovito. Na primjer, kod InfluxDB dobra kompresija — to je njegova glavna karakteristika. No osim pohrane, treba znati i ‘zaboraviti’ stare podatke i raditi neku vrstu downsampling — automatsko brojanje agregata.
- Brzi upiti agregiranih podataka. Ponekad je zanimljivo vidjeti posljednjih 5 minuta s točnošću do milisekundi, ali kod mjesečnih podataka, minutna ili sekundna granularnost možda nije potrebna — dovoljna je opća statistika. Potpora za takvu vrstu potrebna je, inače će se upit za 3 mjeseca izvršavati vrlo sporo čak i u ClickHouse.
- Upiti tipa ‘posljednja točka, prema». Ovo su tipični za time-series upiti: gledamo posljednje mjerenje ili stanje sustava u trenutku vremena t. Za baze podataka ovo nisu ugodni upiti, ali ih također treba moći izvršiti.
- ‘Spajanje’ vremenskih serija. Time-series — to je vremenska serija. Ako postoje dvije vremenske serije, često ih je potrebno spojiti i korelirati. Ne na svim bazama podataka to je jednostavno raditi, osobito s neusklađenim vremenskim serijama: ovdje — jedna vremenska oznaka, ondje — druga. Mogu se izračunati prosjeci, ali ako tu svejedno postoji rupa, onda to nije jasno.
Pogledajmo kako se ti zahtjevi ispunjavaju u ClickHouse.
Shema
U ClickHouse shema za time-series može se izraditi na različite načine, ovisno o stupnju regularnosti podataka. Moguće je izgraditi sustav na regularnim podacima, kada unaprijed znamo sve metrike. Na primjer, tako je učinjeno CloudFlare s nadzorom CDN — to je dobro optimizirani sustav. Moguće je izgraditi općenitiji sustav koji nadzire cijelu infrastrukturu, različite usluge. U slučaju neredovitih podataka, ne znamo unaprijed što nadziremo — i vjerojatno je to najopćenitiji slučaj.
Regularni podaci. Kolone. Shema je jednostavna – kolone s potrebnim tipovima:
STVORI TABLICU cpu (
  datum_stvaranja Datum DEFAULT danas(),
  vrijeme_stvaranja DatumVrijeme DEFAULT sada(),
  vrijeme String,
  tags_id UInt32,
  /* poveži s dim_tag */
  korištenje_korisnika Float64,
  korištenje_sustava Float64,
  korištenje_idle Float64,
  korištenje_nice Float64,
  korištenje_iowait Float64,
  korištenje_irq Float64,
  korištenje_softirq Float64,
  korištenje_ukradeno Float64,
  korištenje_gosta Float64,
  korištenje_gosta_nice Float64
) MOTOR = MergeTree(datum_stvaranja, (tags_id, vrijeme_stvaranja), 8192);
To je obična tablica koja prati neku aktivnost vezanu uz opterećenje sustava (korisnik, system, idle, nice). Jednostavno i praktično, ali ne fleksibilno. Ako želimo fleksibilniju shemu, možemo koristiti nizove.
Neregularni podaci. Nizovi:
STVORI TABLICU cpu_alc (
  datum_stvaranja Datum,
  vrijeme_stvaranja DatumVrijeme,
  vrijeme String,
  tags_id UInt32,
  metrike Ugniježdene(
    naziv LowCardinality(String),
    vrijednost Float64
  )
) MOTOR = MergeTree(datum_stvaranja, (tags_id, vrijeme_stvaranja), 8192);

ODABERITE max(metrike.vrijednost[indexOf(metrike.naziv,'korištenje_korisnika')]) IZ ...
Struktura Ugniježdene — to su dva niza: metrike.naziv i metrike.vrijednost. Ovdje se mogu pohranjivati takvi proizvoljni podaci za praćenje, poput niza naziva i niza mjerenja pri svakom događaju. Za daljnju optimizaciju umjesto jedne tako strukture može se napraviti nekoliko. Na primjer, jedno — za float-vrijednost, drugo — za int-vrijednost, jer int želimo pohraniti učinkovitije.
Ali do takve strukture je teže pristupiti. Morat ćemo koristiti posebnu konstrukciju, pomoću posebnih funkcija prvo izvući vrijednosti iz indeksa, a zatim iz niza:
ODABERITE max(metrike.vrijednost[indexOf(metrike.naziv,'korištenje_korisnika')]) IZ ...Ali to svejedno radi dovoljno brzo. Drugi način pohrane neregularnih podataka – po redovima.
Neregularni podaci. Redovi. U ovom tradicionalnom pristupu bez nizova, naziv i vrijednosti se pohranjuju odmah. Ako s jednog uređaja dolazi odmah 5 000 mjerenja — generira se 5 000 redova u Bazi podataka:
STVORI TABLICU cpu_rlc (
  datum_stvaranja Datum,
  vrijeme_stvaranja DatumVrijeme,
  vrijeme String,
  tags_id UInt32,
  naziv_metrike LowCardinality(String),
  vrijednost_metrike Float64
) MOTOR = MergeTree(datum_stvaranja, (naziv_metrike, tags_id, vrijeme_stvaranja), 8192);


ODABERITE
    maxIf(vrijednost_metrike, naziv_metrike = 'korištenje_korisnika'),
    ...
IZ cpu_r
GDJE naziv_metrike U IN ('korištenje_korisnika', ...)
ClickHouse s ovim se nosi — ima posebne ekstenzije ClickHouse SQL. Na primjer, maxIf — posebna funkcija koja računa maksimum prema metrikama uz uvjet. Može se u jednom upitu napisati nekoliko takvih izraza i odmah izračunati vrijednosti za nekoliko metrika.
Poredit ćemo tri pristupa:
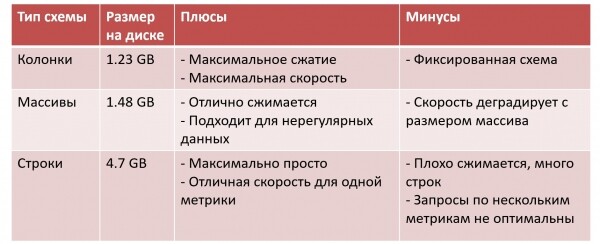
Ovdje sam dodao „Veličinu podataka na disku“ za neki testni skup podataka. U slučaju s kolonama, imamo najmanju veličinu podataka: maksimalno kompresiranje, maksimalnu brzinu upita, ali plaćamo time što moramo sve odmah fiksirati.
U slučaju s nizovima, stvari su malo lošije. Podaci se i dalje dobro komprimiraju, i može se pohraniti nekonvencionalna shema. Ali ClickHouse — kolonska baza podataka, a kada počnemo pohranjivati sve u nizu, tada se ona pretvara u string i plaćamo za fleksibilnost efikasnošću. Za svaku operaciju morat ćemo pročitati cijeli niz u memoriju, a zatim pronaći potrebni element — a ako se niz povećava, brzina opada.
U jednoj od tvrtki koja koristi takav pristup (na primjer, ), nizovi se sjeckaju na komade od 128 elemenata. Podaci nekoliko tisuća metrika u volumenu od 200 TB podataka/dan ne pohranjuju se u jednom nizu, već u 10 ili 30 nizova s posebnom logikom za pohranu.
Maksimalno jednostavan pristup — sa stringovima. No, podaci se loše komprimiraju, veličina tablice postaje velika, a kada upiti idu prema nekoliko metrika, ClickHouse ne radi optimalno.
Hibridna shema
Pretpostavimo da smo odabrali shemu s nizom. Ali ako znamo da većina naših nadzora prikazuje samo metrike user i system, možemo dodatno iz niza na razini tablice materializirati te metrike u kolone na sljedeći način:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Pri unosu ClickHouse automatski će ih izračunati. Tako možemo spojiti ugodno s korisnim: shema je fleksibilna i opća, ali najčešće korištene kolone smo izdvojili. Napominjem da to nije zahtijevalo promjenu unosa i ETL, koji nastavlja unositi u tablicu nizove. Samo smo napravili ALTER TABLE, dodali par kolona i dobili hibridnu i bržu shemu koja se može odmah početi koristiti.
Kodeci i kompresija
Za time-series važno je koliko dobro pakujete podatke, jer niz informacija može biti jako velik. U ClickHouse Postoji set alata za postizanje efekta kompresije 1:10, 1:20, pa čak i više. To znači da nekompresovani podaci od 1 TB na disku zauzimaju 50-100 GB. Manja veličina je dobra, podaci se brže mogu pročitati i obraditi.
Za postizanje visokog nivoa kompresije, ClickHouse podržava sledeće kodeke:
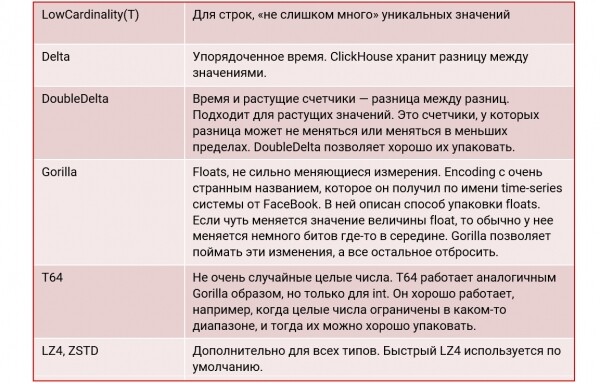
Primer tabele:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Ovde definišemo kodek DoubleDelta u jednom slučaju, u drugom — Gorilla, i obavezno dodajemo još LZ4 kompresiju. U rezultatu, veličina podataka na disku se značajno smanjuje:
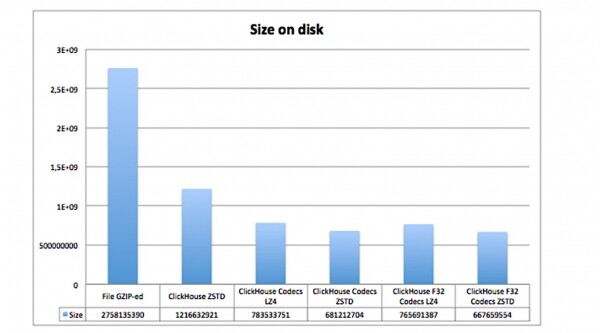
Ovde se pokazuje koliko prostora zauzimaju isti podaci, ali uz korišćenje različitih kodeka i kompresija:
- u GZIP-ovanoj datoteci na disku;
- u ClickHouse bez kodeka, ali sa ZSTD kompresijom;
- u ClickHouse sa kodecima i kompresijom LZ4 i ZSTD.
Vidljivo je da tabele sa kodecima zauzimaju mnogo manje prostora.
Veličina ima značaj
Jednako je važno pravi tip podataka:
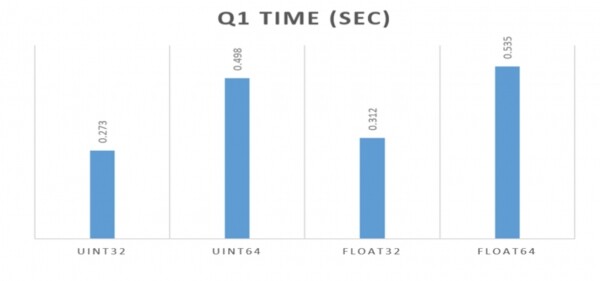
U svim primerima iznad koristio sam Float64. No, da smo izabrali Float32, bilo bi to čak i bolje. To su dobro prikazali momci iz Percone u članku na gornjem linku. Važno je koristiti što kompaktniji tip koji odgovara zadatku: čak i u manjoj meri za veličinu na disku, nego za brzinu upita. ClickHouse veoma je osetljiv na to.
Ako možete koristiti int32 umjesto int64, očekujte skoro dvostruko povećanje performansi. Podaci zauzimaju manje memorije, a sva 'aritmetika' radi mnogo brže. ClickHouse unutar sebe — veoma strogo tipizovana sistema, maksimalno koristi sve mogućnosti koje pružaju savremeni sistemi.
Agregacija i Materializovani prikazi
Agregacija i materializovani prikazi omogućavaju pravljenje agregata za različite slučajeve korišćenja:
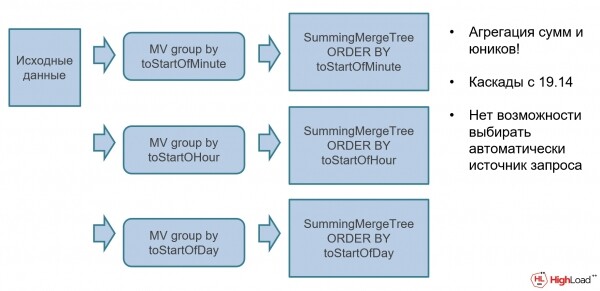
Na primer, možete imati neagregirane izvorne podatke, i na njih možete staviti različite materializovane prikaze sa automatskim sumiranjem putem posebnog motora SummingMergeTree (SMT). SMT — to je posebna struktura podataka koja automatski izračunava agregate. Sirove podatke umetnemo u bazu podataka, oni se automatski agregiraju, a odmah ih možemo koristiti za izradu nadzorne ploče.
TTL — «zaboravljamo» stare podatke
Kako da «zaboravimo» podatke koji više nisu potrebni? ClickHouse može to. Prilikom kreiranja tablica možemo odrediti TTL izraze: na primjer, da čuvamo minutne podatke jedan dan, dnevne — 30 dana, a tjedne ili mjesečne nikada ne diramo:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…
/* no TTL */
Višenamjenski — razdvajamo podatke po diskovima
Razvijajući ovu ideju, podatke možemo pohraniti ClickHouse na različitim mjestima. Pretpostavimo da želimo pohraniti vruće podatke za posljednji tjedan na vrlo brzi lokalni SSD, a starije historijske podatke smještamo na drugo mjesto. U ClickHouse sada je to moguće:
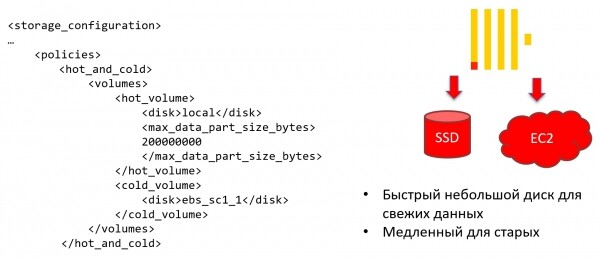
Možemo konfigurirati politiku pohrane (storage policy) tako da ClickHouse automatski premješta podatke po dostizanju određenih uvjeta u drugo skladište.
Ali to nije sve. Na razini konkretne tablice možemo definirati pravila kada točno podaci prelaze na hladnu pohranu. Na primjer, 7 dana podaci leže na vrlo brzom disku, a sve što je starije premješta se na sporiji. To je dobro jer omogućava sustavu da održava maksimalnu učinkovitost, istovremeno kontrolirajući troškove i ne trošeći sredstva na hladne podatke:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Jedinstvene mogućnosti ClickHouse
Skoro svugdje u ClickHouse ima takvih «specijalnosti», ali one se izjednačavaju ekskluzivnošću — onim čega nema u drugim BDP-ima. Na primjer, evo nekoliko jedinstvenih funkcija ClickHouse:
- Nizovi. U ClickHouse ima vrlo dobru podršku za nizove, kao i mogućnost izvođenja složenih proračuna na njima.
- Agregirajuće strukture podataka. To je jedna od «killer features» ClickHouse. Iako ljudi iz Yandexa kažu da ne želimo agregirati podatke, svi agregiraju u ClickHouse, jer je to brzo i praktično.
- Materializirani prikazi. Zajedno s agregirajućim strukturama podataka, materializirani prikazi omogućavaju jednostavno real-time agregiranje.
- ClickHouse SQL. To je proširenje jezika SQL s nekim dodatnim i ekskluzivnim značajkama koje postoje samo u ClickHouse. Nekada je to bilo s jedne strane proširenje, a s druge strane — nedostatak. Sada su gotovo svi nedostaci u usporedbi s SQL 92 uklonjeni, sada je to samo proširenje.
- Lambda– izrazi. Imaju li ih još negdje u bazi podataka?
- ML- podrška. Ovo postoji u različitim BDP-ima, negdje bolje, negdje lošije.
- Otvoreni kod. Možemo proširiti ClickHouse zajedno. Trenutno imamo ClickHouse oko 500 suradnika, a taj broj konstantno raste.
Složeni upiti
U ClickHouse ima mnogo različitih načina da se isto postigne. Na primjer, možete vratiti posljednju vrijednost iz tablice na tri različita načina za CPU (ima još i četvrti, ali je još egzotičniji).
Prvi prikazuje kako je zgodno raditi u ClickHouse upitima kada želite provjeriti da li tuple postoji u podupitu. To je ono što mi osobno jako nedostaje u drugim BDP-ima. Ako želim nešto usporediti s podupitom, u drugim BDP-ima mogu se uspoređivati samo skalarne vrijednosti, a za više kolona treba pisati JOIN. U ClickHouse može se koristiti tuple:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
Drugi način radi isto, ali koristi agregatnu funkciju argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
U ClickHouse ima nekoliko desetaka agregatnih funkcija, a ako koristite kombinatore, po zakonima kombinatorike ih može biti oko tisuću. ArgMax je jedna od funkcija koja računa maksimalnu vrijednost: upit vraća vrijednost usage_user, na kojoj se postiže maksimalna vrijednost created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
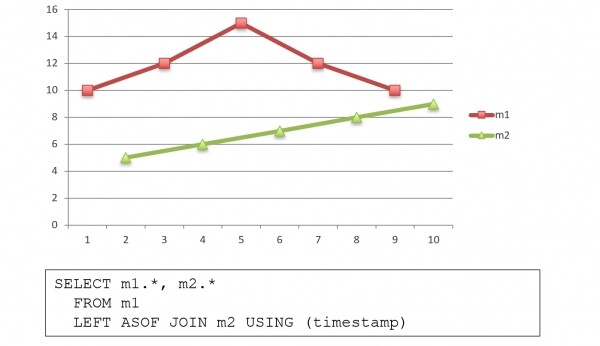
ASOF JOIN je "ljepljenje" redova s različitim vremenima. To je jedinstvena funkcija za baze podataka, koja se također nalazi samo u kdb+. Ako postoje dva vremenska niza s različitim vremenima, ASOF JOIN omogućuje njihovo pomicanje i lijepljenje u jednom upitu. Za svaku vrijednost u jednom vremenskom nizu pronalazi se najbliža vrijednost u drugom, i one se vraćaju u istom redu:
Analitičke funkcije
U standardu SQL-2003 može se pisati ovako:
SELECT origin,
       timestamp,
       timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration,
       timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration,
       ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence,
       COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb
  FROM mytable
ORDER BY origin, timestamp;
U ClickHouse tako se ne može — on ne podržava standard SQL-2003 i vjerojatno to nikada neće raditi. Umjesto toga u ClickHouse Obično se piše ovako:
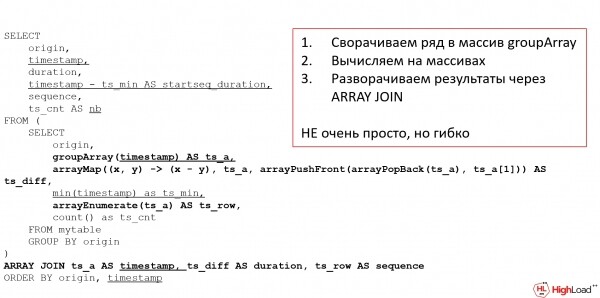
Obećao sam lambde – evo ih!
To je ekvivalent analitičkom upitu u standardu SQL-2003: on izračunava razliku između dviju timestamp, duration, redni broj – sve što obično smatramo analitičkim funkcijama. U ClickHouse mi ih računamo kroz nizove: prvo sabijamo podatke u niz, zatim na nizu radimo sve što želimo, a potom ih opet raširimo. To nije baš zgodno, zahtijeva ljubav prema funkcionalnom programiranju, barem, ali je jako fleksibilno.
Specijalne funkcije
Osim toga, u ClickHouse ima mnogo specijaliziranih funkcija. Na primjer, kako odrediti koliko se sesija odvija istovremeno? Tipičan zadatak za praćenje – odrediti maksimalno opterećenje jednim upitom. U ClickHouse ima specijalnu funkciju za ovu svrhu:
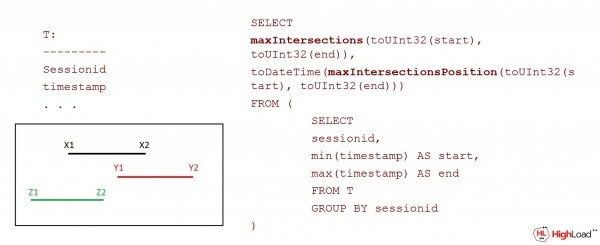
Uopće, za mnoge svrhe u ClickHouse-u postoje specijalne funkcije:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Ovo nije potpuni popis funkcija, svega ih ima 500-600. Savjet: sve funkcije u ClickHouse nalaze se u sistemskoj tablici (ne sve su dokumentirane, ali su sve zanimljive):
select * from system.functions order by nameClickHouse sam u sebi pohranjuje mnogo informacija o sebi, uključujući log tables, query_log, log praćenja, log operacija s blokovima podataka (part_log), log metrike, i sistemski log, koji obično piše na disk. Log metrike – to je time-series u ClickHouse na samom ClickHouse: Baza podataka može sama sebi igrati ulogu time-series baza podataka, tako na neki način "proždire" samu sebe.
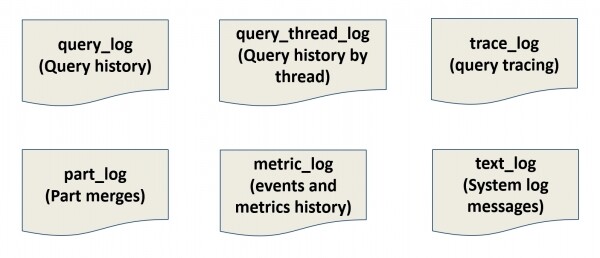
To je također jedinstvena stvar – ako već dobro obavljamo posao za time-series, zašto ne možemo sve što nam treba pohraniti sami u sebi? Nije nam potreban Prometheus, sve pohranjujemo u sebi. Povezali smo Grafana i sami sebe pratimo. Međutim, ako ClickHouse padne, nećemo vidjeti zašto, stoga se obično tako ne radi.
Veliki klaster ili mnogo malih ClickHouse
Što je bolje – jedan veliki klaster ili mnogo malih ClickHouse-a? Tradicionalni pristup DWH – to je veliki klaster u kojem se dodjeljuju sheme za svaku aplikaciju. Došli smo do administratora baze podataka – dajte nam shemu, i ona nam je izdana:
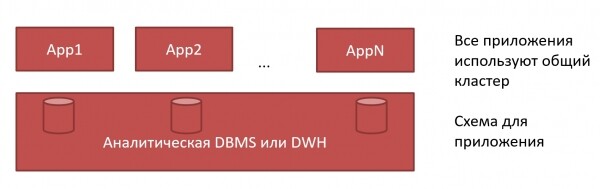
U ClickHouse to se može učiniti drugačije. Svakoj aplikaciji možemo dati vlastiti ClickHouse:
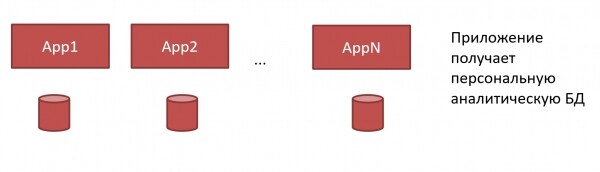
Više nam ne treba veliki monstruozni DWH i nesuradljivi administratori. Svakoj aplikaciji možemo dati vlastiti ClickHouse, a programer to može učiniti sam, jer ClickHouse vrlo se lako instalira i ne zahtijeva složeno administriranje:
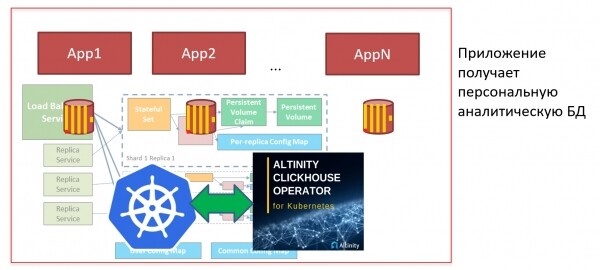
No ako imamo mnogo ClickHouse, i često ga moramo instalirati, želimo automatizirati taj proces. Za to možemo, na primjer, koristiti Kubernetes i clickhouse-operator. U Kubernetes ClickHouse može se postaviti „jednim klikom“: mogu pritisnuti dugme, pokrenuti manifest i baza podataka je spremna. Mogu odmah stvoriti shemu, početi učitavati metrike i za 5 minuta već imam gotovu nadzornu ploču Grafana. Tako je sve jednostavno!
Što na kraju?
Dakle, ClickHouse je:
- Brzo. To je svima poznato.
- Jednostavno. Malo je sporno, ali mislim da je teško u učenju, lako u borbi. Ako razumijete kako ClickHouse radi, dalje je sve vrlo jednostavno.
- Univerzalno. Odgovara različitim scenarijima: DWH, Time Series, Log Storage. Ali ovo nije OLTP baza podataka, zato ne pokušavajte raditi kratke umetke i čitanja.
- Zanimljivo. Vjerovatno je onaj tko radi s ClickHouse, doživio mnogo zanimljivih trenutaka u dobrom i lošem smislu. Na primjer, izašao je nova verzija, sve je prestalo raditi. Ili kada ste se borili s problemom dva dana, ali nakon pitanja u Telegram chatu, problem je riješen za dvije minute. Ili kao na konferenciji prilikom izlaganja Alekse Milovidova, screenshot iz ClickHouse je srušio prijenos HighLoad++. Ove vrste stvari se stalno događaju i čine naš život s ClickHouse živahnim i zanimljivim!
Prezentaciju možete pogledati .
Očekivani susret programera visoko opterećenih sustava na održat će se 9. i 10. studenog u Skolkovu. Konačno će to biti offline konferencija (iako uz poštivanje svih mjera opreza), jer energiju HighLoad++ nije moguće pakirati u online.
Za konferenciju pronalazimo i prikazujemo vam primjere o maksimalnim mogućnostima tehnologija: HighLoad++ je bio, jest i bit će jedino mjesto gdje možete za dva dana saznati kako funkcioniraju Facebook, Yandex, VKontakte, Google i Amazon.
Održavajući naše sastanke neprekidno od 2007. godine, ove godine sastat ćemo se po 14. put. Tijekom tog vremena konferencija je narasla deset puta, prošle godine ključni događaj industrije okupio je 3339 sudionika, 165 predavača, a istovremeno se održavalo 16 trakova.
Prošle godine bilo je 20 autobusa, 5280 litara čaja i kave, 1650 litara voćnog napitka i 10200 bočica vode. Također 2640 kilograma hrane, 16000 tanjura i 25000 čaša. Usput, za novac zarađen od reciklirane papira, posadili smo 100 sadnica hrasta 🙂Ulaznice se mogu kupiti , primiti novosti o konferenciji — , a razgovarati — na svim društvenim mrežama: , , i .
Izvor: habr.com
