

Nedavno sam pričao o tome kako standardni recepti iz PostgreSQL baze. Danas ćemo razgovarati o tome kako učiniti zapis u Bazi podataka efikasnijim bez korištenja bilo kakvih "okvira" u konfiguraciji — samo pravilno organizirajući tokove podataka.
#1. Секционирование
Članak o tome kako i zašto je važno organizirati već je bio, ovdje ćemo govoriti o primjeni nekih pristupa u okviru našeg .
"Stari dani..."
Izvorno, kao i svaki MVP, naš projekt je započeo pod prilično malim opterećenjem — praćenje se vršilo samo za desetero najkritičnijih servera, sve tablice su bile relativno kompaktne... Ali vrijeme je prolazilo, broj praćenih hostova je rastao, i pokušavajući još jednom nešto učiniti s jednom od tablica veličine 1.5TB, shvatili smo da je moguće živjeti tako, ali veoma nezgodno.
Dani su bili gotovo bajkoviti, korištene su različite verzije PostgreSQL 9.x, tako da je cijelo sekcioniranje moralo biti rađeno "ručno" — putem nasljeđivanja tablica i okidača rute s dinamičkim EXECUTE.
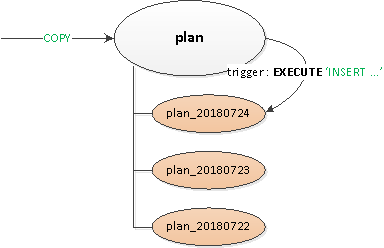
Konačno rješenje je bilo dovoljno univerzalno da se može primijeniti na sve tablice:
- Objavljena je prazna "zaglavna" roditeljska tablica, na kojoj su opisani svi potrebni indeksi i okidači.
- Zapis s gledišta klijenta vršen je u "korijensku" tablicu, a unutar uz pomoć okidača rute
BEFORE INSERTzapis je "fizički" umetnut u potrebnu sekciju. Ako sekcija još nije postojala — uhvatili smo izuzetak i … - … uz pomoć po uzorku roditeljske tablice stvarala se sekcija s ograničenjem na potrebni datum, kako bi se prilikom izvlačenja podataka čitanje vršilo samo u njoj.
PG10: prvi pokušaj
Međutim, sekcioniranje putem nasljeđivanja historijski nije bilo vrlo prilagođeno za rad s aktivnim tokom zapisa ili velikim brojem sekcija-potomaca. Na primjer, može se sjetiti da je algoritam izbora potrebne sekcije imao kvadratnu složenost, što uz 100+ sekcija radi, sami razumijete kako...
U PG10 je ova situacija značajno optimizirana, implementirajući podršku . Stoga smo ga odmah pokušali primijeniti odmah nakon migracije pohrane, ali…
Kako smo saznali nakon pretraživanja vodiča, nativno sekcionirana tablica u ovoj verziji:
- ne podržava opis indeksa
- ne podržava okidače
- ne može biti ničiji "potomak"
- ne podržava
INSERT ... ON CONFLICT - ne može automatski generirati sekciju
Bolno udarivši o dno, shvatili smo da bez modifikacije aplikacije nećemo moći proći, i odložili daljnja istraživanja na pola godine.
PG10: druga prilika
Dakle, počeli smo rješavati nastale probleme redom:
- Budući da su okidači i
ON CONFLICTpokazali se potrebnima na nekoliko mjesta, za njihovo izvršavanje napravili smo privremenu proksi-tablicu. - Riješili smo se "rutiranja" u okidačima — odnosno od
EXECUTE. - Izvukli smo odvojeno predložak-tablicu sa svim indeksima, tako da oni čak nisu ni prisutni na proksi-tablici.
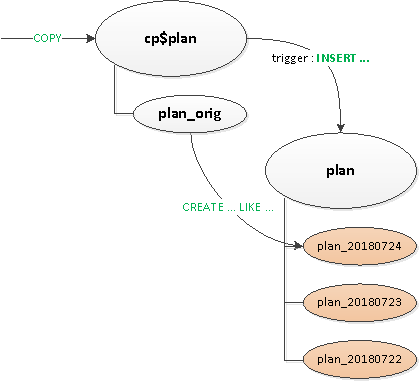
Napokon, nakon svega toga, nativno smo sekcionirali glavnu tablicu. Stvaranje nove sekcije za sada je ostalo na savjesti aplikacije.
"Režemo" rječnike
Kao i u svakom analitičkom sustavu, imali smo i mi "činjenice" i "rezove" (rječnici). U našem slučaju, kao takvi, pojavili su se, na primjer, jednoličnih sporih upita ili tekst samog upita.
"Činjenice" su nam već bile sekcionirane po danima, tako da smo mirno brisali zastarjele sekcije, a one nam nisu smetale (logovi!). Ali, s rječnicima je bio problem...
Ne može se reći da ih je bilo previše, ali otprilike na 100TB "činjenica" dobio se rječnik od 2.5TB.. Iz takve tablice nije lako ništa izbrisati, ni komprimirati u razumnom vremenu, a i zapis u nju postajao je sve sporiji.
Izgleda kao rječnik… u njemu bi svaki zapis trebao biti predstavljen upravo jednom… i to je točno, ali!.. Nitko nam ne brani imati po jedan rječnik za svaki dan! Da, to donosi određenu suvišnost, ali omogućuje:
- brže pisanje/čitanje zahvaljujući manjoj veličini sekcije
- trošiti manje memorije zbog rada s kompaktnijim indeksima
- pohraniti manje podataka zahvaljujući mogućnosti brzog brisanja zastarjelih
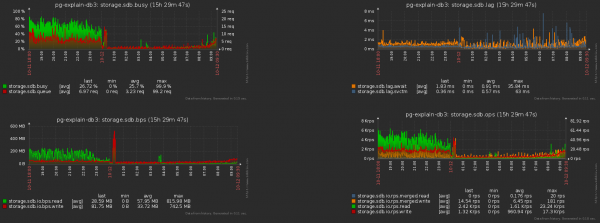
Kao rezultat cijelog kompleksa mjera opterećenje CPU-a smanjeno je za ~30%, na disku — za ~50%:
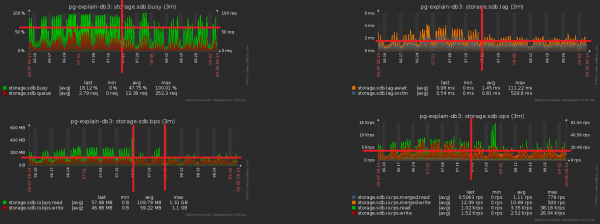
Nastavili smo zapisivati u bazu iste podatke, ali s manjim opterećenjem.
#2. Эволюция и рефакторинг БД
Dakle, stali smo na tome da imamo sekciju za svaki dan s podacima. U suštini, CHECK (dt = '2018-10-12'::date) je ključ sekcioniranja i uvjet koji određuje upisivanje zapisa u konkretnu sekciju.
Budući da se svi izvještaji u našoj usluzi kreiraju prema određenom datumu, indeksi iz "nesekcioniranih vremena" također su bili svi (Server, Datum, Predložak plana), (Server, Datum, Čvor plana), (Datum, Klasa pogreške, Server),…
No sada svaka sekcija ima svoje instance svakog od tih indeksa… I unutar svake sekcije datum je konstantan… Dakle, sada jednostavno upisujemo konstantu kao jedno od polja u svaki takav indeks, što povećava i njegovu veličinu i vrijeme pretraživanja, ali ne donosi ništa korisno. Ostavili smo sebi zamke, ups… Pristup optimizaciji je očigledan — jednostavno
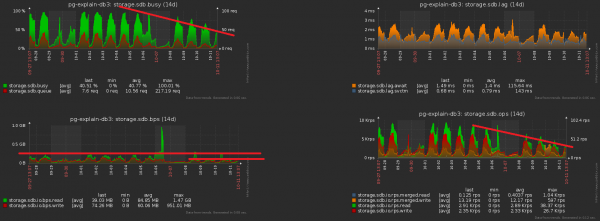
uklanjamo polje s datumom iz svih indeksa na sekcioniranim tablicama. U našim količinama, dobitak je otprilike 1TB/tjedan A sada primijetimo da tu terabajt još treba nekako zapisati. To znači da dodatno!
disk također treba manje opterećivati ! Na ovoj slici dobro se vidi postignuti učinak nakon čišćenja kojem smo posvetili tjedan:Jedna od velikih problema opterećenih sustava je
#3. «Размазываем» пиковую нагрузку
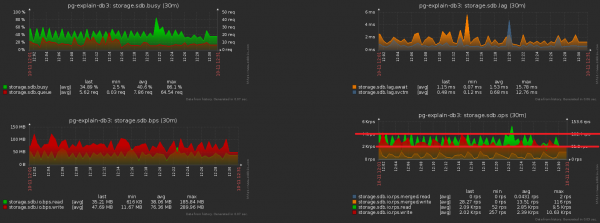
višak sinkronizacije nepotrebnih operacija. Ponekad "jer nisu primijetili", ponekad "jer je tako bilo lakše", ali prije ili kasnije to se mora eliminirati. Približimo prethodnu sliku — i vidimo da naš disk
ima "opterećenje" s dvostrukom amplitudom između susjednih mjerenja, što očito "statistički" ne bi smjelo biti pri tolikom broju operacija: To je dovoljno lako postići. Naš nadzor obuhvatio je već
skoro 1000 servera , svaki od njih obrađuje se zasebnim logičkim tokom, a svaki tok pohranjuje akumulirane informacije za slanje u bazu s određenom periodičnošću, otprilike ovako:setInterval(sendToDB, interval)
Problemi su suštinski u tome dasvi tokovi započinju otprilike u isto vrijeme , pa se trenuci slanja gotovo uvijek poklapaju "do tačke". Ups br. 2…Na sreću, to se može lako ispraviti,
dodavanjem "slučajne" razlike u vremenu: po vremenu:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
Treći tradicionalni problem visokog opterećenja — nedostatak predmemorije tamo gdje bi on mogao biti.
Na primjer, omogućili smo analizu po čvorovima plana (svi ovi Seq Scan on users), ali odmah pomisliti da su oni, u masi, isti — zaboravili smo.
Ne, naravno, u bazu se ništa ne piše ponovo, to odbacuje okidač s INSERT ... ON CONFLICT DO NOTHING. Ali do baze ti podaci ipak dolaze, a i nepotrebno čitanje za provjeru sukoba moramo raditi. Ups br. 3…
Razlika u broju zapisa poslanih u bazu prije/poslije uključivanja predmemorije — očita je:
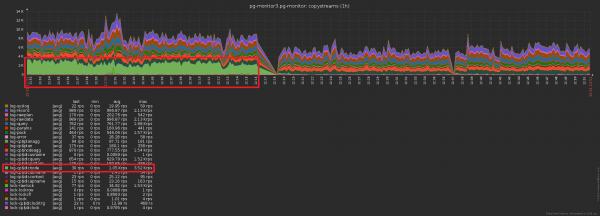
A ovo je — prateći pad opterećenja na skladištu:
U konačnici
„Terabajt-u-dan“ samo zvuči strašno. Ako sve radite ispravno, to je samo 2^40 bajtova / 86400 sekundi = ~12.5MB/s, što su čak i stolni IDE diskovi mogli održati. 🙂
A ako govorimo ozbiljno, čak i uz deseterostruko „iskrivljenje“ opterećenja tijekom dana, možete se lako uklopiti u mogućnosti modernih SSD-a.
Izvor: habr.com
