

Koja verzija firmvera je "ispravna" i "funkcionalna"? Ako storage sustav jamči dostupnost od 99,9999%, znači li to da će raditi neprekidno čak i bez ažuriranja softvera? Ili, naprotiv, za postizanje maksimalne dostupnosti uvijek treba instalirati najnoviji firmver? Pokušat ćemo odgovoriti na ta pitanja oslanjajući se na naše iskustvo.
Kratak uvod
Svi razumijemo da svaka verzija softverskog rješenja, bilo da se radi o operativnom sustavu ili upravljačkom programu za neki uređaj, često sadrži nedostatke/bugove i druge "specijalnosti" koje se mogu, ili ne, "pojaviti" do kraja životnog ciklusa opreme, te se "otkriti" samo pod određenim uvjetima. Količina i važnost takvih nijansi ovisi o složenosti (funkcionalnosti) softvera i o kvaliteti testiranja tijekom njegove izrade.
Često korisnici ostaju na "izvornoj verziji firmvera" (poznato — "radi, ne diraj") ili uvijek instaliraju najnoviju verziju (u njihovom poimanju, najnovija znači najfunkcionalnija). Mi primjenjujemo drugačiji pristup — proučavamo bilješke o izdanju za sav korišteni opremu i pažljivo biramo odgovarajući firmver za svaki uređaj.
Do ovog smo zaključka došli iskustvom. Na vlastitim primjerima korištenja objasnit ćemo zašto obećana dostupnost od 99,9999% storage sustava ne znači ništa ako ne pratite ažuriranja i opise softvera na vrijeme. Naš slučaj može biti koristan korisnicima storage sustava bilo kojeg dobavljača, jer se slična situacija može dogoditi s opremom bilo kojeg proizvođača.
Odabir novog sustava za pohranu podataka
Krajem prošle godine, našoj infrastrukturi dodan je zanimljiv sustav za pohranu podataka: mlađi model iz linije IBM FlashSystem 5000, koji je u trenutku nabave bio poznat pod nazivom Storwize V5010e. Sada se prodaje pod nazivom FlashSystem 5010, ali zapravo je to ista hardverska osnova s istim Spectrum Virtualize unutar.
Postojanje jedinstvenog sustava upravljanja predstavlja, inace, glavnu razliku IBM FlashSystem-a. Kod modela iz nižeg razreda, gotovo se ne razlikuje od modela s višim performansama. Odabir određenog modela samo daje odgovarajuću hardversku osnovu, čije karakteristike omogućuju korištenje određenih funkcionalnosti ili osiguranje višeg nivoa skalabilnosti. Softver tada identificira hardver i pruža neophodno i dovoljno funkcionalnosti za ovu platformu.
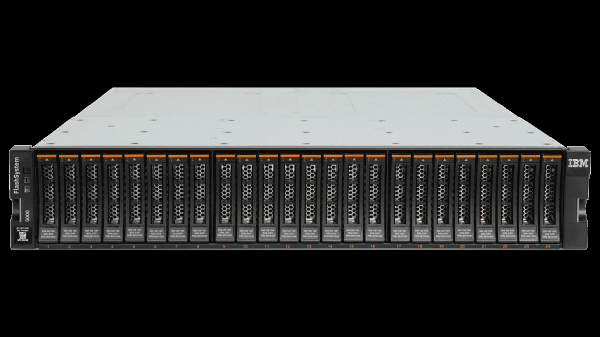 IBM FlashSystem 5010
Kratko o našem modelu 5010. To je dvokontrolerski blokovski sustav pohrane podataka ulaznog razreda. Može smjestiti NLSAS, SAS i SSD diskove. Smještaj NVMe diskova nije dostupan, budući da je ovaj model Skladišni sustav pozicioniran za rješavanje zadataka koji ne zahtijevaju performanse NVMe diskova.
Skladišni sustav je nabavljen za pohranu arhivskih informacija ili podataka do kojih ne dolazi često. Stoga nam je bio dovoljan standardni set njegovih funkcionalnosti: tiering (Easy Tier), Thin Provision. Performanse na NLSAS diskovima na razini od 1000-2000 IOPS također su nas zadovoljile.
Naše iskustvo — kako nismo pravovremeno ažurirali firmware
Sada o samom ažuriranju softvera. U trenutku kupnje sustav je imao pomalo zastarjelu verziju softvera Spectrum Virtualize, a to jest, 8.2.1.3.
Istražili smo opis firmware-a i planirali ažuriranje na 8.2.1.9. Da smo bili malo brži, ne bi bilo ovog članka — na novijem firmware-u greška se ne bi dogodila. Međutim, iz određenih razloga, ažuriranje ovog sustava je odloženo.
Kao rezultat male kašnjenja u ažuriranju, došlo je do izuzetno neugodnog scenarija, kao što je opisano u linku: .
Da, u firmware-u te verzije relevantan je tzv. APAR (Authorized Program Analysis Report) HU02104. Manifestira se na sljedeći način. Pod opterećenjem, u određenim okolnostima, počinje prepunjavanje cache-a, a zatim sustav prelazi u zaštitni režim, u kojem isključuje ulaz-izlaz za pool (Pool). U našem slučaju to je izgledalo kao isključenje 3 diska za RAID grupu u RAID 6 režimu. Isključenje traje 6 minuta. Nakon toga, pristup volumenima u Pool-u se obnavlja.
Ako netko nije upoznat sa strukturom i nazivima logičkih entiteta u kontekstu IBM Spectrum Virtualize, sada ću kratko objasniti.
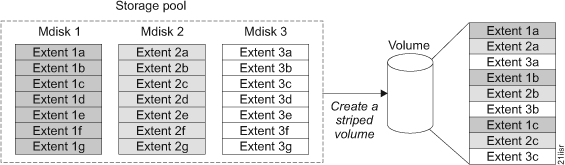 Struktura logičkih elemenata Skladišta podataka
Diskovi se grupiraju u skupine koje se nazivaju MDisk (Upravljani disk). MDisk može predstavljati klasični RAID (0,1,10,5,6) ili virtualizovani – DRAID (Distribuirani RAID). Korišćenje DRAID omogućava povećanje performansi skupa, jer će se koristiti svi diskovi u grupi, a vreme obnove će se smanjiti, zahvaljujući tome što će se obnavljati samo određeni blokovi, a ne svi podaci s oštećenog diska.
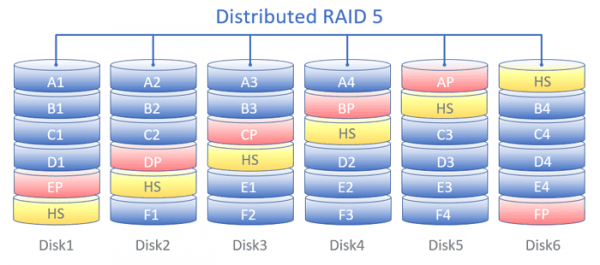 Raspodela blokova podataka po diskovima prilikom korišćenja Distribuiranog RAID-a (DRAID) u modu RAID-5.
Ova šema prikazuje logiku rada obnove DRAID-a u slučaju kvara jednog diska:
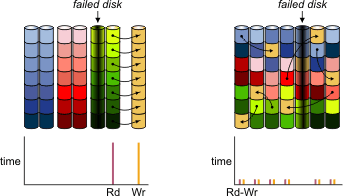 Logika rada obnove DRAID-a pri kvaru jednog diska
Dalje, jedan ili više MDisk formiraju takozvani Pool. Unutar jednog pool-a nije preporučljivo koristiti MDisk s različitim nivoima RAID/DRAID na diskovima istog tipa. Nećemo se previše zadržavati na tome, pošto planiramo govoriti o tome u okviru jednog od sledećih članaka. I, zapravo, Pool se deli na Toma (Volumes), koji se predstavljaju putem nekog od protokola pristupa blokovima prema hostovima.
Dakle, zbog situacije opisane u APAR HU02104, zbog logičkog kvara tri diska, prestao je da funkcioniše MDisk, što je, zauzvrat, dovelo do kvara u radu Pool-a i odgovarajućih Tomova.
Budući da su ovi sistemi prilično "pametni", mogu se povezati sa cloud sistemom za nadgledanje IBM Storage Insights, koji automatski, pri pojavi kvara, šalje zahtev za podršku u IBM. Kreira se zahtev i stručnjaci IBM-a u daljinskom režimu vrše dijagnostiku i kontaktiraju korisnika sistema.
Zahvaljujući tome, pitanje je rešen brzo i od podrške je dobijena preporuka za ažuriranje našeg sistema na odabranu verziju softvera 8.2.1.9, u kojoj je to već bilo ispravljeno. To potvrđuje .
Zaključci i naše preporuke
Kako kažu: „dobro je ono što se dobro završi“. Greška u firmwareu nije izazvala ozbiljne probleme – rad servera je obnovljen u rekordnom vremenu i bez gubitka podataka. Neki klijenti su morali ponovo pokrenuti virtuelne mašine, ali u globalu smo bili spremni na negativnije posledice, jer svakodnevno pravimo rezervne kopije svih elemenata infrastrukture i klijentskih mašina.
Dobilo smo potvrdu da čak i pouzdani sistemi s 99,9999% obećane dostupnosti zahtevaju pažnju i pravovremeno održavanje. Na osnovu situacije izvukli smo nekoliko zaključaka i delimo naše preporuke:
Obavezno treba pratiti izlazak ažuriranja, proučavati Release Notes u potrazi za ispravkama potencijalno kritičnih tačaka i pravovremeno izvoditi planirana ažuriranja.
To je organizacijska i čak prilično očigledna stvar na kojoj se, činilo bi se, ne treba previše zadržavati. Međutim, na ovom „mirnom mestu“ se može relativno lako spotaknuti. U stvari, upravo je ovaj trenutak dodao gore navedene neprijatnosti. Pristupite sastavljanju pravilnika o ažuriranju veoma pažljivo i jednako pažljivo pratite njegovo poštovanje. Ova tačka više se odnosi na pojam „disciplina“.
Uvek je bolje održavati sistem sa najnovijom verzijom softvera. Pri čemu, aktuelna verzija nije ona koja ima veći broj oznake, već ta koja ima kasniji datum izlaska.
Na primer, IBM za svoje sisteme skladištenja podataka održava bar dva ažuriranja softvera. U trenutku pisanja ovog članka, to su 8.2 i 8.3. Ažuriranja za 8.2 izlaze ranije. Posle toga, sa malim zakašnjenjem obično izlazi odgovarajuće ažuriranje za 8.3.
Izdanja 8.3 imaju niz funkcionalnih prednosti, na primer, mogućnost proširivanja MDisk (u DRAID režimu) dodavanjem jednog ili više novih diskova (ova mogućnost je uvedena sa verzijom 8.3.1). To je prilično osnovna funkcionalnost, ali u 8.2, nažalost, nema takve mogućnosti.
Ako nije moguće ažurirati iz bilo kojeg razloga, za verzije softvera Spectrum Virtualize koje prethode verzijama 8.2.1.9 i 8.3.1.0 (gdje je opisani problem aktuelan), IBM tehnička podrška preporučuje smanjenje performansi sustava na razini skladišta, kao što je prikazano na donjoj slici (snimak napravljen u rusificiranoj verziji GUI-a). Vrijednost 10000 IOPS je samo primjer i odabire se prema karakteristikama vašeg sustava.
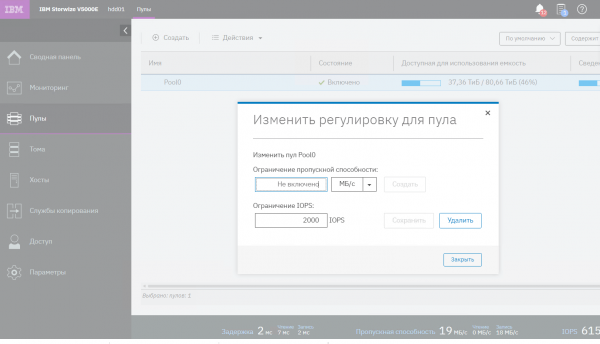 Ograničenje performansi SAN-a IBM
Potrebno je pravilno izračunati opterećenje na sustavima pohrane i spriječiti preopterećenje. Za to se može koristiti bilo IBM-ov kalkulator (ako je dostupan), pomoć partnera ili vanjski resursi. Također je važno razumjeti profil opterećenja na sustavu pohrane, s obzirom da se performanse u MB/s i IOPS značajno razlikuju s obzirom na najmanje sljedeće parametre:
vrsta operacije: čitanje ili pisanje,
veličina blok operacije,
postotno odnosi čitanja i pisanja u ukupnom toku ulazno-izlaznih operacija.
Također, na brzinu izvršavanja operacija utječe i način na koji se čitaju blokovi podataka: sekvencijalno ili slučajno. Prilikom izvršavanja više operacija pristupa podacima s strane aplikacije, postoji pojam ovisnih operacija. I to je također poželjno uzeti u obzir. Sve to može pomoći u razmatranju podataka iz brojila performansi operativnog sustava, sustava pohrane, poslužitelja/hypervizora, kao i razumijevanje specifičnosti rada aplikacija, DBMS-a i drugih "potrošača" diskovnih resursa.
I na kraju, svakako imati rezervne kopije u aktuelnom i funkcionalnom stanju. Raspored rezervnog kopiranja treba postaviti prema prihvatljivim vrijednostima RPO za poslovanje i povremeno obavezno provjeravati integritet rezervnih kopija (mnogi proizvođači softvera za rezervno kopiranje implementirali su u svojim proizvodima automatiziranu provjeru) radi osiguravanja prihvatljive vrijednosti RTO.
Hvala vam što ste pročitali do kraja.
Spremni smo odgovoriti na vaša pitanja i komentare. Također, u kojem redovito provodimo akcije (popusti na IaaS i izvlačenje promotivnih kodova do 100% na VPS), pišemo zanimljive vijesti i najavljujemo nove članke na blogu Habra.
Izvor: habr.com
