

TL;DR: Prije četiri godine napustio sam Google s idejom novog alata za praćenje poslužitelja. Ideja je bila spojiti u jednu uslugu obično izolirane funkcije i analize logova, prikupljanja metrika, i nadzorne ploče. Jedan od principa je da usluga mora biti zaista brza, omogućavajući devops timovima lako, interaktivno i ugodno iskustvo rada. To zahtijeva obradu skupova podataka do nekoliko gigabajta u djeliću sekunde, unutar budžeta. Postojeći alati za rad s logovima često su spori i nezgrapni, stoga smo se suočili s dobrim zadatkom: razviti alat koji će korisnicima donijeti nove doživljaje rada.
U ovom članku opisujemo kako smo u Scalyru riješili ovaj problem, primjenjujući metode stare škole, pristup grubom snagom, eliminirajući suvišne slojeve i izbjegavajući složene strukture podataka. Ove lekcije možete primijeniti na vlastite inženjerske zadatke.
Snaga stare škole
Analiza logova obično počinje pretraživanjem: pronađite sve poruke koje odgovaraju određenom obrascu. U Scalyru to su deseci ili stotine gigabajta logova s mnogih poslužitelja. Moderni pristupi obično podrazumijevaju gradnju složene strukture podataka optimizirane za pretraživanje. Naravno, vidio sam to u Googleu, gdje su prilično dobri u tim stvarima. No, mi smo se odlučili za mnogo grublji pristup: linearno skeniranje logova. I to je uspjelo — pružamo sučelje s pretraživanjem koje je red veličine brže od konkurencije (pogledajte animaciju na kraju).
Ključno otkriće je da su moderni procesori zaista vrlo brzi u jednostavnim, direktnim operacijama. Ovo je lako zanemariti u složenim, višeslojnim sustavima koji ovise o brzini I/O i mrežnim operacijama, a takvi su sustavi danas vrlo rašireni. Tako smo razvili dizajn koji minimizira broj slojeva i suvišnih ostataka. S nekoliko procesora i poslužitelja paralelno, brzina pretraživanja dostiže 1 TB u sekundi.
Ključne uvjete iz ovog članka:
- Grubo pretraživanje je prilično održiv pristup za rješavanje stvarnih, velikih problema.
- Brute force je tehnika dizajniranja, a ne oslobađanje od posla. Kao i svaka tehnika, ona je bolje prilagođena nekim problemima nego drugima, a može se implementirati loše ili dobro.
- Brute force je posebno dobar za postizanje stabilno performansi.
- Efikasna upotreba brute force-a zahtevaju optimizaciju koda i pravovremeno korišćenje dovoljnog broja resursa. Ona je pogodna ako su vaši serveri pod velikim opterećenjem koje nije povezano s korisnicima, dok su korisničke operacije u prvom planu.
- Performanse zavise od dizajna celog sistema, a ne samo od algoritma unutrašnje petlje.
(Ovaj članak opisuje pretraživanje podataka u memoriji. U većini slučajeva, kada korisnik pretražuje logove, Scalyr serveri su ih već keširali. U sledećem članku ćemo razgovarati o pretraživanju nekeširanih logova. Primenjuju se isti principi: efikasan kod, metoda brute force-a uz velike računarske resurse).
Metod brute force-a
Tradicionalno, pretraživanje u velikom skupu podataka vrši se po indeksu ključnih reči. U odnosu na servere logova, to znači pretraživanje svake jedinstvene reči u dnevniku. Za svaku reč potrebno je sastaviti listu svih uključenja. To omogućava lako pronalaženje svih poruka sa tom rečju, poput 'error', 'firefox' ili 'transaction_16851951' — jednostavno gledajući u indeks.
Koristio sam ovaj pristup u Google-u i dobro je funkcionisao. Ali u Scalyr-u pretražujemo logove bajt po bajt.
Zašto? Sa apstraktne algoritamske tačke gledišta, indeksi ključnih reči su mnogo efikasniji od brute force pretrage. Međutim, mi ne prodajemo algoritme, prodajemo performanse. A performanse nisu samo algoritmi, već i sistemski inženjering. Moramo uzeti u obzir sve: količinu podataka, vrstu pretrage, dostupnu opremu i softverski kontekst. Odlučili smo da za naš konkretan problem opcija poput 'grep' bolje odgovara od indeksa.
Indeksi su odlični, ali imaju svoja ograničenja. Jednu reč je lako pronaći. Ali pretraživanje poruka sa više reči, poput 'googlebot' i '404' — već je mnogo složenije. Pretraživanje fraze poput 'uncaught exception' zahteva glomazniji indeks koji beleži ne samo sve poruke sa tom rečju, već i konkretno mesto reči.
Prava poteškoća javlja se kada tražite ne riječi. Pretpostavimo da želite vidjeti koliko prometa dolazi od botova. Prva pomisao je pretraživanje u logovima prema riječi ‘bot’. Tako ćete pronaći neke botove: Googlebot, Bingbot i mnoge druge. No, ovdje ‘bot’ nije riječ, već njezin dio. Ako tražite ‘bot’ u indeksu, nećemo pronaći poruke sa riječju ‘Googlebot’. Ako provjeravate svaku riječ u indeksu i zatim skenirate indeks prema pronađenim ključnim riječima, pretraživanje će se značajno usporiti. Kao rezultat toga, neki programi za obradu logova ne dopuštaju pretraživanje prema dijelovima riječi ili (u najboljem slučaju) omogućuju korištenje posebne sintakse s nižim performansama. To želimo izbjeći.
Još jedan problem je interpunkcija. Želite pronaći sve zahtjeve od 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Napokon, inženjeri vole moćne alate, a ponekad se problem može riješiti samo regularnim izrazom. Indeks ključnih riječi nije baš pogodan za to.
Osim toga, indeksi su složeni. Svaka poruka treba biti dodana u nekoliko listi ključnih riječi. Ove liste trebaju se neprekidno održavati u formatu pogodnom za pretraživanje. Zahtjevi s frazama, dijelovima riječi ili regularnim izrazima trebaju se prevoditi u operacije s više lista, a rezultati skenirati i kombinirati kako bi se dobio konačni skup. U kontekstu velikih višekorisničkih usluga, ta složenost stvara probleme s performansama koji nisu vidljivi prilikom analize algorithama.
Indeksi ključnih riječi također zauzimaju mnogo prostora, a pohrana je glavni stavka troška u sustavu upravljanja logovima.
S druge strane, svaki pretraživački upit može potrošiti veliku računarsku snagu. Naši korisnici cijene brzo pretraživanje po jedinstvenim upitima, ali se takvi upiti javljaju relativno rijetko. Za tipične pretraživačke upite, poput onih u nadzornoj ploči, primjenjujemo posebne tehnike (opisat ćemo ih u sljedećem članku). Drugi upiti su dovoljno rijetki, stoga rijetko obrađujemo više od jednog odjednom. No, to ne znači da naši serveri nisu zauzeti: zaduženi su za primanje, analizu i kompresiju novih poruka, procjenu obavijesti, kompresiju starih podataka i slično. Na taj način imamo prilično značajan rezervoar procesora koji se mogu angažirati za izvršavanje upita.
Brute force funkcioniše ako imate grub problem (i puno snage)
Brute force najbolje djeluje na jednostavnim zadacima s malim internim ciklusima. Često možete optimizirati unutarnji ciklus da radi na vrlo visokim brzinama. Ako je kod složen, mnogo je teže optimizirati ga.
Prvobitno je naš kod za pretraživanje imao prilično veliki unutarnji ciklus. Čuvamo poruke na stranicama od 4K; svaka stranica sadrži određene poruke (u UTF-8) i metapodatke za svaku poruku. Metapodatci su struktura u kojoj su kodirane dužina vrijednosti, unutarnji ID poruke i druga polja. Ciklus pretraživanja izgledao je ovako:
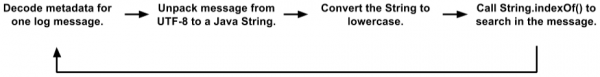
Ovo je pojednostavljena verzija u odnosu na stvarni kod. No, čak i ovdje se može primijetiti nekoliko lokacija objekata, kopija podataka i poziva funkcija. JVM prilično dobro optimizira pozive funkcija i alocira prolazne objekte, pa je ovaj kod djelovao bolje nego što smo to zaslužili. Tijekom testiranja, klijenti su ga prilično uspješno koristili. No, na kraju smo prešli na novi nivo.
(Možete pitati zašto čuvamo poruke u ovom formatu s stranicama od 4K, tekstom i metapodacima, umjesto da radimo direktno s zapisima. Ima mnogo razloga, koji se svode na to da je interna Scalyrova arhitektura više poput distribuirane baze podataka nego datotečnog sustava. Tekstualna pretraga često je u kombinaciji s filtrima sličnim onima iz baza podataka na poljima nakon obrade zapisa. Možemo istovremeno pretraživati tisuće zapisa, a obične tekstualne datoteke nisu prikladne za naše transakcijsko, replicirano, distribuirano upravljanje podacima.)
Isprva se činilo da takav kod nije posebno prikladan za optimizaciju metodom brute force. "Pravi posao" je String.indexOf() čak nije dominirao u CPU profilu. To znači da optimizacija samo ove metode ne bi donela značajnu korist.
Zadesilo se da metapodaci čuvamo na početku svake stranice, a tekst svih poruka je u UTF-8 formatu zapakovan na drugom kraju. Iskoristivši to, prepravili smo petlju za pretraživanje da odmah pretražuje cijelu stranicu:
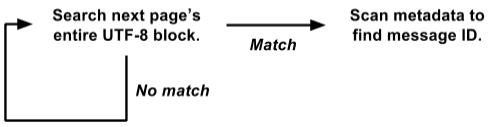
Takva verzija radi direktno na prikazu raw byte[] i izvodi pretragu svih poruka odmah na cijeloj stranici od 4K.
Mnogo je lakše optimizirati za metodu brute force. Interna pretraživačka petlja poziva se simultano za cijelu stranicu od 4K, a ne odvojeno za svaku poruku. Nema kopiranja podataka, niti dodjeljivanja objekata. I složenije operacije s metapodacima pozivaju se samo kada postoji pozitivan rezultat, a ne za svaku poruku. Na taj način smo eliminirali tonu dodatnih troškova, a preostali teret koncentriran je u maloj internoj pretraživačkoj petlji, koja je dobro prilagodljiva daljnjoj optimizaciji.
Naš stvarni algoritam pretraživanja temelji se na . Sličan je Boyer–Moore algoritmu s preskočenjem otprilike dužine pretražene niza u svakom koraku. Glavna razlika je u tome što provjerava dva bajta odjednom kako bi minimizirao lažne podudarnosti.
Naša implementacija zahtijeva stvaranje pretraživačke tablice od 64K za svako pretraživanje, ali to je sitnica u usporedbi s gigabajtima podataka u kojima tražimo. Unutarnja petlja obrađuje nekoliko gigabajta u sekundi na jednom jezgru. U praksi stabilna izvedba iznosi oko 1,25 GB u sekundi po jezgru, s potencijalom za poboljšanje. Možemo eliminirati neke troškove izvan unutarnje petlje, a planiramo eksperimentirati s unutarnjom petljom na C umjesto na Javi.
Koristimo snagu
Razgovarali smo o tome da se pretraživanje po zapisima može implementirati "grubo", ali koliko "snage" imamo? Dosta.
1 jezgro: kada se pravilno koristi, jedno jezgro modernog procesora je prilično moćno samo po sebi.
8 jezgri: trenutno radimo na Amazonovim poslužiteljima hi1.4xlarge i i2.4xlarge SSD, od kojih svaki ima 8 jezgara (16 niti). Kao što je spomenuto, obično su ova jezgra zauzeta pozadinskim operacijama. Kada korisnik izvrši pretraživanje, pozadinske operacije se suspendiraju, oslobađajući svih 8 jezgara za pretraživanje. Pretraživanje se obično završava za djelić sekunde, nakon čega se pozadinski rad ponovo pokreće (program kontroliše kako bi osigurao da lavina pretraživačkih zahtjeva ne ometa važan pozadinski rad).
16 jezgara: za pouzdanost organiziramo poslužitelje u master/slave grupe. Svaki master ima podređeni SSD poslužitelj i jedan EBS. Ako glavni poslužitelj otkaže, SSD poslužitelj odmah preuzima njegovo mjesto. Gotovo cijelo vrijeme master i slave rade normalno, tako da je svaki blok podataka dostupan za pretraživanje na dva različita poslužitelja (podređeni EBS poslužitelj ima slabiji procesor, pa ga ne razmatramo). Dijelimo zadatak između njih, tako da ukupno imamo 16 jezgara dostupnih.
Mnoge jezgre: u bliskoj budućnosti podijelit ćemo podatke među poslužiteljima tako da svi sudjeluju u obradi svakog netrivijalnog zahtjeva. Svako jezgro će raditi. [Napomena: proveli smo plan i povećali brzinu pretraživanja na 1 TB/s, pogledajte napomenu na kraju članka].
Jednostavnost osigurava pouzdanost
Još jedna prednost metode grube sile je prilično stabilna izvedba. Općenito, pretraživanje nije previše osjetljivo na detalje zadatka i skupa podataka (mislim da se zato naziva "grubim").
Indeks ključnih riječi ponekad daje nevjerojatno brze rezultate, a u drugim slučajevima ne. Pretpostavimo da imate 50 GB logova u kojima se pojam 'customer_5987235982' pojavljuje točno tri puta. Pretraživanje tog pojma izravno iz indeksa pokazuje tri lokacije i završava odmah. No, složeno pretraživanje s wildcard znakovima može skenirati tisuće ključnih riječi i trajati dugo.
S druge strane, pretraživanje metodom brute-force za bilo koji upit odvija se otprilike istom brzinom. Traženje dugih riječi je bolje, ali čak i pretraživanje jednog znaka događa se prilično brzo.
Jednostavnost brute-force metode znači da je njezina učinkovitost blizu teorijskom maksimumu. Ovdje ima manje opcija za nepredviđeno preopterećivanje diskova, sukobe zbog zaključavanja, potrage po pokazivaču i tisuće drugih razloga za neuspjehe. Upravo sam pogledao upite koje su korisnici Scalyr-a postavili prošlog tjedna na našem najopterećenijem serveru. Bilo je 14,000 upita. Točno osam njih je trajalo više od jedne sekunde; 99% je izvršeno unutar 111 milisekundi (ako niste koristili alate za analizu logova, vjerujte: to je brzo).
Stabilna, pouzdana učinkovitost važna je za korisničko iskustvo servisa. Ako povremeno usporava, korisnici će ga smatrati nepouzdanim i neće ga rado koristiti.
Pretraživanje logova u akciji
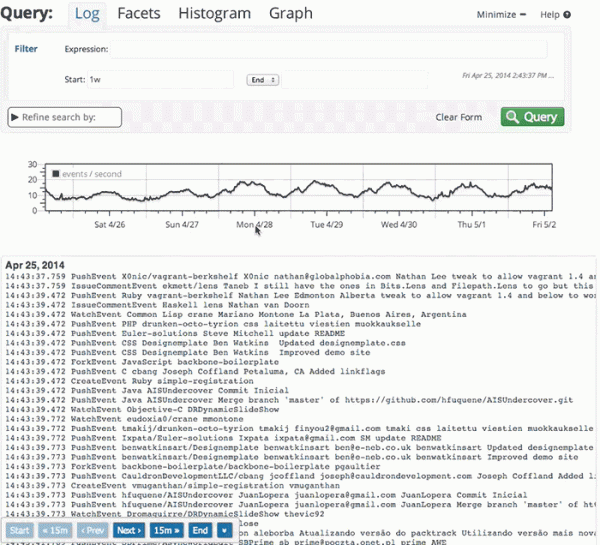
Evo male animacije koja prikazuje Scalyrovo pretraživanje u akciji. Imamo demo račun na koji importujemo svaki događaj iz svakog javnog repozitorija na Github-u. U ovoj demonstraciji istražujem podatke za tjedan: otprilike 600 MB neobrađenih logova.
Video je snimljen uživo, bez posebne pripreme, na mom desktopu (oko 5000 kilometara od servera). Učinak koji ćete vidjeti uvelike zahvaljuje , kao i brzom i pouzdanom backendu. Svaki put kada dođe do pauze bez indikatora 'loading', ja pravim pauzu kako biste mogli pročitati što namjeravam kliknuti.
Za kraj
Kada se obrađuju veliki opsezi podataka, važno je odabrati dobar algoritam, ali „dobar“ ne znači „kompliciran“. Razmislite o tome kako će vaš kod raditi u praksi. Neki faktori koji mogu biti od velike važnosti u stvarnom svijetu isključeni su iz teorijske analize algoritama. Jednostavniji algoritmi su lakši za optimizaciju i stabilniji su u rubnim situacijama.
Također razmislite o kontekstu u kojem će se kod izvršavati. U našem slučaju potrebni su dovoljno moćni serveri za upravljanje pozadinskim zadacima. Korisnici relativno rijetko iniciraju pretraživanje, stoga možemo posuditi cijelu grupu servera na kratko vrijeme potrebno za izvršenje svakog pretraživanja.
Metodom brute-force implementirali smo brz, pouzdan, fleksibilan pretraživač skupa logova. Nadamo se da će ove ideje biti korisne za vaše projekte.
Ispravka: naslov i tekst su promijenjeni s "Pretraživanje brzinom od 20 GB u sekundi" na "Pretraživanje brzinom od 1 TB u sekundi" kako bi se odrazilo povećanje performansi u posljednjih nekoliko godina. Ovo povećanje brzine prvenstveno je rezultat promjene tipa i broja EC2 servera koje danas pokrećemo za usluživanje povećane korisničke baze. U bliskoj budućnosti očekuju se promjene koje će osigurati još jedno značajno povećanje efikasnosti, i s nestrpljenjem čekamo priliku da o tome govorimo.
Izvor: habr.com
