

Nastavak prijevoda male knjige:
«Razumijevanje posrednika poruka»
autor: Jakub Korab, izdavač: O’Reilly Media, Inc., datum izdanja: lipanj 2017, ISBN: 9781492049296.
Prethodni prevedeni dio:
POGLAVLJE 3
Kafka
Kafka je razvijena u LinkedInu kako bi se zaobišla određena ograničenja tradicionalnih posrednika poruka i izbjegla potreba za konfiguracijom više posrednika poruka za različite interakcije 'tačka-tačka', što je opisano u ovoj knjizi u odjeljku 'Vertikalno i horizontalno skaliranje' na stranici 28. Scenariji korištenja u LinkedInu uglavnom su se temeljili na jednostranom usvajanju vrlo velikih količina podataka, poput klikova na stranicama i dnevnika pristupa, istovremeno omogućujući korištenje tih podataka više sustavima, bez utjecaja na performanse producenata ili drugih konzumenata. Uistinu, razlog postojanja Kafke je omogućiti takvu arhitekturu razmjene poruka koju opisuje Universal Data Pipeline.
S obzirom na taj konačni cilj, prirodno su se pojavili i drugi zahtjevi. Kafka treba:
- Biti izuzetno brza
- Pružati veliku propusnost pri razmjeni poruka
- Podržavati modele 'Izvjestitelj - Primalac' i 'Tačka - Tačka'
- Ne usporavati s dodavanjem konzumenata. Na primjer, performanse i redovi te tema u ActiveMQ pogoršavaju se s porastom broja konzumenata na odredištu
- Biti horizontalno skalabilna; ako jedan posrednik, koji pohranjuje (persists) poruke, može to raditi samo maksimalnom brzinom diska, tada je smisleno nadmašiti jedan primjerak posrednika za povećanje performansi
- Ograničiti pristup pohrani i ponovnom preuzimanju poruka
Kako bismo postigli sve to, u Kafki je usvojena arhitektura koja je redefinirala uloge i odgovornosti klijenata i posrednika za razmjenu poruka. JMS model je vrlo usmjeren na posrednika, gdje on odgovara za distribuciju poruka, dok se klijenti moraju brinuti samo o slanju i primanju poruka. Nasuprot tome, Kafka je orijentirana na klijenta, pri čemu klijent preuzima mnoge funkcije tradicionalnog posrednika, poput poštene distribucije relevantnih poruka među potrošačima, dok zauzvrat dobiva izuzetno brz i skalabilan posrednik. Za ljude koji su radili s tradicionalnim sustavima razmjene poruka, rad s Kafkom zahtijeva temeljne promjene u razmišljanju.
Ova inženjerska orijentacija dovela je do stvaranja infrastrukture za razmjenu poruka koja može povećati propusnost za više redova veličine u usporedbi s konvencionalnim posrednikom. Kao što ćemo vidjeti, ovaj pristup dolazi s kompromisima koji znače da Kafka nije prikladna za određene vrste opterećenja i instaliranih softverskih rješenja.
Ujedinjeni model odredišta
Kako bismo ispunili gornje zahtjeve, Kafka je spojila razmjenu poruka tipa „objava – pretplata” i „točka – točka” unutar jednog tipa odredišta — topika. To zbunjuje ljude koji su radili s sustavima razmjene poruka gdje se riječ „topik” odnosi na mehanizam za emitiranje, iz kojeg (iz topika) čitanje nije pouzdano. Topike u Kafki treba smatrati hibridnim tipom odredišta, prema definiciji koja je dana u uvodu ove knjige.
U ostatku ovog poglavlja, osim ako izričito ne navedemo drukčije, termin „topik” će se odnositi na topik Kafke.
Kako bismo u potpunosti razumjeli kako se topici ponašaju i koje garancije pružaju, prvo trebamo gledati kako su implementirani u Kafki.
Svaki topik u Kafki ima svoj dnevnik.
Prodavači koji šalju poruke u Kafka dodaju ih u ovaj log, dok ih korisnici čitaju iz loga koristeći pokazivače koji se neprekidno pomiču unaprijed. Povremeno Kafka briše najstarije dijelove loga, bez obzira na to jesu li poruke u tim dijelovima pročitane ili ne. Središnji dio dizajna Kafke je to što broker ne brine o tome jesu li poruke pročitane ili ne — to je odgovornost klijenta.
Izrazi "log" i "pokazivač" ne pojavljuju se u . Ovi dobro poznati termini se ovdje koriste kako bi olakšali razumijevanje.
Ovaj model se potpuno razlikuje od ActiveMQ, gdje se poruke iz svih redova pohranjuju u jedan log, a broker označava poruke kao obrisane nakon što su pročitane.
Sada ćemo malo detaljnije istražiti log teme.
Kafka log se sastoji od više particija (). Kafka jamči strogu održivost u svakoj particiji. To znači da će poruke zapisane u particiju u određenom redoslijedu biti pročitane u istom redoslijedu. Svaka particija implementirana je kao ciklična datoteka loga koja sadrži podskup (subset) svih poruka koje su proizvođači poslali u temu. Stvorena tema po defaultu sadrži jednu particiju. Ideja particija je središnja ideja Kafke za horizontalno skaliranje.
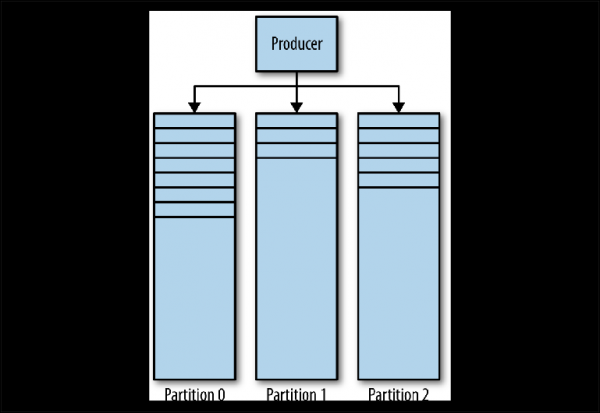
Slika 3-1. Particije Kafke
Kada proizvođač šalje poruku u Kafka temu, odlučuje u koju particiju će poslati poruku. O tome ćemo razgovarati detaljnije kasnije.
Čitanje poruka
Klijent koji želi čitati poruke upravlja imenovanim pokazivačem, nazvanim grupa potrošača (consumer group), koji ukazuje na pomak (offset) poruke u particiji. Pomak je pozicija s rastućim brojem koja počinje od 0 na početku particije. Ova grupa potrošača, na koju se referira u API kroz korisnički definirani identifikator group_id, odgovara jednom logičkom potrošaču ili sustavu.
Većina sustava koji koriste razmjenu poruka čitaju podatke od večine putem više instanci i tokova za paralelnu obradu poruka. Tako će obično postojati mnogo instanci potrošača koje dijele istu grupu potrošača.
Problem čitanja može se predstaviti na sljedeći način:
- Tema ima nekoliko particija
- Mnoge grupe potrošača mogu istovremeno koristiti temu
- Grupa potrošača može imati nekoliko odvojenih instanci
To je netrivijalan problem "mnogi prema mnogima". Da bismo razumjeli kako Kafka upravlja odnosima između grupa potrošača, instanci potrošača i particija, razmotrit ćemo niz postupno složenijih scenarija čitanja.
Potrošači i grupe potrošača
Uzmimo kao polaznu točku temu s jednom particijom ().
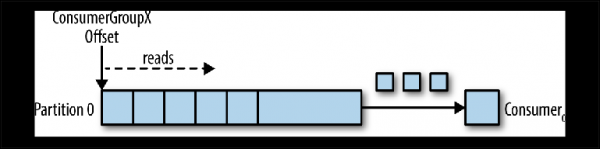
Slika 3-2. Potrošač čita iz particije
Kada se instanca potrošača poveže s vlastitim group_id na ovu temu, dodjeljuje joj se particija za čitanje i pomak u toj particiji. Pozicija ovog pomaka konfigurira se u klijentu, kao pokazatelj na najnoviju poziciju (najnoviju poruku) ili najraniju poziciju (najstariju poruku). Potrošač zahtijeva (polls) poruke iz teme, što dovodi do njihovog sekvencijskog čitanja iz zapisnika.
Pozicija pomaka redovito se pohranjuje natrag u Kafku i čuva se kao poruke u internom topiku _consumer_offsets. Pročitane poruke se ne brišu, za razliku od običnog brokera, a klijent može premotati (rewind) pomak kako bi ponovno obradio već pregledane poruke.
Kada se poveže drugi logički potrošač, koristeći drugi group_id, on upravlja drugim pokazateljem, koji nije neovisan o prvom (). Tako tema Kafka djeluje kao red, u kojem postoji jedan potrošač, i kao u običnom topiku izdavač-pretplatnik (pub-sub), na kojeg se pretplaćuje nekoliko potrošača, s dodatnom prednošću da se sve poruke čuvaju i mogu se obrađivati više puta.
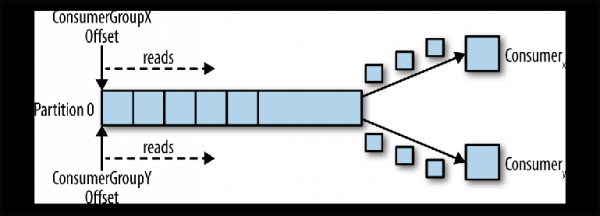
Slika 3-3. Dva potrošača u različitim grupama potrošača čitaju iz jedne particije
Potrošači u grupi potrošača
Kada jedan primjerak potrošača čita podatke iz particije, on potpuno kontrolira pokazivač i obrađuje poruke, kao što je opisano u prethodnom odjeljku.
Ako je više primjeraka potrošača povezano s istim group_id na temu s jednom particijom, onda će primjerku koji se povezao posljednji biti predan nadzor nad pokazivačem i od tog trenutka on će primati sve poruke ().
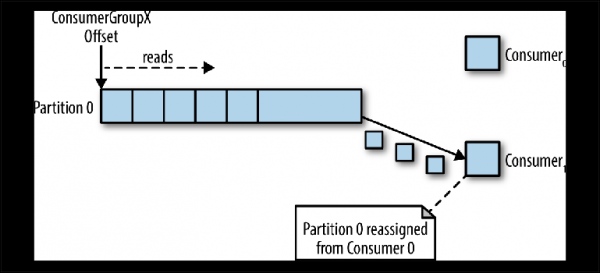
Slika 3-4. Dva potrošača u istoj grupi potrošača čitaju iz jedne particije
Ovaj način obrade, gdje broj primjeraka potrošača premašuje broj particija, može se smatrati vrstom monopolnog potrošača. To može biti korisno ako vam je potrebna 'aktivno-pasivna' (ili 'vruća-topla') klasterizacija vaših primjeraka potrošača, iako je paralelni rad više potrošača ('aktivno-aktivna' ili 'vruća-vruća') mnogo tipičniji nego potrošači u stanju čekanja.
Ovo ponašanje raspodjele poruka, kako je opisano iznad, može izazvati iznenađenje u usporedbi s tim kako se ponaša obična JMS queue. U ovom modelu, poruke poslane u queue bit će ravnomjerno raspoređene između dva potrošača.
Najčešće, kada stvorimo više primjeraka potrošača, radimo to ili za paralelnu obradu poruka, ili za povećanje brzine čitanja, ili za poboljšanje otpornosti procesa čitanja. Budući da samo jedan primjerak potrošača može istovremeno čitati podatke iz particije, kako se to postiže u Kafki?
Jedan od načina da se to učini je korištenje jednog primjerka potrošača za čitanje svih poruka i njihov prijenos u skup niti. Iako ovaj pristup povećava propusnost obrade, povećava složenost logike potrošača i ne čini ništa za poboljšanje otpornosti sustava čitanja. Ako se jedan primjerak potrošača isključi zbog kvara napajanja ili slično, tada se čitanje prekida.
Kanonijski način rješavanja ovog problema u Kafki je korištenje borojnog broja particija.
Particioniranje
Particije su osnovni mehanizam za paralelno čitanje i skaliranje teme izvan propusnosti jednog primjerka brokera. Da bismo to bolje razumjeli, razmotrit ćemo situaciju u kojoj postoji tema s dvije particije, a na tu temu se prijavljuje jedan konzumer ().
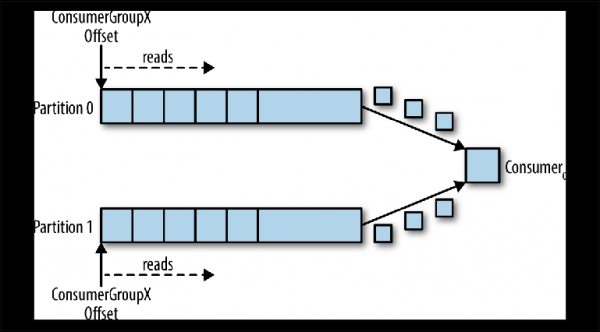
Slika 3-5. Jedan konzumer čita iz više particija
U ovom scenariju, konzumeru se daju kontrolne točke koje odgovaraju njegovom group_id u obje particije, a čitanje poruka započinje iz obje particije.
Kada se u ovu temu doda dodatni konzumer za istu group_id, Kafka ponovo raspoređuje (reallocate) jednu od particija s prvog na drugi konzumer. Nakon toga, svaki primjerak konzumerskog čita samo iz jedne particije teme ().
Da biste omogućili obradu poruka paralelno u 20 niti, potrebno je najmanje 20 particija. Ako je broj particija manji, imat ćete konzumer koji nemaju s čim raditi, što je ranije opisano u raspravi o monopolnim konzumerima.
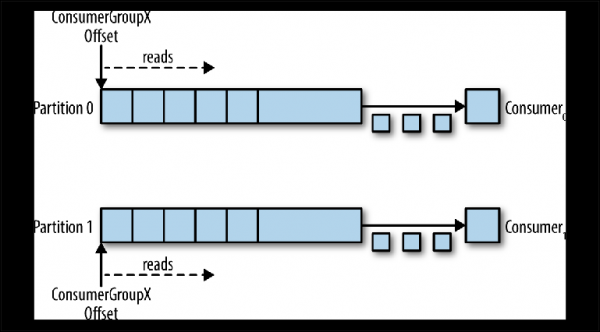
Slika 3-6. Dva konzumera u istoj grupi konzumerā čitaju iz različitih particija
Ova shema znatno smanjuje složenost rada brokera Kafke u usporedbi s raspodjelom poruka potrebnom za podršku JMS redu. Ovdje se ne morate brinuti o sljedećim pitanjima:
- Koji konzumer treba primiti sljedeću poruku, na temelju ciklične (round-robin) raspodjele, trenutnog kapaciteta međuspremnika ili prethodnih poruka (kao za JMS grupe poruka).
- Koje su poruke poslane kojim konzumerima i trebaju li biti ponovo isporučene u slučaju kvara.
Sve što broker Kafka mora učiniti je dosljedno prenositi poruke konzumeru kada ih on zatraži.
Međutim, zahtjevi za paralelno čitanje i ponovnu isporuku neuspjelih poruka ne nestaju - odgovornost za njih jednostavno se prenosi s brokera na klijenta. To znači da ih morate uzeti u obzir u svom kodu.
Slanje poruka
Odgovornost za odluku u koju particiju poslati poruku leži na proizvođaču te poruke. Da bismo razumjeli mehanizam kojim se to postiže, prvo moramo razmotriti što zapravo šaljemo.
Dok dok koristimo poruku s metapodacima (zaglavlja i svojstva) i tijelom koje sadrži korisni teret (payload) u JMS-u, u Kafki poruka je par"ključ-vrijednost". Korisni teret poruke se šalje kao vrijednost (value). Ključ, s druge strane, koristi se uglavnom za particioniranje i treba sadržavati ključ specifičan za poslovnu logiku, kako bi se povezane poruke smjestile u istu particiju.
U Poglavlju 2 smo raspravili scenarij online klađenja, kada povezani događaji trebaju biti obrađivani redom od strane jednog konzumenta:
- Korisnička računica je postavljena.
- Novac se isplaćuje na račun.
- Postavlja se oklada koja povlači novac s računa.
Ako svaki događaj predstavlja poruku koja je poslana u temu, tada će u ovom slučaju prirodni ključ biti identifikator računa.
Kada se poruka šalje koristeći Kafka Producer API, predaje se funkciji particioniranja, koja, uzimajući u obzir poruku i trenutno stanje Kafka klastera, vraća identifikator particije u koju bi poruka trebala biti poslana. Ova funkcija je implementirana u Javi kroz sučelje Partitioner.
Ovo sučelje izgleda ovako:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
Implementacija Partitioner za određivanje particije koristi po defaultu algoritam hashiranja ključa (general-purpose hashing algorithm over the key) ili ciklisku rotaciju (round-robin) ako ključ nije naveden. Ova zadana vrijednost dobro funkcionira u većini slučajeva. Međutim, u budućnosti ćete možda htjeti napisati svoju vlastitu.
Pisanje vlastite strategije particioniranja
Pogledajmo primjer kada želite poslati metapodatke zajedno s korisnim teretom poruke. Korisni teret u našem primjeru su upute za uplatu na račun za igranje. Upute su ono što bismo željeli jamčiti da se ne mijenja prilikom prijenosa i želimo biti sigurni da samo pouzdani viši sustav može inicirati te upute. U ovom slučaju, pošiljateljski i primateljski sustav dogovaraju korištenje potpisa za provjeru autentičnosti poruke.
U standardnom JMS-u samo definiramo svojstvo "potpis poruke" i dodajemo ga u poruku. Međutim, Kafka nam ne pruža mehanizam za prijenos metapodataka - samo ključ i vrijednost.
Budući da je vrijednost korisnički teret bankovnog transfera (bank transfer payload), čije očuvanje želimo, nemamo drugog izbora nego definirati strukturu podataka za korištenje u ključu. Pretpostavljajući da nam je potreban identifikator računa za particioniranje, jer sve poruke povezane s računom trebaju biti obrađene redom, smislit ćemo sljedeću strukturu JSON-a:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Budući da će se vrijednost potpisa mijenjati ovisno o korisničkom teretu, zadana strategija heširanja sučelja Partitioner neće pouzdano grupirati povezane poruke. Stoga ćemo morati napisati vlastitu strategiju koja će analizirati ovaj ključ i odvojiti (partition) vrijednost accountId.
Kafka uključuje kontrolne zbrojeve za otkrivanje oštećenja poruka u skladištu i ima cijeli niz sigurnosnih značajki. Čak i u tom slučaju, ponekad se pojavljuju zahtjevi specifični za industriju, poput onih navedenih iznad.
Prilagođena strategija particioniranja mora osigurati da sve povezane poruke završe u istoj particiji. Iako to zvuči jednostavno, zahtjev može postati složen zbog važnosti redoslijeda povezanih poruka i fiksnog broja particija u temi.
Broj particija u temi može se s vremenom mijenjati, jer se mogu dodati ako promet premaši prvotna očekivanja. Tako će se ključevi poruka povezati s particijom u koju su prvotno poslani, implicirajući dio stanja koji treba biti raspoređen među instancama proizvođača.
Drugi faktor koji treba uzeti u obzir je ravnomjernost raspodjele poruka među particijama. Općenito, ključevi se ne raspodjeljuju ravnomjerno među porukama, a heš-funkcije ne jamče pravednu raspodjelu poruka za mali skup ključeva.
Važno je napomenuti da, bez obzira na to kako odlučite podijeliti poruke, može biti potrebno ponovno koristiti sam razdjelnik.
Razmotrite zahtjev za replikaciju podataka između Kafka klastera na različitim geografski udaljenim lokacijama. U tu svrhu, Kafka dolazi s alatima naredbenog retka pod nazivom MirrorMaker, koji se koristi za čitanje poruka iz jednog klastera i njihovo prenošenje u drugi.
MirrorMaker mora razumjeti ključeve replikiranog topica kako bi održao relativni redoslijed između poruka za vrijeme replikacije između klastera, budući da se broj particija za taj topic može razlikovati u oba klastera.
Prilagođene strategije particioniranja se relativno rijetko koriste, jer zadano heširanje ili ciklično prebacivanje uspješno rade u većini scenarija. Međutim, ako tražite stroge garantije redoslijeda ili trebate izvući metapodatke iz korisničkog opterećenja, onda je particioniranje nešto što vrijedi detaljnije istražiti.
Prednosti skalabilnosti i performansi Kafke proizlaze iz premještanja nekih obaveza tradicionalnog brokera na klijenta. U ovom slučaju, donosi se odluka o raspodjeli potencijalno povezanih poruka među nekoliko konzumenata koji rade paralelno.
JMS brokeri također moraju rješavati takve zahtjeve. Zanimljivo je da mehanizam slanja povezanih poruka istom konzumeru, realiziran putem JMS Message Groups (vrsta Sticky Load Balancing (SLB) strategije), također zahtijeva da pošiljatelj označi poruke kao povezane. U slučaju JMS, broker je odgovoran za slanje te grupe povezanih poruka jednom konzumeru od više njih i prijenos prava vlasništva nad grupom ako konzumer odustane.
Dogovori o producentu
Particioniranje nije jedina stvar na koju treba obratiti pažnju prilikom slanja poruka. Razmotrite metode send() klase Producer u Java API:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Važno je napomenuti da obje metode vraćaju Future, što ukazuje na to da operacija slanja nije izvršena odmah. Kao rezultat toga, poruka (ProducerRecord) se zapisuje u memorijski bafer za svaku aktivnu particiju i šalje brokeru u pozadinskom toku u biblioteci klijenta Kafka. Iako to čini rad nevjerojatno brzim, to znači da neiskusno napisana aplikacija može izgubiti poruke ako se njezin proces zaustavi.
Kao i uvijek, postoji način da se operacija slanja učini pouzdanijom na račun performansi. Veličinu ovog bafera možemo postaviti na 0, i tok aplikacije koja šalje bit će prisiljen čekati dok se prijenos poruke brokeru ne završi, na sljedeći način:
RecordMetadata metadata = producer.send(record).get();Ponovno o čitanju poruka
Čitanje poruka ima dodatne složenosti o kojima treba razmisliti. Za razliku od JMS API-ja, koji može pokrenuti slušatelja poruka (message listener) kao odgovor na dolazak poruke, sučelje Consumer Kafka samo izbacuje (polling). Pogledajmo detaljnije metodu poll (), koja se koristi u tu svrhu:
ConsumerRecords poll(long timeout);Povratna vrijednost metode je kontejnerska struktura koja sadrži više objekata ConsumerRecord iz potencijalno više particija. ConsumerRecord sama po sebi je objekt-holster za par ključ-vrijednost s odgovarajućim metapodacima, poput particije iz koje je dobivena.
Kao što je raspravljano u Poglavlju 2, moramo stalno imati na umu što se događa s porukama nakon njihova uspješnog ili neuspješnog obrade, na primjer, ako klijent ne može obraditi poruku ili ako se prekida. U JMS-u je to riješeno putem načina potvrde (acknowledgement mode). Broker ili uklanja uspješno obrađenu poruku, ili ponovo isporučuje neobrađenu ili neuspješnu (uz pretpostavku da su korištene transakcije).
Kafka funkcionira potpuno drugačije. Poruke se ne uklanjaju na brokeru nakon čitanja i odgovornost za to što se događa u slučaju pogreške leži na samom kodu koji čita.
Kao što smo već spomenuli, grupa konzumerâ povezana je s pomakom u dnevniku. Pozicija u dnevniku, povezana s tom pomakom, odgovara sljedećoj poruci koja će biti izdata kao odgovor na poll ()Trenutak kada se ovo pomakne povećava ima presudnu važnost tijekom čitanja.
Vraćajući se na model čitanja o kojem smo ranije razgovarali, obrada poruke sastoji se od tri faze:
- Izvuci poruku za čitanje.
- Obradi poruku.
- Potvrdi poruku.
Kafka konzumer dolazi s opcijom konfiguracije enable.auto.commit. Ovo je često korištena postavka prema zadanim postavkama, kao što to obično biva s postavkama koje sadrže riječ 'auto'.
Sve do Kafka 0.10, klijent koji je koristio ovu opciju slao je pomak posljednje pročitane poruke pri sljedećem pozivu poll () nakon obrade. To je značilo da su poruke koje su već bile preuzete (fetched) mogle biti ponovno obrađene ako ih je klijent već obradio, ali je iznenada uništen prije poziva. poll (). Budući da broker ne čuva nikakvo stanje u vezi s tim koliko je puta poruka pročitana, sljedeći konzumer koji preuzima tu poruku neće znati da se dogodilo nešto loše. Ovo ponašanje je bilo pseudo-transakcijsko. Pomak se potvrđivao samo u slučaju uspješne obrade poruke, no ako bi klijent prekinuo rad, broker bi toj poruci ponovno poslao istu poruku drugom klijentu. Ovo ponašanje odgovara garanciji isporuke poruka 'barem jednom«.
U Kafka 0.10, kod klijenta je izmijenjen tako da je potvrđivanje počelo povremeno pokretati klijentska biblioteka, u skladu s postavkom auto.commit.interval.ms. Ovo ponašanje je negdje između režima JMS AUTO_ACKNOWLEDGE i DUPS_OK_ACKNOWLEDGE. Kada se koristi automatsko potvrđivanje, poruke su mogle biti potvrđene neovisno o tome jesu li zapravo obrađene - to se moglo dogoditi u slučaju sporog konzumer.
Ako bi konzumer prekinuo rad, poruke bi preuzeo sljedeći konzumer, počevši od potvrđene pozicije, što bi moglo dovesti do propuštanja poruke. U tom slučaju, Kafka nije gubila poruke, čitajući kod jednostavno ih nije obrađivao. poll ()Ovaj režim ima iste perspektive kao u verziji 0.9: poruke mogu biti obrađene, ali u slučaju kvara, pomak možda neće biti potvrđen, što potencijalno može dovesti do duplog isporučivanja. Što više poruka preuzimate tijekom izvršenja, to je veći ovaj problem.
Kao što je raspravljeno u dijelu „Čitanje poruka iz reda“ na str. 21, u sustavu razmjene poruka ne postoji pojam jednokratne isporuke poruke, uzimajući u obzir režime kvara.
U Kafki postoje dva načina za potvrđivanje (commit) offseta: automatski i ručno. U oba slučaja poruke se mogu obrađivati više puta, u slučaju da je poruka obrađena, ali se dogodila greška prije commita. Također, možete ne obraditi poruku ako je commit izvršen u pozadini, a vaš kod je završen prije nego što je započeo obradu (moguće u Kafki 0.9 i ranijim verzijama).
Kontrolirati proces ručnog commita offseta može se u API-ju konsumenta Kafke postavljanjem parametra enable.auto.commit na vrijednost false i eksplicitnim pozivom jedne od sljedećih metoda:
void commitSync();
void commitAsync();
Ako želite obraditi poruku „barem jednom“, trebate ručno potvrditi offset koristeći commitSync (), izvršavajući ovu naredbu odmah nakon obrade poruka.
Ove metode ne dopuštaju potvrđivanje (acknowledgment) poruka sve dok ne budu obrađene, ali ne rade ništa kako bi isključile potencijalno duplicirano obrađivanje, dok istovremeno stvaraju izgled transakcionalnosti. U Kafki ne postoje transakcije. Klijent nema mogućnost sljedećeg:
- Automatski poništiti (roll back) neuspješnu poruku. Konsumenti sami moraju rješavati iznimke koje proizlaze iz problematičnih payloadova i isključivanja backenda, jer se ne mogu oslanjati na ponovnu isporuku poruka od strane brokera.
- Slati poruke u više topica unutar jedne atomske operacije. Kao što ćemo ubrzo vidjeti, kontrola nad različitim topicima i particijama može se nalaziti na različitim strojevima u klasteru Kafke, koji ne koordiniraju transakcije pri slanju. U trenucima pisanja ovog članka, učinjeni su određeni napori da se to omogući putem KIP-98.
- Povezati čitanje jedne poruke iz jednog topica s slanjem druge poruke u drugi topic. Ponovno, arhitektura Kafke ovisi o brojnim neovisnim strojevima koji djeluju kao jedna sabirnica i ne poduzimaju se nikakvi pokušaji da se to prikrije. Na primjer, ne postoje komponentne API koje bi omogućile povezivanje Konsument i Producent u transakciji. U JMS-u to se osigurava objektom Sesija, iz kojeg se stvaraju Proizvođači poruka i Potrošači poruka.
Ako ne možemo oslanjati se na transakcije, kako možemo osigurati semantiku koja je bliža onoj koju pružaju tradicionalni sustavi razmjene poruka?
Ako postoji vjerojatnost da će se pomak potrošača povećati prije nego što je poruka obrađena, na primjer, tijekom kvara potrošača, potrošač nema način da sazna je li njegova grupa potrošača propustila poruke kada joj je dodijeljena particija. Stoga je jedna od strategija vraćanje (rewind) pomaka na prethodnu poziciju. Kafka API potrošača pruža sljedeće metode za to:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Metoda seek () može se koristiti s metodom
offsetsForTimes (Map timestampsToSearch) za vraćanje u stanje u nekom određenom trenutku u prošlosti.
Neizravno, korištenje ovog pristupa znači da je vrlo vjerojatno da će neke poruke koje su prethodno obrađene biti pročitane i obrađene ponovno. Da bismo to izbjegli, možemo koristiti idempotentno čitanje, kao što je opisano u Poglavlju 4, za praćenje prethodno pregledanih poruka i isključivanje duplikata.
Kao alternativa, kod vašeg potrošača može biti jednostavan, ako je gubitak ili duplikacija poruka prihvatljivo. Kada razmatramo scenarije korištenja za koje se Kafka obično koristi, kao što su obrada događaja logova, metrika, praćenje klikova itd., možemo shvatiti da gubitak pojedinih poruka vjerojatno neće imati značajan utjecaj na okolne aplikacije. U takvim slučajevima, zadane vrijednosti su sasvim prihvatljive. S druge strane, ako vaša aplikacija mora obraditi uplate, morate pažljivo brinuti o svakoj pojedinoj poruci. Sve se svodi na kontekst.
Osobna opažanja pokazuju da s porastom intenziteta poruka, vrijednost svake pojedine poruke opada. Poruke velikih volumena postaju, u pravilu, vrijedne kada ih promatramo u agregiranoj formi.
Visoka dostupnost (High Availability)
Kafka pristup visokoj dostupnosti značajno se razlikuje od ActiveMQ pristupa. Kafka je dizajnirana na osnovu horizontalno skalabilnih klastera, gdje svi primjerci poslužitelja istovremeno prihvaćaju i distribuiraju poruke.
Kafka klaster se sastoji od više primjeraka poslužitelja koji rade na različitim poslužiteljima. Kafka je razvijena za rad na običnoj autonomnoj opremi, gdje svaki čvor ima svoje vlastito odvojeno skladište. Korištenje mrežnih skladišta (SAN) nije preporučljivo, jer više računalnih čvorova može konkurirati za vremenske intervale skladišta i stvarati sukobe.Se
Kafka je neprekinuti sustav. Mnogi veliki korisnici Kafke nikada ne isključuju svoje klastere, a softver uvijek osigurava ažuriranje putem postupnog ponovnog pokretanja. To se postiže jamčenjem kompatibilnosti s prethodnim verzijama za poruke i interakcije između poslužitelja.
Poslužitelji su povezani s klasterom poslužitelja , koji djeluje kao registar konfiguracijskih podataka i koristi se za koordinaciju uloga svakog poslužitelja. ZooKeeper je sam distribucirani sustav koji osigurava visoku dostupnost replikacijom informacija uspostavljanjem kvoruma..
U osnovnom slučaju, tema se stvara u klasteru Kafka s sljedećim svojstvima:
- Broj particija. Kao što je ranije raspravljano, točna vrijednost koja se koristi ovdje ovisi o željenom razini paralelnog čitanja.
- Faktor replikacije definira koliko primjeraka poslužitelja u klasteru treba imati zapise za ovu particiju.
Koristeći ZooKeeper za koordinaciju, Kafka nastoji pravedno rasporediti nove particije među poslužiteljima u klasteru. To čini jedan primjerak koji igra ulogu Kontrolora.
U vrijeme rada za svaku particiju teme, Kontrolor dodjeljuje poslužitelju uloge vođe (vođa, master, glavni) i sljedbenika. (sljedbenici, robovi, podređeni). Broker, koji djeluje kao vođa za ovu particiju, odgovara za primanje svih poruka koje su mu poslali producenti i distribuiranje poruka prema konzumentima. Kada se poruke šalju u particiju teme, one se repliciraju na sve čvorove brokera koji djeluju kao sljedbenici za tu particiju. Svaki čvor koji sadrži zapise za particiju naziva se replikom. Broker može djelovati kao vođa za neke particije i kao sljedbenik za druge.
Sljedbenik koji sadrži sve poruke pohranjene kod vođe naziva se sinhronizirana replika (replika koja je u sinhroniziranom stanju, in-sync replica). Ako broker koji djeluje kao vođa za particiju isključi, bilo koji broker koji se nalazi u aktualiziranom ili sinhroniziranom stanju za tu particiju može preuzeti ulogu vođe. Ovo je izuzetno otporan dizajn.
Dio konfiguracije producenata je parametar acks, koji određuje koliko replika mora potvrditi (acknowledge) prijem poruke prije nego što aplikacija nastavi s slanjem: 0, 1 ili sve. Ako je zadana vrijednost all, tada prilikom prijema poruke vođa šalje potvrdu (confirmation) natrag producentu čim primi potvrde (acknowledgements) zapisa od nekoliko replika (uključujući i sebe) koje su određene konfiguracijom teme min.insync.replicas (po defaultu 1). Ako poruku nije moguće uspješno replicirati, producent će izazvati iznimku za aplikaciju (NotEnoughReplicas ili NotEnoughReplicasAfterAppend).
U tipičnoj konfiguraciji stvara se tema s faktorom replikacije 3 (1 vođa, 2 sljedbenika za svaku particiju) i parametar min.insync.replicas postavlja na vrijednost 2. U tom slučaju, klaster će dopustiti da jedan od brokera koji upravljaju particijom teme može biti isključen bez utjecaja na klijentske aplikacije.
To nas vraća na već poznati kompromis između performansi i pouzdanosti. Replikacija se odvija zbog dodatnog vremena čekanja na potvrde (acknowledgments) od replikacija. Iako, budući da se odvija paralelno, replikacija, barem na tri čvora, ima istu performansu kao i na dva (zanemarujući povećano korištenje propusnosti mreže).
Koristeći ovu shemu replikacije, Kafka vješto izbjegava potrebu za fizičkim zapisivanjem svake poruke na disk putem operacije sync(). Svaka poruka koju proizvođač pošalje bit će zapisana u dnevnik particije, ali, kao što je raspravljano u Poglavlju 2, zapisivanje u datoteku se prvotno odvija u predmemoriji operativnog sustava. Ako je ta poruka replicirana na drugi primjerak Kafke i nalazi se u njegovoj memoriji, gubitak vođe ne znači da je sama poruka izgubljena — može je preuzeti sinkronizirana replikacija.
Odustajanje od potrebe za izvršavanjem operacije sync() znači da Kafka može primati poruke brzinom kojom ih može zapisivati u memoriju. I obrnuto, što duže se može izbjeći ispis (flushing) u disk, to bolje. Iz tog razloga, nije neuobičajeno da se brokerima Kafke dodjeljuje 64 GB memorije ili više. Takvo korištenje memorije znači da jedan primjerak Kafke može lako raditi brzinama koje su tisućama puta brže od tradicionalnog brokera poruka.
Kafka se također može konfigurirati da primijeni operaciju sync() na paketima poruka. Budući da je sve u Kafki usmjereno na rad s paketima, ovo zapravo dobro funkcionira za mnoge scenarije korištenja i predstavlja korisno sredstvo za korisnike koji zahtijevaju vrlo jake garancije. Veći dio čiste performanse Kafke povezan je s porukama koje se šalju brokeru u obliku paketa, a s tim da se te poruke čitaju iz brokera u sekvencijalnim blokovima. operacija (operacijama, u kojima se ne izvršava zadatak kopiranja podataka iz jednog područja memorije u drugo). Ovo predstavlja veliki dobitak s aspekta performansi i resursa i moguće je samo zahvaljujući korištenju temeljne strukture podataka dnevnika, koja definira shemu particije.
U klasteru Kafka moguće je puno veće performanse nego pri korištenju jednog Kafka brokera, jer se particije teme mogu horizontalno skalirati na mnoštvu zasebnih strojeva.
Zaključci
U ovoj glavi smo razmotrili kako arhitektura Kafke preispituje odnose između klijenata i brokera, kako bi osigurala nevjerojatno otpornu cijev za razmjenu poruka, s propusnošću koja je višestruko veća od običnog brokera poruka. Raspravili smo funkcionalnosti koje koristi za postizanje ovog cilja i ukratko obradili arhitekturu aplikacija koje omogućuju tu funkcionalnost. U sljedećoj glavi ćemo razmotriti uobičajene probleme koje aplikacije temeljenje na razmjeni poruka moraju rješavati i raspraviti strategije za njihovo rješavanje. Završit ćemo glavu definirajući kako razmišljati o tehnologijama razmjene poruka u cjelini, kako biste mogli procijeniti njihovu prikladnost za vaše scenarije korištenja.
Prethodni prevedeni dio:
Prijevod je izvršen:
Nastavak slijedi…
Samo registrirani korisnici mogu sudjelovati u anketi. , molimo.
Koristi li se Kafka u vašoj organizaciji?
Da
Ne
Ranije je korištena, sada nije
Planiramo koristiti
Glasovalo je 38 korisnika. Suzdržalo se 8 korisnika.
Izvor: habr.com
