

Danas neće biti nikakvih složenih slučajeva i kompliciranih SQL algoritama. Sve će biti vrlo jednostavno, na razini Kapetana Očiglednog — radimo pregled registra događaja s sortiranjem po vremenu.
Dakle, tu leži u bazi tablica events, a ona ima polje ts — točno to vrijeme po kojem želimo uredno prikazati ove zapise:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Jasno je da zapisa tamo neće biti desetak, stoga će nam trebati na neki način stranica navigacija.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Čak i gotovo nije šala — rijetko, ali se sreće u divljini. Ponekad, nakon rada s ORM-om, teško je preći na 'direktni' rad s SQL-om.
Ali hajde da pređemo na uobičajenije i manje očite probleme.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - zapisa na stranici, $1 - početak stranice
Odakle ovdje broj 26? To je približan broj zapisa za ispunjavanje jednog ekrana. Točnije, 25 prikazanih zapisa, plus 1, koji signalizira da dalje u izboru ima još nešto i ima smisla ići dalje.
Naravno, ovu vrijednost ne treba 'ugrađivati' u tijelo upita, već je prenijeti putem parametra. No, u tom slučaju, planera PostgreSQL-a neće moći osloniti na saznanje da zapisa treba biti relativno malo, — i jednostavno će odabrati neučinkovit plan.
I dok je u sučelju aplikacije pregled registra realiziran kao prebacivanje između vizualnih 'stranica', nitko dugo ne primjećuje ništa sumnjivo. Točno do trenutka kada u borbi za udobnost UI/UX ne odluče promijeniti sučelje na 'beskonačno pomicanje' — to jest, svi zapisi registra prikazani su kao jedan popis koji korisnik može pomjerati gore-dolje.
I eto, pri sljedećem testiranju zatečeni ste na dupliciranju zapisa u registru. Zašto, kada na tablici postoji normalan indeks (ts), na koji se oslanja vaš upit?
Tako je zato što niste uzeli u obzir da ts nije jedinstveni ključ u ovoj tablici. U biti, ni vrijednosti nisu jedinstvene, kao i kod bilo kojeg „vremena“ u stvarnim uvjetima — stoga se jedan te isti zapis u dva susjedna upita lako „preskoči“ s stranice na stranicu zbog drugačijeg konačnog poretka unutar sortiranja istih vrijednosti ključa.
U stvari, ovdje se skriva i drugi problem, koji je mnogo teže primijetiti — neki zapisi neće biti prikazani uopće! Naime, „duplicirani“ zapisi zauzeli su nečije mjesto. Detaljno objašnjenje uz lijepe slike možete .
Proširujući indeks
Pametan programer shvaća — treba učiniti ključ indeksa jedinstvenim, a najjednostavniji način — proširiti ga unaprijed jedinstvenim poljem, kao što je PK:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);A upit mutira:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Nakon nekog vremena dolazi vam DBA i „veseleći“ se, kaže da vaše upite , i uopće, bilo bi vrijeme da se pređe na navigaciju od posljednje prikazane vrijednosti. Vaš upit ponovno mutira:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- posljednje dobivene vrijednosti u prethodnom koraku
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Olakšano ste uzdahnuli, sve dok nije nastupilo…
#3. Чистка индексов
Jer je jednom vaš DBA pročitao i shvatio da „neposljednji“ timestamp — to nije dobro. I ponovno je došao k vama — sada s mišlju da bi onaj indeks trebao ipak postati (ts DESC).
Ali što učiniti s početnim problemom „skakanja“ zapisa između stranica?.. Sve je jednostavno — treba birati blokove s neodređenim brojem zapisa!
Uglavnom, tko nam zabranjuje da čitamo ne „točno 26“, nego „ne manje od 26“? Na primjer, tako da u sljedećem bloku budu zapisi s unaprijed poznatim različitim vrijednostima ts — tada neće biti problema s „preskočenim“ zapisima između blokova!
Evo kako to postići:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
Što se ovdje zapravo događa?
- Koračamo 25 zapisa „dolje“ i dobivamo „graničnu“ vrijednost
ts. - Ako tamo već ništa nema, zamijenimo NULL vrijednost s
-infinity. - Oduzimamo cijeli segment vrijednosti između dobivene vrijednosti
tsi proslijeđene iz sučelja parametra $1 (prethodne „posljednje“ prikazane vrijednosti). - Ako se blok vratio s manje od 26 zapisa — on je zadnji.
Isto to i vizualno:
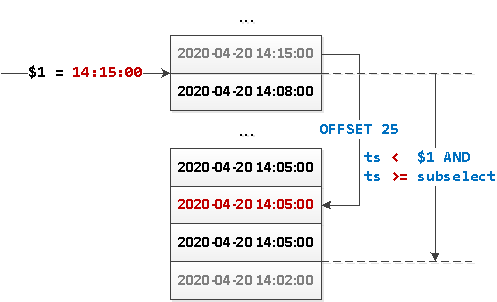
Budući da sada imamo uzorak koji nema određenu 'točku početka', ništa nas ne sprječava da 'okrenemo' ovaj upit u suprotnom smjeru i implementiramo dinamičko učitavanje blokova podataka od 'referentne točke' u oba smjera — i dolje i gore.
Napomena
- Da, u tom slučaju obraćamo se indeksu dvaput, ali sve ‘čisto prema indeksu’. Stoga će ugniježdeni upit rezultirati samo jednim dodatnim Index Only Scanom..
- Očito je da se ovom metodom može koristiti samo kada su vam vrijednosti
tsslučajno preklapale, i ima ih malo.. Međutim, ako je vaš tipični slučaj — 'milijun zapisa u 00:00:00.000', onda to ne bi trebalo raditi. U smislu, ne biste trebali dopuštati takav slučaj. Ali ako se to već dogodilo, upotrijebite varijantu s proširenim indeksom.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish