

Povremeno se programer suočava s potrebom da u zahtev preda skup parametara ili čak celu selekciju na ulazu. Ponekad se jave vrlo neobična rešenja ovog problema.
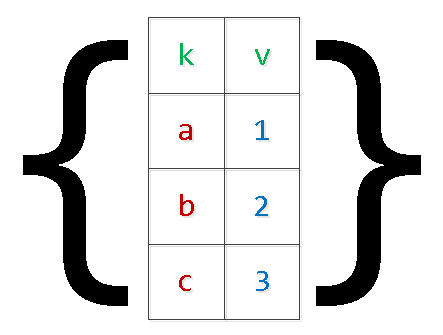
Krenimo "od obrnutog" i pogledajmo šta ne treba raditi, zašto i kako se može bolje.
Direktno "ubacivanje" vrednosti u telo zahteva
Obično izgleda otprilike ovako:
query = "SELECT * FROM tbl WHERE id = " + value... ili ovako:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)O ovom načinu je rečeno, napisano i dosta:
Gotovo uvek je to — direktan put do SQL injekcija i nepotrebnog opterećenja poslovne logike, koja mora "lepite" string vašeg zahteva.
Ovakav pristup može biti delimično opravdan samo u slučaju potrebe za korišćenjem particionisanja u verzijama PostgreSQL 10 i niže radi dobijanja efikasnijeg plana. U tim verzijama spisak skeniranih sekcija se definiše još bez obzira na prodate parametre, isključivo na osnovu tela zahteva.
$n-argumenti
Korištenje parametara — to je dobro, omogućava korišćenje , smanjujući opterećenje kako na poslovnu logiku (string zahteva se formira i prenosi samo jednom), tako i na BD server (nije potrebna ponovna analiza i planiranje za svaku instancu zahteva).
Promenljiv broj argumenata
Problemi ćemo doživeti kada budemo želeli predati unapred nepoznat broj argumenata:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Ako ostavimo zahtev u ovom obliku, iako će nas spasiti od potencijalnih injekcija, ipak će zahtevati spajanje/analizu zahteva za svaku varijantu broj argumenata.. Već je bolje nego raditi to svaki put, ali možemo to izbjeći.
Samo je potrebno preneti jedan parametar koji sadrži serijalizovano predstavljanje niza:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Jedina razlika je potreba da eksplicitno konvertujemo argument u potreban tip niza. No, to ne izaziva probleme, jer već unapred znamo kuda idemo.
Prenos selekcije (matrice)
Obično su to razni načini prenošenja skupova podataka za umetanje u bazu "u jednom zahtevu":
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Pored gore pomenutih problema sa "spajanjem" zahteva, to nas može dovesti i do out of memory i pada poslužitelja. Razlog je jednostavan — pod argumentima PG rezervira dodatnu memoriju, dok se broj zapisa u skupu ograničava samo poslovnom logikom aplikacije. U posebno ekstremnim slučajevima viđali smo »numerički« argumenti veći od $9000 — ne treba tako.
Prepisat ćemo upit, primjenjujući već »dvoetažnu« serializaciju:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Da, u slučaju «složenih» vrijednosti unutar niza, potrebno ih je obaviti navodnicima.
Jasno je da na ovaj način možemo «proširiti» odabir s proizvoljnim brojem polja.
unnest, unnest, …
S vremena na vrijeme srećemo varijante prijenosa umjesto «niza nizova» nekoliko «nizova stupaca», o kojima sam spominjao :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Na ovaj način, pogriješivši u generiranju popisa vrijednosti za različite stupce, vrlo je lako dobiti sasvim nepredviđene rezultate, koji također ovise o verziji poslužitelja:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Počevši još od verzije 9.3, PostgreSQL je dobio potpune funkcije za rad s json tipom. Stoga, ako se definicija ulaznih parametara događa u pregledniku, možete ih izravno tamo oblikovati json-objekt za SQL upit:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Za prethodne verzije može se koristiti isti način za each(hstore), ali korektna «završnica» s izbjegavanjem složenih objekata u hstore može uzrokovati probleme.
json_populate_recordset
Ako unaprijed znate da će podaci iz «ulaznog» json-niza ići za popunjavanje neke tablice, možete značajno uštedjeti na «razdereviji» polja i pretvaranju u potrebne tipove, koristeći funkciju json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
A ova funkcija jednostavno «proširuje» proslijeđeni niz objekata u odabir, ne oslanjajući se na format tablice:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TEMPORARY TABLE
Ali ako je volumen podataka u proslijeđenom odabiru vrlo velik, teško je smjestiti ga u jedan serializirani parametar — a ponekad to nije ni moguće, jer zahtijeva jednokratno dodjeljivanje velikog volumena memorijeNa primjer, ako trebate dugo skupljati veliki paket podataka o događajima iz vanjskog sustava, a zatim ga jednokratno obraditi na strani Baze podataka.
U tom slučaju, najbolje rješenje bi bilo korištenje :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- ponoviti mnogo, mnogo puta
...
-- ovdje radimo nešto korisno s cijelom ovom tablicom
Ova metoda je dobra upravo za rijetko prenošenje velikih volumena poslužitelj.
S obzirom na opis strukture svojih podataka, privremena tablica se od "obične" razlikuje samo jednim karakteristikama u sistemskoj tablici pg_class, a u pg_type, pg_depend, pg_attribute, pg_attrdef, … — zapravo se ni s čim ne razlikuje.
Zato, u web sustavima s velikim brojem kratkoročno aktivnih veza, svaka takva tablica će stvarati nove sistemske unose svaki put, koji se brišu zatvaranjem veze s Baza podataka. Kao rezultat, nekontrolirana upotreba TEMP TABLE dovodi do "natezanja" tablica u pg_catalog i usporavanja mnogih operacija koje ih koriste.
Naravno, s ovim se može boriti pomoću periodičnog prolaska VACUUM FULL kroz tablice sistemskog kataloga.
Sesijske varijable
Pretpostavimo da je obrada podataka iz prethodnog slučaja dovoljno složena za jednu SQL naredbu, ali da želimo raditi dovoljno često. Dakle, želimo koristiti proceduralnu obradu u , ali će korištenje privremenih tablica za prenos podataka biti previše skupo.
Ne možemo koristiti $n-parametre za prijenos u anonimni blok. Rješenje će nam dati sesijske varijable i funkcija current_setting.
Do verzije 9.2 bilo je potrebno unaprijed konfigurirati custom_variable_classes za "svoje" sesijske varijable. U trenutnim verzijama, može se pisati otprilike ovako:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
U drugim podržanim proceduralnim jezicima mogu se pronaći i druga rješenja.
Znate li još načina? Podijelite u komentarima!
Izvor: habr.com
