

Nastavljamo seriju članaka posvećenih istraživanju malo poznatih načina za poboljšanje performansi "navodno jednostavnih" upita na PostgreSQL-u:
Nemojte misliti da toliko ne volim JOIN… 🙂
Ali često bez njega upit je osjetno produktivniji nego s njim. Stoga ćemo danas pokušati u potpunosti osloboditi se resursno zahtjevnog JOIN-a — uz pomoć rječnika.
Počevši od PostgreSQL 12, dio u nastavku opisane situacije može se ponašati malo drugačije zbog . Ovo ponašanje može se vratiti prethodnom s pomoću opcije
MATERIALIZED.
Mnoge "činjenice" o ograničenom rječniku
Uzmimo sasvim realan praktičan zadatak — potrebno je prikazati popis ili aktivnih zadataka sa pošiljateljima:
25.01 | Ivanov I.I. | Pripremiti opis novog algoritma.
22.01 | Ivanov I.I. | Napisati članak na Habr: život bez JOIN-a.
20.01 | Petrova P.P. | Pomoći optimizirati upit.
18.01 | Ivanov I.I. | Napisati članak na Habr: JOIN uzimajući u obzir raspodjelu podataka.
16.01 | Petrova P.P. | Pomoći optimizirati upit.
U apstraktnom svijetu, autori zadataka trebali bi se ravnomjerno rasporediti među svim zaposlenicima naše organizacije, ali u stvarnosti zadaci dolaze, u pravilu, od prilično ograničenog broja ljudi — "od nadređenih" prema gore u hijerarhiji ili "od kolega" iz susjednih odjela (analitičari, dizajneri, marketing, …).
Pretpostavimo da u našoj organizaciji od 1000 ljudi samo 20 autora (obično čak i manje) postavlja zadatke konkretnim izvršiteljima i , kako bismo ubrzali "tradicionalni" upit.
Generatorski skript
-- zaposlenici
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- zadaci s navedenom raspodjelom
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Prikazujemo zadnjih 100 zadataka za određenog izvođača:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 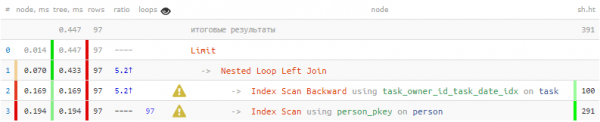
Ispada da 1/3 ukupnog vremena i 3/4 pročitanih podataka stranica podataka učinjene su samo da bi se 100 puta tražio autor — za svaki prikazani zadatak. Ali znamo da među ovom stotinom ima samo 20 različitih — zar ne možemo iskoristiti ovo znanje?
hstore-riječnik
Iskoristimo za generiranje „riječnika“ ključ-vrijednost:
CREATE EXTENSION hstoreU riječnik nam je dovoljno staviti ID autora i njegovo ime, kako bismo zatim mogli izvući po ovom ključu:
-- formiramo ciljnu selekciju
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- formiramo riječnik za jedinstvene vrijednosti
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- dobivamo povezane vrijednosti riječnika
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> key
FROM
T; 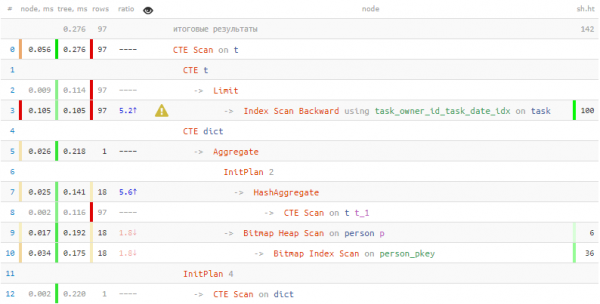
Na dobivanje informacija o osobama utrošeno je 2 puta manje vremena i 7 puta manje pročitanih podataka! Osim „riječnika“, ovih rezultata pomogli smo postići i masovno izdvajanje zapisa iz tablice u jedan prolaz pomoću = ANY(ARRAY(...)).
Zapisi tablice: serijalizacija i deserializacija
Ali što učiniti ako trebamo sačuvati u riječniku ne jedno tekstualno polje, već cijeli zapis? U tom slučaju će nam pomoći sposobnost PostgreSQL-a raditi s zapisom tablice kao jedinstvenom vrijednošću:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- magija #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- magija #2
FROM
  T;
Hajde da razložimo šta se ovde uopšte dogodilo:
- Uzeli smo p kao alias za cijeli zapis tablice person i skupili ih u niz.
- Ova niz zapisa prebacili smo u niz tekstualnih nizova (person[]::text[]), kako bismo ga smestili u hstore rečnik kao niz vrednosti.
- Prilikom dobijanja povezane stavke, izvukli smo je iz rečnika po ključu kao tekstualni niz.
- Tekst moramo pretvoriti u vrednost tipa tabele person (za svaku tabelu automatski se stvara odgovarajući tip).
- «Raspakovali» smo tipizovani zapis u kolone koristeći
(...).*.
json-rečnik
No, ovakav trik, kao onaj koji smo primenili gore, neće proći ako ne postoji odgovarajući tabelarni tip za „prebacivanje“. U istoj situaciji ćemo se naći i ako pokušamo koristiti string CTE, a ne „pravu“ tabelu..
U tom slučaju pomoći će nam :
... , p AS ( -- ovo je već CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- sada je ovo već json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- i unutar json za svaki red
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- izvukli smo iz rečnika kao json
      ) AS j(name text, birth_date date) -- popunili potrebnu strukturu
  ) j;
Treba napomenuti da prilikom opisivanja ciljne strukture možemo nabrojati ne sva polja izvorne linije, već samo ona koja nam zaista trebaju. Ako imamo „rođenu“ tabelu, bolje je koristiti funkciju json_populate_record.
Pristup rečniku još uvek imamo jednom, ali troškovi za json-[de]serijalizaciju su prilično visoki, zato je razumno koristiti ovakav način samo u određenim slučajevima kada „pošteni“ CTE Scan pokazuje lošije rezultate.
Testiramo performanse
Dakle, dobili smo dva načina za serijalizaciju podataka u rečnik — hstore / json_object. Pored toga, sami nizovi ključeva i vrednosti mogu se takođe generisati na dva načina, sa unutrašnjim ili spoljašnjim prebacivanjem u tekst: array_agg(i::text) / array_agg(i)::text[].
Proverićemo efikasnost različitih vrsta serijalizacije na čistom sintetičkom primeru — serijalizujemo različiti broj ključeva:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Ocena skripte : serijalizacija
S T KAO (
  ODABERITE
    *
  , (
      ODABERITE
        regexp_replace(ea[array_length(ea, 1)], '^Vrijeme izvođenja: (d+.d+) ms$', '1')::real et
      IZ
        (
          ODABERITE
            array_agg(el) ea
          IZ
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              objasni analizu
              S T KAO (
                ODABERITE
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                IZ
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLICA dict
            $$) T(el text)
        ) T
    ) et
  OD
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  NAREDA
    1, 2
)
ODABERITE
  v
, avg(et)::numeric(32,3)
IZ
  T
GROUP BY
  1
NAREDA
1; 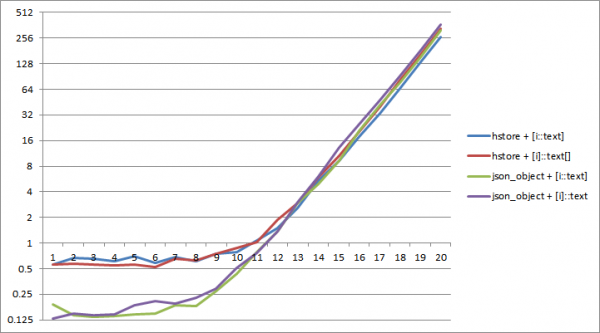
Na PostgreSQL 11 otprilike do veličine rječnika od 2^12 ključeva serijalizacija u json zahtijeva manje vremena. Pri tome je najučinkovitija kombinacija json_object i "internog" pretvaranja tipova array_agg(i::text).
Sada pokušajmo pročitati vrijednost svakog ključa 8 puta — jer ako se ne obraćamo rječniku, zašto nam je potreban?
Procjenjivački skript : čitanje iz rječnika
S T KAO (
  ODABERITE
    *
  , (
      ODABERITE
        regexp_replace(ea[array_length(ea, 1)], '^Vrijeme izvođenja: (d+.d+) ms$', '1')::real et
      IZ
        (
          ODABERITE
            array_agg(el) ea
          IZ
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              objasni analizu
              S T KAO (
                ODABERITE
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                IZ
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              ODABERITE
                (TABLICA dict) -> (i % ($$ || (1 << v) || $$) + 1)::text
              IZ
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  OD
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  NAREDA
    1, 2
)
ODABERITE
  v
, avg(et)::numeric(32,3)
IZ
  T
GROUP BY
  1
NAREDA
1; 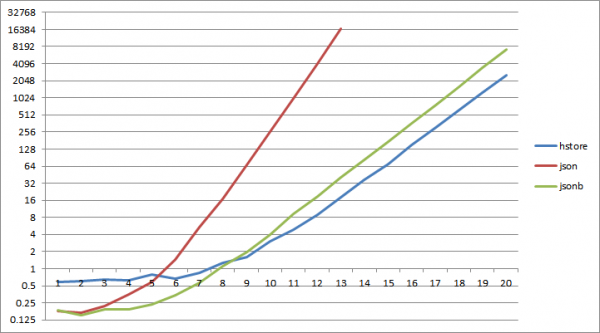
I… već otprilike pri 2^6 ključeva čitanje iz json-rječnika počinje značajno zaostajati čitanju iz hstore, za jsonb to se isto događa pri 2^9.
Konačni zaključci:
- ako treba izvršiti JOIN s višekratno ponavljajućim zapisima — bolje koristiti "rječnik" tablice
- ako vaš rječnik očekivano mali i čitat ćete iz njega malo — može se koristiti json[b]
- u svim ostalim slučajevima hstore + array_agg(i::text) bit će učinkovitije
Izvor: habr.com
