

Bojte se operacija, buffers koje donose…
Na primjeru malog upita razmotrit ćemo neke univerzalne pristupe optimizaciji upita u PostgreSQL-u. Koristiti ih ili ne — izbor je na vama, ali vrijedi ih upoznati.
U nekim budućim verzijama PG situacija se može promijeniti s "pametnijim" planerom, ali za 9.4/9.6 izgleda otprilike jednako, kao što su primjeri ovdje.
Uzet ću sasvim realan upit:
SELECT
  TRUE
FROM
  "Dokument" d
INNER JOIN
  "DokumentProširenje" doc_ex
    USING("@Dokument")
INNER JOIN
  "TipDokumenta" t_doc ON
    t_doc."@TipDokumenta" = d."TipDokumenta"
WHERE
  (d."Lice3" = 19091 or d."Zaposlenik" = 19091) AND
  d."$Crtica" IS NULL AND
  d."Obrisano" IS NOT TRUE AND
  doc_ex."Stanje"[1] IS TRUE AND
  t_doc."TipDokumenta" = 'PlanRadova'
LIMIT 1;
o imenima tablica i poljaNa "ruske" nazive polja i tablica može se gledati na različite načine, ali to je stvar ukusa. Budući da nemamo stranih programera, a PostgreSQL nam omogućava davanje naziva čak i hijeroglifima, ako su oni stavljeni u navodnike, preferiramo imenjavanje objekata jasno i razumljivo, kako ne bi došlo do nesporazuma.
Pogledajmo dobiveni plan:
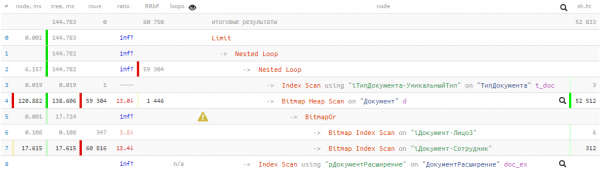
144ms i gotovo 53K buffers — dakle više od 400MB podataka! Imat ćemo sreće ako se svi oni nađu u predmemoriji u trenutku našeg upita, inače će trajati mnogo duže pri čitanju s diska.
Algoritam je najvažniji!
Kako bismo na neki način optimizirali bilo koji upit, prvo moramo razumjeti što on zapravo treba raditi.
Za sada ćemo izvan okvira ovog članka ostaviti razvoj same strukture Baze Podataka, i dogovoriti se da možemo relativno "jeftino" prepisati upit i/ili nanijeti na bazu neke potrebne nam indekse.
Dakle, upit:
— provjerava postoji li bilo koji dokument
— u nam stanju i određenog tipa
— gdje je autor ili izvršitelj potreban zaposlenik
JOIN + LIMIT 1
Često je programeru lakše napisati upit u kojem se prvo spoji veći broj tablica, a zatim iz te gomile ostane samo jedan zapis. No lakše za programera — ne znači učinkovitije za Bazu Podataka.
U našem slučaju bilo je samo 3 tablice — a kakav je efekt…
Hajde da se prvo riješimo spajanja s tablicom "TipDokumenta", a usput obavijestimo bazu da je tip zapisa jedinstven (mi to znamo, ali planer još nije shvatio):
WITH T AS (
  SELECT
    "@TipDokumenta"
  FROM
    "TipDokumenta"
  WHERE
    "TipDokumenta" = 'PlanPoslova'
  LIMIT 1
)
...
WHERE
  d."TipDokumenta" = (TABLE T)
...
Da, ako je tabela/CTE sastavljena samo od jednog polja jedne jedine stavke, tada se u PG može pisati i ovako, umjesto
d."TipDokumenta" = (SELECT "@TipDokumenta" FROM T LIMIT 1)„Lenji” proračuni u upitima PostgreSQL-a
BitmapOr vs UNION
U nekim slučajevima Bitmap Heap Scan će nas koštati vrlo skupo — na primjer, u našoj situaciji, kada se dovoljan broj stavki uklapa u traženi uvjet. Dobili smo to zbog OR-uvjeta koji je postao BitmapOr-operacije u planu.
Vratimo se na izvorni zadatak — potrebno je pronaći stavku koja odgovara bilo kojem od uvjeta — što znači da nije potrebno tražiti svih 59K stavki po oba uvjeta. Postoji način da se prvo obradi jedan uvjet, a na drugi pređe samo kada po prvom ništa ne bude pronađeno. Pomoći će nam takva konstrukcija:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
„Vanjski” LIMIT 1 garantira da će pretraga završiti čim se pronađe prva stavka. I ako se ona pronađe već u prvom bloku, izvršenje drugog neće se odvijati (nikada se ne izvršava u planu).
„Skrivanje pod CASE” složenih uvjeta
U izvornoj upitu postoji izuzetno neprijatan trenutak — provjera stanja prema povezanoj tablici „DokumentProširenje”. Bez obzira na istinitost drugih uvjeta u izrazu (na primjer, d."Obrisan" IS NOT TRUE), ovo spajanje se uvijek izvršava i „košta resurse”. Više ili manje će ih biti potrošeno — ovisi o volumenu ove tablice.
Međutim, moguće je modificirati upit tako da se pretraga povezane stavke odvija samo kada je to doista potrebno:
SELECT
  ...
FROM
  "Dokument" d
WHERE
  ... /*index cond*/ AND
  CASE
    WHEN "$Nacrt" IS NULL AND "Obrisan" IS NOT TRUE THEN (
      SELECT
        "Stanje"[1] IS TRUE
      FROM
        "DokumentProširenje"
      WHERE
        "@Dokument" = d."@Dokument"
    )
  END
Budući da nam iz povezane tablice ni jedno od polja nije potrebno za rezultat, imamo mogućnost pretvoriti JOIN u uvjet koji se odnosi na podupit.
Ostavimo indeksi polja „izvan zagrada” CASE, jednostavne uvjete iz stavke prenosimo u WHEN-blok — a sada se „teški” upit izvršava samo kada dođemo do THEN.
Moje prezime je „Ukupno”
Sastavljamo rezultantni upit sa svim gore opisanim mehanizmima:
S T AS (
  SELECT
    "@TipDokumenta"
  FROM
    "TipDokumenta"
  WHERE
    "TipDokumenta" = 'PlanRadova'
)
  (
    SELECT
      TRUE
    FROM
      "Dokument" d
    WHERE
      ("Lice3", "TipDokumenta") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Nacrt" IS NULL AND "Obrisan" IS NOT TRUE THEN (
          SELECT
            "Stanje"[1] IS TRUE
          FROM
            "DokumentProsirenje"
          WHERE
            "@Dokument" = d."@Dokument"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Dokument" d
    WHERE
      ("TipDokumenta", "Zaposlenik") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Nacrt" IS NULL AND "Obrisan" IS NOT TRUE THEN (
          SELECT
            "Stanje"[1] IS TRUE
          FROM
            "DokumentProsirenje"
          WHERE
            "@Dokument" = d."@Dokument"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Prilagodba [za] indekse
Oko je primijetilo da se uvjeti koji se indeksiraju u podblokovima UNION malo razlikuju — to je zato što već imamo odgovarajuće indekse na tablici. A da ih nema — onda bi trebalo stvoriti: Dokument(Lice3, TipDokumenta) i Dokument(TipDokumenta, Zaposlenik).
o redoslijedu polja u ROW-uvjetimaGledajući sa stajališta planera, naravno, može se napisati i (A, B) = (constA, constB), i (B, A) = (constB, constA). No prilikom zapisivanja u redoslijedu polja u indeksu, takav upit je jednostavno lakše debagirati.
Što je u planu?
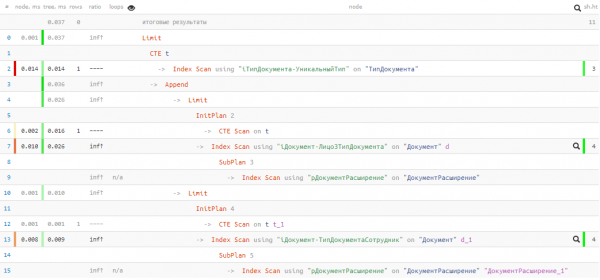
Nažalost, nismo imali sreće, i u prvom UNION-bloku nije ništa pronađeno, pa je drugi ipak otišao na izvršenje. Ali čak i tada — samo 0.037ms i 11 buffer-a!
Poboljšali smo upit i smanjili „prijenos” podataka u memoriji nekoliko tisuća puta, koristeći prilično jednostavne tehnike — dobar rezultat uz malo kopipaste. 🙂
Izvor: habr.com
