

Predlažem da se upoznate s transkripcijom izlaganja Vladimira Sitnikova iz početka 2016. godine "PostgreSQL i JDBC - izvučimo sve što možemo"
Dobar dan! Zovem se Vladimir Sitnikov. Radim 10 godina u kompaniji NetCracker. Uglavnom se bavim performansama. Sve što je povezano s Javom, sve što je povezano s SQL-om - to je ono što volim.
Danas ću govoriti o tome s čime smo se susreli u kompaniji kada smo počeli koristiti PostgreSQL kao server za baze podataka. Uglavnom radimo s Javom. No, ono što ću danas ispričati, odnosi se ne samo na Javu. Kao što praksa pokazuje, to se javlja i u drugim jezicima.
Govorit ćemo o:
- prikupljanju podataka.
- O spremanju podataka.
- I o performansama.
- I o zamkama koje se tu kriju.
Započnimo s jednostavnim pitanjem. Biramo jedan redak iz tablice prema primarnom ključu.
Baza se nalazi na istom hostu. I sve to traje 20 milisekundi.
Ovih 20 milisekundi - to je jako puno. Ako imate 100 takvih upita, gubite vrijeme u sekundi kako biste obradili te upite, tj. trošite vrijeme uzalud.
Ne volimo to raditi i gledamo što nam baza nudi za to. Baza nam nudi dva načina izvršenja upita.
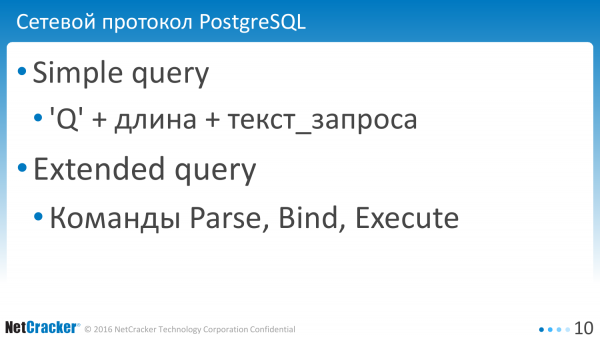
Prvi način - to je jednostavni upit. Što je dobro u njemu? Uzimamo ga i šaljemo, i ništa više.
Baza također ima prošireni upit, koji je složeniji, ali funkcionalniji. Možete posebno slati upite za parsiranje, izvršavanje, povezivanje varijabli itd.
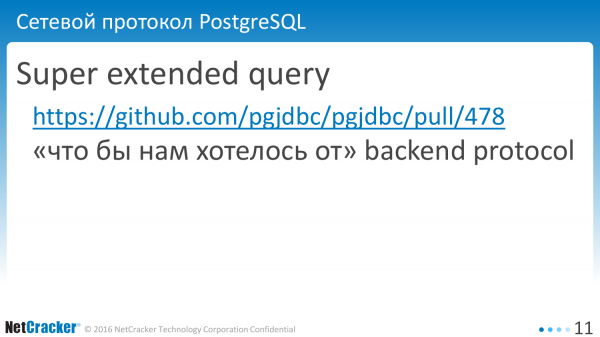
Super prošireni upit - to je ono što nećemo pokrivati u trenutnom izlaganju. Možda imamo nešto što želimo od baze podataka i postoji popis želja koji je oblikovan na neki način, tj. to je ono što želimo, ali trenutno nije moguće i neće biti sljedeće godine. Zato smo to jednostavno zabilježili i idemo pitati glavne osobe.
A ono što možemo napraviti jest - to su jednostavan upit i prošireni upit.
Koja je posebnost svakog pristupa?
Jednostavan upit je dobro koristiti za jednokratno izvršavanje. Jedan puta izvršite i zaboravite. A problem je u tome što ne podržava binarni format podataka, tj. za neke visoko performantne sustave nije prikladan.
Extended query – omogućuje uštedu vremena prilikom parsiranja. To je ono što smo učinili i počeli koristiti. Ovo nam je iznimno pomoglo. Tu nije samo ušteda na parsiranju. Ušteda je i u prijenosu podataka. Prijenos podataka u binarnom formatu je znatno efikasniji.
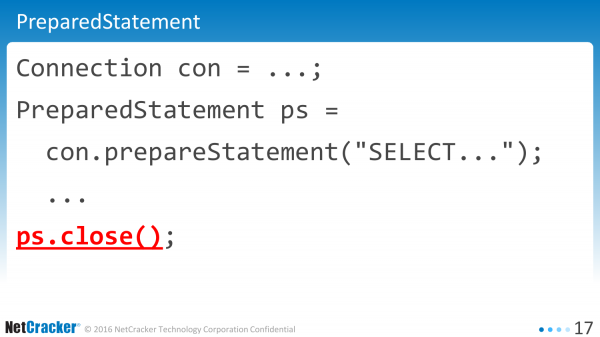
Pređimo na praksu. Ovako izgleda tipična aplikacija. To može biti Java itd.
Stvorili smo statement. Izvršili smo naredbu. Stvorili smo close. Gdje je ovdje greška? Koji je problem? Nema problema. Tako piše u svim knjigama. Tako treba pisati. Ako želite maksimalnu izvedbu, pišite tako.
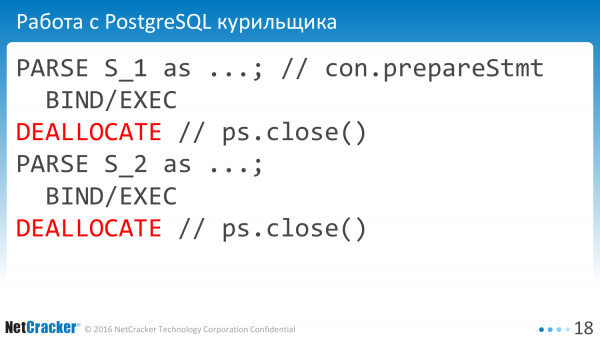
No praksa je pokazala da to ne funkcionira. Zašto? Zato što imamo metodu „close“. I kada to radimo, iz perspektive baze podataka izgleda – to je kao rad pušača s bazom podataka. Rekli smo „PARSE EXECUTE DEALLOCATE“.
Zašto ova suvišna stvaranja i učitavanje statements? Nikome nisu potrebni. No obično u PreparedStatement tako i bude, kada ih zatvaramo, zatvaraju sve u bazi podataka. To nije ono što želimo.
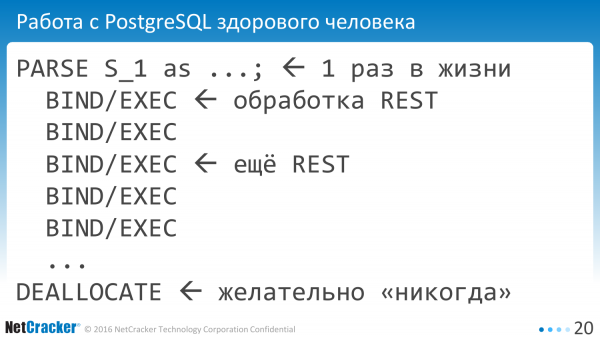
Želimo, kao zdravi ljudi, raditi s bazom. Jednom smo uzeli i pripremili naš statement, a zatim ga izvršavamo mnogo puta. U stvarnosti mnogo puta – to je jednom za cijeli život aplikacije parsirano. I na različitim REST-ima koristimo isti id statementa. To je naš cilj.
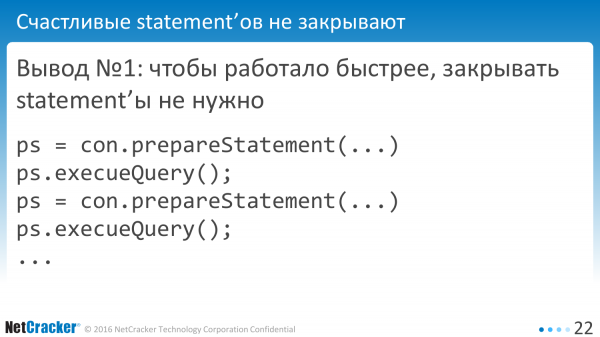
Kako to možemo postići?
Vrlo jednostavno – ne trebamo zatvarati statements. Pišemo ovako: „prepare“ „execute“.
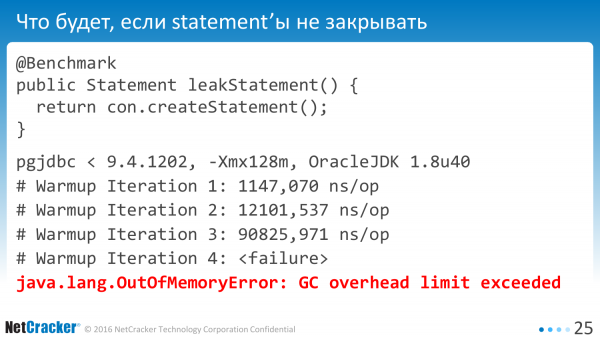
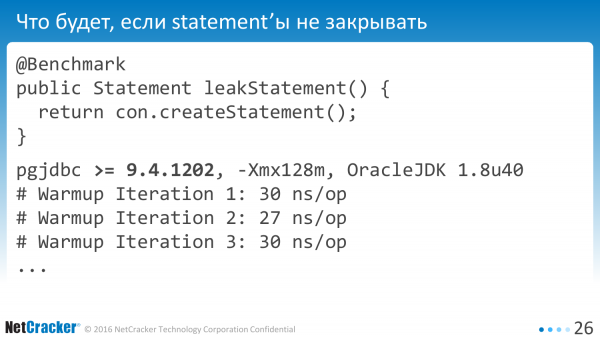
Ako ovo pokrenemo, jasno je da će nam negdje nešto preplaviti. Ako nije jasno, možemo izmjeriti. Uzmi ćemo i napisati benchmark, u kojem je takva jednostavna metoda. Stvaramo statement. Pokrećemo na nekoj verziji drajvera i dobijamo da se prilično brzo urušava gubitkom cijele memorije koju smo imali.
Jasno je da se takve greške lako ispravljaju. Neću o njima govoriti. Ali reći ću da u novoj verziji radi puno brže. Metoda je glupa, ali unatoč tome.
Kako raditi ispravno? Što trebamo učiniti za to?
U stvarnosti, aplikacije uvijek zatvaraju statements. U svim knjigama piše da ih treba zatvoriti, inače će doći do curenja memorije.
I PostgreSQL ne može keširati upite. Svaka sesija treba sama slabiti ovaj keš.
I ne želimo trošiti vrijeme na parsiranje.
A kao i obično, imamo dva načina.
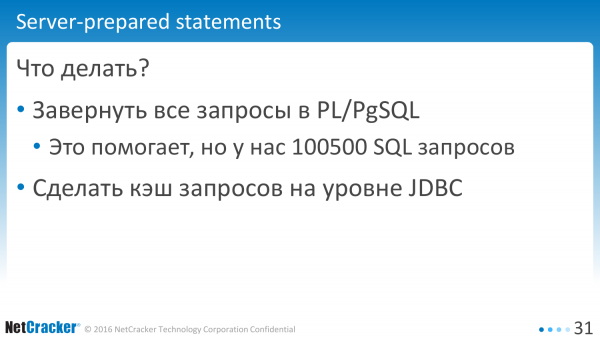
Prva opcija je da uzmemo i kažemo, da sve obavijemo u PgSQL. Tamo postoji keš. On sve kešira. Izaći će sjajno. To smo pogledali. Imamo 100500 upita. Ne radi. Nismo saglasni s tim da ručno pretvaramo upite u procedure. Ne-ne.
Imamo drugu opciju – uzeti i sami napraviti. Otvaramo izvorne kodove, počinjemo raditi. Radimo-radimo. Ispostavilo se da to nije tako teško napraviti.
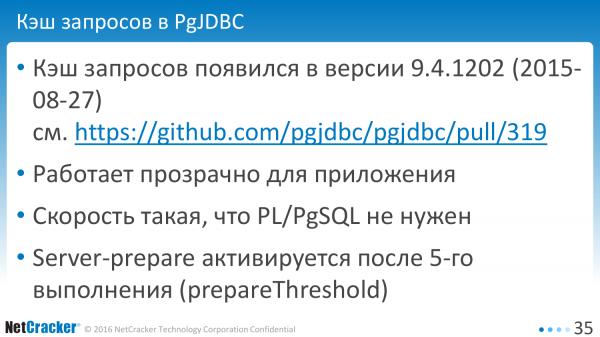
To se pojavilo u avgustu 2015. godine. Sada je već dostupna modernija verzija. I sve je sjajno. Radi toliko dobro, da ništa ne menjamo u aplikaciji. Čak smo prestali razmišljati u pravcu PgSQL, tj. to nam je bilo sasvim dovoljno da smanjimo sve administrativne troškove praktično na nulu.
Samim tim, Server-pripremljene izjave aktiviraju se pri 5. izvršenju kako ne bismo trošili memoriju u bazi podataka na svaki jednokratni upit.
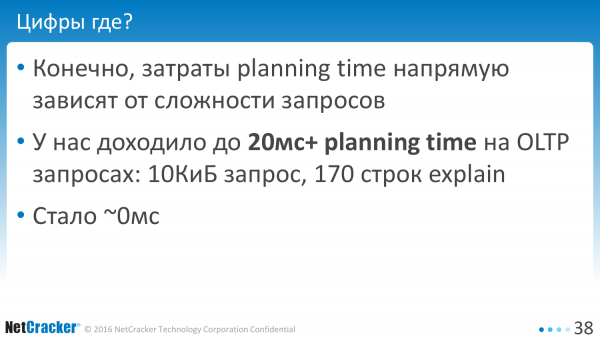
Može se pitati – gde su brojevi? Šta dobijate? I ovde neću dati brojeve, jer svaki upit ima svoje.
Imali smo upite takve da smo na OLTP-upitima trošili oko 20 milisekundi na parsiranje. Bilo je 0,5 milisekundi za izvršenje, 20 milisekundi za parsiranje. Upit – 10 KiB teksta, 170 redova plana. To je OLTP upit. Traži 1, 5, 10 redova, ponekad više.
Ali nismo želeli trošiti 20 milisekundi. Sveli smo to na 0. Sve je sjajno.
Šta možete izvući iz ovoga? Ako imate Javu, uzmite modernu verziju drajvera i radujte se.
Ako imate neki drugi jezik, razmislite – možda će vam to takođe biti potrebno? Zato što s aspekta krajnjeg jezika, na primer, ako je PL 8 ili imate LibPQ, nije vam očigledno da trošite vreme ne na izvršenje, nego na parsiranje i to vredi proveriti. Kako? Sve je besplatno.
Osim toga, postoje greške, neke posebnosti. I o njima ćemo sada govoriti. Veći deo će biti o industrijskoj arheologiji, o onome što smo pronašli, na šta smo naišli.
Ako se upit generiše dinamički. To se dešava. Neko spaja stringove, nastaje SQL-upit.
Šta je loše u tome? Loše je to što svaki put na kraju dobijamo drugačiji string.
I ova različita linija treba ponovno izračunati hashCode. To je doista CPU zadatak – pronaći dugi tekst upita nije lako ni u postojećem hash-u. Stoga je jednostavna poruka – nemojte generirati upite. Pohranite ih u jednu varijablu. I uživajte.
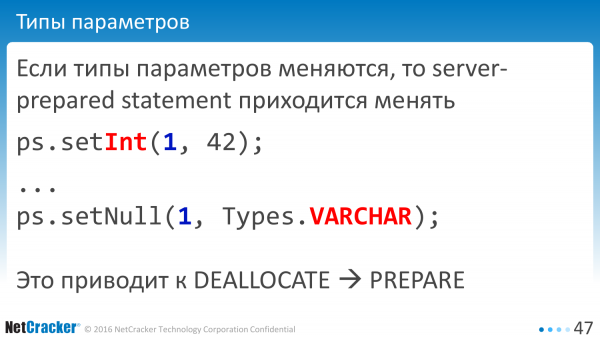
Sljedeći problem. Tipovi podataka su važni. Postoje ORM alati koji kažu da nije važno koji NULL, neka bude neki. Ako je Int, kažemo setInt. A ako je NULL, neka uvijek bude VARCHAR. I koja je u konačnici razlika koji je tu NULL? Baza podataka će sve razumjeti sama. I takva slika ne funkcionira.
U praksi bazi podataka nije svejedno. Ako prvi put kažete da imate broj, a drugi put kažete da je to VARCHAR, nemoguće je ponovno koristiti unaprijed pripremljene izjave na serveru. U tom slučaju morate ponovno kreirati našu izjavu.
Ako izvršavate isti upit, pazite da se tipovi podataka u vašim kolonama ne pomiješaju. Treba paziti na NULL. To je česta pogreška koja nam se dogodila nakon što smo počeli koristiti PreparedStatements.
Dobro, uključeno. Uzeli smo, možda, drajver. I performanse su opale. Sve je postalo loše.
Kako se to događa? Je li to greška ili značajka? Nažalost, nismo uspjeli shvatiti – je li to greška ili značajka. Ali postoji sasvim jednostavan scenarij za reprodukciju ovog problema. Potpuno nas je iznenadio. Sastoji se od selekcije iz doslovno jedne tablice. Imali smo, naravno, više takvih upita. Obično su uključivali dvije do tri tablice, ali ima i ovakav scenarij reprodukcije. Uzmite na vašoj bazi bilo koju verziju i reproducirajte.
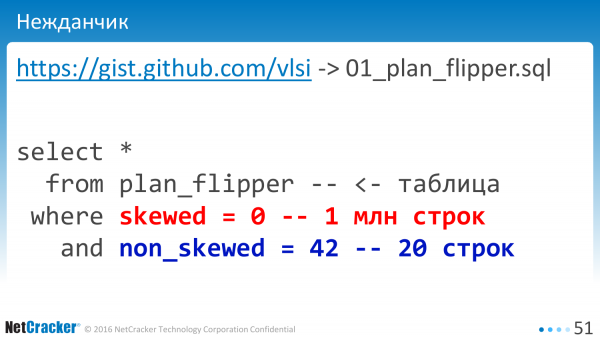
Bit je u tome da imamo dvije kolone, od kojih je svaka indeksirana. U jednoj koloni ima milion redaka s vrijednošću NULL. A u drugoj koloni ima samo 20 redaka. Kada izvršavamo bez povezanih varijabli, sve dobro funkcionira.
Ako počnemo izvršavati s povezanim varijablama, tj. izvršavamo znak «?» ili «$1» za naš upit, što na kraju dobivamo?
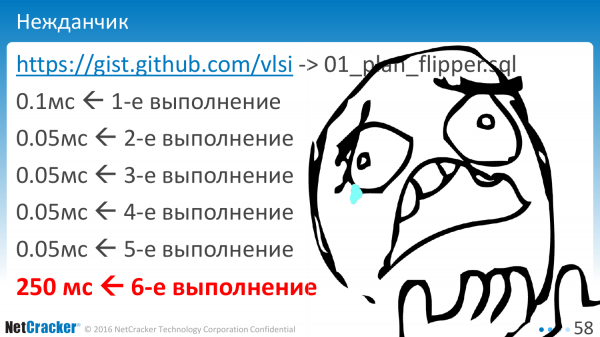
Prvo izvođenje – kako se očekuje. Drugo – malo brže. Nešto je pohranjeno u cache. Treće-četvrto-peto. Onda bum – i tako. I najgore je što se to događa pri šestom izvođenju. Tko je znao da treba napraviti točno šest izvođenja da bi se shvatilo koji je pravi plan izvršenja?
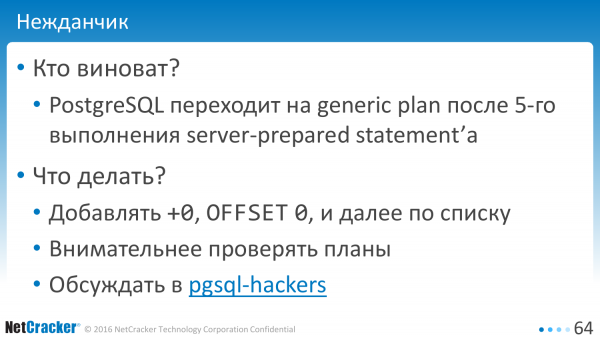
Tko je kriv? Što se dogodilo? Baza podataka sadrži optimizaciju. I ona je nekako optimizirana za generički slučaj. Tako da, počevši od nekog trenutka, prelazi na generički plan, koji, nažalost, može biti drugačiji. Može biti jednak, ali može i biti različit. Tu postoji neki prag koji dovodi do takvog ponašanja.
Što možemo učiniti s tim? Tu je, naravno, malo teže nešto pretpostaviti. Postoji jednostavno rješenje koje koristimo. To je +0, OFFSET 0. Sigurno poznajete takva rješenja. Jednostavno uzmemo i u upit dodamo «+0» i sve je u redu. Pokazat ću kasnije.
I postoji još jedna opcija - pažljivije pregledati planove. Razvijač ne bi trebao samo napisati upit, već i 6 puta reći «explain analyze». Ako je 5, neće odgovarati.
I postoji još treća opcija - napisati pismo na pgsql-hackers. Ja sam napisao, ali za sada nije jasno - je li to greška ili funkcija.
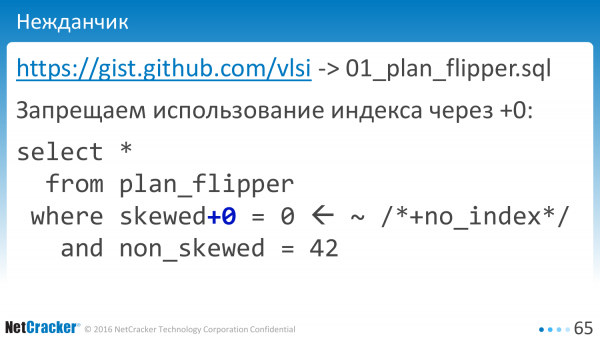
Dok razmišljamo - je li to greška ili funkcija, hajde da to sredimo. Uzećemo naš upit i dodati «+0». Sve je u redu. Dva simbola i ne treba misliti kako i što. Vrlo jednostavno. Samo smo bazi podataka zabranili korištenje indeksa po toj koloni. Nemamo indeks po koloni «+0» i sve, baza podataka ne koristi indeks, sve je dobro.
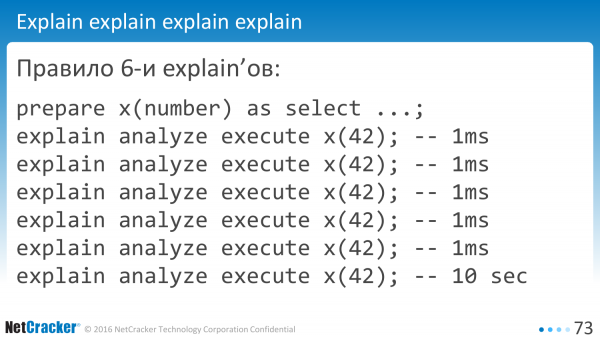
Evo pravilo 6 explain-a. U trenutnim verzijama treba napraviti 6 puta, ako imate povezane varijable. Ako nemate povezane varijable, onda to radimo ovako. I u konačnici, baš taj upit pada. Nije složeno.
Činilo bi se, koliko može? Ovdje greška, ondje greška. Stvarno, greška svuda.
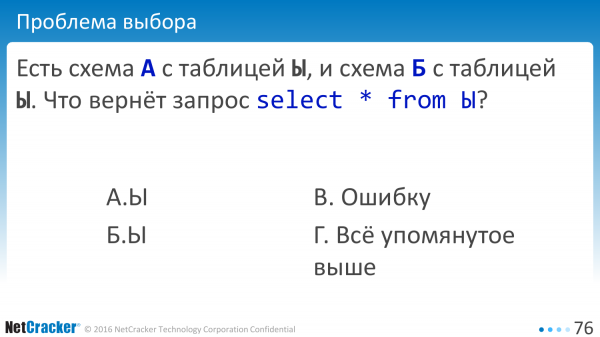
Pogledajmo još jednom. Na primjer, imamo dva sheme. Shema A s tablicom Ы i shema B s tablicom Ы. Upit - izabrati podatke iz tablice. Što će se dogoditi? Imat ćemo grešku. Imat ćemo sve prethodno navedeno. Pravilo je takvo - greška je svuda, imat ćemo sve prethodno navedeno.
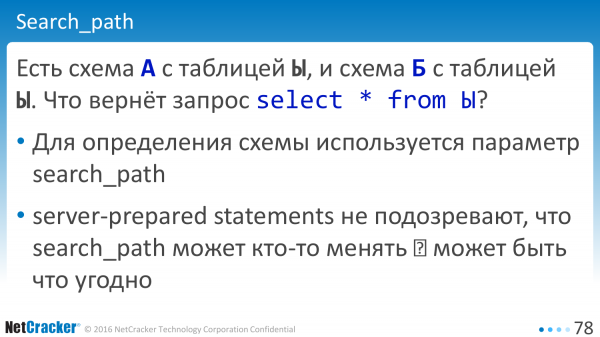
Sada pitanje: «Zašto?». Činilo bi se, postoji dokumentacija koja kaže da, ako imamo shemu, postoji varijabla «search_path» koja govori gdje treba tražiti tablicu. Činilo bi se, varijabla postoji.
U čemu je problem? Problem je u tome što server-prepared statements ne sumnjaju da bi netko mogao mijenjati search_path. Ova vrijednost ostaje kao da je konstantna za bazu podataka. I neki dijelovi možda neće preuzeti nove vrijednosti.
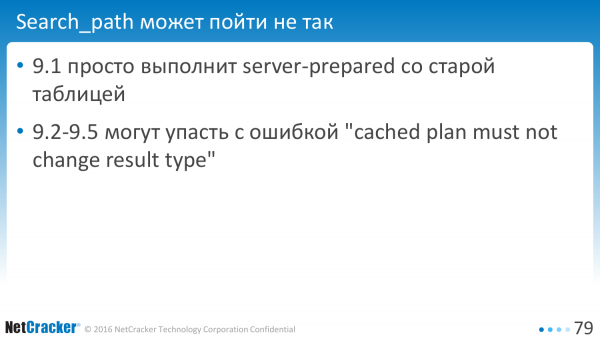
Naravno, to ovisi o verziji na kojoj testirate. Ovisi o tome koliko se ozbiljno vaši podaci razlikuju. Verzija 9.1 jednostavno će izvršiti stare upite. Nove verzije mogu prepoznati prevaru i reći da imate pogrešku.
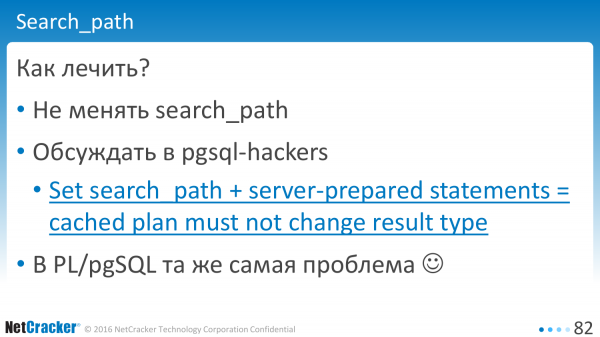
Kako to liječiti? Postoji jednostavan recept – nemojte to raditi. Ne mijenjajte search_path tijekom rada aplikacije. Ako ga promijenite, bolje je stvoriti novu vezu.
Možemo razgovarati, tj. otvoriti, raspraviti, dopisati. Možda ćemo uvjeriti developere baze podataka da u slučaju kada netko promijeni vrijednost, baza podataka treba obavijestiti klijenta: "Pogledajte, ovdje vam se vrijednost ažurirala. Možda biste trebali resetirati izjave, ponovo ih stvoriti?". Trenutno se baza podataka ponaša neprimjetno i ne javlja o tome da su unutra izjave promijenjene.
I ponovno ću naglasiti – to nije tipično za Javu. Ista stvar će se vidjeti u PL/pgSQL jedan na jedan. Ali će se tu reproducirati.
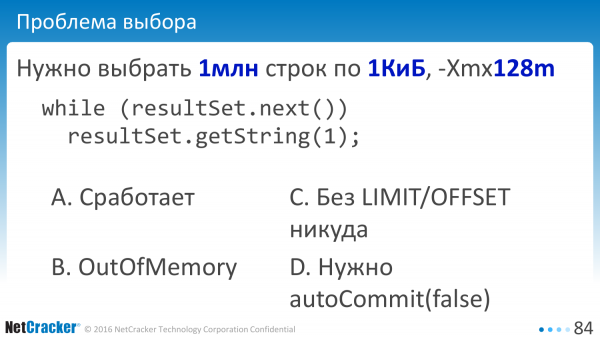
Pokušajmo još odabrati podatke. Biramo, biramo. Imamo tablicu s milijun redaka. Svaki redak je oko kilobajta. Približno gigabajt podataka. A imamo radnu memoriju u Java mašini od 128 megabajta.
Kao što preporučuje u svim knjigama, koristimo stream obradu. Tj. otvaramo resultSet i čitamo podatke polako. Hoće li to raditi? Hoće li pasti zbog memorije? Hoće li čitati malo po malo? Vjerujmo u bazu, vjerujmo u Postgres. Ne vjerujemo. Hoće li pasti OutOfMemory? Tko je imao OutOfMemory? A tko je uspio popraviti nakon toga? Netko je uspio popraviti.
Ako imate milijun redaka, ne možete jednostavno birati. Obavezno je koristiti OFFSET/LIMIT. Tko se slaže s tom opcijom? I tko se slaže s varijantom da se igra s autoCommitom?
Ovdje, kao obično, najneobičnija opcija pokazuje se ispravnom. I ako iznenada isključite autoCommit, to će pomoći. Zašto? Znanosti o tome nije poznato.
No prema zadanim postavkama svi klijenti koji se povezuju s bazom podataka Postgres odabiru podatke u cijelosti. PgJDBC u tom pogledu nije iznimka, odabire sve redke.
Postoji varijacija na temu FetchSize, tj. na razini pojedinačne izjave možete reći da ovdje, molim vas, odabirete podatke po 10, 50. No to ne radi dok ne isključite autoCommit. Isključite autoCommit – počinje raditi.
No, hodati kroz kod i svuda postavljati setFetchSize – to je nepraktično. Zato smo napravili takvu postavku koja će za cijelu vezu reći zadanu vrijednost.
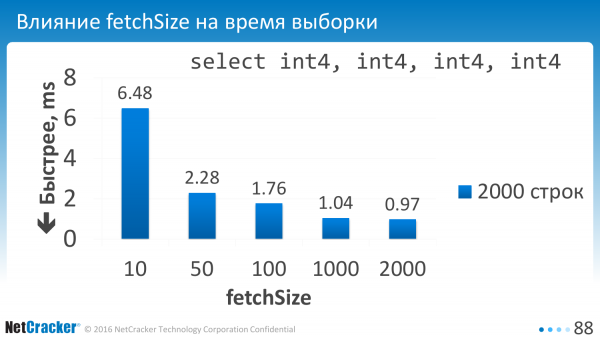
To smo rekli. Postavili smo parametar. I što smo dobili? Ako biramo malo, na primjer, birajući 10 redaka, imamo prilično velike troškove. Zato bi ovu vrijednost trebalo postaviti na otprilike stotinu.
Idealno, naravno, naučiti ograničiti i u bajtovima, ali recept je takav: postavljamo defaultRowFetchSize iznad stotinu i radujemo se.
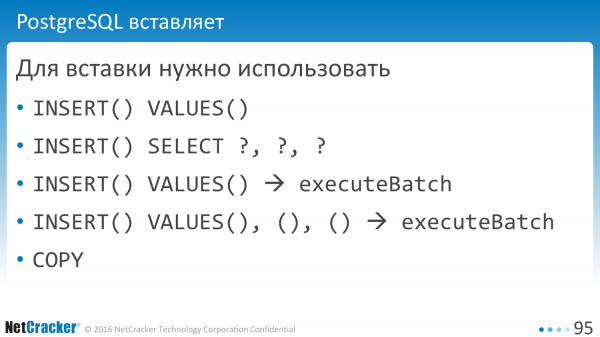
Hajde da pređemo na umetanje podataka. Umetanje je jednostavnije, tu su različite varijante. Na primjer, INSERT, VALUES. To je dobra opcija. Može se reći "INSERT SELECT". U praksi je to zapravo isto. Nema razlike u performansama.
Knjige govore da treba izvoditi Batch izjave, knjige govore da se mogu izvoditi složenije naredbe s više zagrada. A u Postgresu postoji divna funkcija – možete raditi COPY, tj. raditi to brže.

Ako mjerimo, možemo ponovo napraviti nekoliko zanimljivih otkrića. Kako želimo da to radi? Želimo da ne analiziramo i da ne izvršavamo suvišne naredbe.
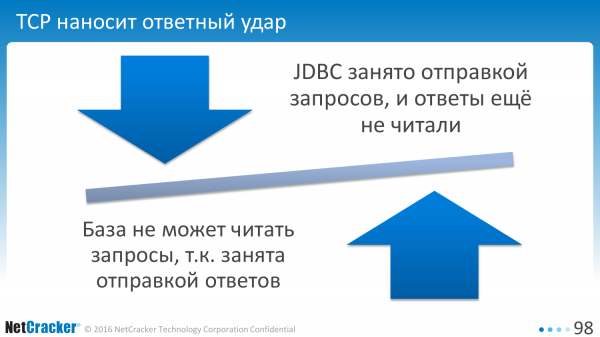
U praksi nam TCP to ne omogućava. Ako je klijent zauzet slanjem zahtjeva, baza podataka ne čita zahtjeve u pokušaju da nam pošalje odgovore. Na kraju, klijent čeka bazu podataka dok ona ne pročita zahtjev, a baza podataka čeka klijenta dok on ne pročita odgovor.
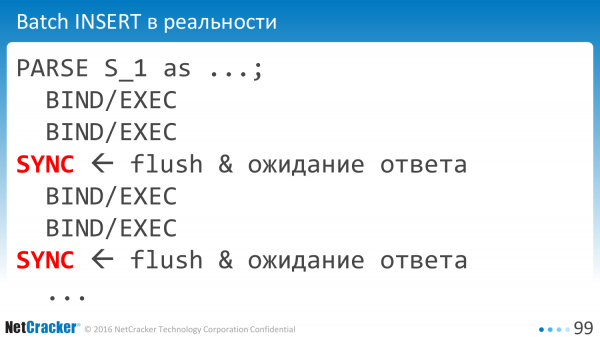
I zato je klijent prisiljen s vremena na vrijeme slati paket sinkronizacije. Suvišne mrežne interakcije, suvišno gubljenje vremena.
 I što više njih dodajemo, to je gore. Driver je prilično pesimističan i dodaje ih prilično često, otprilike jednom na 200 redaka, ovisno o veličini redaka itd.
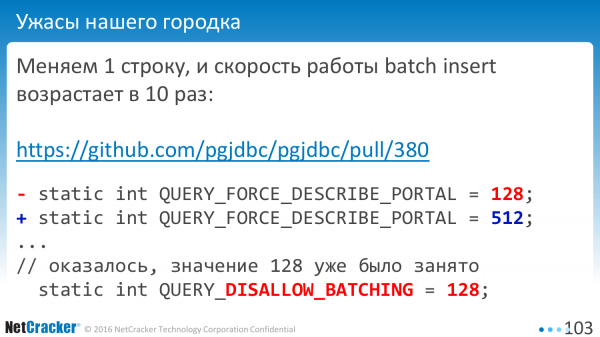
Dogodi se da ispraviš samo jedan redak i svi procesi se ubrzaju 10 puta. To se dešava. Zašto? Kao obično, neka konstanta je već bila korištena. A vrijednost "128" značila je – ne koristiti batching.
Dobro je što to nije ušlo u službenu verziju. Otkriveno je prije nego što smo počeli izdavati verziju. Sve vrijednosti koje spominjem temelje se na suvremenim verzijama.
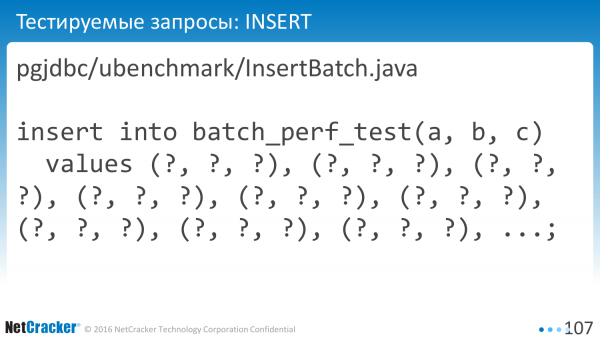
Hajde da mjerimo. Mjerimo jednostavni InsertBatch. Mjerimo višekratni InsertBatch, tj. isto, ali s mnogo values. Spretan potez. Ne znaju svi to raditi, ali to je jednostavan potez, puno lakše nego COPY.
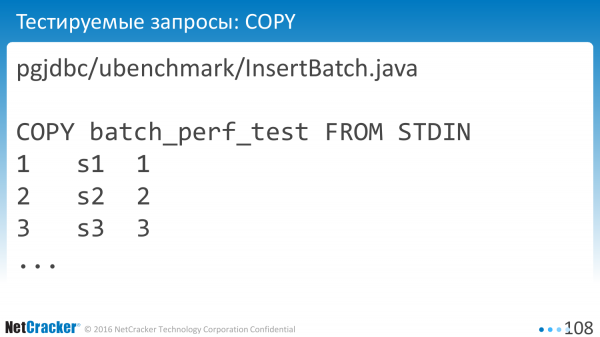
Može se raditi COPY.
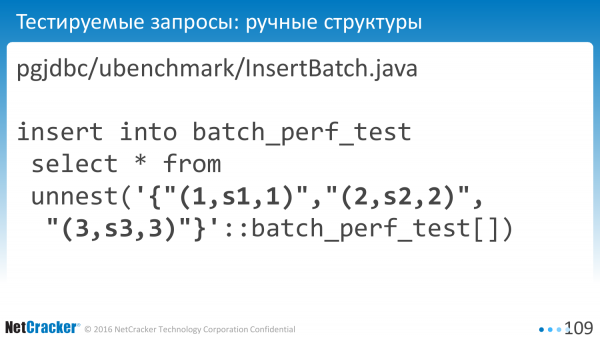
I to se može raditi na strukturama. Deklarirajte User default type, predajte niz i INSERT izravno u tablicu.
Ako otvorite poveznicu: pgjdbc/ubenchmsrk/InsertBatch.java, taj kod je na GitHubu. Možete vidjeti konkretno koje se upiti generiraju. Nije ni važno.
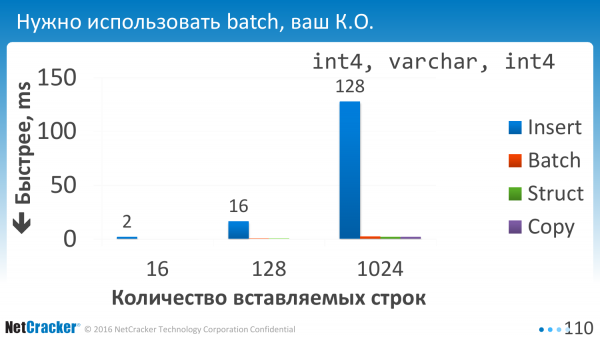
Pokrenuli smo. I prvo što smo shvatili je da ne koristiti batch – to jednostavno nije moguće. Sve opcije batching su jednake nuli, tj. vrijeme izvršenja praktički je jednako nuli u usporedbi s pojedinačnim izvršenjem.
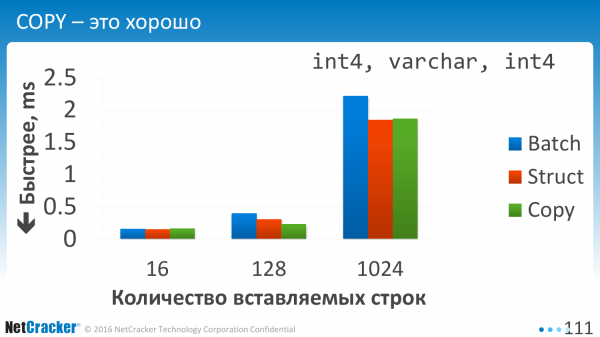
Unosimo podatke. Tablica je prilično jednostavna. Ima tri kolone. I što ovdje vidimo? Vidimo da su sve te tri opcije otprilike jednake. I COPY je svakako bolji.
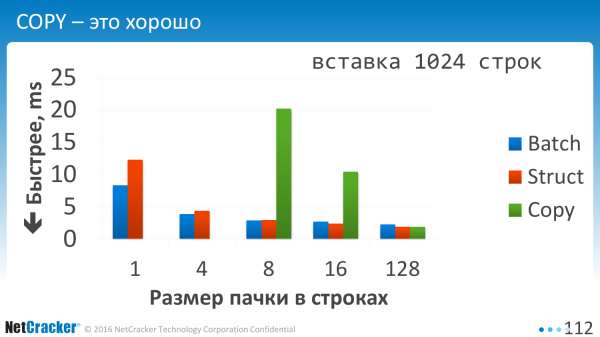
To je kada unosimo u dijelovima. Kada smo govorili da jedno vrijednost VALUES, dva vrijednost VALUES, tri vrijednost VALUES ili smo ih tamo 10 naveli zarezom. To se upravo sada prikazuje horizontalno. 1, 2, 4, 128. Vidljivo je da Batch Insert, koji je prikazan plavom bojom, olakšava stvar. Tj. kada unosite po jedan ili čak kada unosite po četiri, postaje dvostruko bolje, samo zato što smo u VALUES stavili malo više. Manje EXECUTE operacija.
Koristiti COPY na malim volumena je izuzetno neperspektivno. Prve dvije čak nisam ni prikazao. One idu u nebo, tj. te zelene cifre za COPY.
COPY treba koristiti kada imate obim podataka od bar više od sto redaka. Troškovi otvaranja te veze su veliki. I, iskreno, nisam se time dublje bavio. Batch sam optimizirao, COPY – ne.
Što radimo dalje? Mjerimo. Shvaćamo da trebamo koristiti ili strukture, ili pametan batch koji kombinira nekoliko vrijednosti.
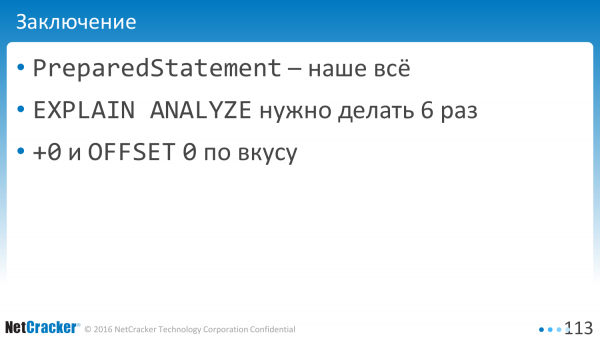
Što trebamo iznijeti iz današnjeg izlaganja?
- PreparedStatement – to je sve za nas. To puno pomaže u performansama. Donosi veliku bačvu katrana.
- I treba napraviti EXPLAIN ANALYZE 6 puta.
- I treba razblažiti OFFSET 0, i trikovima poput +0 kako bi se ispravio preostali postotak naših problematičnih upita.
Izvor: habr.com
